Looped-DiT:2.6 亿参数模型击败 6.5 倍规模的模型
商汤 OpenSenseNova 发布 Looped-DiT,它在每个去噪步骤内反复运行共享 transformer 块,让一个小模型击败规模大得多的模型。
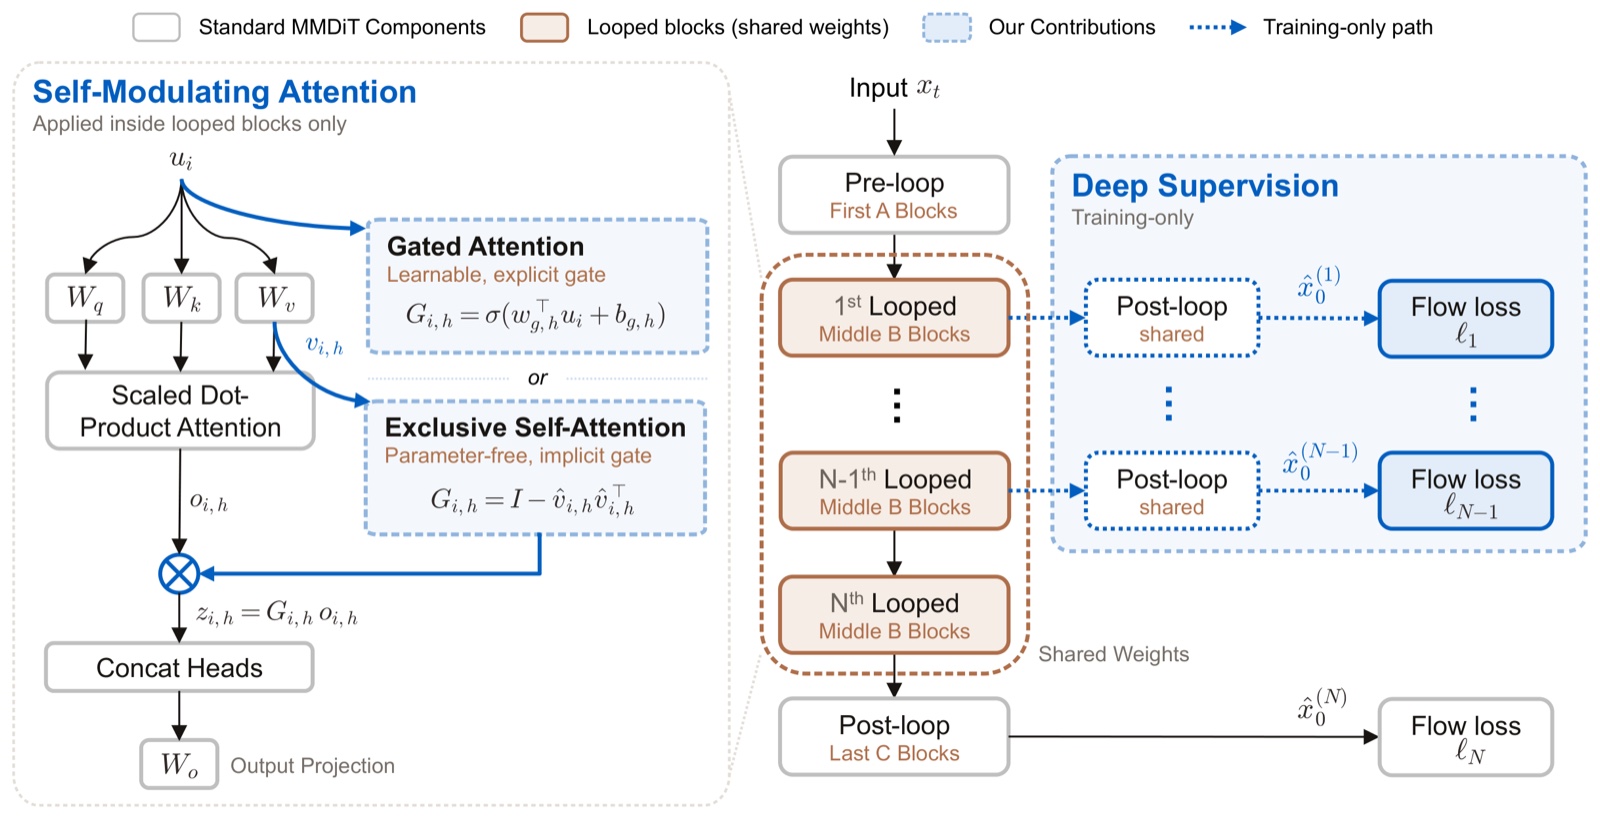
方法:一个共享块组在每个去噪步骤中循环 N 次,由自调制注意力调节循环,并通过深度监督训练每次循环之后的状态。
为什么朴素的循环会失败
把相同的块运行两遍并不能可靠地改进扩散 transformer。论文将原因归结为两个问题:各次中间循环的监督信号太弱,以及随着循环次数增加,注意力更新会逐步侵蚀局部信息。Looped-DiT 添加了两个组件来解决它们:
- 深度监督(Deep Supervision) 在每次循环后通过循环后的块解码状态,并将每个预测结果都与同一个干净图像目标进行训练。
- 自调制注意力(Self-Modulating Attention) 调节循环内部的注意力更新,使用独占自注意力(XSA)或逐头注意力门控。
主干网络是来自 MiniT2I 的像素空间 MMDiT,以冻结的 FLAN-T5-Large 作为条件。仓库涵盖 B/32、B/16 和 L/16 的训练、任意循环深度的推理、六项基准的评估,以及每个训练集的数据准备脚本。
结果
分数使用 EMA 权重、100 步 Euler、引导系数 6.0、循环深度 4:
| 模型 | 补丁 | GenEval | DPG | PRISM | CoRe | Spatial | TIIF | 平均 |
|---|---|---|---|---|---|---|---|---|
| Looped-DiT B/32 | 32 | 85.1 | 85.3 | 54.4 | 44.5 | 52.3 | 76.1 | 66.3 |
| Looped-DiT B/16 | 16 | 87.4 | 87.0 | 67.0 | 53.5 | 54.6 | 79.7 | 71.5 |
真正关键的结论在论文摘要中:在参数量匹配和算力匹配的设置下,循环设计始终优于非循环基线;而在固定推理预算下,更深的循环比额外的去噪步数能带来更多收益。作者还报告称,更深的循环会逐步纠正更早循环中犯下的错误,他们将其描述为具有 Latent 推理迹象的行为。
运行它
两个模型均以 PyTorch 文件形式发布:sensenova/Looped-DiT-B16 和 sensenova/Looped-DiT-B32,推理只需一次模块调用。--loops 设置循环深度,传入多个深度会各生成一行结果,从而可以在单个提示词上比较不同深度:
hf download sensenova/Looped-DiT-B16 looped-dit-b16.pt --local-dir checkpoints

python -m looped_dit.sample --checkpoint checkpoints/looped-dit-b16.pt \
    --prompt "a red cube on top of a blue sphere" --loops 1 2 3 4 --out loops.png
论文的主要结果使用 Euler 100 步、引导 6.0、循环深度 4、512x512,基于 bfloat16 的 EMA 权重。深度 4 是训练深度,但作者指出其他深度无需重新训练也能工作,因此循环次数是推理时的一个可调参数,而不是模型文件的固定属性。
可用性
这是一个研究发布,而不是 ComfyUI 集成。目前没有 ComfyUI 节点、没有 Comfy-Org 重新打包,也没有 diffusers pipeline,所以要运行它就得使用仓库自带的 Python 环境:PyTorch 2.1 或更新版本的 CUDA 构建、requirements.txt,以及需要单独安装的评估栈(mmdet、vLLM、modelscope),因为基准数据和 Mask2Former 权重并未打包在内。考虑到发布日期以及它迄今获得的 51 个 GitHub star,社区移植并不令人意外,但截至本文撰写时还不存在。
评论
使用 GitHub 登录后即可参与讨论。