MiniMax H3 角色替换 LoRA:在参考视频中替换任意人物
Akatz Labs 为 MiniMax H3 Ref2VA 打造的角色替换 LoRA,可用一张角色图像或角色设定图替换参考视频中的某个人物,并公开了权重与数据集。
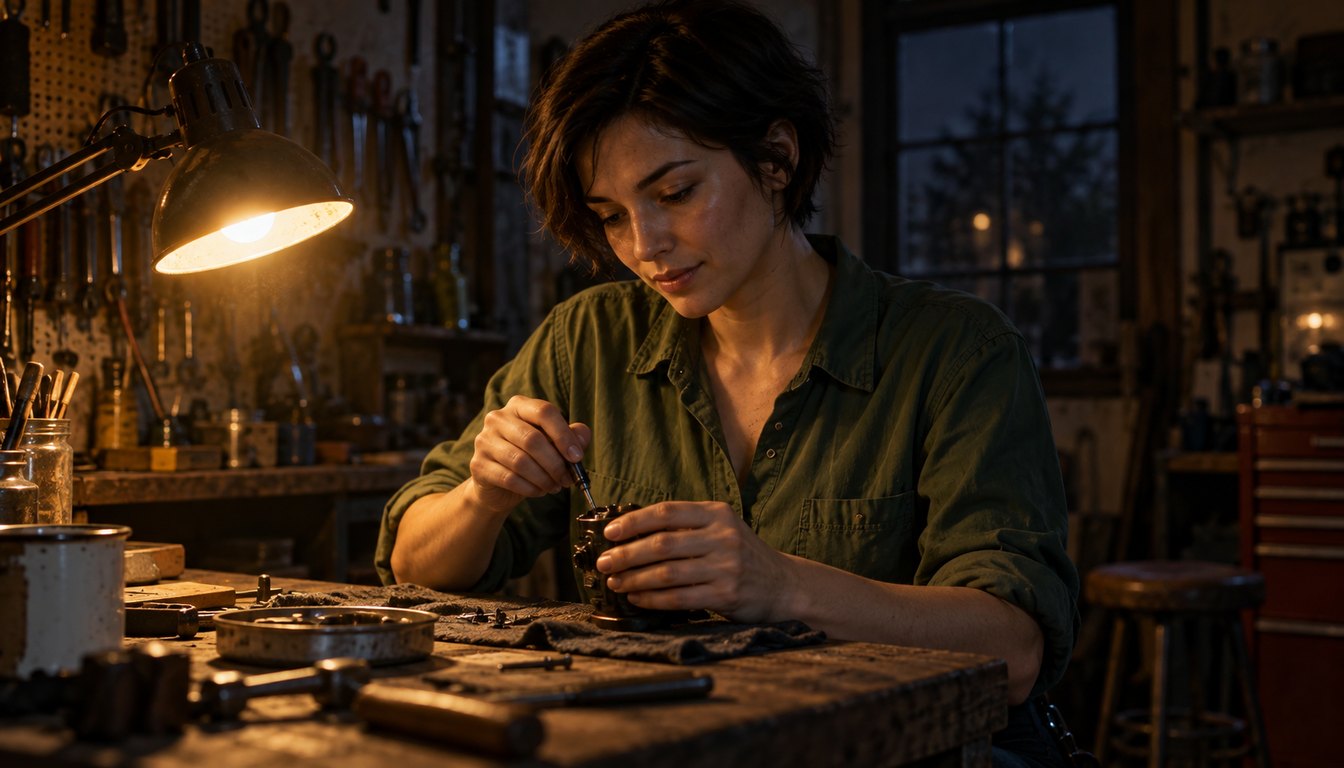 | 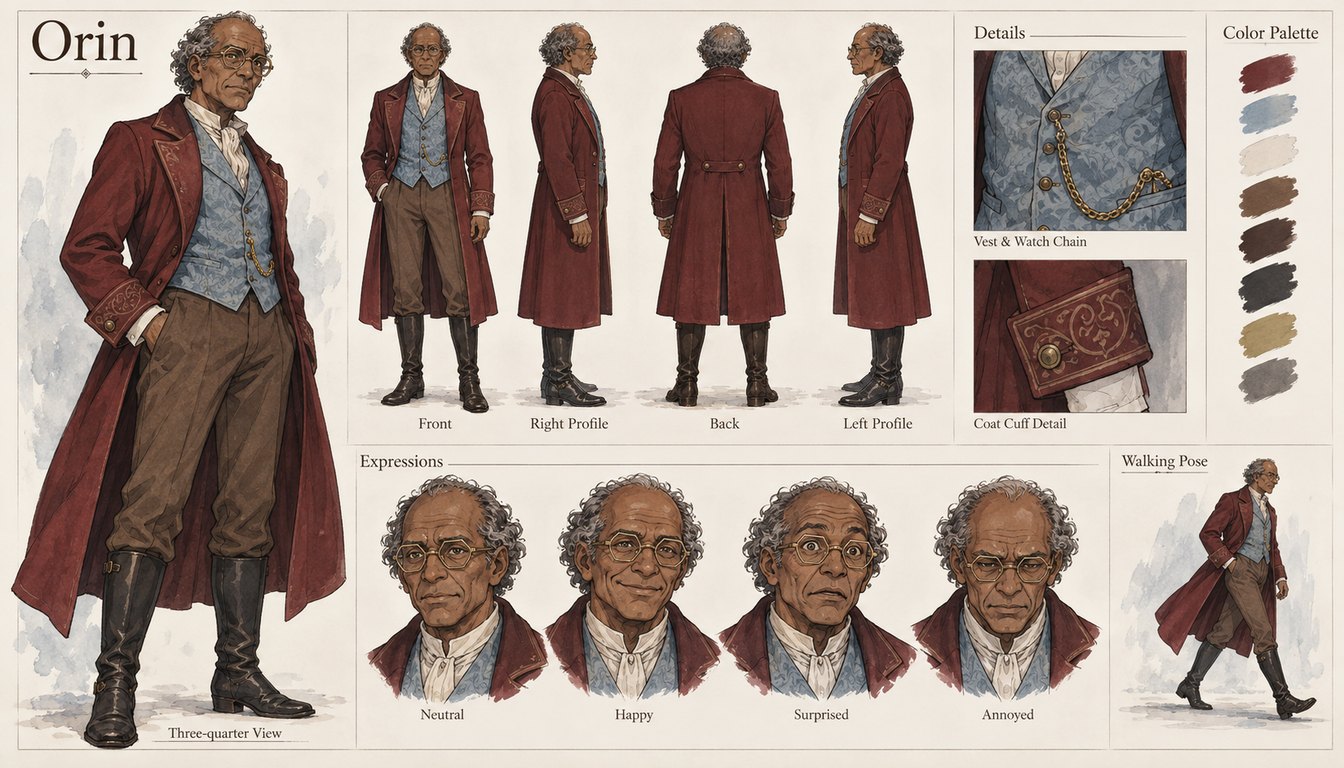 | 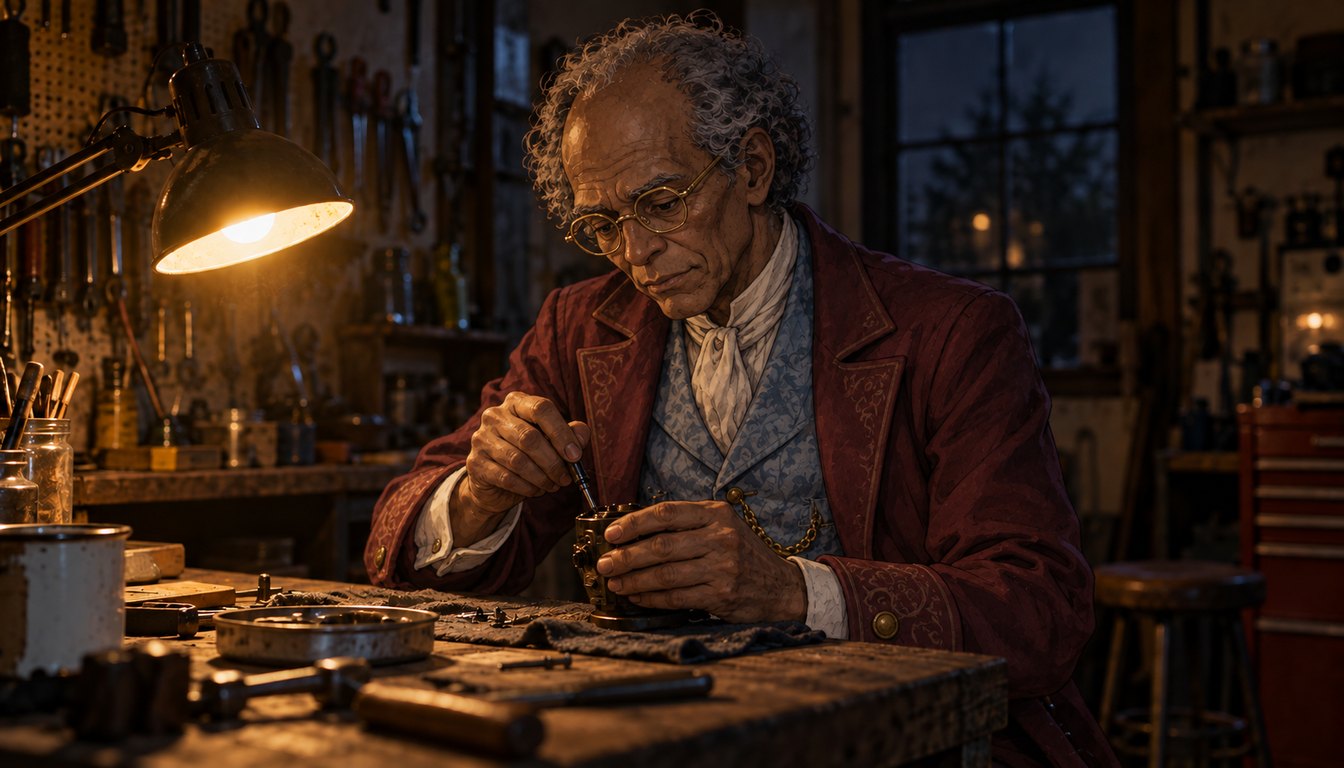 |
|---|---|---|
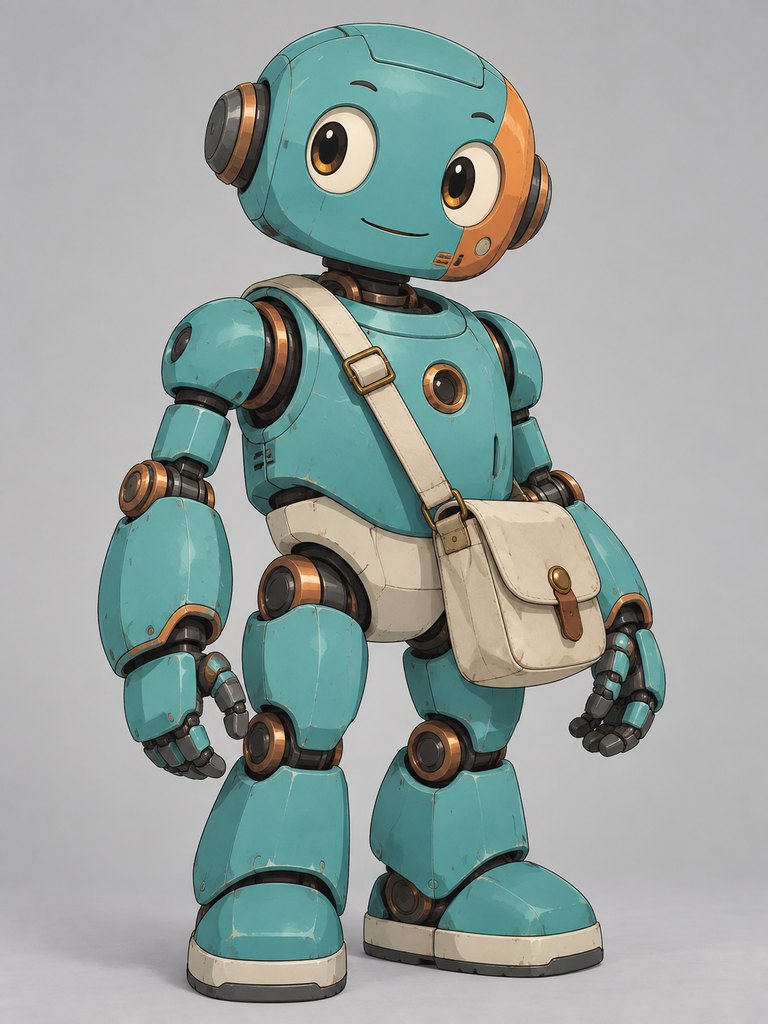
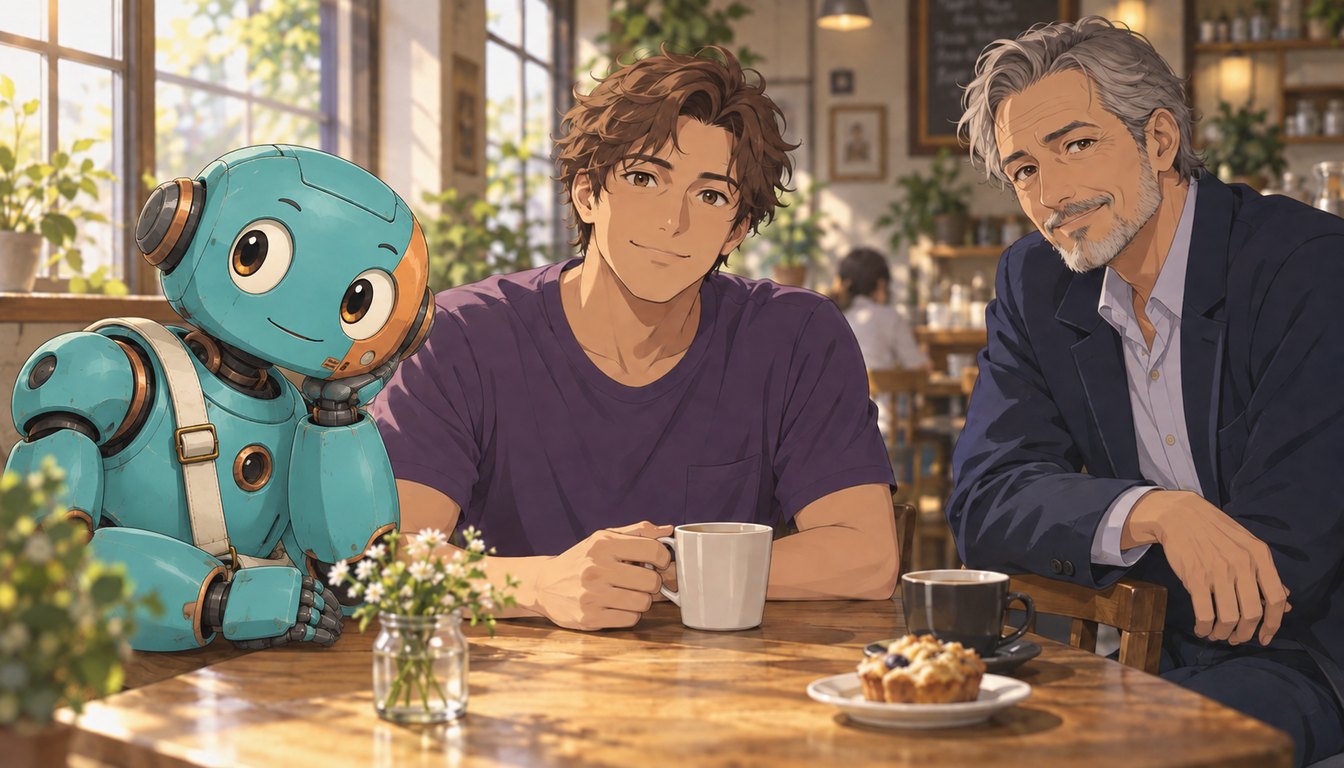
| 源视频帧 | 角色设定图参考 | 数据集目标:替换后的角色 |
来自已发布数据集的一个训练示例,依次展示源视频帧、角色设定图,以及 LoRA 被训练生成的编辑目标。来源:H3 Character Swap v1。
这项任务的范围比单纯的身份迁移更广。H3 FaceSwap LoRA 是把一张脸挪到片段中已有的表演上;而这个适配器复制的是整个替换角色,包括其服装和渲染媒介,同时反过来保留源场景的媒介。这正是跨风格替换得以实现的原因:把一个插画角色放进实拍素材中,它仍保持插画外观,而 94 条训练编辑中有 34 条正是这样构建的。
数据集包含哪些内容
Akatz Labs 使用 H3 Character Swap v1 训练该适配器,这是一个与权重一同发布的引用条件化数据集:
- 134 个示例:94 条角色替换编辑和 40 条保留片段。训练使用了 76 条编辑和 32 条片段,另有 18 条编辑和 8 条片段作为留出集。
- 每条编辑都由一张静态图像构成。 场景以五帧静态视频(
<Video 1>)提供,替换角色以一张角色图像或设定图(<Picture 1>)提供,每一对都带有简短的目标定位指令,例如Swap the man in the purple shirt in <Video 1> with the character in <Picture 1>. - 跨风格与设定图覆盖。 34 条编辑在不同渲染风格之间进行替换,20 条使用完整角色设定图,竖版、方形和横版设定图均保持其原始宽高比。
- 正则化片段是明确的保留示例。 同一段视频同时作为控制和目标使用,并配有说明文字
Keep <Video 1> unchanged. - 一次只处理一个角色。 训练目标中未对多角色替换进行监督。
适配器本身是一个 rank 16 的 LoRA,148 MB,基于 Comfy-Org/MiniMax-H3 的剪枝 INT8 Ref2VA 基础模型,借助 Ostris 训练助手完成了 1,000 次更新。仓库只发布了最终 checkpoint,训练启动脚本和运行配置位于仓库的 training/ 目录下。
更多示例
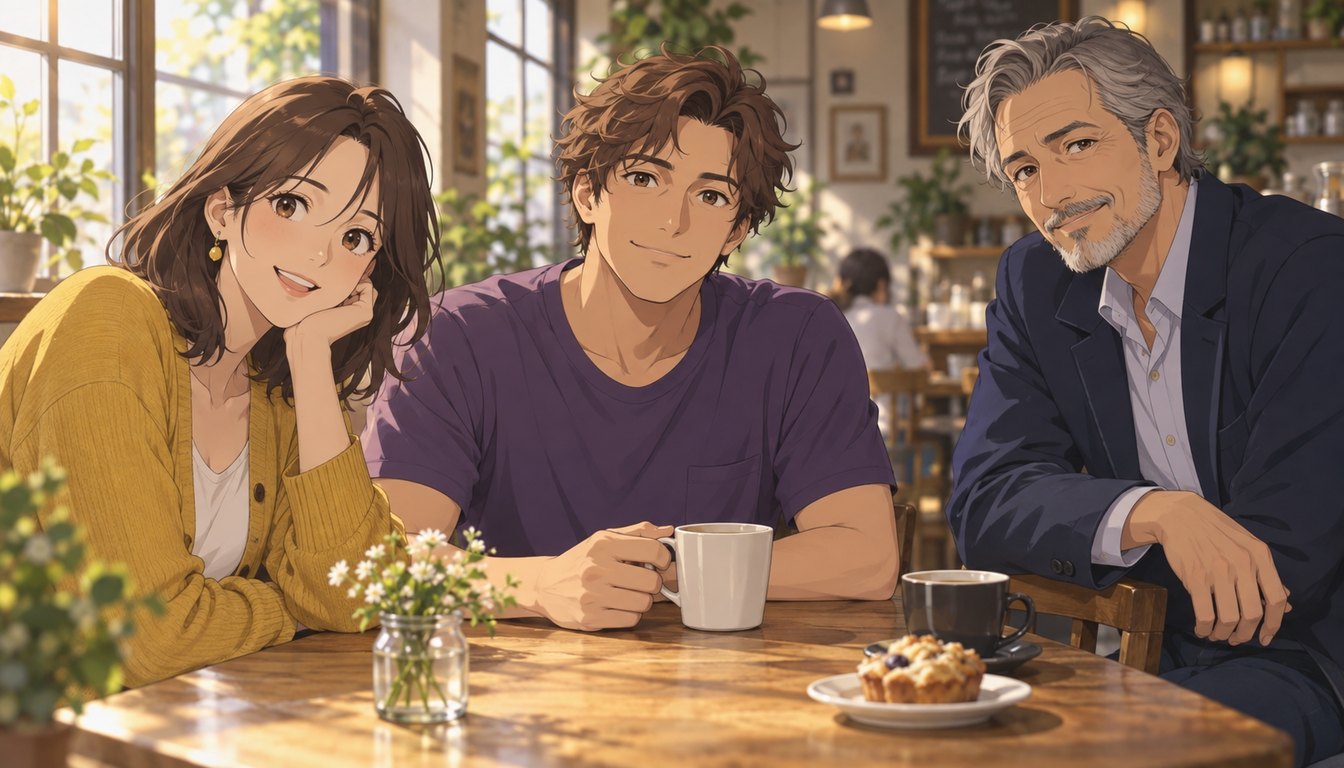 |  |  |
|---|---|---|
| 源视频帧 | 竖版角色参考图 | 数据集目标:替换后的角色 |
第二组训练配对,这次以竖版角色参考图而非设定图作为条件。
它擅长什么,又在哪里失效
作者本人与基础模型的对比范围较窄,值得在下载前读一读:
- 场景保留得到改善。 在并排对比中,该适配器比基础模型更能贴近来源地保留背景和场景结构,但作者将这些对比定性为定性评估,而非基准测试。
- 长片段会漂移。 在较长的时间窗口内,构图、位置和来源时序会发生偏移,硬切也可能退化为缓慢的重新定位,而不是一次真正的编辑。
- 表情不可靠。 特写面部表情往往无法跟随原始表演,而更强的表情指令有时会完全抑制替换效果。
- 短片段才是最佳区间。 约 4 到 5 秒的连续镜头比作者尝试的完整 14 秒表现更好;目前尚未确定精确的最大时长。
- 没有触发词。 定位来自提示词,而卡片也明确指出,提示词措辞并不能保证与来源严格对齐。
Banodoco 的测试者也遇到了同样的瓶颈。Charlie 在混合 FL2VA/Ref2VA H3 模型上对该适配器做了一次十秒测试,报告称它大约只能维持五秒,而 15 秒的尝试会变成模糊帧;另一位测试者则指出,原始人物的姿态和动作仍必须在提示词中描述,否则替换不会复制其动作。
漂移的原因在于结构:由于每个编辑目标都是静态图像,模型从未见过展示如何跨时间保持表演的动态角色替换目标。Akatz Labs 带着这一诊断申请了 Banodoco 的算力资助计划,并获批 40 个 H100 小时,用于拍摄 12 到 24 组动态视频配对,覆盖表情、切换、遮挡和更长的序列,此外还会比较当前的引用条件化与显式对齐的来源和目标 latent 位置。
在 ComfyUI 中运行
该适配器是单个仅模型 LoRA,没有节点依赖:
- 将
h3_character_swap_pro4500_1000.safetensors下载到ComfyUI/models/loras/。 - 创建或打开一个 MiniMax H3 Ref2VA 工作流,并将其指向剪枝 INT8 Ref2VA 基础模型及其文本编码器和 H3 视频与音频 VAE。
- 通过仅模型 LoRA 加载器以 强度 1.0 应用该 LoRA。
- 加载你想保留的片段作为
<Video 1>,加载替换角色作为<Picture 1>,然后在提示词中指明目标人物,例如:
Replace only the man in the purple shirt in <Video 1> with the character in <Picture 1>.
Keep the replacement character's identity, outfit, and art style from <Picture 1>.
Preserve the source video's camera, background, lighting, objects, and all other people.
Match the target person's position, scale, pose, and movement.
Do not show the reference sheet or its background.
卡片建议使用 24 fps、H3 支持的帧网格,并优先选择短连续镜头而非长镜头。卡片指出,该适配器无需 Turbo LoRA、Spectrum 或 Sol attention 即可工作,而将其与 8 步 Turbo LoRA 组合只是评估时的选择,并不构成兼容性声明。
可用性
- 训练数据集与来源信息:akatz-ai/H3-Character-Swap-v1
- 训练配置与启动脚本:权重仓库中的
training/ - 基础模型:Comfy-Org/MiniMax-H3
评论
使用 GitHub 登录后即可参与讨论。