Viggle Turbo v0.2:在 ComfyUI 中实现 5 步 Qwen-Image 2.1 蒸馏
Viggle 针对 Qwen-Image 2.1 的 v0.2 DMD 蒸馏将生成压缩到 5 步且无需 CFG,以 rank-256 LoRA 形式发布,并附带社区 ComfyUI 转换版本。
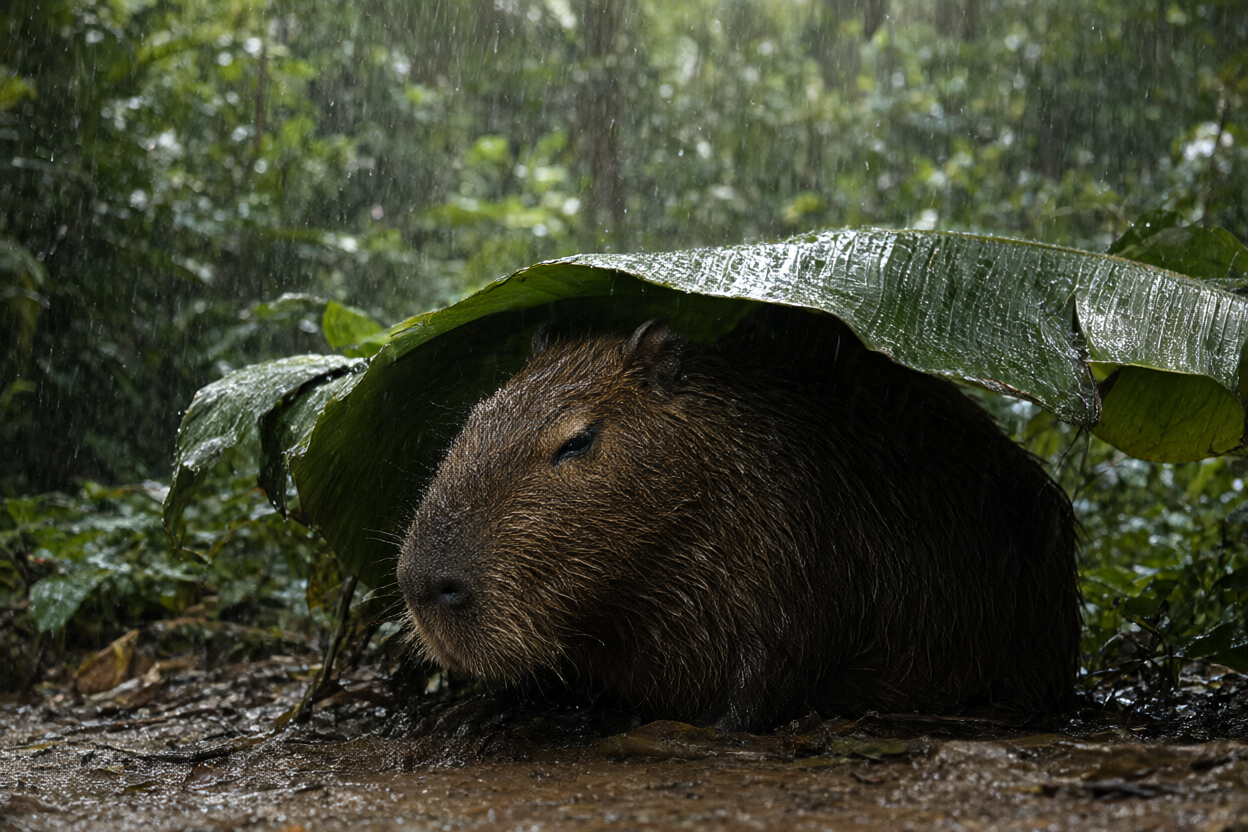
来自 Viggle 官方 demo Space 的 5 步文生图示例。
v0.2 有哪些变化
首个公开版本 v0.1 只是一个预览版,输出多样性大幅下降,构图上也偏离基础模型。v0.2 的学生模型更大,Viggle 在一组留出的 96 条用户请求上,将其与 40 步基础模型加上官方提示词增强进行了对比测量:
| 指标 | v0.1 LoRA r64 | v0.1 全量微调 | v0.2 LoRA r256,5 步 |
|---|---|---|---|
| 相对基础模型的样本多样性 | 0.75 | 0.72 | 0.93 |
| 相对基础模型的构图偏移 | -0.019 | -0.033 | +0.000 |
多样性是指 8 个种子下提示词内 DINOv2 补丁距离的均值,以相对基础模型的比例表示;偏移则是指在相同提示词和种子下,图像质心相对基础模型输出的位移幅度。实际效果是:v0.2 保留了基础模型在不同种子间的分布范围,并把主体放在基础模型会放置的位置,而 v0.1 会把所有种子都推向相似的构图。v0.1 的产物仍留在仓库中以供复现,但 Viggle 表示没有理由再优先选用它们。
运行方式
蒸馏后的学生模型采用固定 schedule 采样,而非按步数采样:5 步,sigma 节点为 [1.0, 0.875, 0.75, 0.5, 0.25],true_cfg_scale=1.0,且不使用负面提示词。这些节点就是四步训练节点,只是把噪波最高的那一段一分为二;Viggle 发现这样可以消除普通四步采样中大部分的细节损失和残影。其他步数和 CFG 取值都没有帮助。
还有两个细节对搭建工作流的人很重要:
- 使用随附的 scheduler 配置,或将
shift_terminal=None。基础模型的shift_terminal: 0.02会毁掉最后一步。 - 保持 LoRA 缩放为 1.0,因为随附 adapter 中 alpha 等于 rank。
文生图的训练面积为 1024 和 2048,编辑为 1024 和 1536;编辑最多接受 3 张引用图像,它们的顺序决定了提示词中的 <image1>、<image2> 和 <image3> 分别指向哪一张。
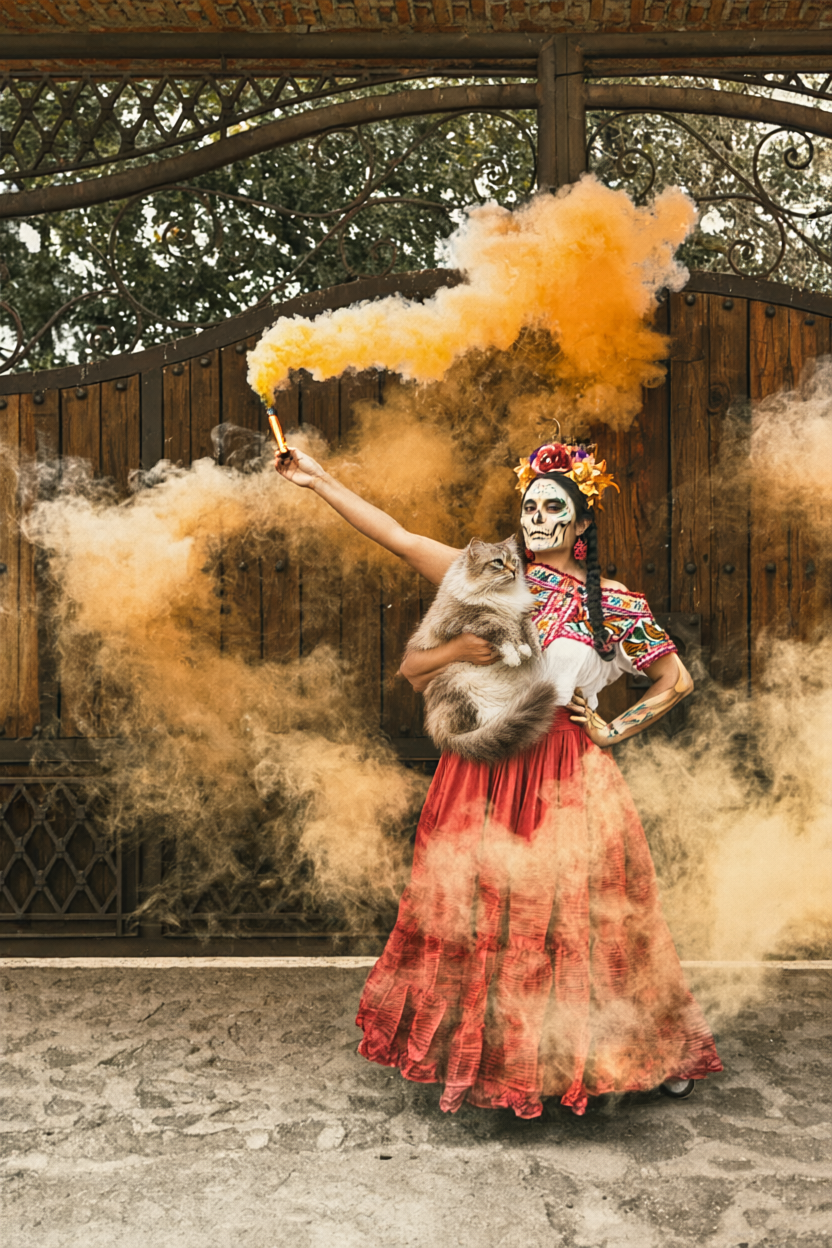
5 步、832x1248 的双引用编辑。提示词:"The woman from image 1 is holding the cat from image 2 in her arms, keep the background of image 1"。
ComfyUI 可用性
官方发布采用 diffusers 键名格式,并附带一个并行的 peft_v0.2 adapter,而不是 ComfyUI 可直接加载的单文件 kohya 格式,因此目前还没有官方 ComfyUI 工作流。社区在 v0.1 发布后一天内就填补了这一空缺:
t8star/Qwen-Image-2.1-viggle-turbo-4step-r64-comfy将 v0.1 r64 adapter 转换为 ComfyUI 可加载的 LoRA。- 4 步系列的量化版本也有 GGUF 仓库(Abiray、realrebelai),面向与其他 Qwen-Image 2.1 量化版本相同的低显存配置。
基础 Qwen-Image-2.1 的 transformer、文本编码器、VAE 和 processor 并未随该蒸馏模型一起分发,因此仍需从基础模型获取,而 ComfyUI 已原生支持基础模型。
它仍做不到的事情
Viggle 明确表示 v0.2 仍属预览版。文生图效果已接近基础模型,但复杂编辑仍落后于基础模型:多引用构图、换脸和证件类编辑可能产生人物重复或残影,“保持一切不变”的请求可能在身份上发生漂移,渲染的小字号或长文本也比 40 步时更容易出现乱码。2K 输出尚未与教师模型进行验证对比,RGBA 输出、超过 3 个引用以及基于遮罩的局部编辑均未测试。
该模型已在 ComfyUI 社区中开始被采用,此次发布也在 Banodoco #qwen-image 通道和 r/StableDiffusion 上广泛传播。
评论
使用 GitHub 登录后即可参与讨论。