Ming-Image 0.1 Design:ComfyUI 中的 6B UI 与海报模型
Ming-Image 0.1 Design 是 inclusionAI 的 6B 文生图模型,面向 UI、信息图和文字密集的海报,支持 RGBA 透明度,ComfyUI 支持正在开发中。
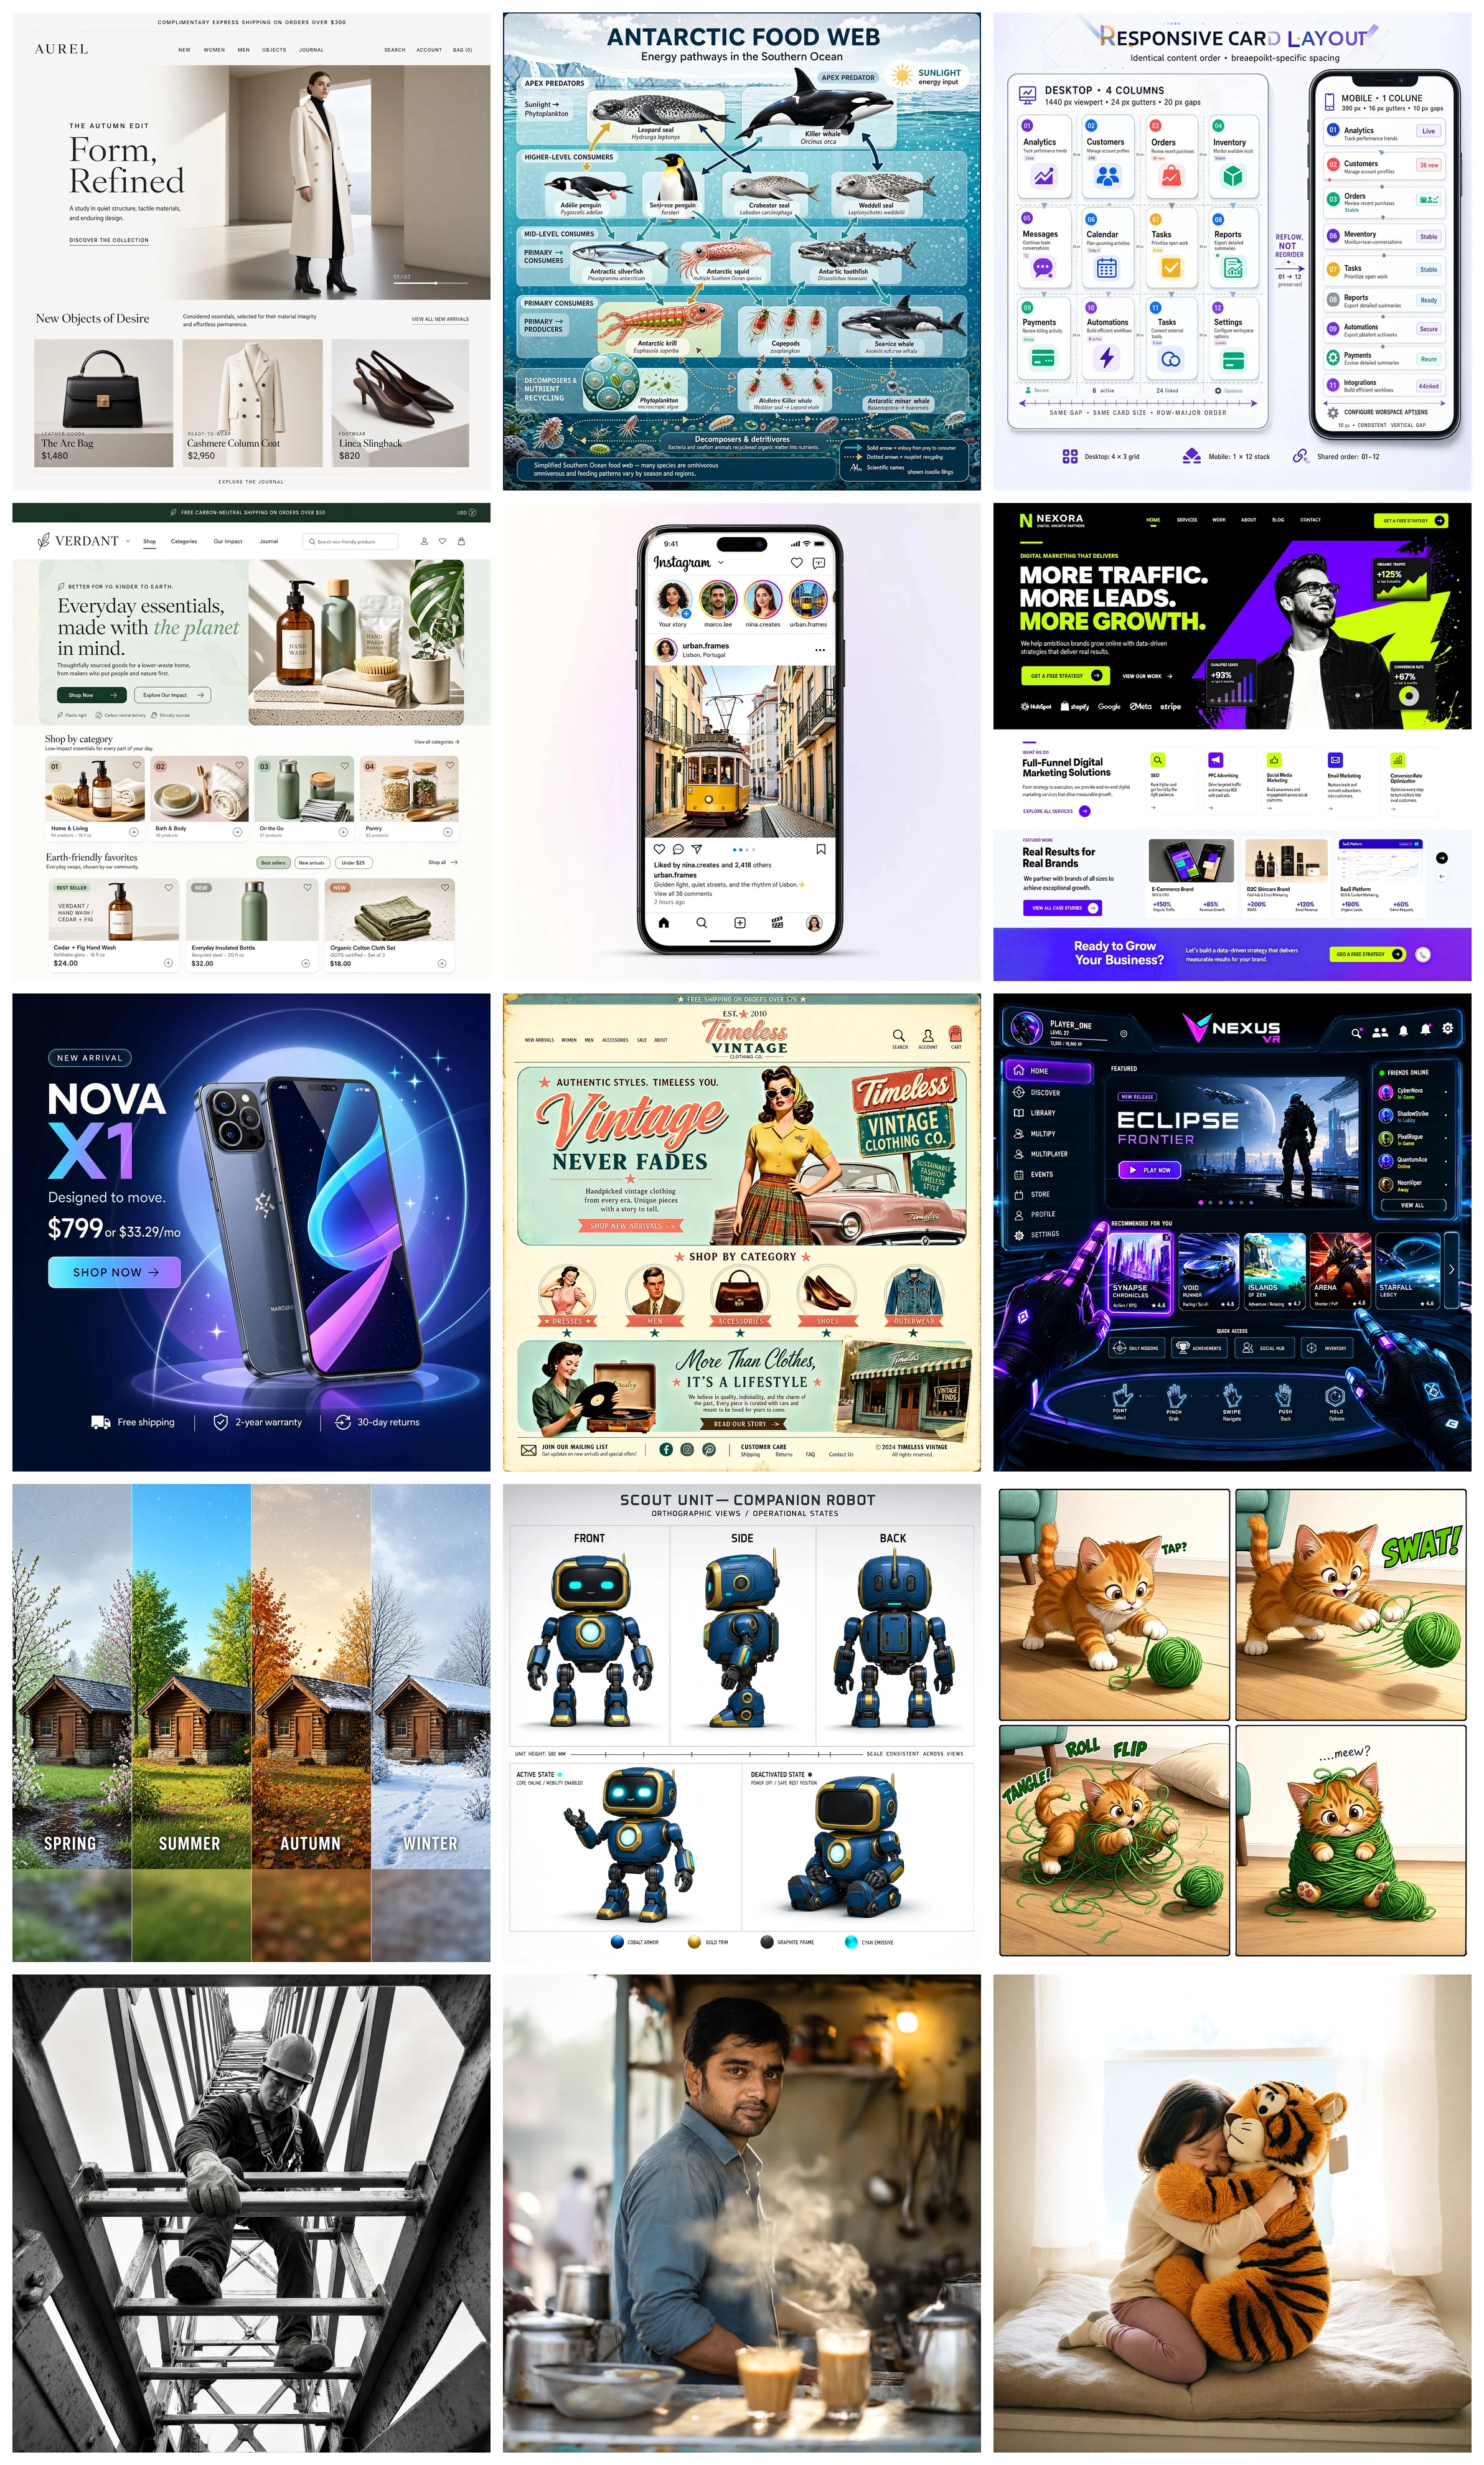
来自官方模型卡的设计示例。
Ming-Image 0.1 Design 是什么
Ming-Image 0.1 Design 出自 inclusionAI,即 Ling 和 Bailing 模型系列背后的团队,它瞄准的是常规图像模型处理得很差的任务:排版出干净、可读的设计,而不是一张照片。界面、仪表盘、响应式卡片布局、信息图面板、产品海报和 logo 图集都是它的目标内容,官方示例中大量强调渲染文字清晰可读、排版合理。
- 6B diffusion transformer。 该 DiT 为 30 层、3840 维设计,具有 16 个输入通道和 2x2 patching,并搭配一个独立的视觉语言编码器及其专属 connector。Kijai 认为其基础源自 Z-Image,并配有新的文本编码器。
- 设计优先的训练数据,而非通用照片语料,因此输出读起来像是带有真实文字块的编排布局。
- 两种原生输出档位:1024 和 2048,完整布局推荐使用 2048。
- 采样默认值很短: 12 步、CFG 1.0,因此只需少量迭代就能得到设计结果。
- 提示词增强是推荐流程的一部分。 官方 pipeline 建议在生成前用
Ling-3.0-flash-VL或qwen3.8-27B重写提示词,这一点在需要放置大量文字的密集布局中尤为重要。
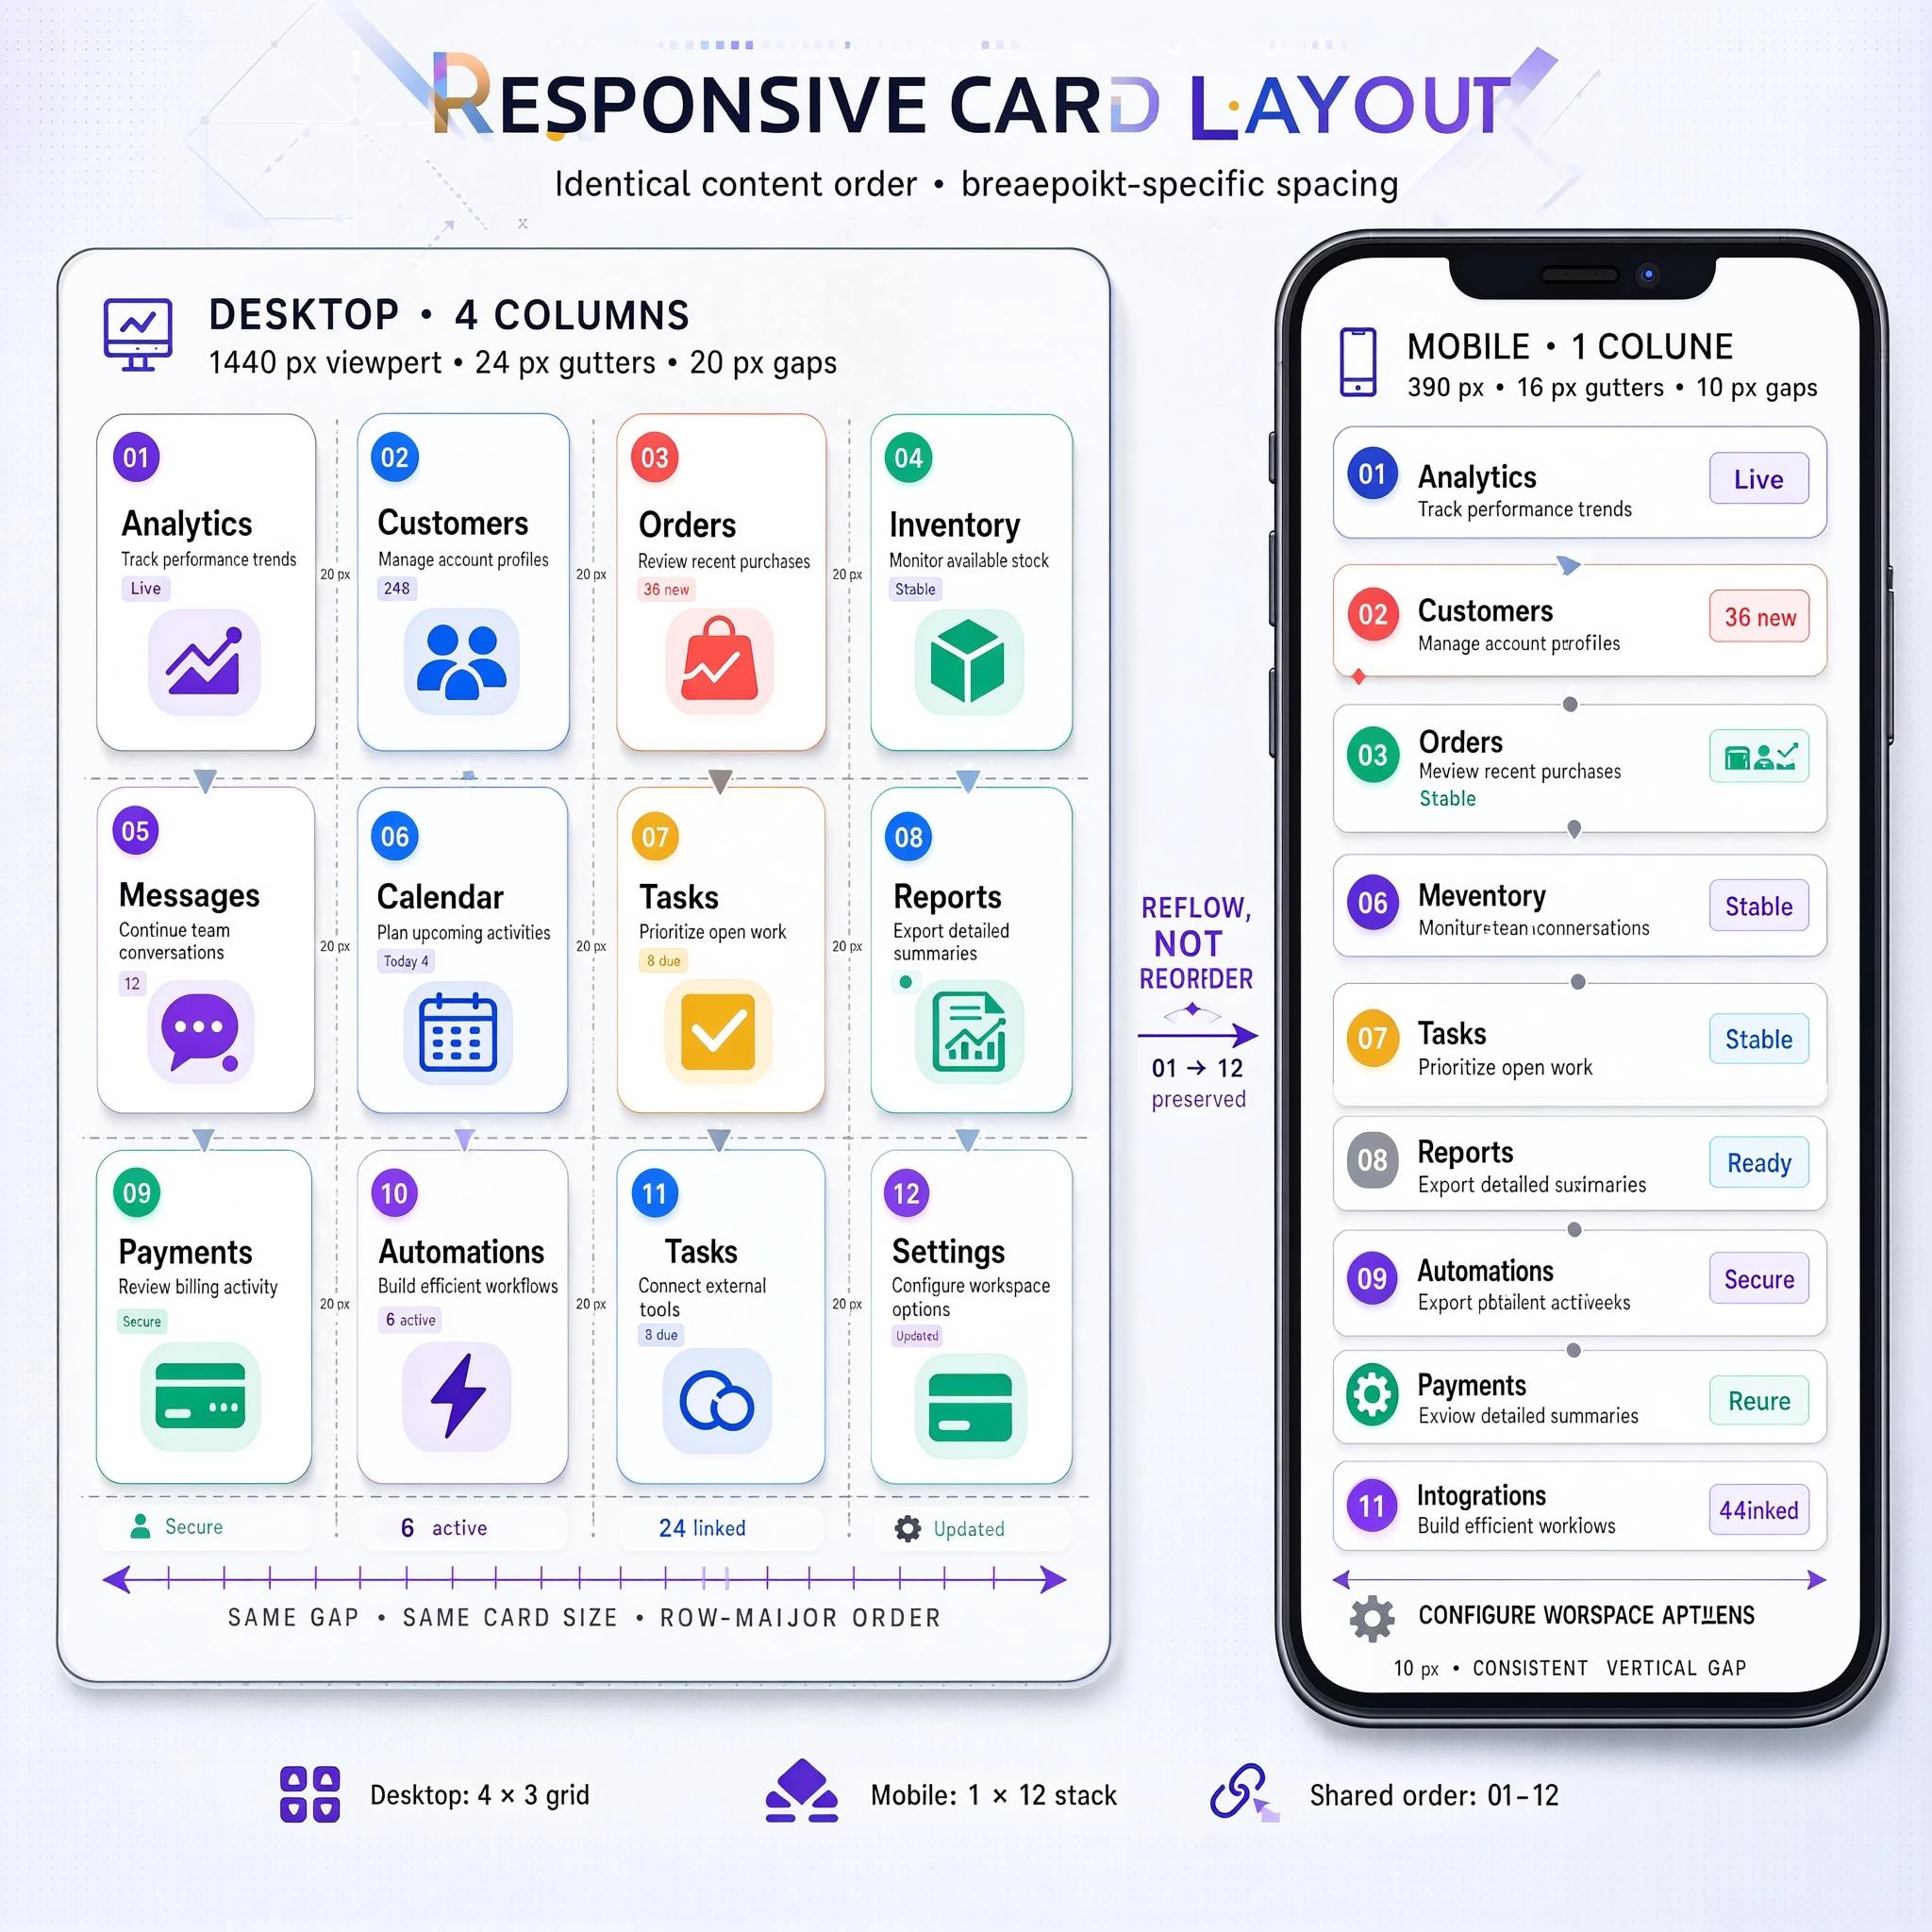
响应式卡片布局,官方文生图示例之一。
透明背景作为一等输出
除了普通图像,Ming-Image 0.1 Design 还能输出带真实 alpha 通道的 RGBA 图像,因此生成的海报元素、产品抠图或 UI 素材到手即可合成,无需再单独做一次抠图处理。模型卡提供了一组推荐的触发短语,并要求你在提示词前只添加其中一条,这与 Qwen-Image 2.1 的透明度模式做法一致。
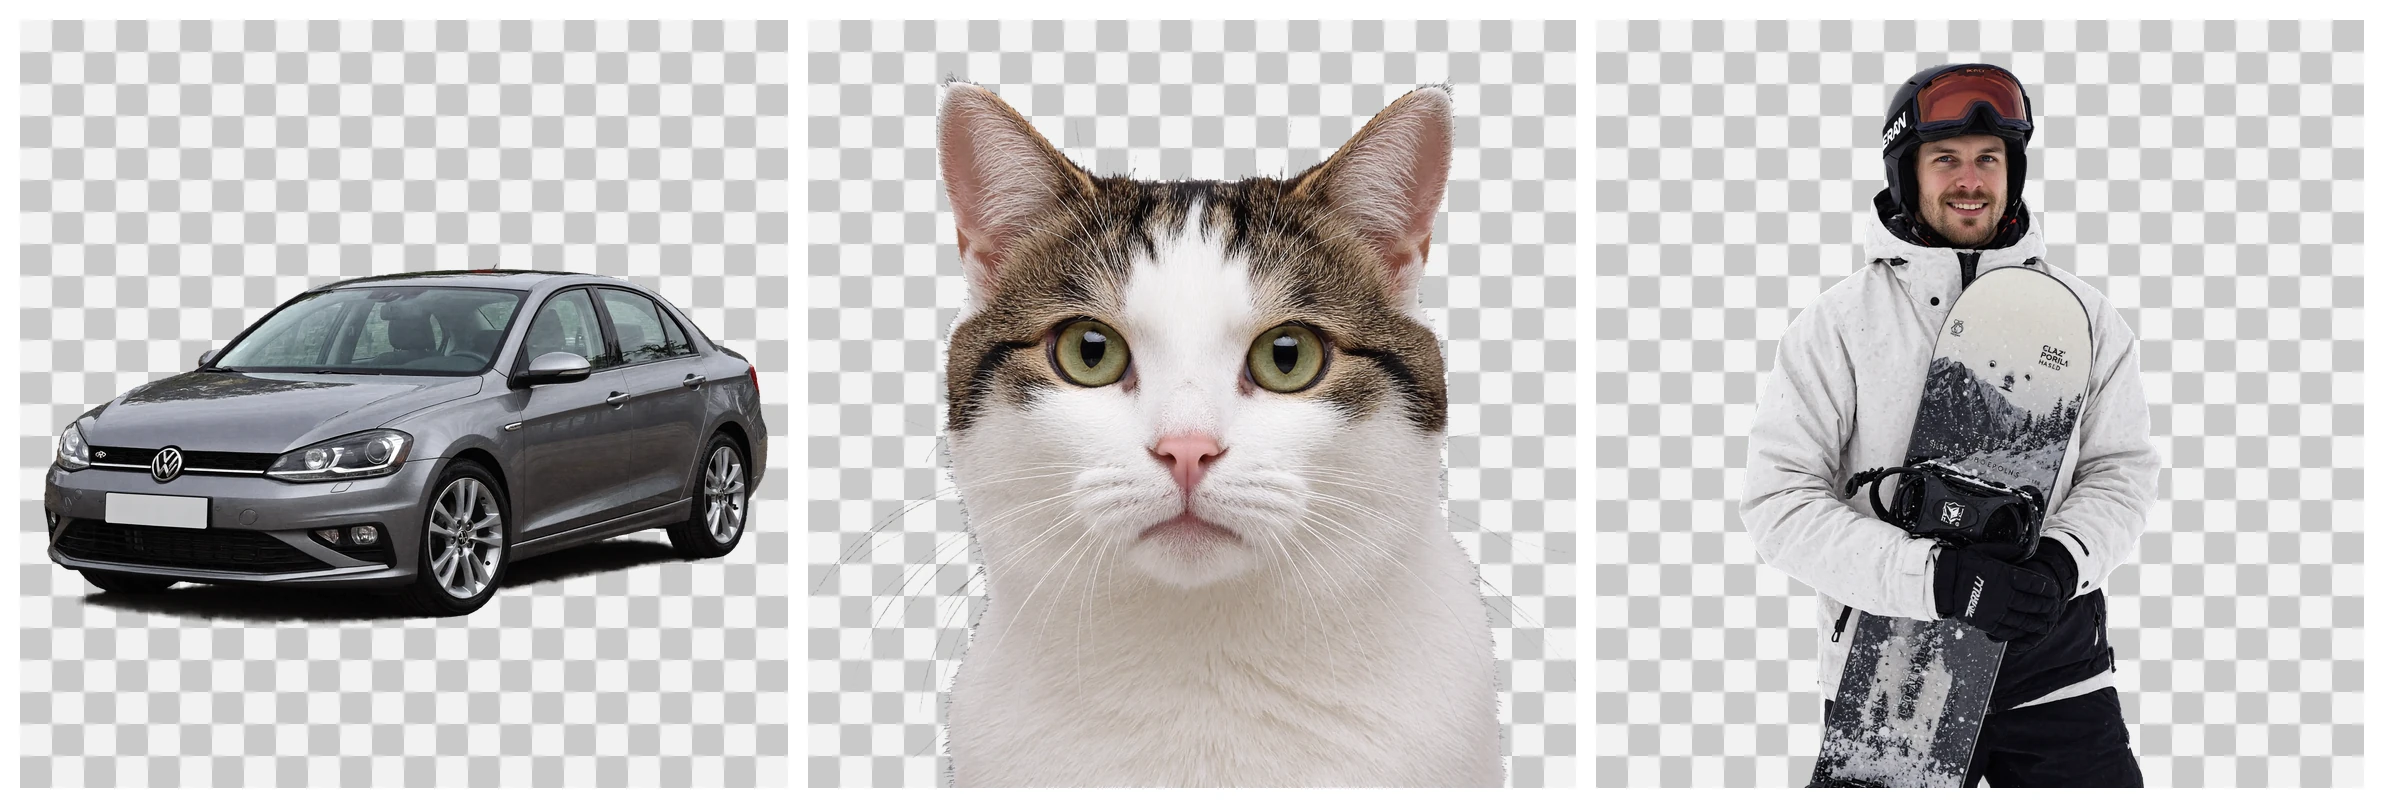
透明背景输出。棋盘格用于预览 alpha 通道,并非生成图像的一部分。
Layer 同系列模型:把设计转成可编辑图层
该系列还有第二个 6B checkpoint:Ming-Image 0.1 Design Layer,它反向解决这个问题:输入一张已合并的设计图像,将其拆解为多个可独立编辑的透明图层。这一步能把生成的设计稿变成真正可以在设计工具中加工的内容,inclusionAI 为它配了两套已发布的智能代理工作流:一个 Ling UI Design skill,利用生成的参考图加图层拆解来构建并可视化检查 UI 代码;以及一个 image-to-editable-PPT skill,把生成的页面重建为原生 PowerPoint 元素。
Layer checkpoint 使用的采样默认值与设计模型不同:12 步、CFG 2.0,可用档位为 512 和 1024。
它在 UI/UX 排行榜上的位置
inclusionAI 在发布模型的同时,也把它提交到了 Artificial Analysis UI/UX Design 排行榜,这是判断该模型与谁竞争最清晰的信号。
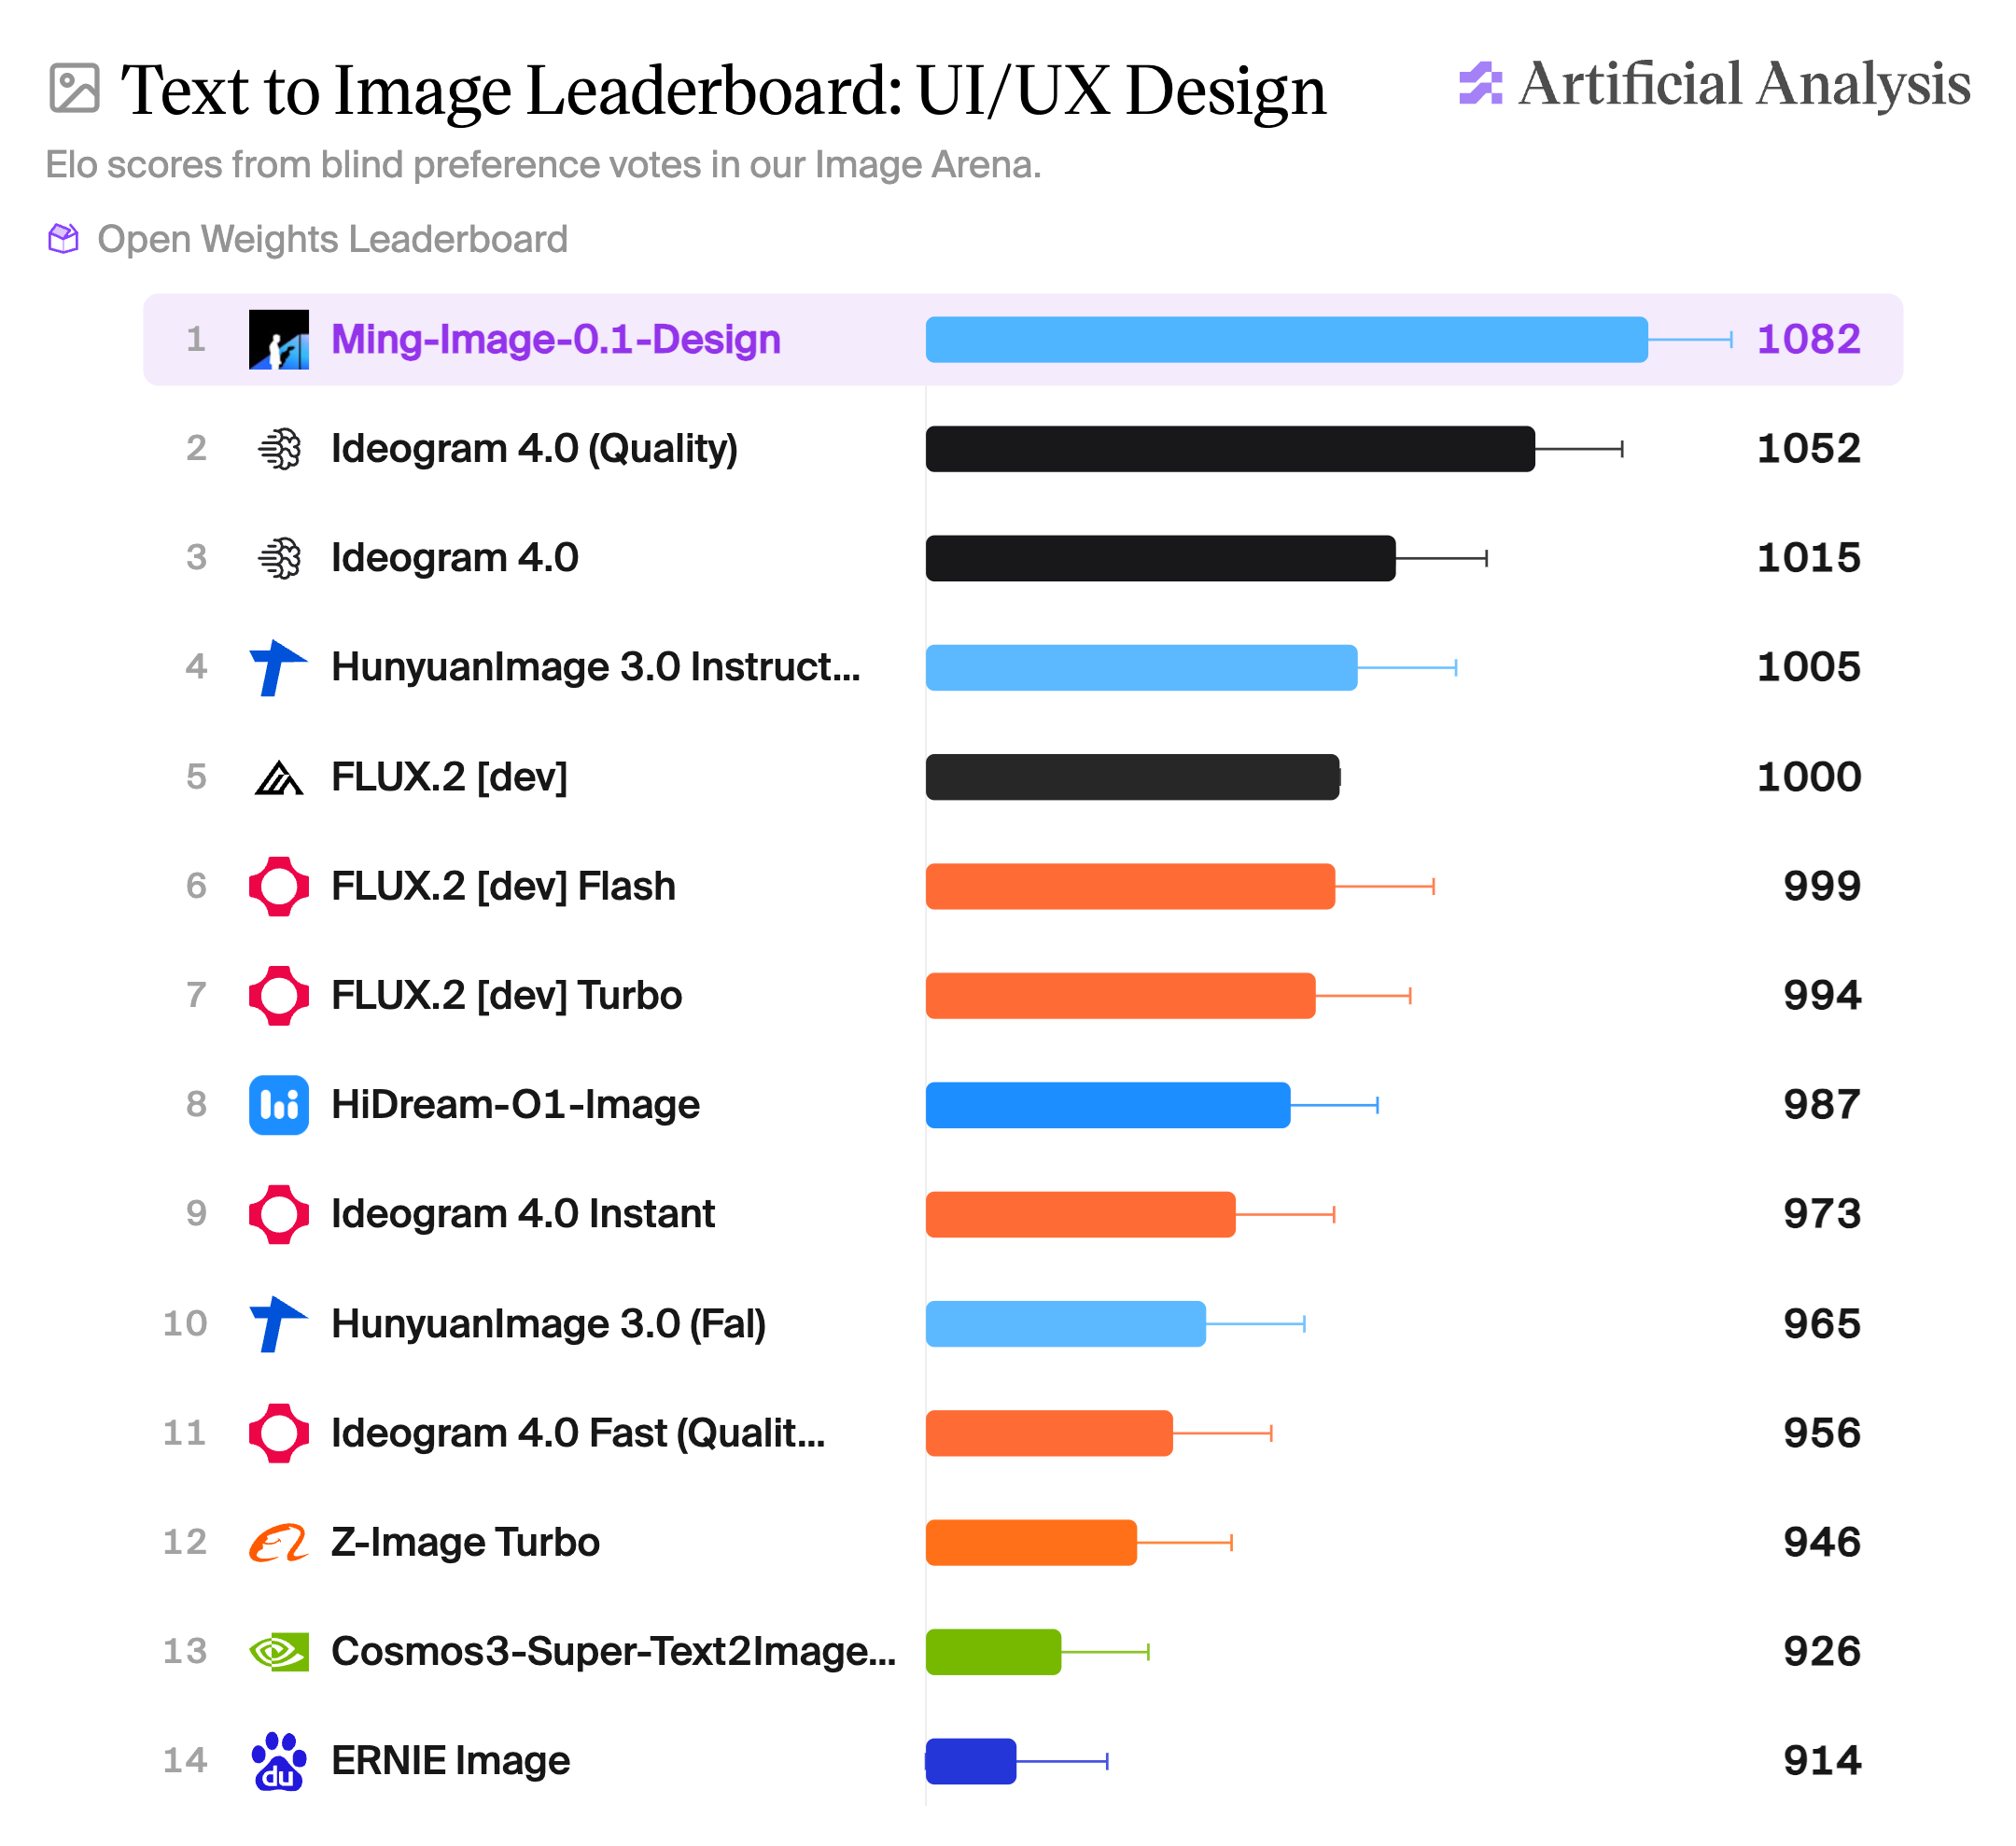
Ming-Image 0.1 Design 在 UI/UX Design 排行榜上的排位,来自官方仓库。
ComfyUI 可用性
Ming-Image 的 ComfyUI 支持仍在进行中,因此目前还没有合并进核心的实现或官方工作流模板。不过有两件事让它现在就能用:
- Kijai 在
Kijai/Ming-Image-ComfyUI发布了权重的 ComfyUI 重打包版本,包含 transformer 和文本编码器的 BF16、int8_convrot与w4a8变体,以及配套 VAE,按通常的diffusion_models/text_encoders/vae文件夹结构组织。 - 核心实现位于 ComfyUI PR #16482,Kijai 在其中表示该节点已能处理 RGBA 输出。该 pull request 仍处于开放状态,因此未经修改的 ComfyUI 安装还无法加载该模型。
Banodoco #ming-image 通道中的早期测试表明,这里采样器的影响比平时更大:Kijai 指出 LCM 输出干净但过度平滑,并且在 INT8 下随机文字错误仍然常见;而 RuneX 报告说该模型能响应边界框风格的提示词,并且凭借较小的体量编辑速度很快。Layer checkpoint 目前尚未被打包,因为 Kijai 认为额外的文本编码器和 projector 处理会带来相当多的复杂度,而适用场景又相对狭窄。
评论
使用 GitHub 登录后即可参与讨论。