Qwen-Image 2.1 提示词增强模型在 ComfyUI 中运行指南
Qwen 的 PE-T2I 与 PE-I2I 提示词重写模型可将简短需求和编辑指令展开,社区节点包通过加载 CLIP 在 ComfyUI 中同时运行两者。
两个重写模型,各司其职
PE 模型是基于 Qwen3.5-VL 9B 微调而来,于 2026-09-20 与基础模型一同发布,官方 Qwen-Image 2.1 README 推荐将它们作为准备提示词的默认方式:“为获得最佳效果,我们推荐使用官方提示词重写模型,把简短提示词展开为详尽、高质量的描述。”
- PE-T2I 可将任意语言的简短需求转换为一段较长的英文提示词,并附上推荐宽高比。其回答在
think块之后以 JSON 返回:{"rewritten_prompt": ..., "wh_ratio": "16:9"}。 - PE-I2I 接收一条编辑指令以及最多 10 张引用图像,按
<image1>、<image2>等依次引用,并返回精确的编辑提示词。其 JSON 回答会额外包含ratio_follow,用于指定输出应继承哪张输入图像的宽高比。
两者都应在开启思考(thinking)的情况下采样:官方示例使用 temperature 1.0、top_p 0.95、top_k 20,其中文生图模型使用 max_new_tokens 16256,编辑模型则使用 24000。
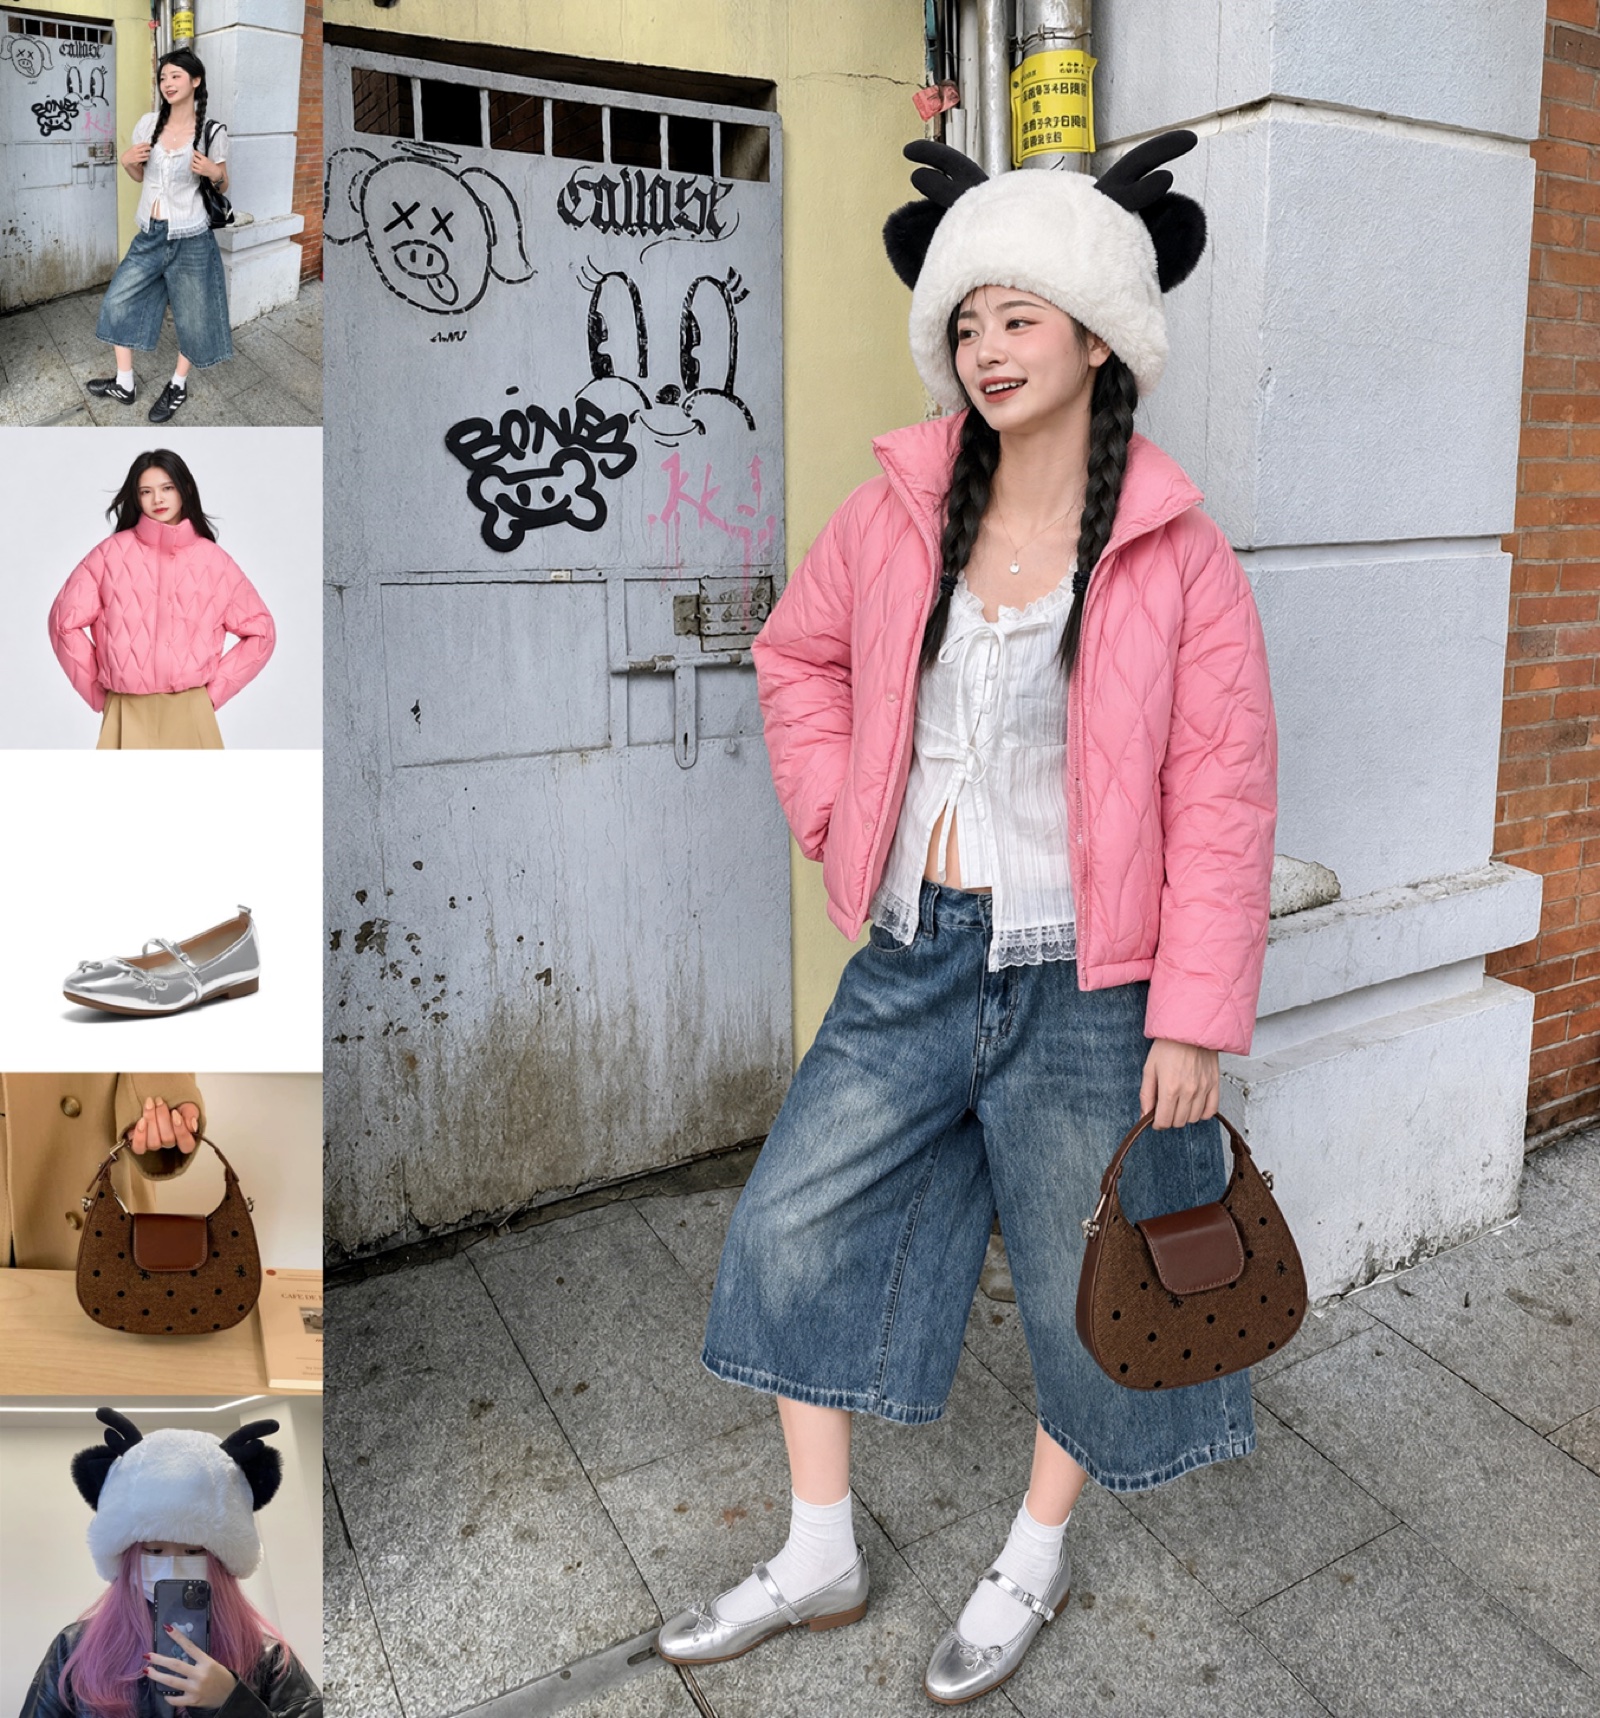
官方 Qwen-Image 2.1 示例:由五张引用图像组合出的一套穿搭,这正是 PE-I2I 重写模型被训练用来转换为明确提示词的那类多图像指令。
在 ComfyUI 中运行它们
ComfyUI 官方的三个 Qwen-Image 2.1 模板分别覆盖文生图、图像编辑和背景移除,但都没有调用重写模型。Comfy-Org 确实将两个 PE 权重重新打包为 int8 convrot 文件,放在 Comfy-Org/Qwen-Image-2.1 中(text_encoders/qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors 和 ..._pe_i2i...),但仅仅加载它们只是完成了一半工作:还得有东西来构建对话提示词、读回 JSON,并把结果提供给采样器。
该节点包正是为此提供了两个节点,两者都注册在 Qwen Image 类别下:
| 节点 | 输入 | 输出 |
|---|---|---|
QwenImage21_T2IPromptRewrite | CLIP、prompt、采样控制 | positive_prompt、negative_prompt、wh_ratio、thinking、parse_ok |
QwenImage21_EditPromptRewrite | CLIP、prompt、image_1 … image_10 | 同上,另加 ratio_follow |
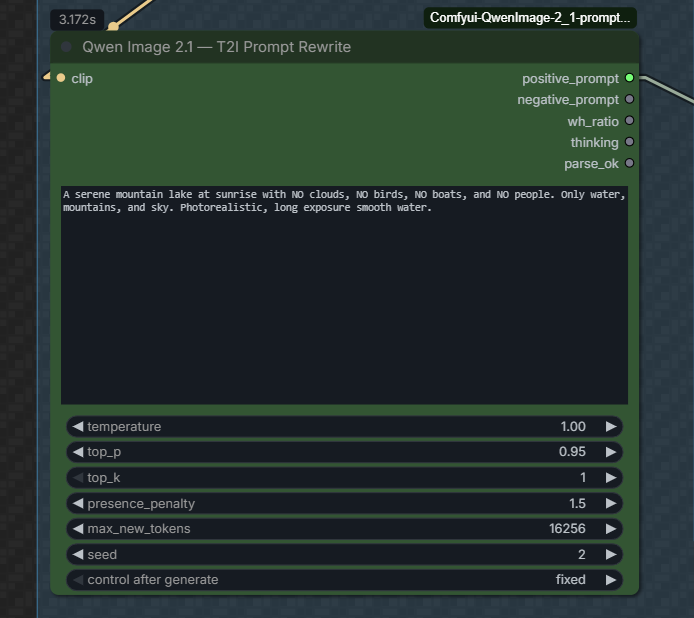
T2I 重写节点:输入一条简短提示词,输出展开后的提示词、宽高比与推理过程。
PE 文件由普通的 加载 CLIP 节点加载,type = qwen_image,生成过程走 ComfyUI 自带的 clip.tokenize() → clip.generate() → clip.decode() 路径,与内置 TextGenerate 节点使用相同的机制。无需外部服务器,也不需要单独的 transformers pipeline。
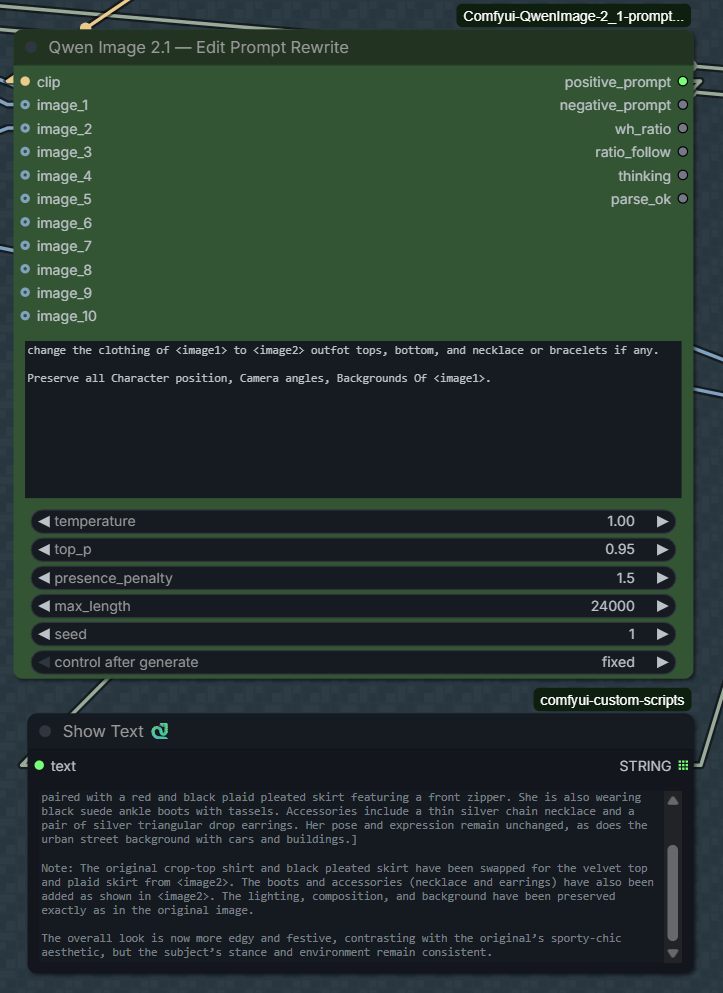
编辑节点提供十个图像槽位,返回重写后的指令以及需要继承的宽高比。
有几项设置值得直接照抄 README,因为这两个模型并不共用这些参数:
| 参数 | T2I | 编辑 |
|---|---|---|
presence_penalty | 1.5 | 0 |
max length | 16256 | 24000 |
thinking | 开启 | 开启 |
较高的惩罚值可避免文生图重写模型重复输出,而编辑重写模型则应在不启用该惩罚的情况下运行。两个模型都使用 think 块进行训练,因此该节点包会在解析 JSON 之前把推理过程与答案分离,并在答案能够干净解析时报告 parse_ok。安装可选的 json_repair 包后,还能挽救略有格式错误的答案,而不是直接失败。
将其接入节点图
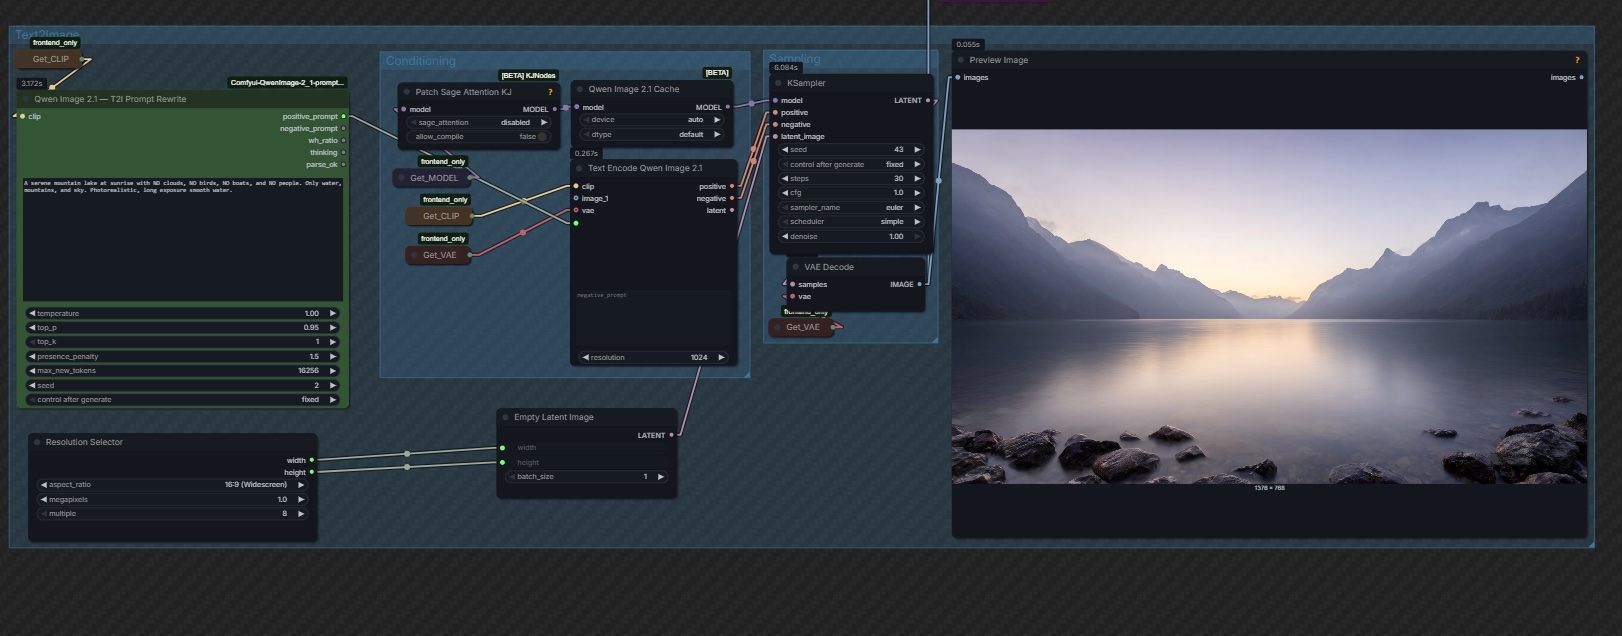
README 中的节点图:在 PE 模型上使用加载 CLIP,输出接入重写节点,其 positive_prompt 继续送入 Text Encode Qwen Image 2.1。
在文生图运行中,重写后的字符串会替代你原本要输入文本编码节点的内容,而 wh_ratio 可以驱动分辨率选择器,无需手动指定宽度和高度。在编辑运行中,引用图像会放入节点的图像槽位,指令中以 <image1>、<image2> 的方式引用它们,而 ratio_follow 决定输出画布应匹配哪张输入图像。
获取方式
- PE-T2I:Qwen/Qwen-Image-2.1-PE-T2I,已发布在 Hugging Face
- PE-I2I:Qwen/Qwen-Image-2.1-PE-I2I,已发布在 Hugging Face
- 适配 ComfyUI 的副本:Comfy-Org/Qwen-Image-2.1 中的
text_encoders/目录下,int8 convrot 格式 - 节点包:benjiyaya/ComfyUI-Qwen-Image-2.1-Prompt-Enhancer,克隆到
ComfyUI/custom_nodes/ - 官方重写代码:Qwen-Image 2.1 仓库中的
prompt_rewrite/,提供 transformers、vLLM 与 vLLM 服务器入口
评论
使用 GitHub 登录后即可参与讨论。