MiniMax H3 VFX Edit LoRA 带来提示词驱动的视频编辑
Alissonerdx 的 MiniMax H3 LoRA 包新增提示词驱动的 VFX Edit,并附带文档化的 Style Transfer 与 Head Swap 适配器,含 ComfyUI 工作流与示例片段。
该仓库正是九月更早报道的 H3 锐度 LoRA 背后的同一个仓库,也是使用量较高的 H3 LoRA 包之一,撰写本文时约有 239 个点赞和 26,600 次下载。所有模型都基于 H3 的 ref2va 权重训练,并共享同一套条件技巧:来源片段通过核心 MiniMaxH3AddGuide 节点在 frame_idx = 0 处作为对齐引导注入,因此模型看到的是逐帧对齐的原始素材,而不是松散的视频引用。
该包含有哪些内容
| 模型 | 功能 | 触发词 | 工作流 |
|---|---|---|---|
minimax_h3_vfx_edit_v1.0_r128 | 对已对齐的来源片段进行提示词驱动的 VFX 编辑 | vfx_edit: | minimax_h3_vfxedit_wokflow.json |
minimax_h3_vfx_edit_v1.0_r128_ffp | 更高分辨率的 VFX Edit,带实验性首帧传播 | vfx_edit: | 同一工作流 |
minimax_h3_style_transfer_v1.0_r64 | 依据图像或文本描述为整个片段重新设定风格 | style_transfer: | minimax_h3_style_transfer_workflow.json |
minimax_h3_head_swap_v1.0_r32 | 在已对齐片段上进行实验性头部替换 | head_swap: | minimax_h3_head_swap_workflow.json |
minimax_h3_lms_v1.0_r64 | 锐度与细节恢复(最初的适配器) | 固定提示词 | minimax_h3_lms_workflow.json |
除 LoRA 之外,还附带一个独立的 Latent 放大器实验,VFX Edit 权重于 2026 年 9 月 21 日上传。
VFX Edit
VFX Edit 是本次的重点新增功能:给它一个片段外加一句指令,它就会返回同一素材,且仅应用该修改。
vfx_edit: Add fire effects to the man's hands while preserving his identity, pose, motion, clothing, framing, lighting and background.文档推荐的写法是:先说明要做的编辑,再列出必须保持不变的内容,并且绝不要要求模型保留本就应由它替换的那块区域。已发布两个版本:
- 标准版(
r128)在 384 分辨率 Bucket 上以 73 帧片段训练,无需图像引用。 - FFP(
r128_ffp,首帧传播)在 512 Bucket 上以 124 帧片段继续该训练,并新增实验性支持:将编辑后的首帧通过 H3 原生图像引用通道推送。如果提供了图像,提示词必须明确写出<Picture 1>并说明其角色;如果没有提供,提示词则完全不能提及<Picture 1>或<Subject 1>。
运行方式:将完整来源片段放入 MiniMaxH3AddGuide,而不是视频引用槽位;匹配来源比例和受支持的帧数,并从 LoRA 强度 1.0 开始。官方公布的局限性坦率说明了它做不到什么:身份漂移、文字与徽标被改写、精细细节偏弱,以及长片段效果更差。它不是合成器,也不保证像素级完全保留。
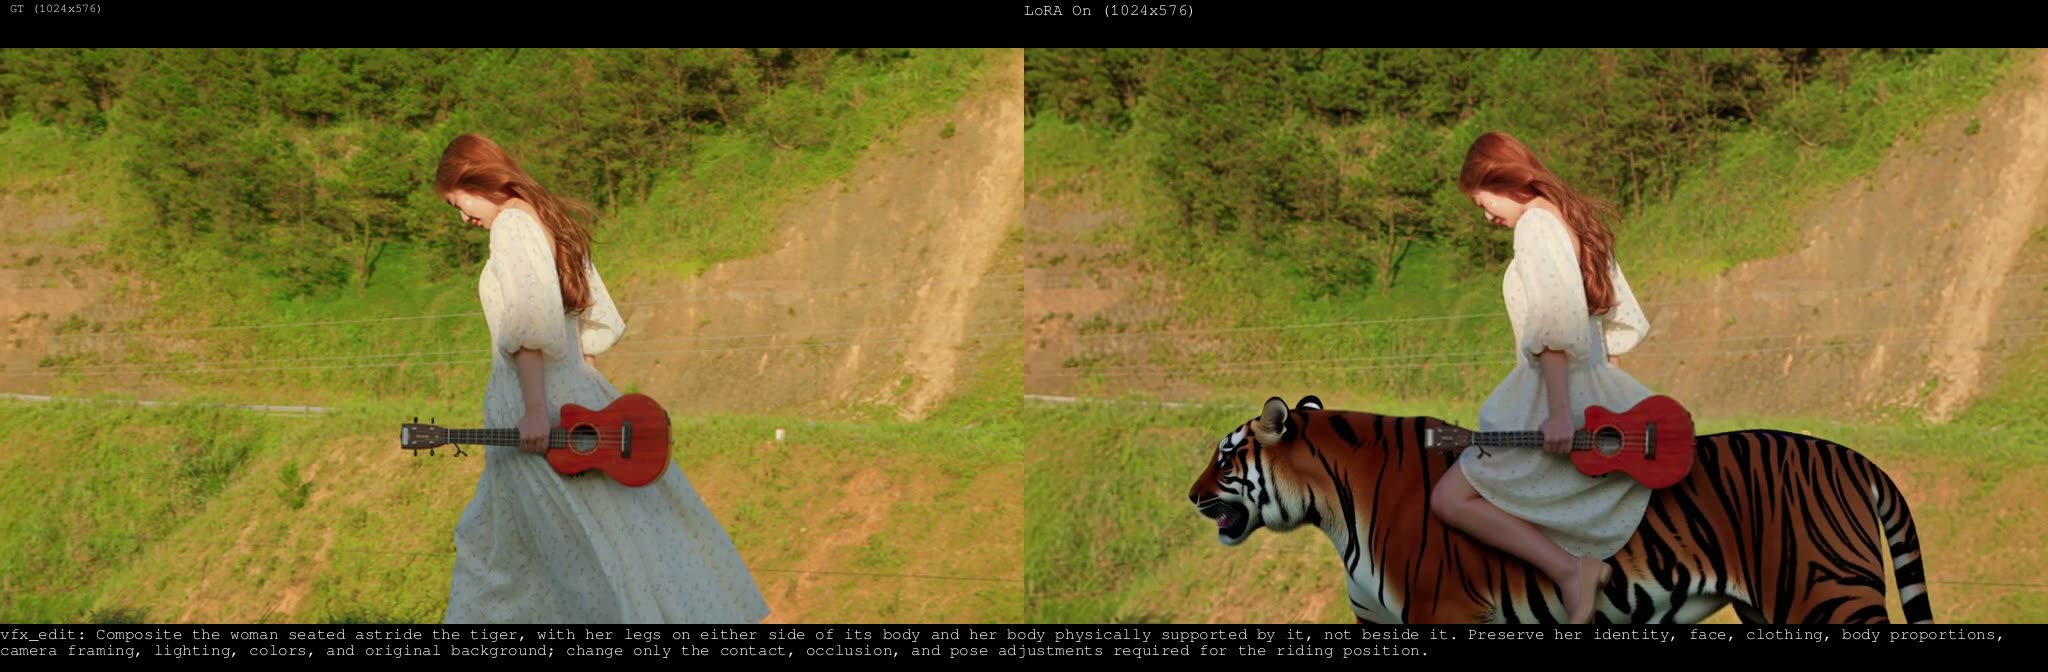 | 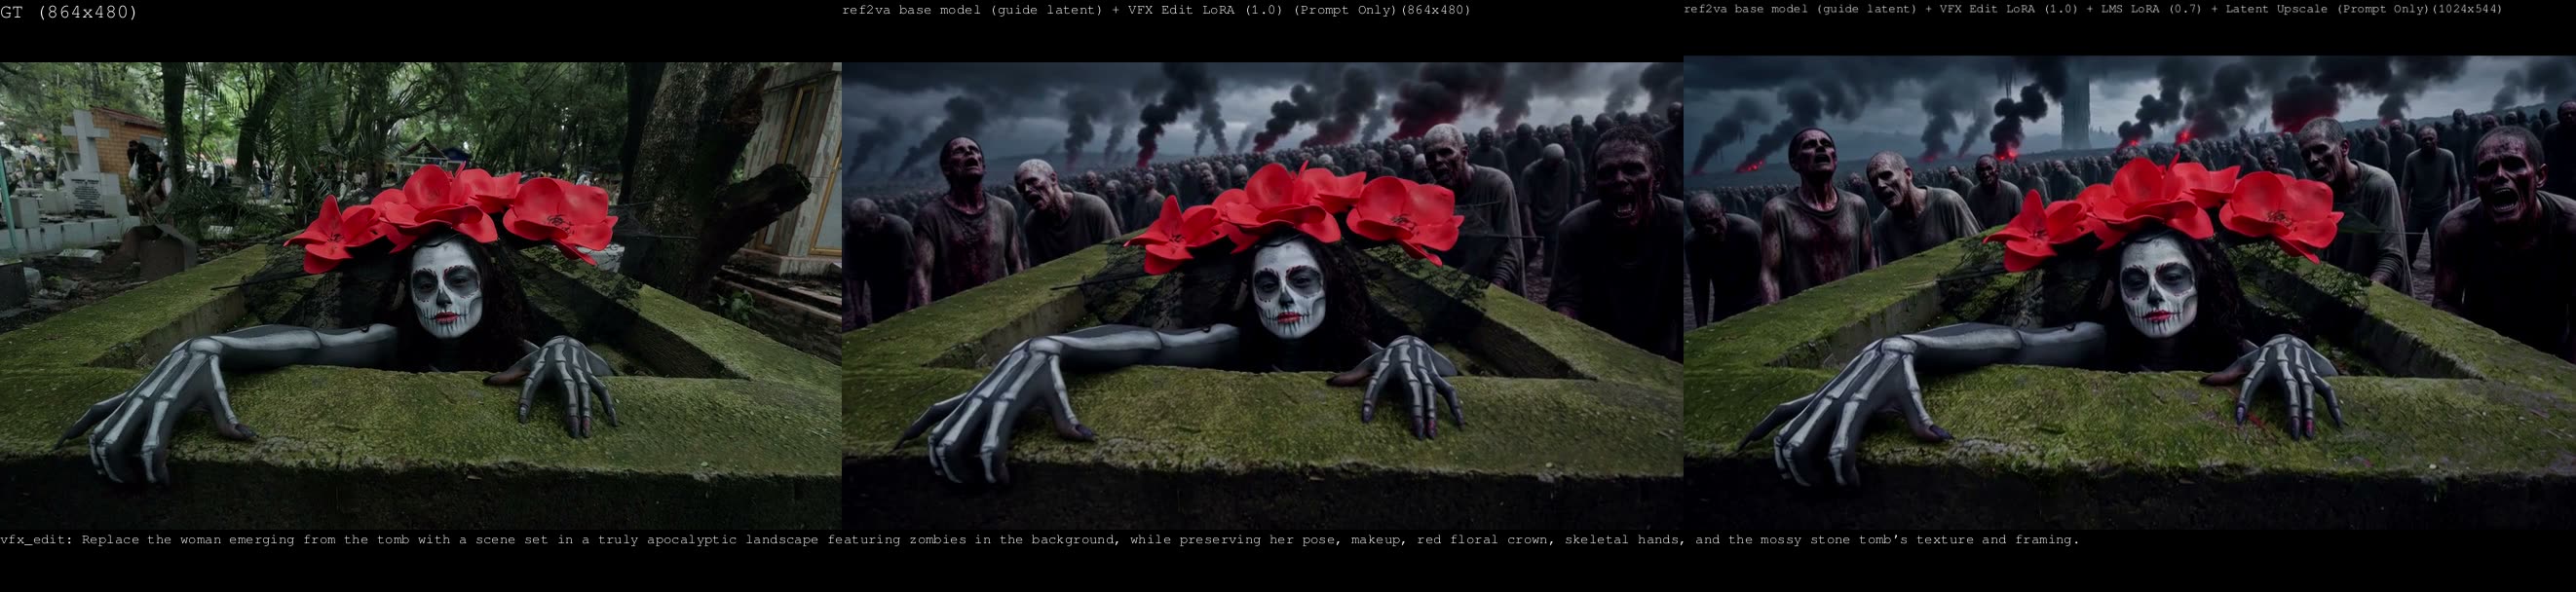 |
|---|---|
| 来自仓库的 VFX Edit 示例片段 | 第二个 VFX Edit 示例 |
Style Transfer 与 Head Swap
Style Transfer 会为整个片段重新设定风格,同时尽量保持运动、构图和时序不变。来源视频放入 MiniMaxH3AddGuide,风格图像作为 <Picture 1> 放入原生引用通道,强度为 1.0;如果风格开始压过原始运动,可降到约 0.7。对于基础模型本就熟悉的外观,仅用文本风格提示词也有效。文档提醒不要在用参考图像的同时提及某位艺术家,因为文本可能会盖过图像。
Head Swap 标记为实验性,它同时使用两条条件路径且角色不同:用于替换的脸部通过原生引用通道作为 <Picture 1> / <Subject 1> 传入,而完整的基础视频则以 <Video 1> 通过 MiniMaxH3AddGuide 在 frame_idx = 0 处传入。基础视频不得经由原生视频引用通道传递。文档还附有明确的责任使用声明:仅限研究与创作用途,不得用于冒充、欺诈或欺骗。
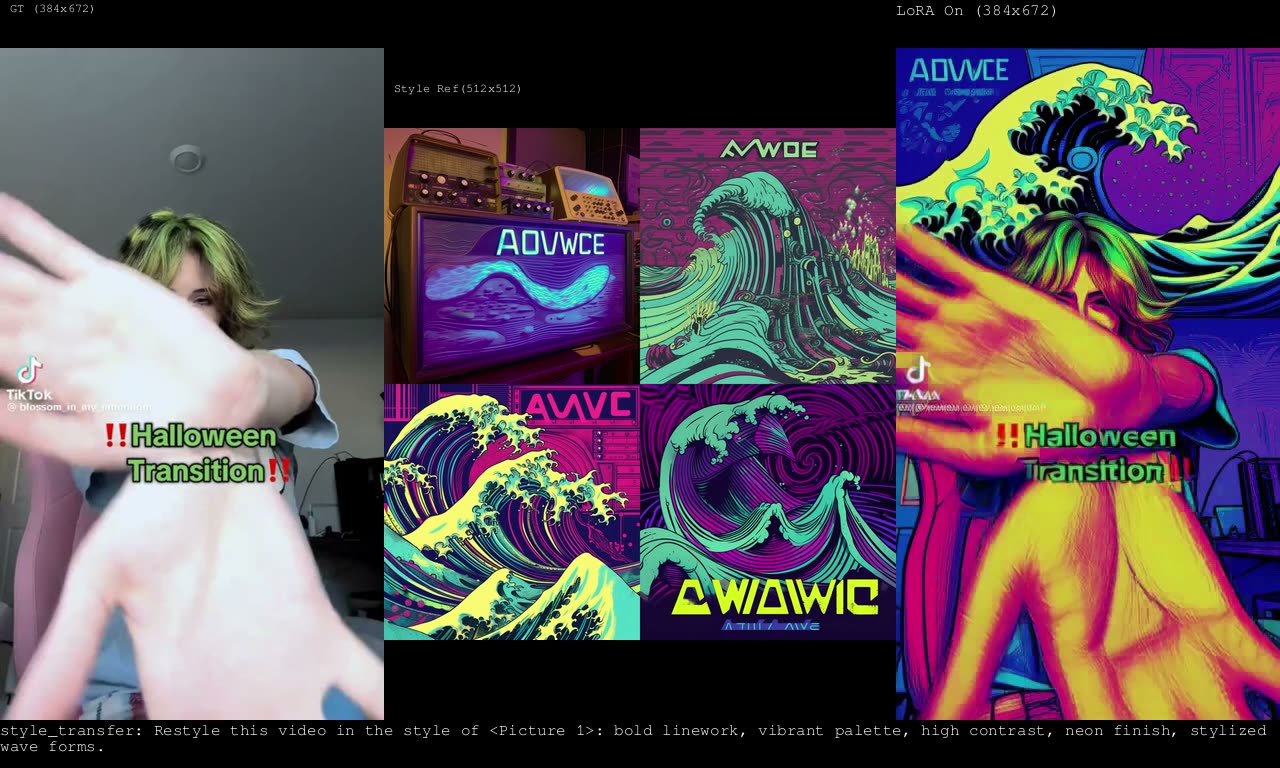
来自仓库的 Style Transfer 示例
Latent 放大器实验
该包还记录了一个实验性的 Latent 放大器 checkpoint h3_upscaler_lms_v0.1,它从 LBH-123-AI latent upscaler 起步,并在与 LMS LoRA 相同的锐度数据集上微调了 2,000 步。同样的权重发布了两份,分别位于 latent_upscaler/ 和 experiments/ 下,指南中明确说明目前还没有为它上传专门的示例视频或工作流。
获取方式
从仓库下载这些 LoRA,放入 ComfyUI/models/loras/,然后从 workflows/ 文件夹加载匹配的工作流:每个工作流都会列出它所需的模型。LoRA 的条件路径本身基于核心 MiniMax H3 节点(包括 MiniMaxH3AddGuide)运行,但随附的示例工作流还会通过第三方节点包来加载视频、缩放帧尺寸并运行潜空间放大器,请按各工作流自带的说明补齐缺失节点。
评论
使用 GitHub 登录后即可参与讨论。