CrossView-Warp LoRA:为 MiniMax H3 视频带来全新相机角度
Cseti 将 CrossView-Warp 移植到 MiniMax H3:一个 Ref2VA LoRA,外加一个 ComfyUI 节点,借助 MoGe 深度变形从新的相机角度重新渲染现有素材。
这是 CrossView 系列的第三个版本,前两个是 LTX-2.3 IC-LoRA 版本;它也是首个基于 MiniMax H3 Ref2VA 构建、而非依赖提示词驱动的相机描述语的版本。该节点不再靠文字描述相机该往哪里移动,而是用真实几何关系对现有素材进行变形,并把结果作为引导交给模型,因此新角度会落在深度图所指示的位置上。
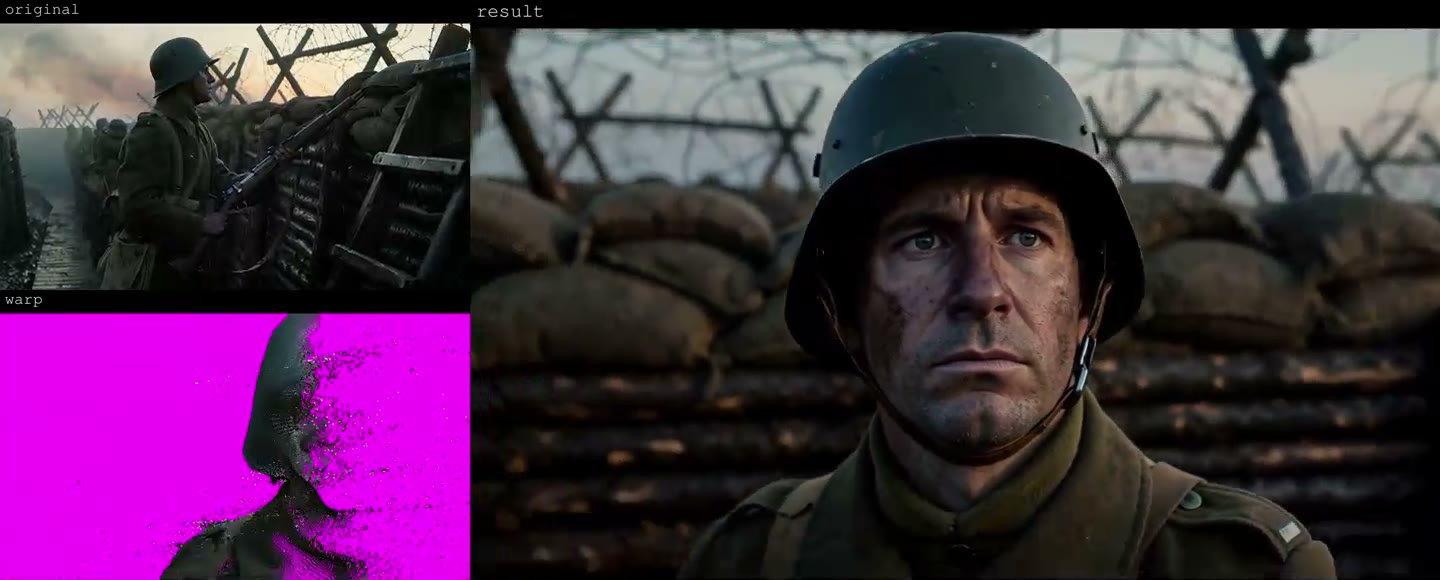
模型页面上的每段片段都是三联对比:深度变形、原始素材和已生成结果。
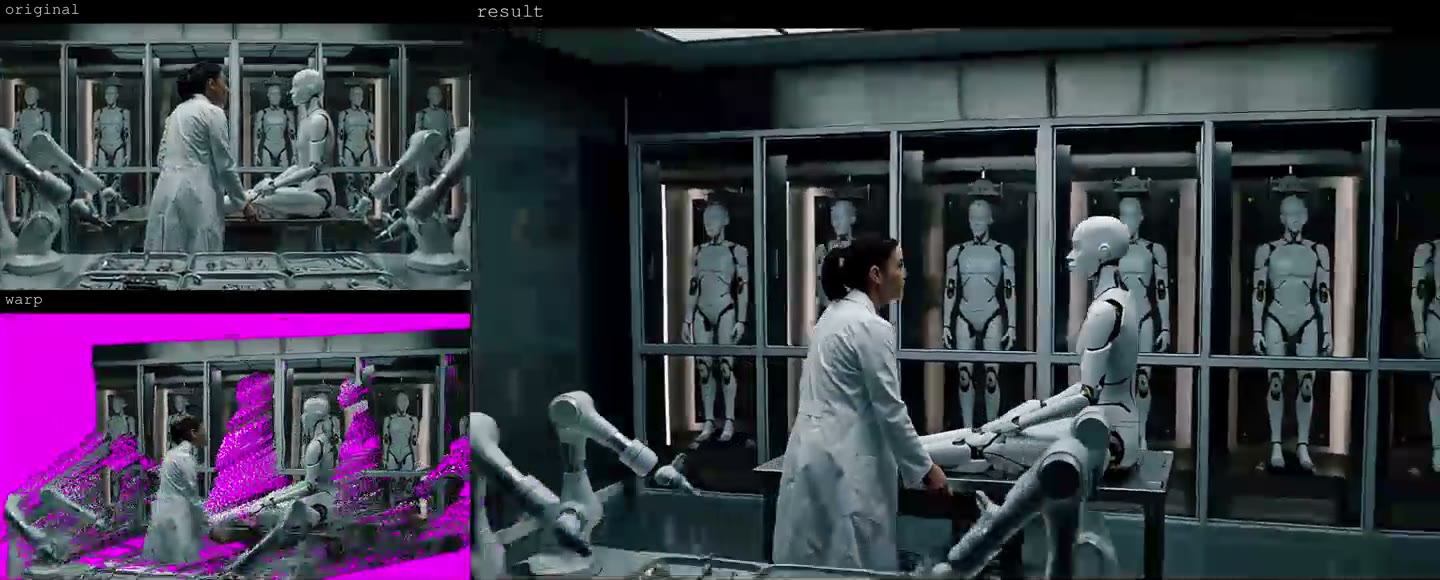 | 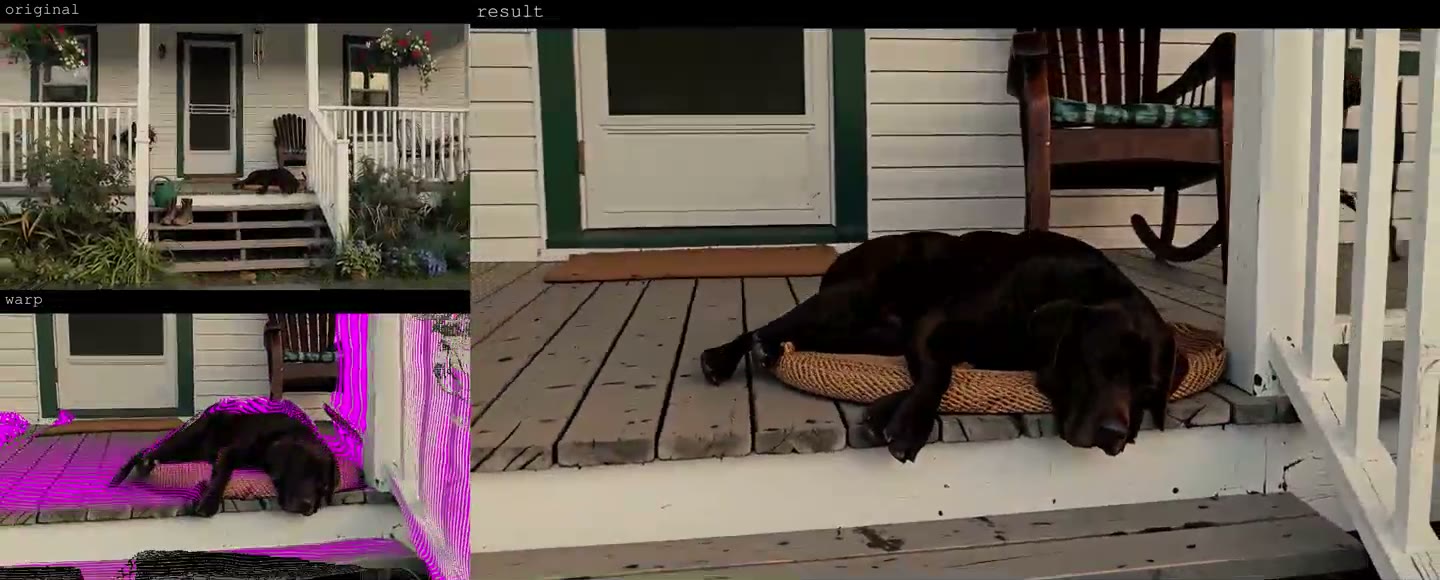 |
|---|---|
| 第二个相机运动 | 第三个相机运动 |
工作原理
该 LoRA 会同时读取两段视频。第一段是你片段的深度变形,由运行 MoGe 几何推理的 CrossViewWarp 节点生成,它承载视角变化。第二段是片段本身,它承载身份、光照与外观。变形结果在第 0 帧进入模型的引导路径,来源片段进入引用路径,而 crossview 触发词会启用该适配器。
由于几何信息来自变形而非文本提示词,相机偏移在节点中以数值方式设定,其控制界面与 LTX 版本相同。原始相机从未看到的区域会在节点预览中被标记出来,你可以通过提示词指定那里应出现的内容。
提示词与设置
触发词为 crossview。LoRA 强度范围为 0.8 到 1.0,在四步蒸馏路径上推荐使用 0.8。
| 设置 | 数值 |
|---|---|
| 触发词 | crossview |
| LoRA 强度 | 0.8(0.8 到 1.0) |
| 帧数 | 124 |
| 第一遍 | 0.5 MP,16:9 |
| 第二遍 | 1.5 MP,16:9 |
| 采样器 / 步数 | res_multistep,配合 DMD 8 步 turbo LoRA 使用 8 步 |
| Sigma 偏移 | 视频 12 / 音频 3 |
该节点的操作演示视频讲解了相机控制,上面的设置正是发布示例所用的那套设置。
训练详情
| 参数 | 数值 |
|---|---|
| 基础模型 | MiniMax H3,ref2va |
| 框架 | musubi-tuner(minimax-h3 分支) |
| 策略 | Ref2VA,aligned_guide_indices = [0] |
| 已发布的 checkpoint | 6,000 步中的第 3,500 步 |
| LoRA 秩 / alpha | 32 / 32 |
| 优化器 | adamw8bit,1e-4 |
| 基础精度 | INT8 ConvRot |
| 训练分辨率 | 512x512,73 帧 |
| 训练计划 | 6,000 步,批处理大小为 1 |
| 实测 | 单步 20.35 秒,在 RTX PRO 6000 Blackwell 上耗时 33 小时 55 分钟 |
训练集与 LTX v2 版本所用的相同,为 719 个 Blender 场景,按不同相机偏移渲染,使适配器学习变形与其所隐含视角之间的关系。
获取方式
该适配器以单个 safetensors 文件发布,可加载到 H3 ref2va checkpoint 上。发布说明指出,原始相机从未看到的区域会在节点预览中被特别标出,并且可以使用引用图像或提示词来引导这些区域生成的内容。
LoRA: Cseti/MiniMax-H3_Ref2VA-LoRA-CrossView-Warp_v1
节点: cseti007/ComfyUI-CrossViewWarp
基础模型: MiniMaxAI/MiniMax-H3
评论
使用 GitHub 登录后即可参与讨论。