Viggle Meridian 为 ComfyUI 带来几何引导重摄像模型
Viggle Meridian 通过几何渲染为 MiniMax H3 视频重新取景:输入现有视频加一条相机路径,即可获得全新视角。两个 LoRA、两个节点,开箱即用的工作流。
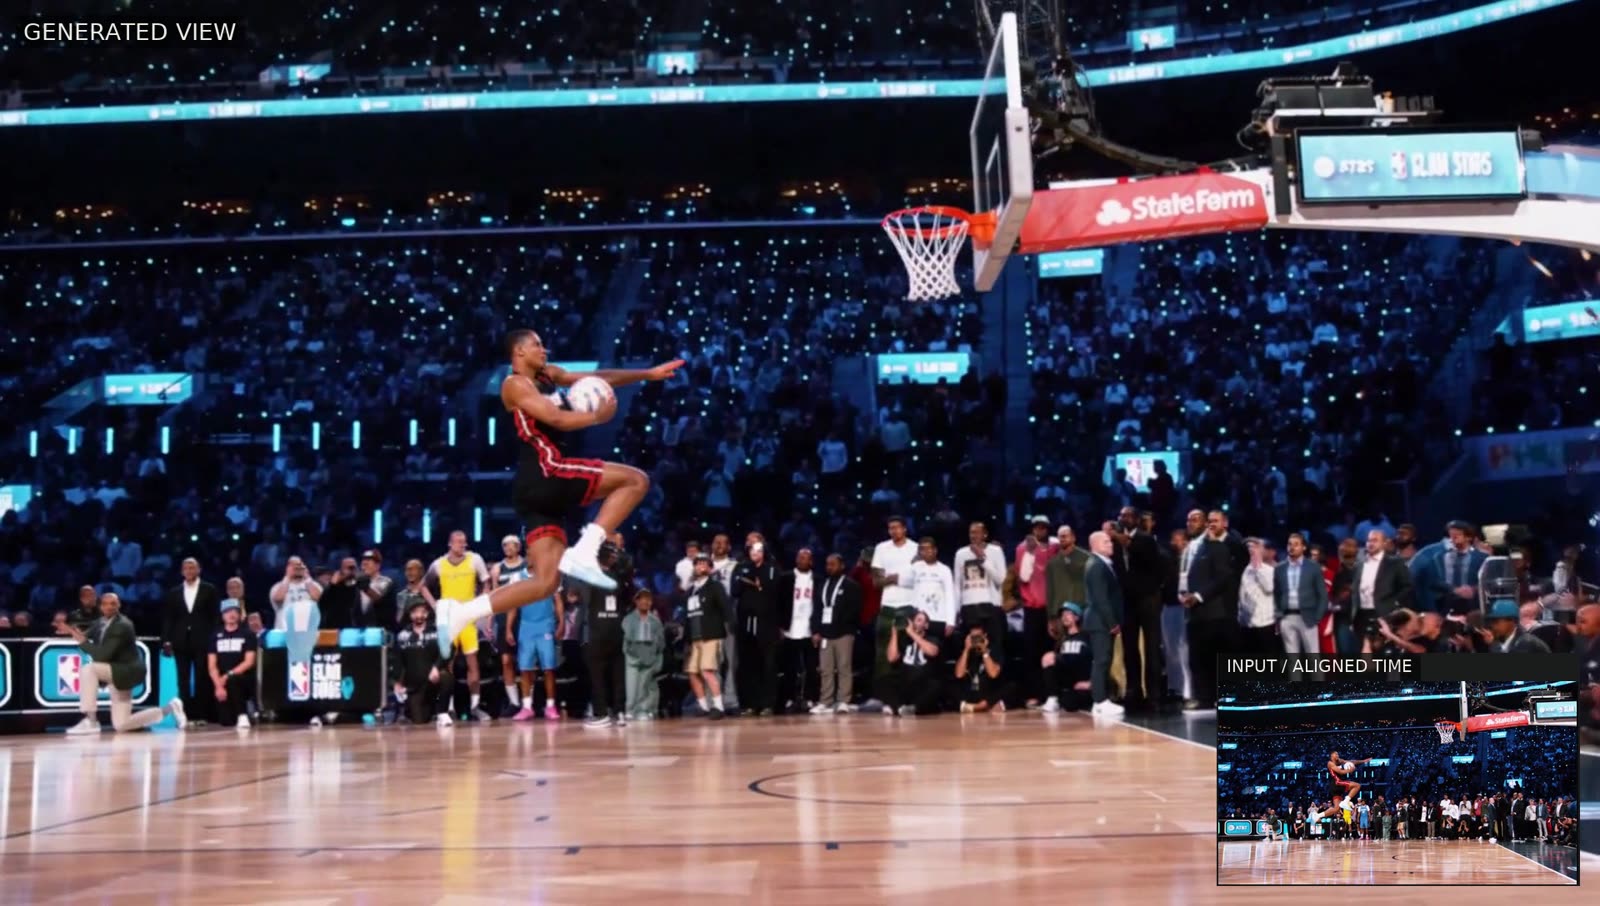
从新角度观看的一次扣篮。该剪辑将已生成视角与取自原始素材的画面混合在一起。
工作原理
Meridian 把这项工作拆分为几何与生成两部分,而不是让视频模型凭空想象一次相机运动:
- 构建几何。 VGGT-Omega 从输入视频中估计深度和相机位姿,已选择的帧会变成彩色的 3D 点。
- 渲染新视角。 对于每个输出帧,输入中的一个时刻会与选定的相机视点配对,并从该角度渲染这些点。原始相机从未看到的区域会显示为灰色空洞。
- 生成镜头。 源视频和与之匹配的渲染视频都会作为引用输入 Meridian,由它填补空洞并细化结果。
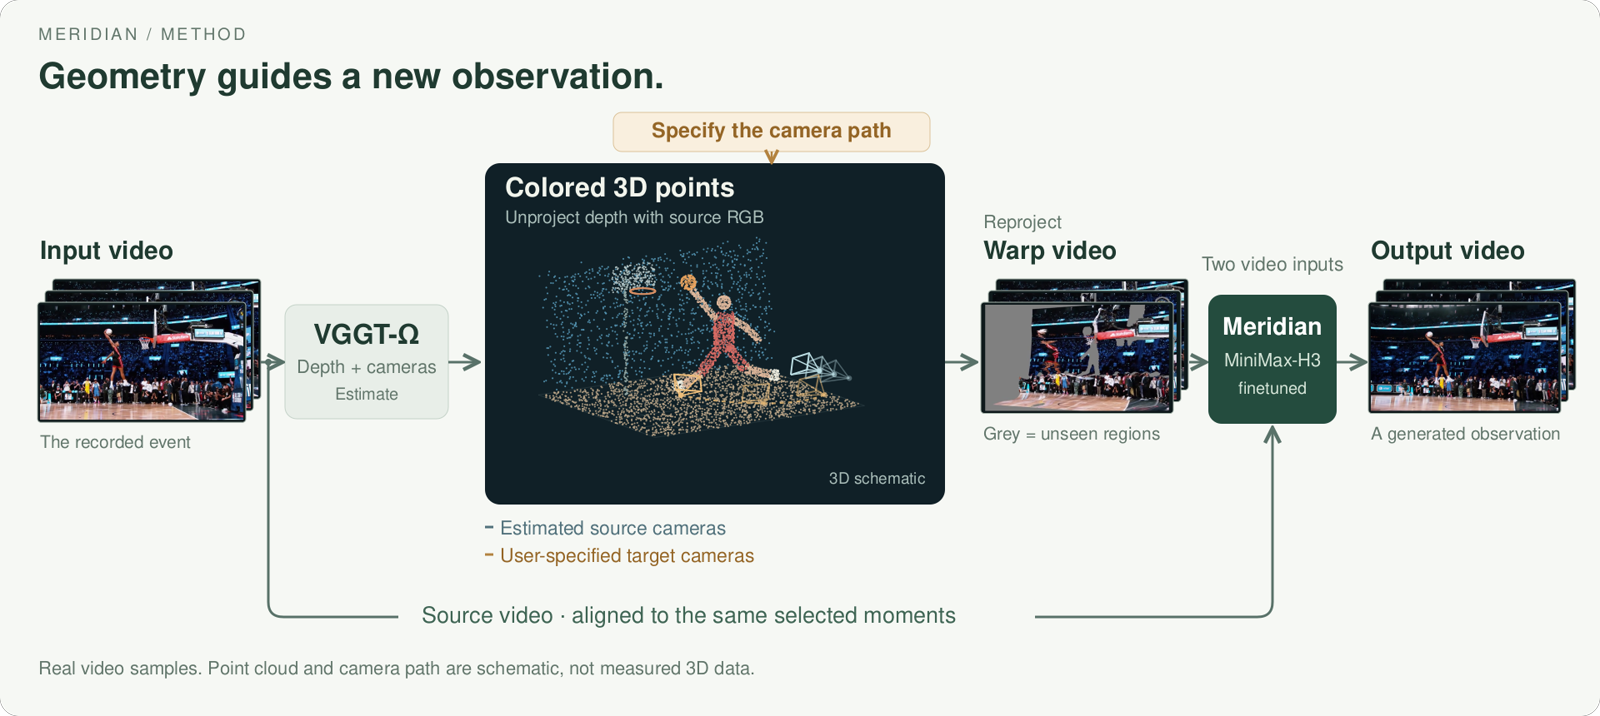
由 VGGT-Omega 得出的深度与相机位姿,沿选定路径渲染。帧是真实的,点和相机为示意图。
由于点一旦存在,几何渲染的成本就很低,因此可以在视频模型运行之前预览取景、发现缺口并调整路径。空间和时间是分开控制的:选择从何处观看、选择观看哪一时刻,并决定二者如何衔接,这正是它能实现子弹时间风格运镜的原因,但这并非该模型唯一能做到的效果。
两个 LoRA,无需合并的 checkpoint
Meridian 使用 MiniMax H3 的 transformer 和 VAE,推理时不加载文本编码器:任务的文本 embedding 是预先计算好的,transformer 架构保持不变。
| 组件 | 作用 |
|---|---|
teacher_lora/ | 读取几何渲染的重摄像适配器。2.5 GiB,其自身的网格为 --steps 50 --flow-shift 12 |
turbo_lora/ | 将 teacher 蒸馏为 3 次前向。2.5 GiB,默认 --steps 4 --flow-shift 3 |
legacy/ | 首个发布版本:一个 61.7 GiB 的融合 transformer 及其适配器,为可复现性而保留 |
两个适配器会一起加载,且都不应合并到基础权重中。默认运行会以权重 1.0 将它们相加,这正是 turbo 蒸馏时所针对的组合:在 bf16 下合并是有损的,而对 turbo 来说,合并基本上会抹掉全部的更新。
在 ComfyUI 中运行
Viggle 在 comfyui/ 下以 ComfyUI 通用 LoRA 格式发布了这两个适配器,同时还提供了两个自定义节点文件和两个 API 格式的节点图。将任一节点图拖放到画布上,前端即可构建出它。
- 从 Comfy-Org/MiniMax-H3 加载
minimax_h3_fl2va_bf16.safetensors。Meridian 是在 H3 的fl2va分区上训练的,因此ref2va文件是错误的底模。 - 先应用
comfyui/meridian_teacher_lora.safetensors,再应用comfyui/meridian_turbo_lora.safetensors,两者强度均为 1.0。 - 使用
euler采样器、simple调度器,cfg设为 1.0。由于没有负面分支,请把同一份条件接入两个输入。 - ComfyUI 的
steps比仓库中的--steps少 1,因为它的调度器会追加末尾的零:turbo 组合使用MiniMaxH3SigmaShift3.0,steps为 3;仅使用 teacher 时为 shift 12.0,steps为 49。
输出为 24 fps,画布属于 768 级别并按宽高比匹配:16:9 的输入对应 1344x768。有效长度为 73、90、107、124、141、158、175 或 243 帧,每段大约 3 到 10 秒。CLI 按索引读取帧,因此源素材应是恒定 24 fps 导出的连续镜头;它不会规范化帧率,也不会检测剪辑点。
示例
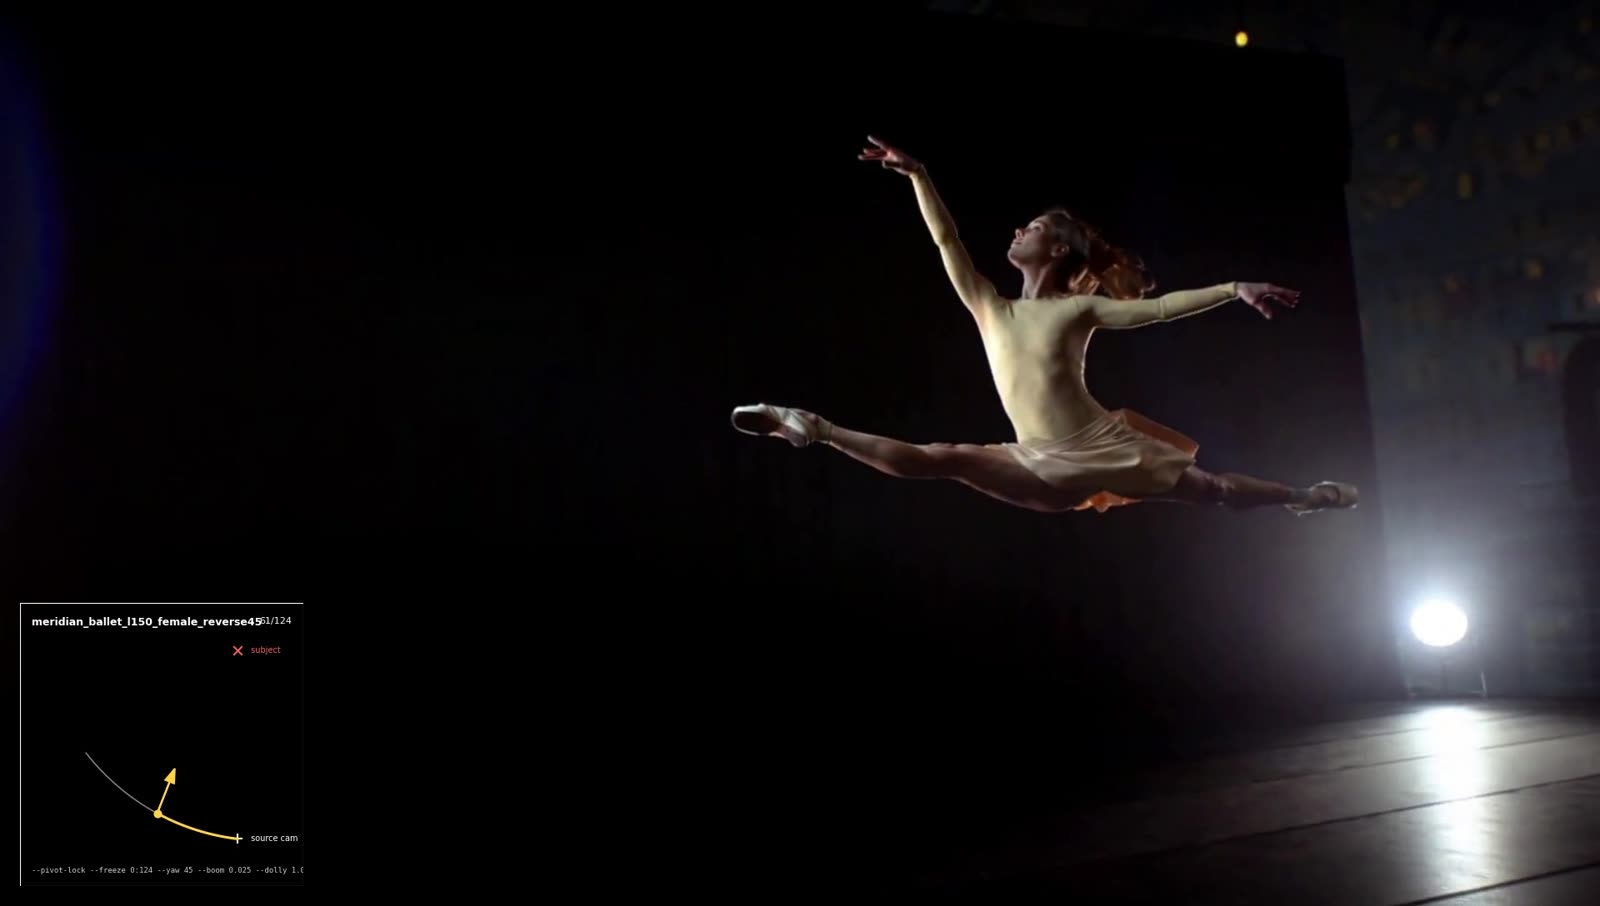
仅用一张静态照片创作的相机运动。
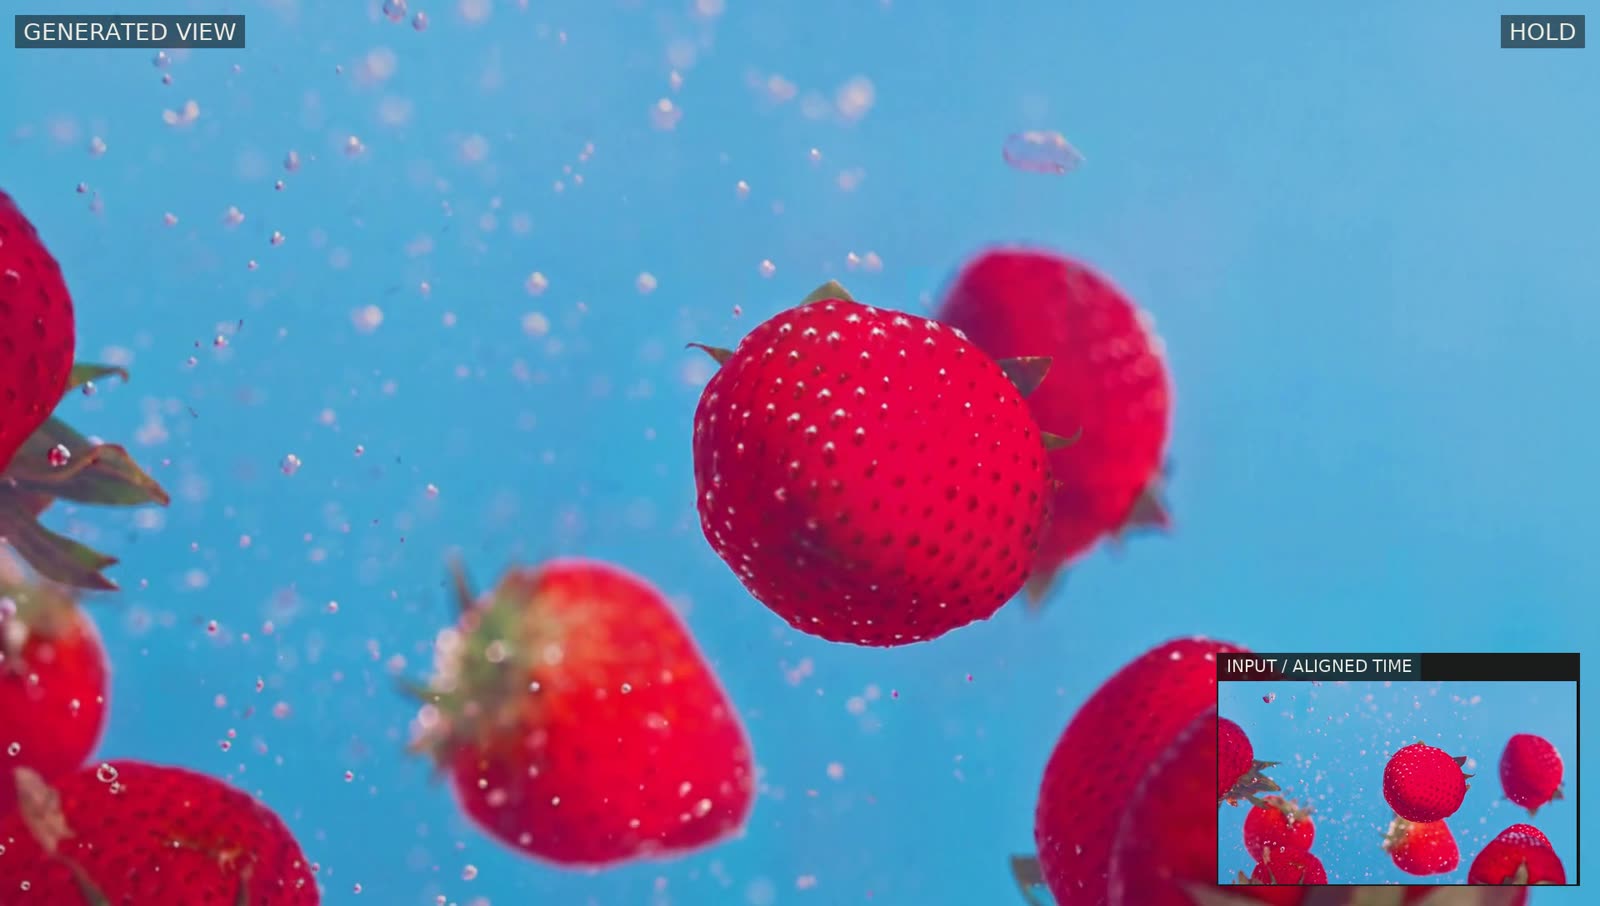
源时间前进,在相机运动时保持,然后继续。
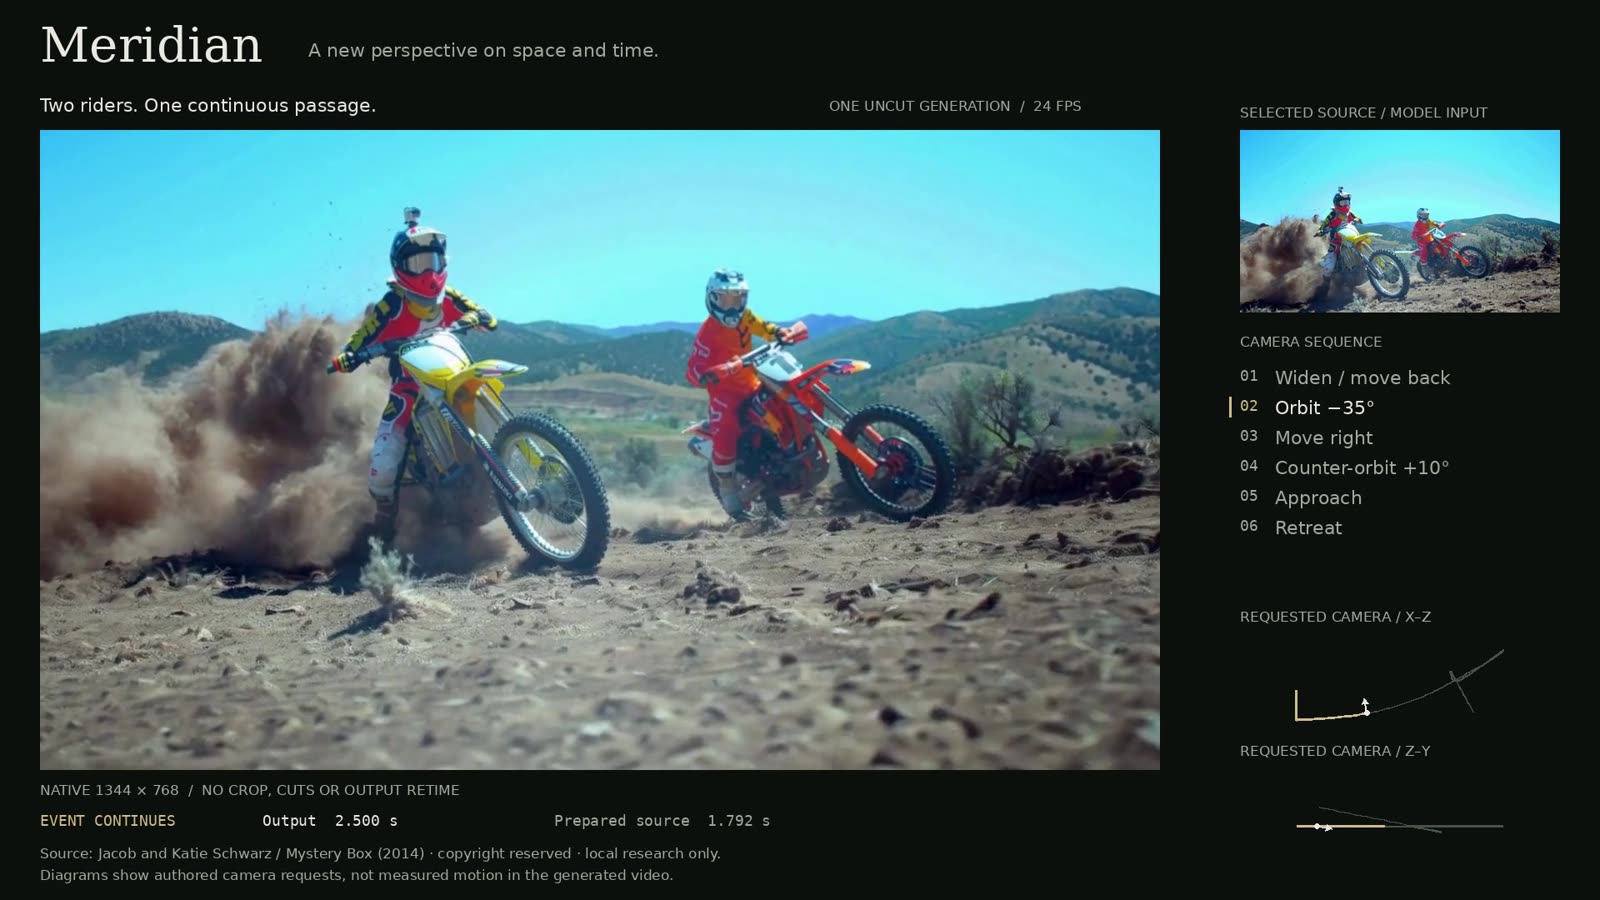
在单个连续镜头中环绕、横向移动并改变距离。
依赖项与限制
参考实现运行在一块高显存的 CUDA GPU 上,目前不提供量化、CPU 卸载或多 GPU 分片,因此消费级显卡暂时无法胜任。Viggle 明确邀请社区将 Meridian 带到 RTX 4090 等更小的 GPU 上,并指出保留 H3 的架构、去掉文本编码器是节省内存工作的一个有用起点。VGGT-Omega 的几何模型需通过其自身的仓库单独获取,并未与这些适配器捆绑提供。
获取方式
权重、适配器、ComfyUI 节点、节点图以及推理 CLI 都可在 Hugging Face 上获取。该仓库还包含示例片段,以及一个原型 Studio,可在正式生成之前借助实时 3D 反馈设计相机路径。
评论
使用 GitHub 登录后即可参与讨论。