Supra2-IMG:10 小时训练完成的 1 亿参数文生图模型
ComfyUI Wikinews
SupraLabs 发布 Supra2-IMG:一个 1.05 亿参数的 DiT 文生图模型,在单张 H100 上从零开始训练仅用 10 小时,样本分辨率为 256x256。
SupraLabs 发布了 Supra2-IMG,一个用于文生图的 1.05 亿参数扩散 transformer。它在单张 H100 上从零开始训练了 10 小时,作者称其结果是该参数预算下的当前最佳水平。
来自模型仓库的 Supra2-IMG 官方横幅。
它是什么
Supra2-IMG 是一个极小的 DiT:1.041 亿参数,基于 128 个 token 的 Flan-T5 条件生成 256x256 图像。文本条件来自冻结的 Flan-T5-Base 编码器,Latent 由 SD-VAE-FT-MSE 解码,因此这两个组件都从各自的仓库获取,而不是打包在 checkpoint 中。
| 组件 | 值 |
|---|---|
| 参数 | 1.041 亿(D_MODEL 576,深度 14,9 个注意力头,头维度 64,MLP 比例 4.0) |
| 分辨率 | 256x256(32x32 Latent,补丁大小 2) |
| 文本编码器 | Flan-T5-Base,冻结,128 token 上下文 |
| VAE | SD-VAE-FT-MSE |
| Checkpoint | model_final_ema.pt |
SupraLabs 是 1 亿参数 Supra2 语言模型背后的独立实验室,Supra2-IMG 将同样的"小规模、从零开始训练"思路应用到图像生成上。该模型以原始 PyTorch 代码加权重的方式发布:inference.py、config.json 和 model_final_ema.pt。
训练
这次训练刻意保持克制,而这正是本次发布的意义所在:
- 数据集:在完整的 LucasFang/FLUX-Reason-6M 数据集上训练 10 个 epoch,准备完成后共 560 万张图像。
- Caption 选择:每张图像按
caption_composition到caption_entity到caption_text到caption_style到caption_imaginative的顺序取第一个可用的 caption,为每个样本保留质量最高的标注。 - 硬件:RunPod 上的一张 Nvidia H100 SXM 80GB,包含数据准备在内共 9 小时,使用 2.5TB 磁盘。
由于整个模型只有几百兆字节,它非常适合作为研究小规模预训练以及微调实验的基础,而在 8B 规模下这些实验会昂贵得多。
样本
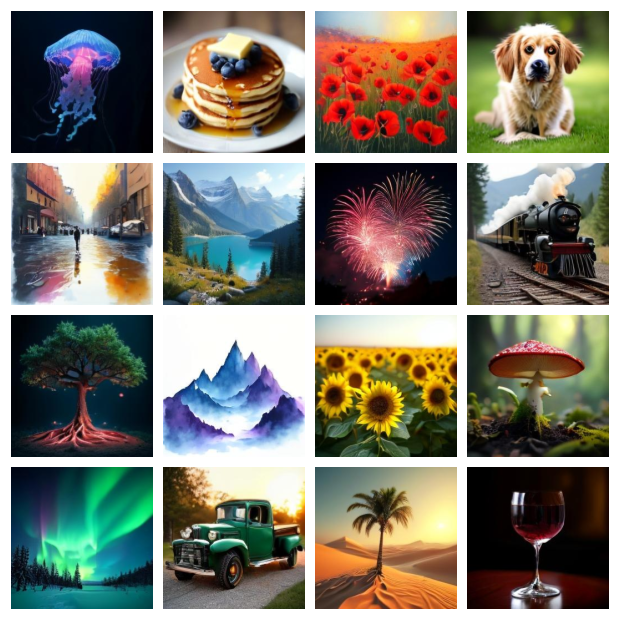
来自模型仓库的官方样本,全部使用推荐设置生成,而非精挑细选的运行结果。
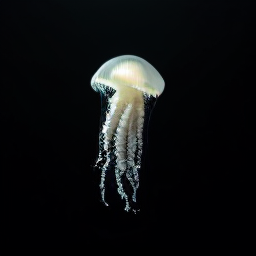
由随附推理脚本生成的 256x256 示例输出。
可用性
目前没有 ComfyUI 支持:Supra2-IMG 是纯 PyTorch 发布版本,采用自定义的 SupraDiT 架构,因此它不是 diffusers pipeline,官方也没有发布 ComfyUI 模板或节点。运行它需要使用随附脚本加上两个外部组件:
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/inference.py
python inference.py --prompt "a sea jellyfish floating in the pitch-black ocean depths" \
  --seed 0 --cfg 3.0 --steps 50 --n 1 --out jellyfish.png
推荐的采样设置为种子 0、CFG 3.0 和 50 步。
- 权重与代码:SupraLabs/Supra2-IMG
- 文本编码器:google/flan-t5-base
- VAE:stabilityai/sd-vae-ft-mse
- 实验室:supra-labs.com
评论
使用 GitHub 登录后即可参与讨论。