Qwen-Image 2.1:ComfyUI 中的 7B 文生图与编辑模型
Qwen-Image 2.1 是阿里巴巴的 7B 开放权重图像模型,原生支持 RGBA 透明度,可基于最多 10 张引用图像进行编辑,并在发布首日获得 ComfyUI 支持与官方模板。
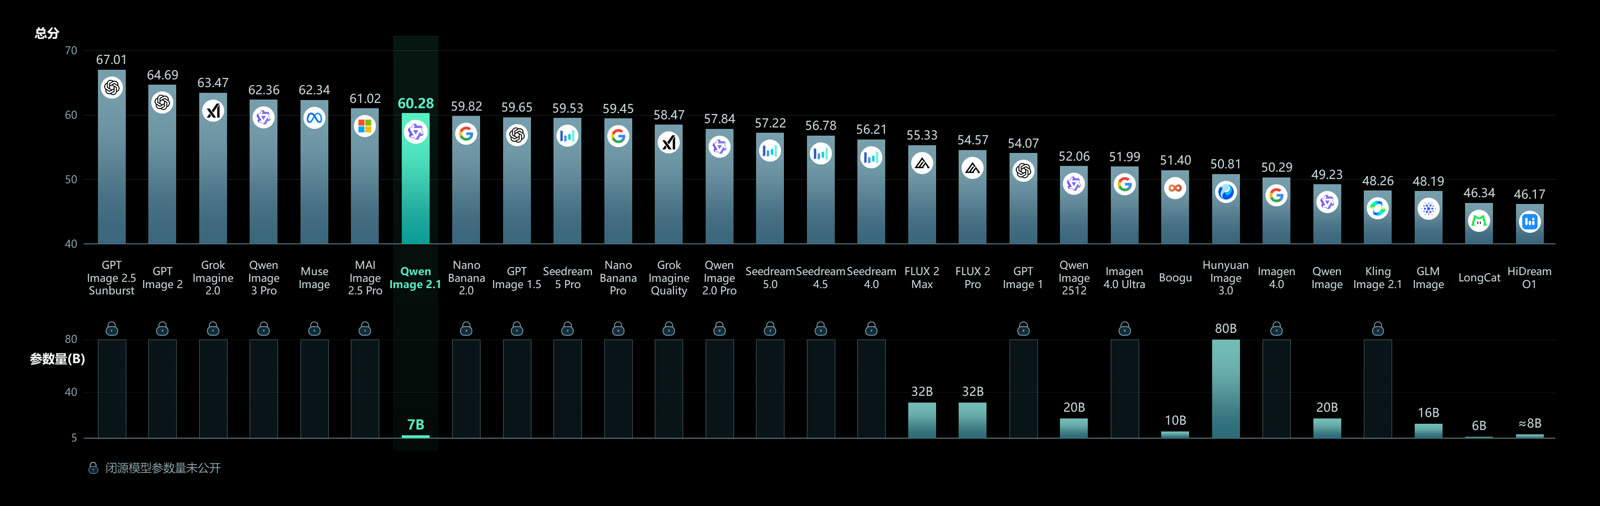
来自官方 Qwen-Image 2.1 模型卡的示例。
Qwen-Image 2.1 有哪些新变化
此前的 Qwen-Image 生成使用 20B MMDiT 主干,搭配 Qwen2.5-VL-7B 文本编码器。Qwen-Image 2.1 将视觉生成部分替换为由 32 层单流 DiT 组成的 7B 组件,四项主要变化如下:
- 紧凑高效。 混合粒度注意力加上前缀 KV 缓存复用,在保持高质量的同时,算力成本远低于 20B 系列。
- 原生透明度,生成与编辑统一。 同一个模型既能根据文本写出普通或透明(RGBA)图像、编辑透明图层,也能从照片中提取主体。
- 多样化的编辑能力。 单次请求最多支持 10 张引用图像,可用圆形、手绘标注或独立遮罩指定局部编辑,并为人像与商品保持身份一致性。
- 逼真的纹理与更精致的美学。 更出色的文字排版、人像布光与精细细节。
原生输出尺寸比旧版工作流使用的 1024 级别正方形更宽:1:1 为 2048x2048,4:3 为 2400x1792,3:2 为 2528x1696,16:9 为 2752x1536,并有对应的竖版比例。
带真实透明度通道的透明图像
最引人注目的特性是透明度能够保留到文件之中。Qwen-Image 2.1 不再先在平面背景上生成、再用单独的抠图模型切出主体,而是自己写入透明度,因此贴纸、产品渲染图或 UI 素材生成后即可直接用于合成。模型卡推荐使用明确的提示词格式来触发这一能力:
This is an RGBA image with transparency. <your subject description>.
The image has alpha channel and the background is transparent.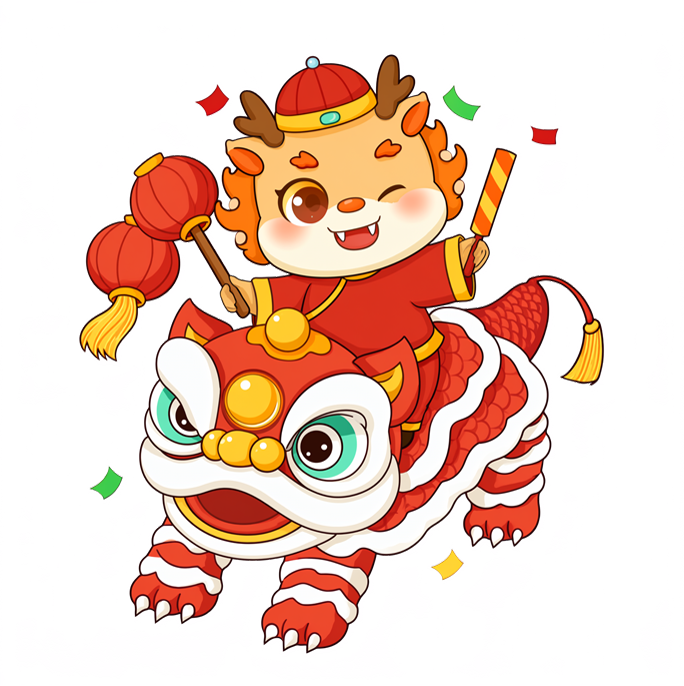
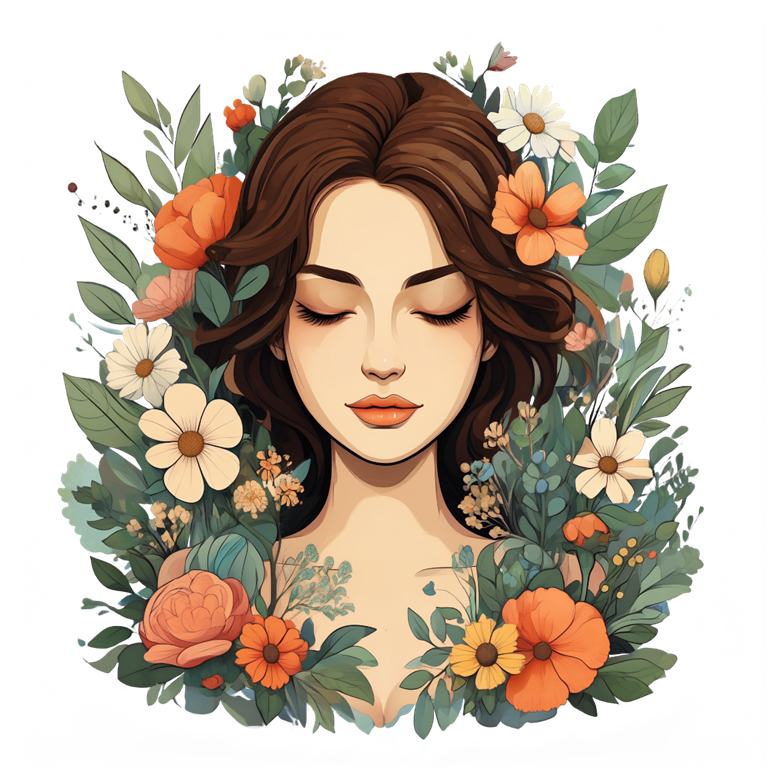
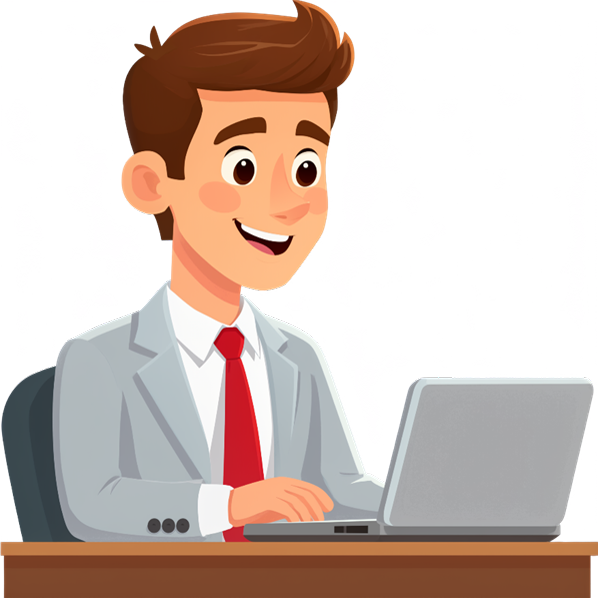
原生透明图像生成,直接取自官方展示。这些文件带有透明度通道,而不是画上去的棋盘格。
基于最多十张引用图像进行编辑
编辑场景最能体现引用图像数量的价值。Qwen-Image 2.1 单次可接受最多十张图像,因此无需把多次生成拼接起来,就能完成群组构图、多商品场景和角色设定表。局部编辑可以用圆形、手绘标注或遮罩节点来指定。
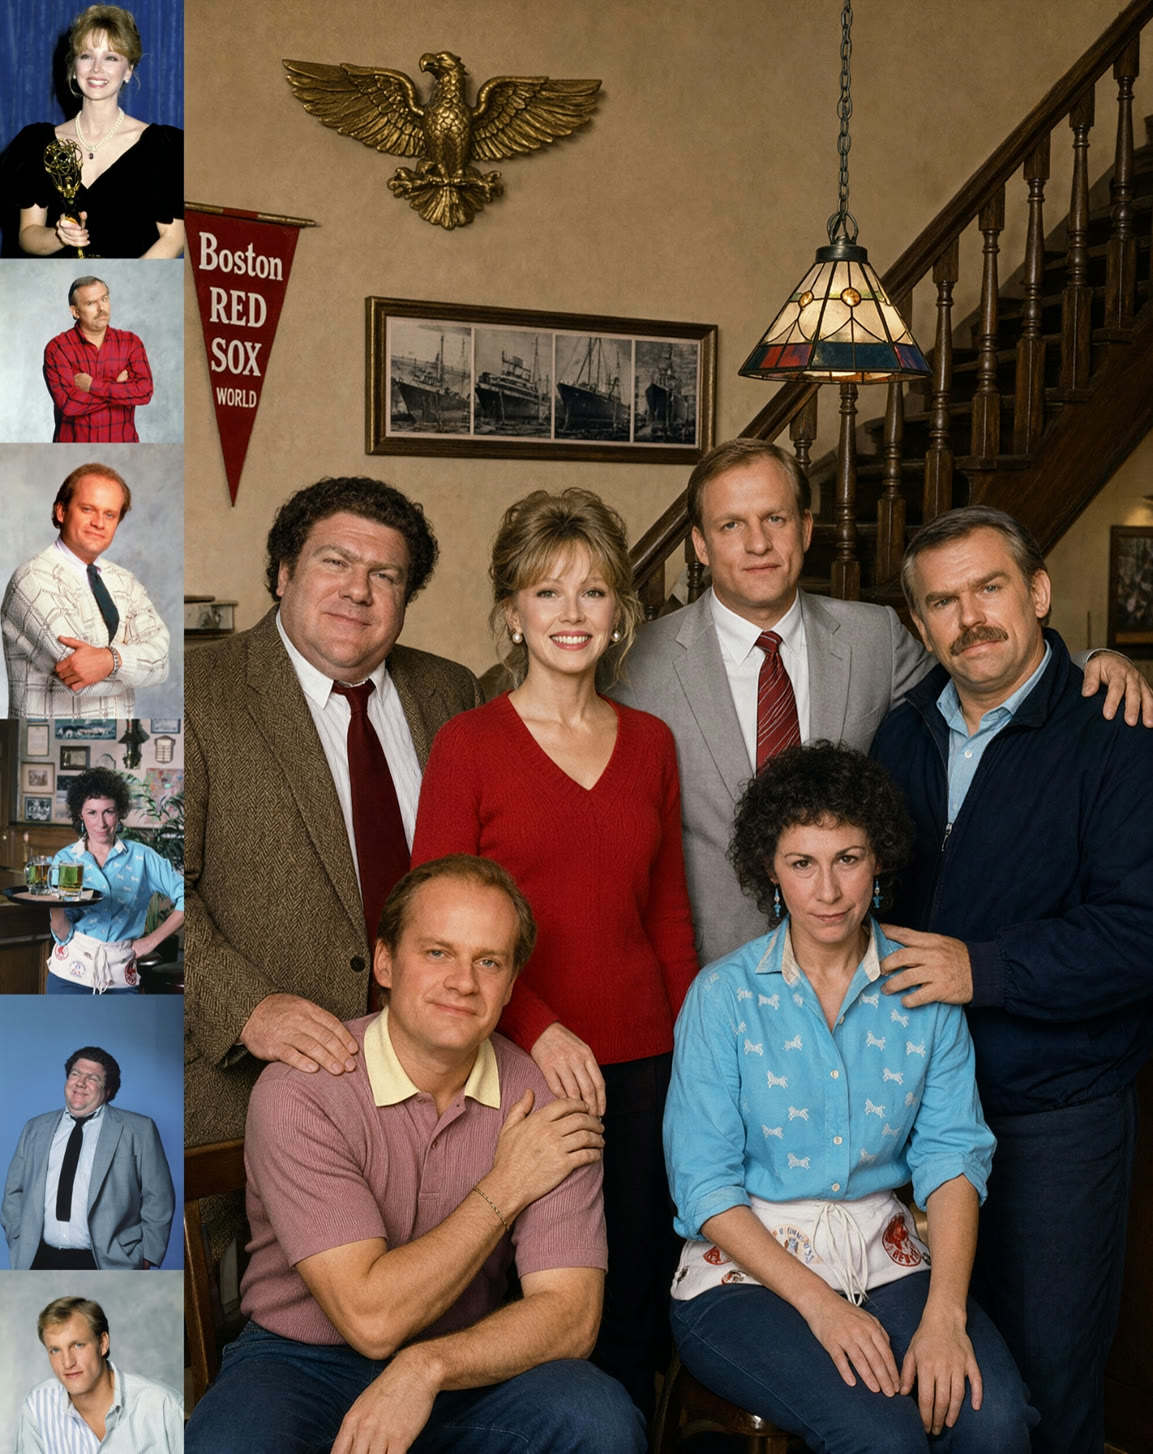
由六张人像引用图像生成的一张合影。
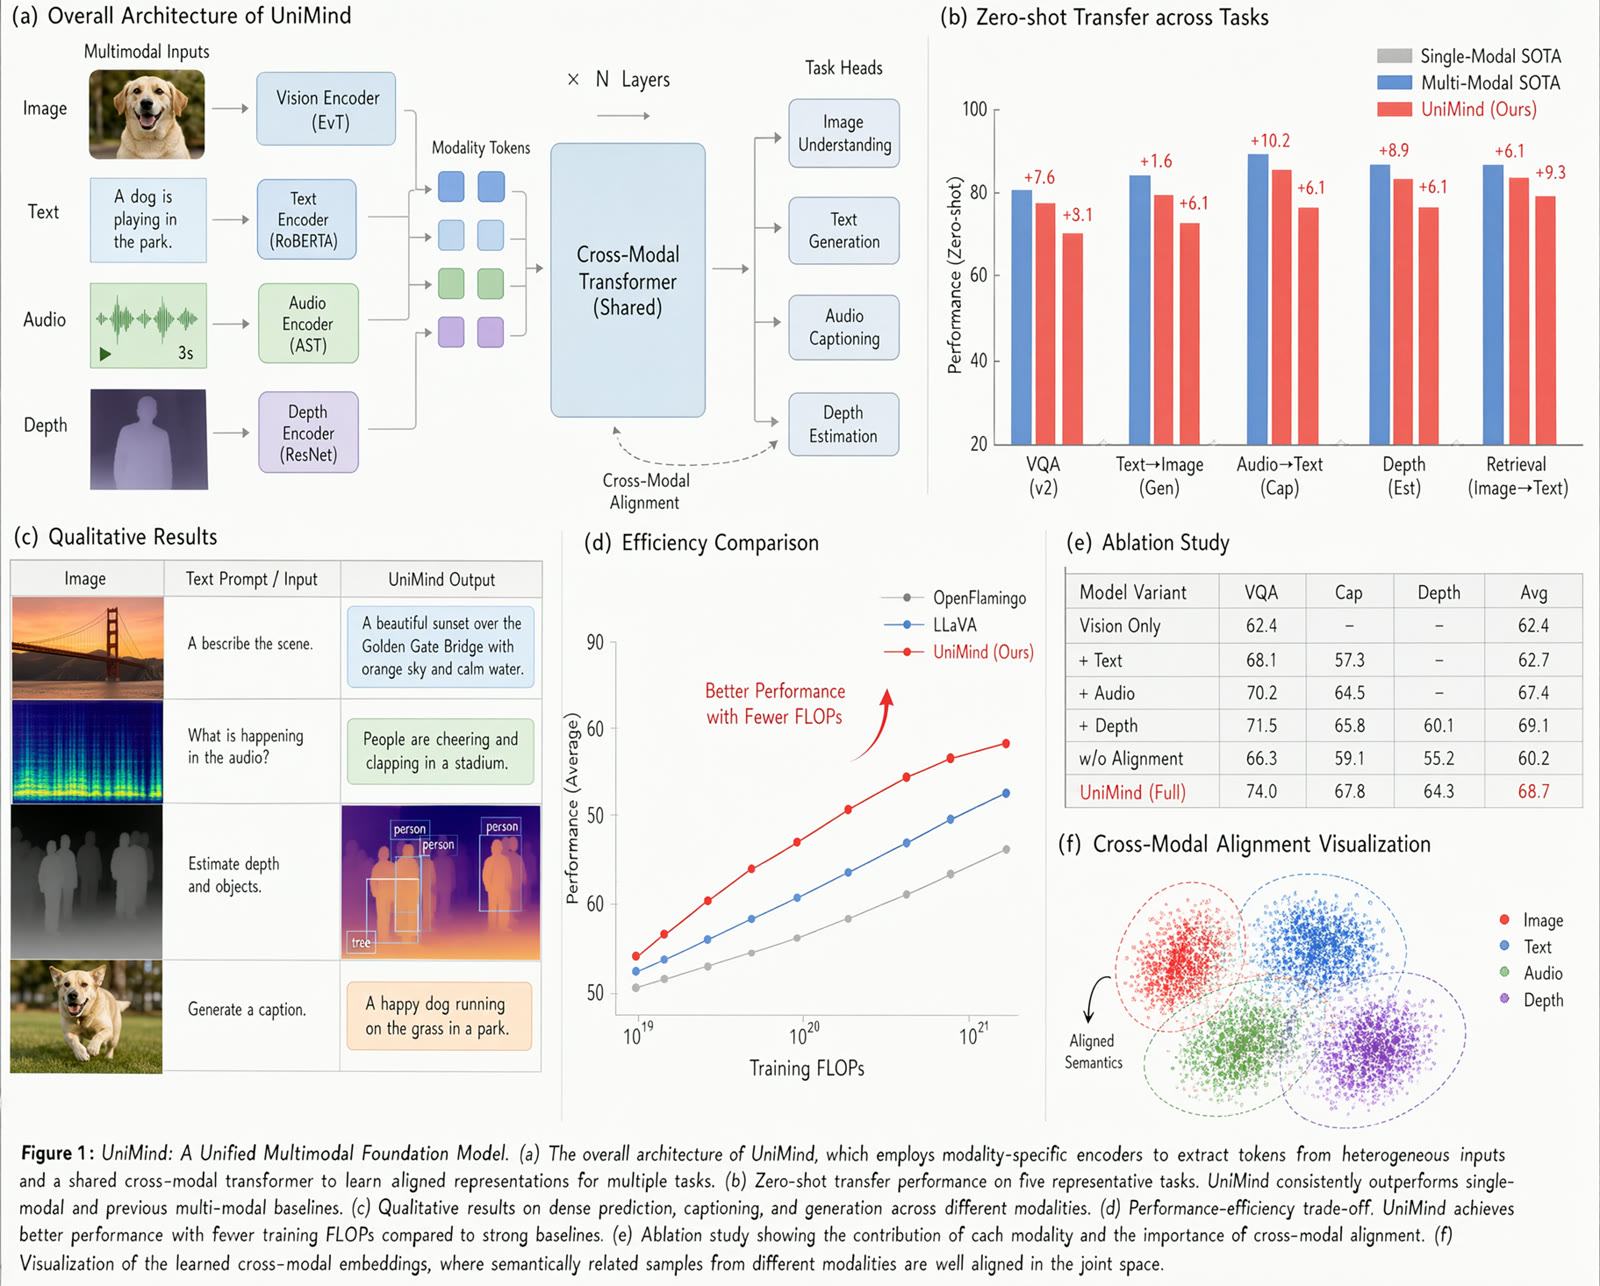
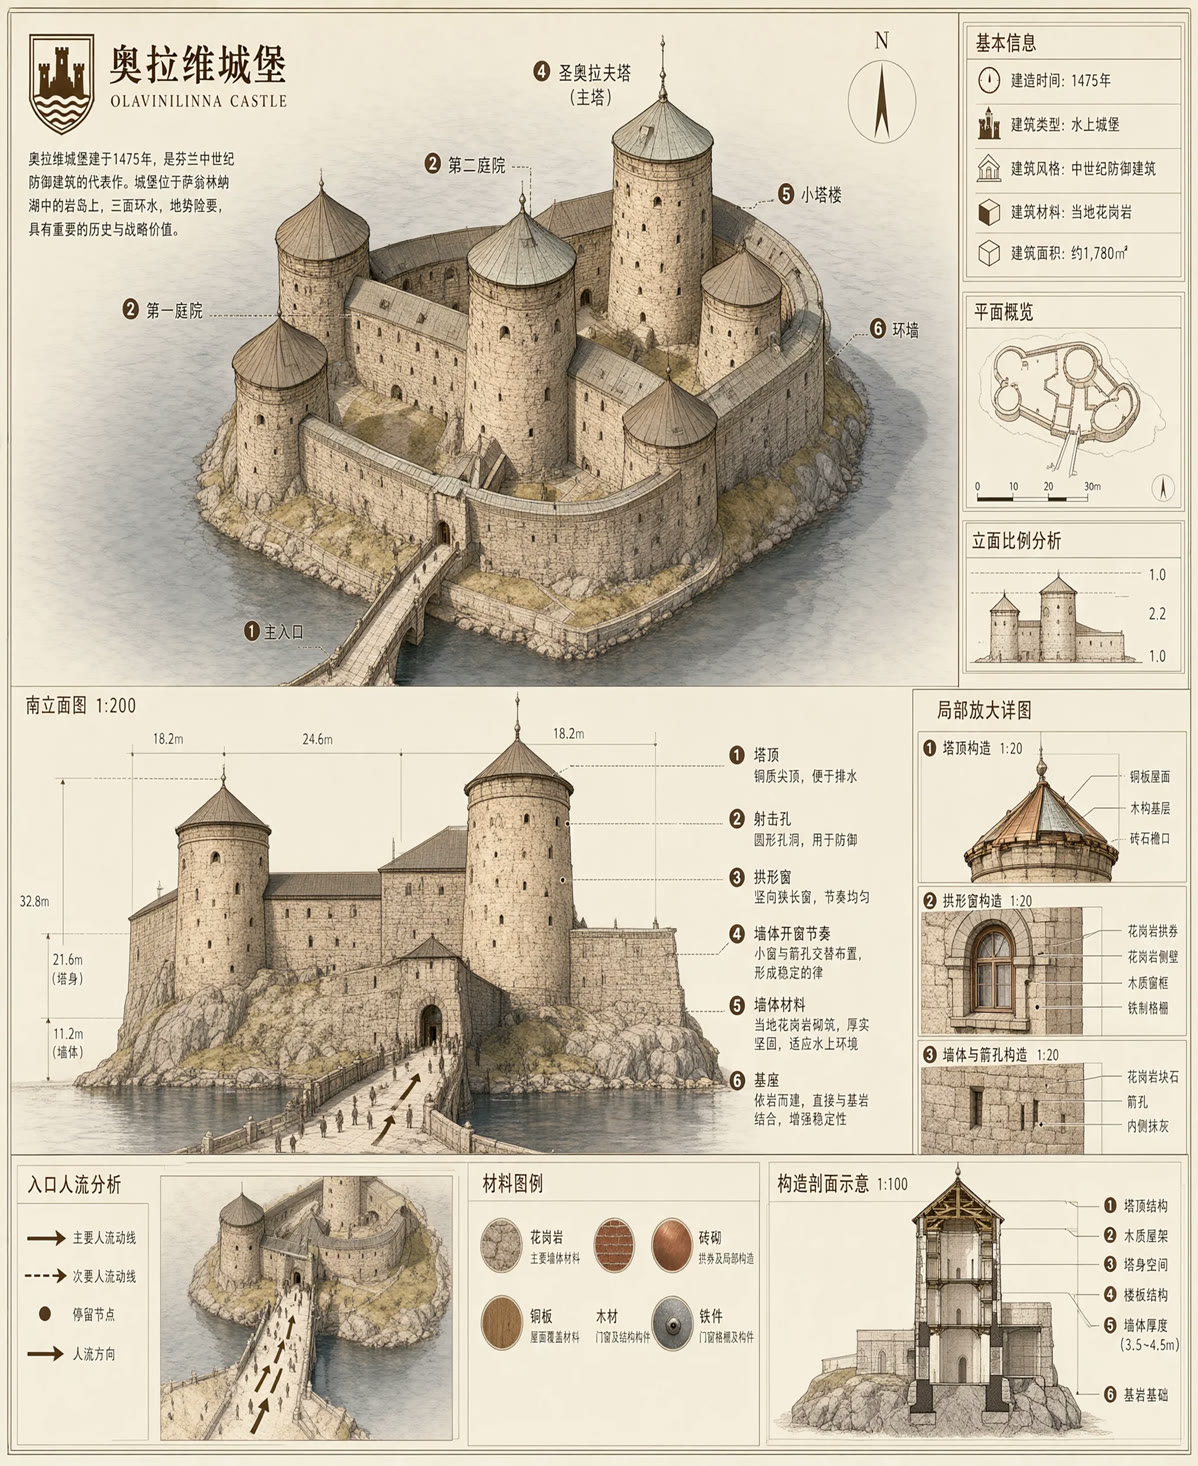
来自模型卡的排版与布局示例。
发布首日支持 ComfyUI
ComfyUI 已在 Comfy-Org/ComfyUI #16400 中合并 Qwen-Image 2.1 支持(CORE-423,由 Kijai 提交),下面三个官方模板需要 ComfyUI 0.37.0 或更新版本。后续提交为该模型加入了 transformer 块编译并改进了 KV 缓存放置。
重新打包的单文件权重位于 Comfy-Org/Qwen-Image-2.1,这些模板属于内置工作流图库的一部分,因此也可以直接从模板浏览器打开,而不必拖入 JSON。
| 模板 | 功能 |
|---|---|
| 文本生成图像 | 以 25 个采样步生成一张 1024x1024 图像,支持原生 2K 输出、排版与透明度 |
| 图像编辑 | 通过同一个生成与编辑 checkpoint 处理两张引用图像,适用于角色一致的编辑和商品抠图 |
| 移除背景 | 输入一张图像,输出一张透明结果,使用模型原生的 RGBA 输出 |
模型文件
Comfy-Org 重新打包的版本按常规文件夹划分:
📂 ComfyUI/
└── 📂 models/
    ├── 📂 diffusion_models/
    │   ├── qwen_image_2.1_bf16.safetensors
    │   └── qwen_image_2.1_int8_convrot.safetensors
    ├── 📂 text_encoders/
    │   ├── qwen3vl_8b_bf16.safetensors
    │   ├── qwen3vl_8b_int8_convrot.safetensors
    │   └── qwen3vl_8b_w4a8.safetensors
    └── 📂 vae/
└── qwen_image_2.1_vae_bf16.safetensors除此之外,该重新打包版本还包含提示词增强器文本编码器,即 INT8 convrot 形式的 qwen3.5_9b_qwen_image_2.1_pe_t2i 和 qwen3.5_9b_qwen_image_2.1_pe_i2i。这些是 Qwen 微调后的 LLM,用于把简短请求扩展成图像模型偏好的模板格式,它们是可选的:任何能力足够的 LLM 都能填充同样的提示词模板,图像模型本身不依赖它们也能运行。
早期用户的反馈
该模型自发布当天起就已在用户手中使用,反复出现的实用经验大致有以下几点:
- 原生尺寸很重要。 大幅超过 2048 级别的训练分辨率会让曝光不稳定,而过大的输入引用图像会显著拖慢生成速度。在加载前先缩放引用图像,比让采样器硬啃更划算。
- CFG 低于 1 不可用。 1 附近的引导值与上一代 Qwen-Image 系列表现相似,当图像中的文字需要更清晰时,人们会采用较小的 CFG 搭配注重质量的负面提示词。
- 风格迁移仍不稳定。 通过文本指令改变风格是可靠的,而通过引用图像提供的风格则没那么稳定,这与用户在更早的 Qwen-Image Editing 模型上遇到的情况一致。
可用性
权重已发布在 Hugging Face 和 ModelScope 上,发布帖见 Qwen 博客。除 ComfyUI 之外,发布首日提供的集成还包括通过 QwenImage21Pipeline 使用的 Diffusers、vLLM-Omni、SGLang 和 LightX2V。
评论
使用 GitHub 登录后即可参与讨论。