MiniMax H3 FaceSwap LoRA:替换任意参考视频中的人物
UntMods 为 MiniMax H3 Ref2VA 打造的 FaceSwap LoRA,可用参考图像中的人脸替换参考视频里的人物身份,并附带可直接使用的 ComfyUI 工作流。
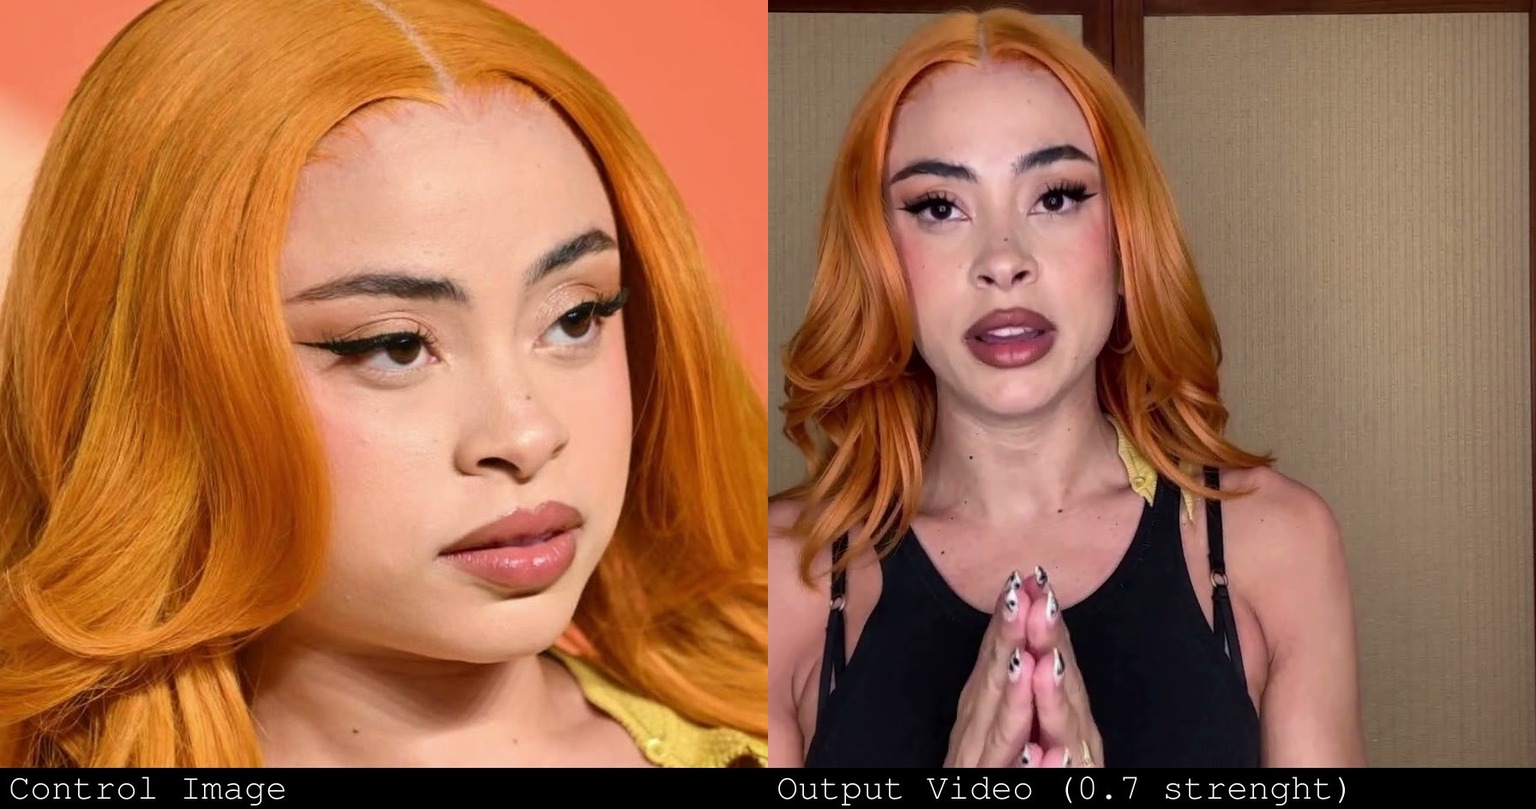
左:提供新身份的控制图像。右:使用它生成输出视频中的一帧。
LoRA 改变了什么
在 MiniMax H3 上做人脸替换,通常意味着要强行让整套参考图像脱离其训练时的行为:ref2va 变体本身已接受参考图像,但它用这些图像来引导外观、服装和场景,而不是覆盖片中的演员。这个适配器把任务收窄到人脸。你输入想要保留的视频片段,以及一张或多张新身份的参考图像,再用一个触发词 Faceswap 告诉采样器何时执行替换。
模型卡片中的实用信息:
- 为
ref2va训练。 它作用在参考生视频与音频的 H3 权重之上,而非fl2va分支。 - 一个触发词
Faceswap,强度 1.0。 - 剪枝适配器。 低于作者阈值的模块会从 safetensors 文件中移除,这让下载体积保持在 63 MB,用作者的话说就是“更少的 LoRA 伪影,强度与训练基座一致”。
- 支持多张参考。 随附的工作流包含三个参考图像加载器,并注明该节点“支持单张或多张参考图像”。
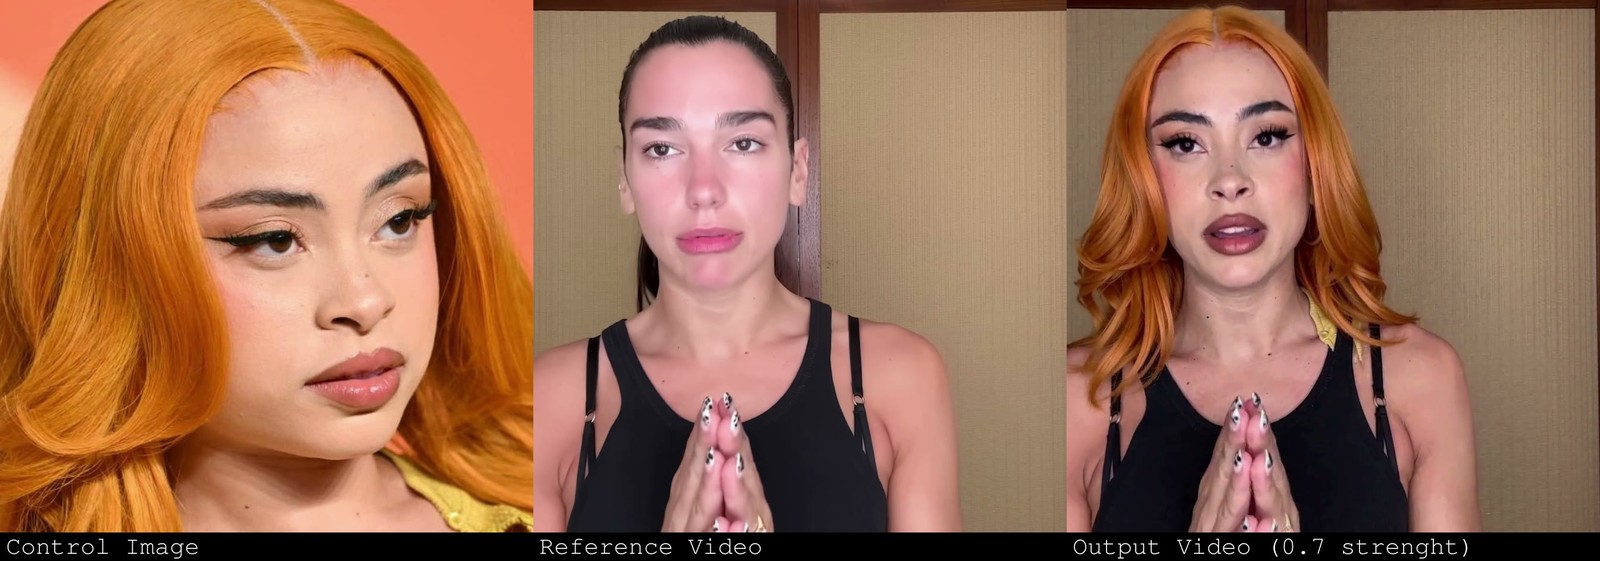
已发布的演示片段都是三分屏对比,标签直接烧录在画面中:左侧为控制图像,中间为参考视频,右侧为替换后的输出。
在 ComfyUI 中运行
仓库提供 SS_FaceSwap_MiniMax REF2V.json,这是一个前端格式的工作流,基于作者自己的 CRT-Nodes 节点包,外加 ComfyUI-VideoHelperSuite 用于视频的加载与封装:
- 安装
CRT-Nodes(在 ComfyUI Manager 中显示为CRT-Nodes)和ComfyUI-VideoHelperSuite,然后重新启动 ComfyUI。 - 从模型仓库下载
SS_FaceSwap_MiniMax_H3_REF2VA.safetensors,放入ComfyUI/models/loras/MiniMaxH3/SS_FaceSwap/,这正是工作流预期的路径。 - 打开工作流,在 VHS 视频加载器中载入来源视频,把新身份图像放入参考图像加载器,并在提示词中写入
Faceswap。
示例工作流通过 LoraLoaderModelOnly 以强度 1.0 接入该 LoRA,旁边第二个槽位放着一个 8 步的 Ref2VA turbo LoRA,因此演示片段能以加速的步数渲染。它的采样器是 CRT 的 MiniMaxH3UnifiedSampler,使用 R2V 模式和该节点包的“Balanced (recommended)”预设;与模型一同发布的对比视频标注为 0.7 strength。checkpoint、文本编码器和 VAE 槽位分别指向剪枝 int8 convrot ref2va 基座、nvfp4 Qwen3-VL 32B 文本编码器,以及 H3 独立的 int8 视频 VAE 和 fp32 音频 VAE。
触发词只是条件的一半:该适配器训练的目的就是从参考图像中获取身份,所以视频片段本身的主体保留动作、时间、构图和音频,只有人脸被替换。
模型卡片中的示例
被迁移的身份不一定非得是人。在第二个公布的对比示例中,一只黑猫提供了人脸,结果落在来源视频中的主持人身上:
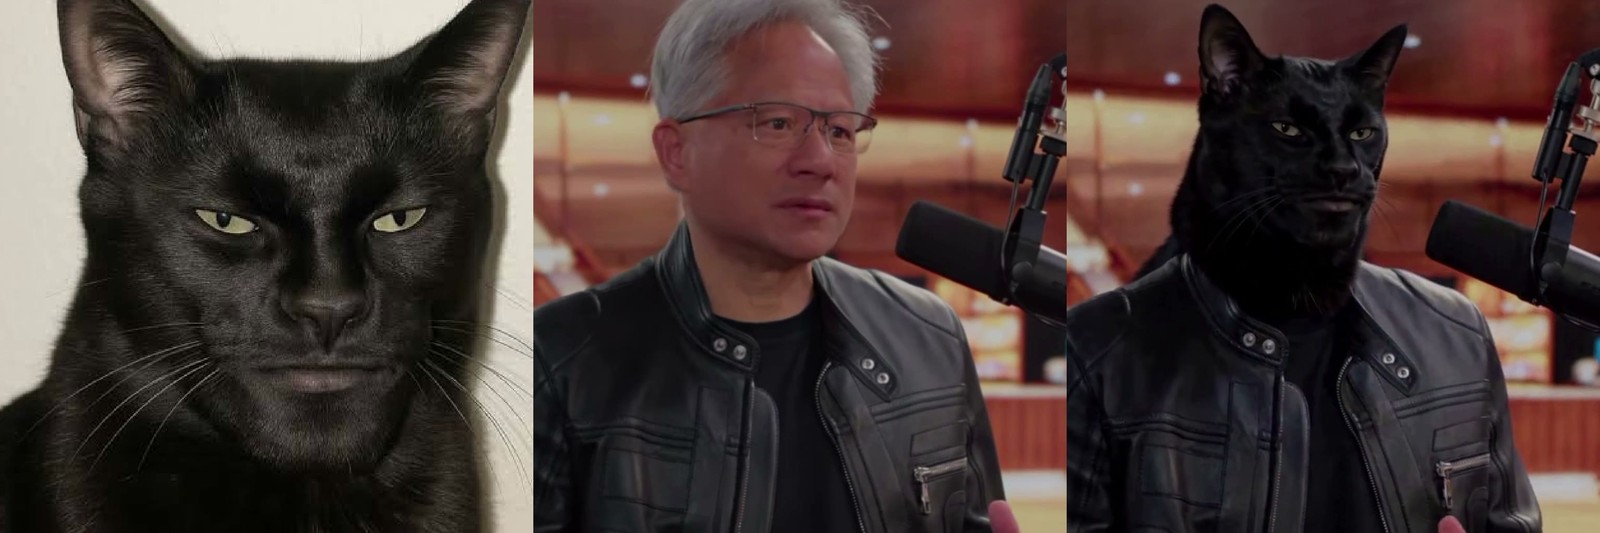
左侧为控制图像,中间为参考视频,右侧为输出。
控制图像、参考视频以及 0.7 强度下的输出,音频保留自来源视频。
同一套流程用于把猫的身份迁移到演播室主持人身上。
可用性
- 模型卡片与权重:UntMods/FaceSwap_MiniMaxH3_REF2VA
- 工作流 JSON:
SS_FaceSwap_MiniMax REF2V.json - 节点包:PGCRT/CRT-Nodes
该链接于 9 月 19 日在 Banodoco 的 #minimax_h3_chatter 中分享,模型卡片在最初几天里已收获超过 55 个赞。公布的演示均为训练者自己的片段;截至撰写时还没有第三方测试结果出现。
评论
使用 GitHub 登录后即可参与讨论。