ComfyUI v0.37.0:支持 Qwen-Image 2.1 与 MoGe 3
ComfyUI v0.37.0 原生支持 Qwen-Image 2.1,附带三个官方模板,新增 MoGe 3 几何估算,Qwen3.8 文本编码器速度更快,并自动启用快速磁盘加载。
MoGe 3 在稀疏体素壳上细化粗略点图,保留图像空间解码器会模糊的细薄结构(对比图来自 Comfy-Org/ComfyUI#16381)。
核心中的 Qwen-Image 2.1
Qwen-Image 2.1 通过 Comfy-Org/ComfyUI#16400(CORE-423)进入核心,并以原生实现的形式发布:7B 单流 diffusion transformer 位于 comfy/ldm/qwen_image21,Qwen3-VL-8B 文本编码器从其最后一个隐藏状态读取,参考图像槽位由 DiT 自身拼接。
两个新节点承担模型的编辑侧功能:
- Text Encode Qwen Image 2.1(
TextEncodeQwenImage21,类别model/conditioning/qwen image)接受动态的参考图像列表而非固定输入,使用resolution控件调整它们的大小(默认 1024,32 的倍数,0表示每张参考图保持自身尺寸),并将它们作为 VAE latents 拼接到序列中。它输出正面和负面条件,以及一个与第一张参考图像尺寸一致的空 latent,这正是让编辑保持对齐的关键。 - Qwen Image 2.1 Cache(
QwenImage21Cache)设置前缀 KV cache 的存放位置和存储方式:device可选auto、gpu、cpu或off,dtype可选default、int8或int4。cpu会在计算背后从 RAM 预取 cache,而off会在每一步重新计算前缀,速度较慢,但在调试时可以排除 cache 的影响。
本次发布附带三个官方模板:文本生成图像、图像编辑和背景移除。三者的要求均为 v0.37.0 或更高版本。
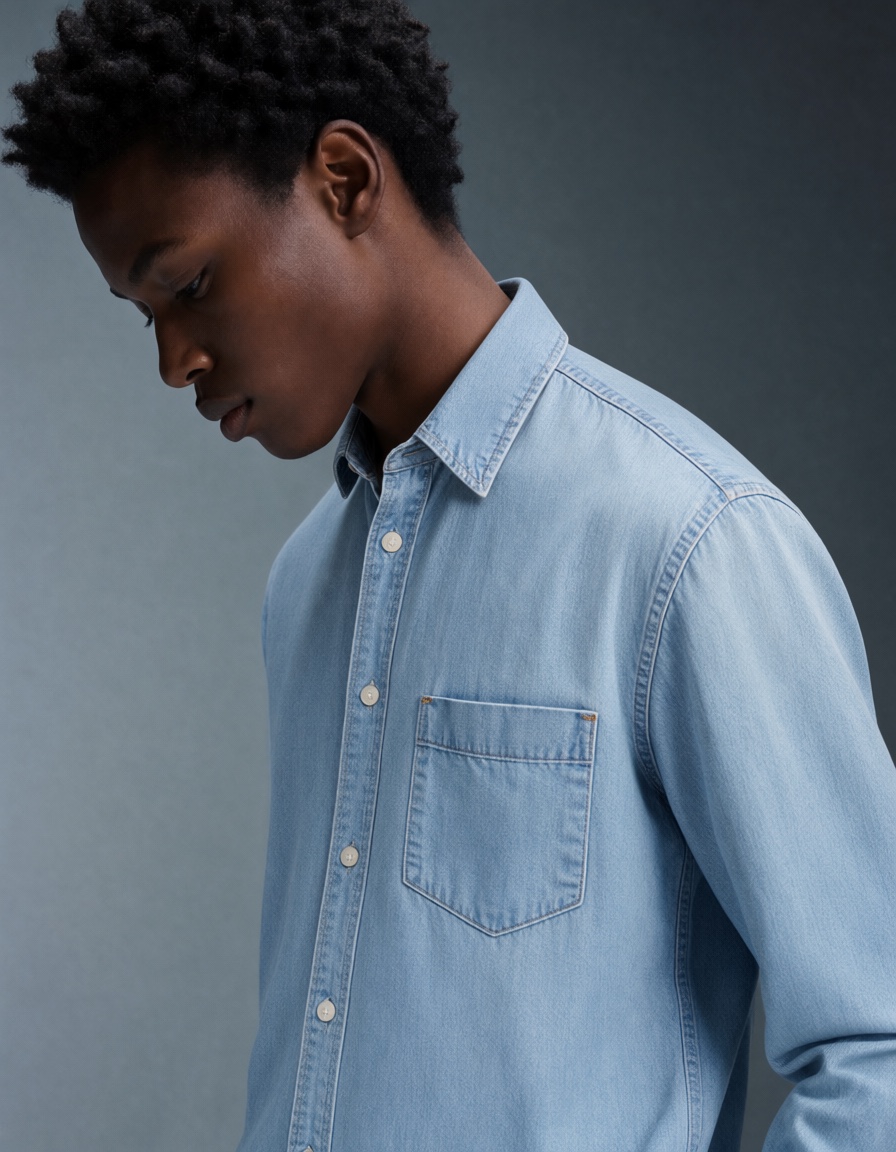
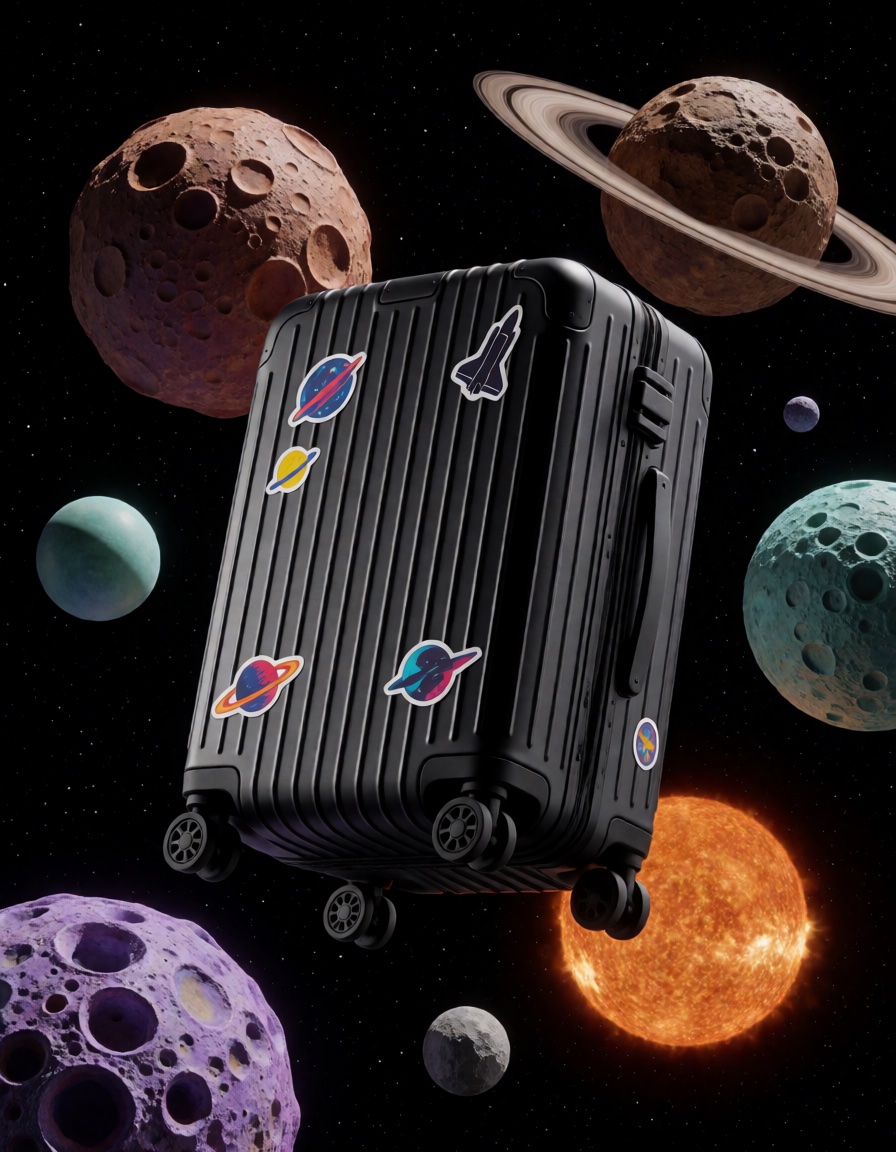
官方 Qwen Image 2.1 图像编辑模板的输出,来自 workflow_templates 仓库。
重新打包的权重发布在 Comfy-Org/Qwen-Image-2.1。
MoGe 3:精细几何估算
MoGe 3 是微软研究院单目几何模型的第三代,发表于论文 MoGe-3: Fine-Detail Monocular Geometry Estimation with Self-Guided Sparse Volumetric Refinement。它不在图像空间直接解码点图,而是将粗略预测提升到稀疏体素壳上,并在其上运行稀疏 3D UNet,这正是它保持细薄结构和深度不连续处锐利的原因。
核心支持通过 Comfy-Org/ComfyUI#16381(CORE-443)加入,同时支持 ViT-L 和 ViT-G 两个模型。ComfyUI 移植版将细化器构建在项目已为 Trellis 2 提供的 FlexGEMM 稀疏内核之上(comfy/ldm/trellis2/flexgemm.py),因此在普通 CUDA 环境中无需安装额外内容。
来自 MoGe 3 项目页面的预告。
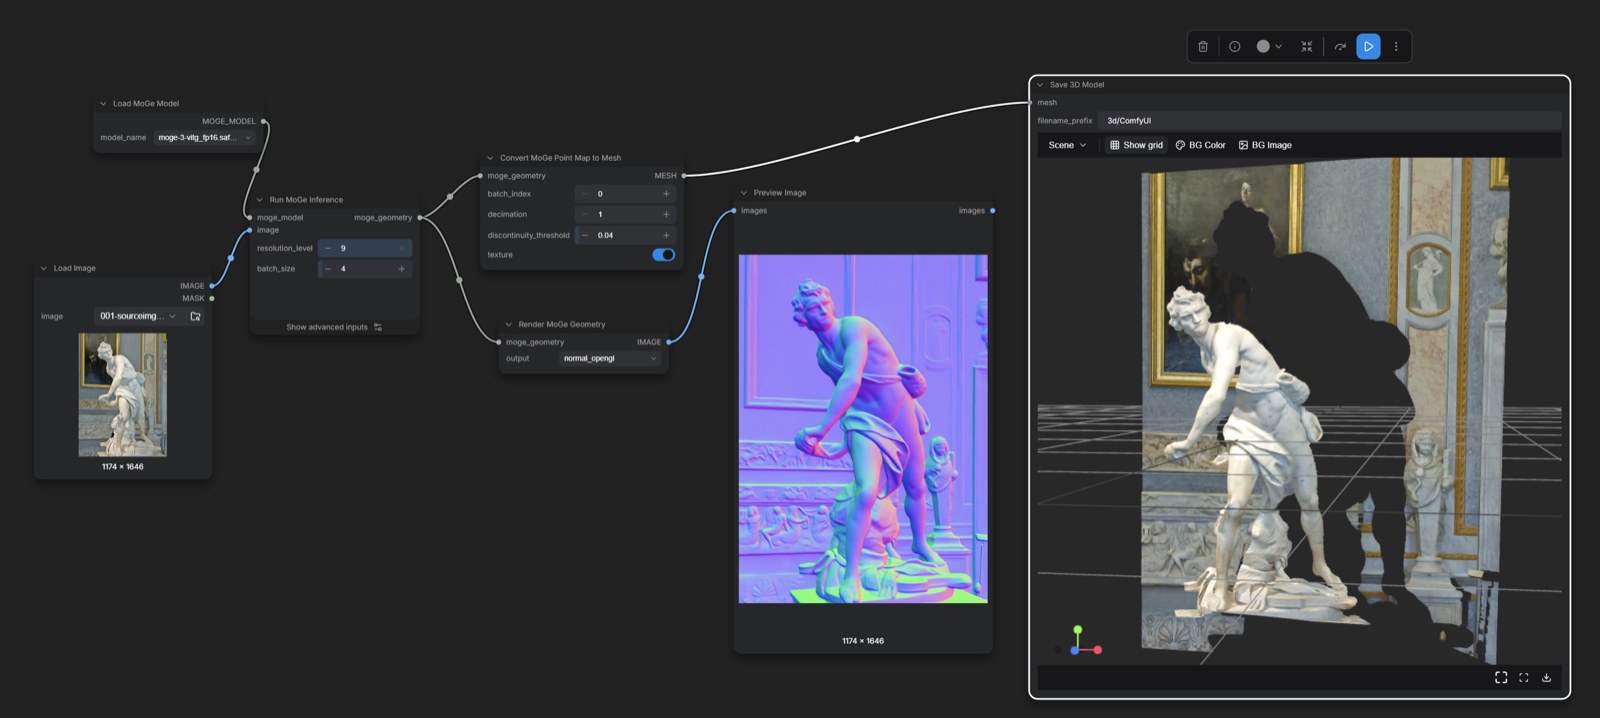
官方模板 utility_moge3_geometry_estimation 接收一张图像并输出深度图和表面法线图。它默认加载 moge_3_vitg_fp16.safetensors,同一下拉菜单中可选择 ViT-L 文件。MoGe 推理和 MoGe 全景推理节点上新增的 refine_steps 控件直接控制 MoGe-3 细化器:默认 3,最高 8,0 表示禁用。它对 MoGe 1 或 MoGe 2 模型没有效果,而节点仍然可以加载这些模型。
该模板只需一张图像即可运行(输入素材来自 workflow_templates 仓库)。
该模板需要来自 Comfy-Org/MoGe 的重新打包权重:
📂 ComfyUI/
└── 📂 models/
    └── 📂 geometry_estimation/
        ├── moge_1_vitl_fp16.safetensors
        ├── moge_2_vitl_normal_fp16.safetensors
        ├── moge_3_vitg_fp16.safetensors
        └── moge_3_vitl_fp16.safetensors
同一节点系列还保留了更早的工具:将等距柱状图像拆分为十二个透视视图并合并回深度的全景推理、点图到网格的转换,以及用于相机匹配的 FoV 读数。
更快的 Qwen 文本编码器
Comfy-Org/ComfyUI#15623(CORE-390)是针对 Qwen3.5 和 Qwen3.8 文本编码器的解码速度优化,这些编码器对 Qwen-Image 提示词改写和文本生成节点都很重要:
- 推测解码:模型的多 token 预测头起草 2 到 5 个 token,一次批量验证通过予以接受。起草头以捕获的 CUDA graph 运行,验证通过则在内存编译器下运行。
- FixedKVBias:全容量注意力 cache,带有设备端写入位置,因此解码步骤在
llama.py和qwen35.py中都能保持 graph 可重放。 - 融合 DeltaNet 解码内核来自 comfy-kitchen,带 eager 回退,同时重复和存在惩罚通过固定大小的词表掩码应用,而非逐步分配。
文本生成节点通过新的 mtp 控件暴露此功能,可选 auto、off 和 2 到 5。auto 自适应起草深度,固定值则将其锁定。它对没有 MTP 权重的模型没有效果,工具提示说明采样输出仍保持正确的分布,但对相同种子与非 MTP 输出不同。同一版本还为这些编码器增加了 W4A8 GEMV 支持,可与 Comfy-Org 发布的 int8 和 W4A8 重新打包权重配合使用。
快速磁盘与内存
v0.37.0 升级到 comfy-aimdo 0.5.5,其中包含 Windows 快速磁盘检测的原生 C 实现。ComfyUI 现在会自行检测快速磁盘,并在驱动器为 PCIe 4 NVMe 或更高速时,按模型自动启用磁盘支持的动态加载和卸载:权重跳过 RAM 缓冲和 pin 注册预热步骤。混合配置下,较慢的驱动器会获得 RAM 优先权,因此在 NVMe 和机械硬盘之间分配的模型库仍能在有帮助的地方使用缓存。--fast-disk 仍可强制启用该行为,新的 --disable-fast-disk 可将其关闭,并覆盖 --fast-disk。
同一版本还带来两项内存变化。当启用动态 VRAM 时,文本编码器现在会保留在 GPU 上,而不是来回移动;使用 comfy-kitchen 注意力时,Wan 模型的峰值 VRAM 会下降。
其他变更
- 空Latent图像现在默认为 1024 x 1024,而非 512 x 512,因此新建节点与现代模型的训练分辨率一致。
- 启用 ComfyUI 编译器 graph 时,MiniMax Music 3 不再渲染噪声:自回归文本编码器现在像 YuE2 和通用生成路径一样使用固定解码缓冲区。
- ACE-Step 的 VAE解码不再在不支持 bf16 的 GPU 上崩溃。
- YuE2 生成音乐节点新增了 CFG 控制,SheetSage2 位置嵌入精度已与上游保持一致。
- 整个 graph 中的节点名称和分类已清理。
- 合作节点:Meshy 7.1、GPT Image 2 的透明背景、当 Tripo P2 运行关联的 GLB 或 FBX 输出会为空时拒绝执行的保护,以及合作代理调用上的 Idempotency-Key,使重试不会被重复计费。
- comfyui-frontend-package 升级至 1.53.6,工作流模板升级至 v0.11.66,内嵌文档升级至 0.5.12,comfy-kitchen 升级至 0.2.35。
获取 v0.37.0
通过管理器或你选择的启动器更新 ComfyUI。Qwen-Image 2.1 和 MoGe 3 的节点及其模板需要 v0.37.0 或更高版本,而 Desktop 和 Cloud 版本会跟随稳定版发布。
评论
使用 GitHub 登录后即可参与讨论。