在 ComfyUI 中直接训练你自己的 YuE2 LoRA
ComfyUI-YuE2-Trainer 将 YuE2-3B 音乐模型的 LoRA 训练带入 ComfyUI 节点:喂入 mp3 或 wav 文件,选定一个触发词,即可获得可直接用原生加载器载入的 LoRA。
safetensors LoRA,可在原生 YuE2 checkpoint 上使用自带的 LoRA 加载器加载。无需标注文件,无需外部训练脚本,也不用离开 ComfyUI。
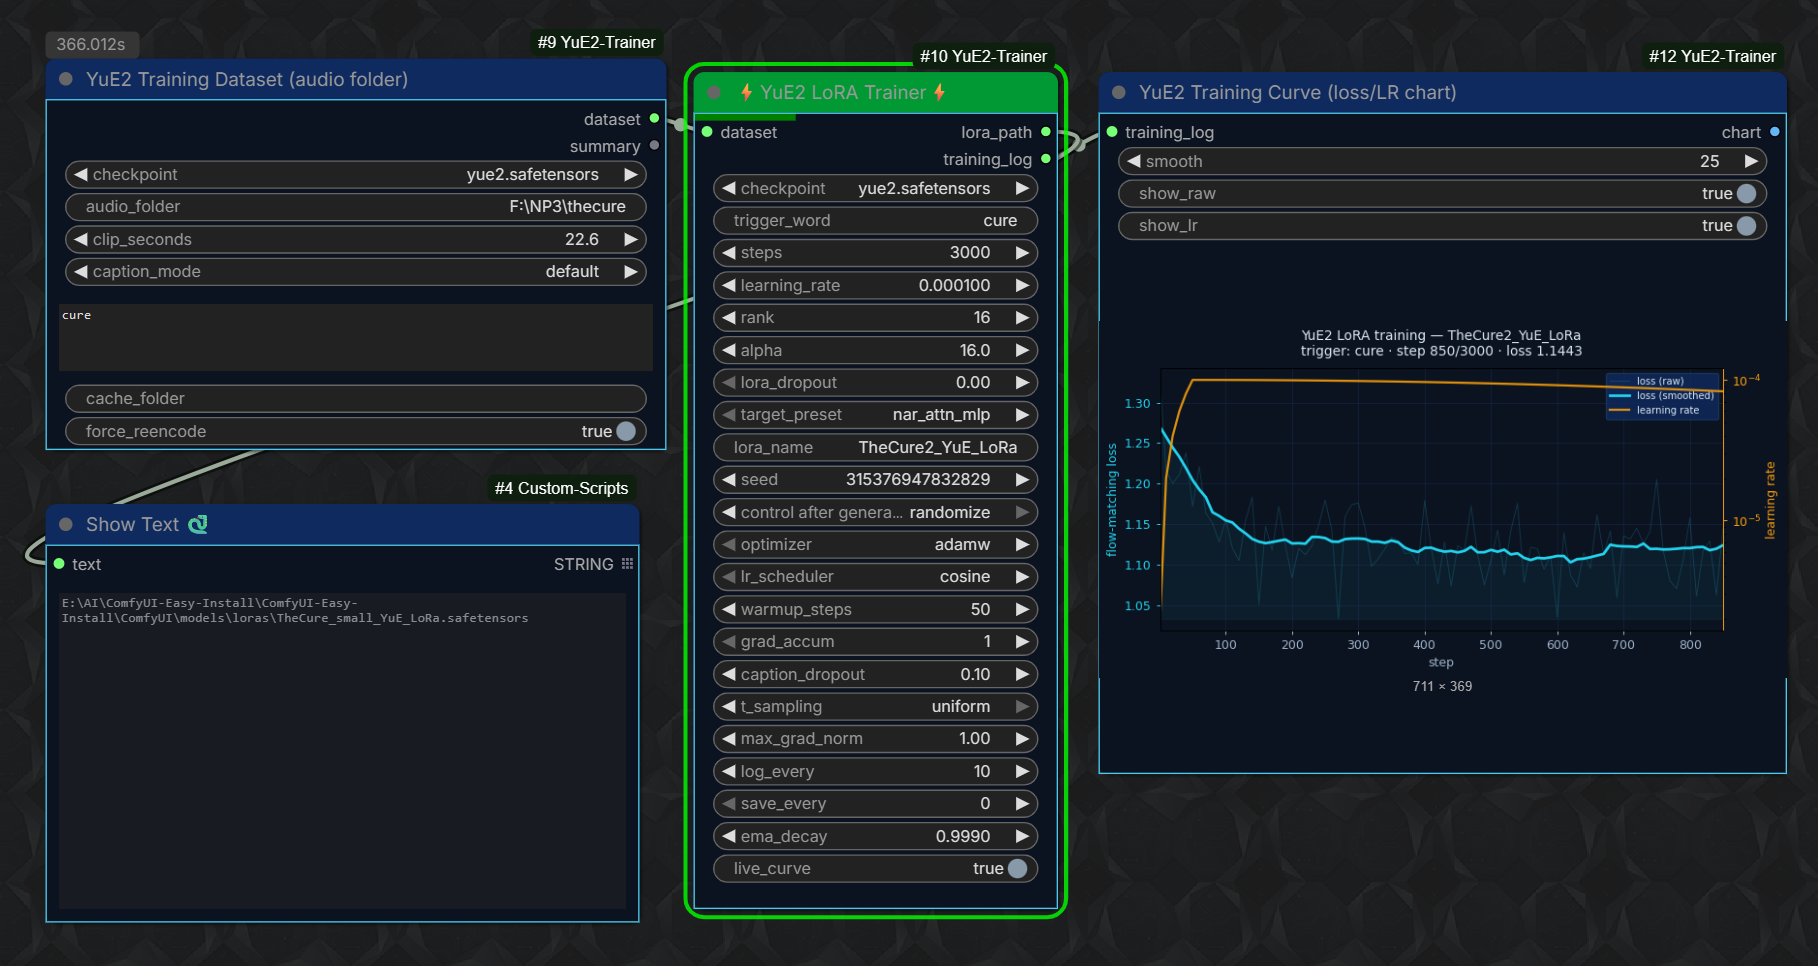
它训练什么,以及如何训练
YuE2-3B 可根据风格提示词和歌词生成完整歌曲,其内部包含三个部分:一个 2.2B 的 AR 语言模型,负责规划歌曲并写出语义 token;一个 1.5B 的 NAR 流匹配分支,将 64 通道 VAE latent 渲染为声音;以及一个 48 kHz 立体声 VAE。该训练器冻结了 AR「作曲」分支(m-a-p 尚未发布音频到 token 的编码器及其训练代码),仅在 NAR 分支上训练 LoRA 适配器,使用的是已发布的流匹配目标函数。
因此,其成果是一个风格、配器与音色 LoRA,而不是声音克隆。训练无需标注:音频文件会被一次性编码为 VAE latent 并缓存到磁盘,触发词则通过 YuE2 checkpoint 原生的文本前缀([Tags] your_trigger_word, caption ...)注入。如果你需要更精细的控制,还支持为每个文件提供同名的可选 .txt 标注。
保存下来的 LoRA 是原生 ComfyUI 格式的标准 *.safetensors,将其放入 models/loras/,再在原生 YuE2 checkpoint 上使用自带的 LoraLoaderModelOnly 节点加载即可。无需任何转换步骤。
依赖项
- 单文件原生 YuE2 checkpoint:来自 Comfy-Org/YuE2 的
yue2_3b_bf16.safetensors(约 7.8 GB),与原生生成节点使用的是同一个文件。请使用 bf16 版本,INT8 重新打包版无法用于训练。 - 推荐 24 GB 显存(在 RTX 5090 Laptop 24 GB 上测试通过)。
- 该节点包是独立的:官方 YuE2 模型代码(m-a-p 的
yue2_infer,Apache-2.0,未修改)已打包在内,因此不需要其他自定义节点。
作者设置与早期反馈
作者推荐的配方是 5000 步,权重 2.0,并且该 LoRA 在 FP16 模型上的效果比 convrot 变体更好。早期社区反馈褒贬不一:第一个 issue 报告训练出的 LoRA 没有可听出的效果,而声音克隆也被明确列为不可用,因此请把它当作一个仍在公开打磨中的实验性工具。该项目已经有分支在探索更广的训练覆盖范围,其中包括一个同时训练声学模型和规划器 CLIP 的版本。
获取方式
该训练器在 GitHub 上免费提供:Starnodes2024/ComfyUI-YuE2-Trainer(撰写本文时为 51 stars)。可通过 ComfyUI-Manager 安装,或 git clone 到 custom_nodes 目录。
评论
使用 GitHub 登录后即可参与讨论。