Anima-Light-Lavender:面向长自然语言提示词的 Anima 后训练模型
Anima-Light-Lavender 是 Anima-Base v1.0 的后训练版本,可读取 512 token 的自然语言描述,提供 BF16 与 MXFP8 权重,并能原样放入 ComfyUI 使用。
Anima-Base v1.0 以 Danbooru 风格标签作为原生输入。Anima-Light-Lavender 走的是另一个方向:它基于带有长自然语言 image_description 字段的结构化描述进行训练,本次发布重点在于理解 512 token 规模的描述。训练集约为 170 万张 Danbooru 图像,由一套数据处理流程完成标注与筛选,该流程所用的标注、筛选和偏好判断模型全部由作者自行训练,而非直接采用现成方案。
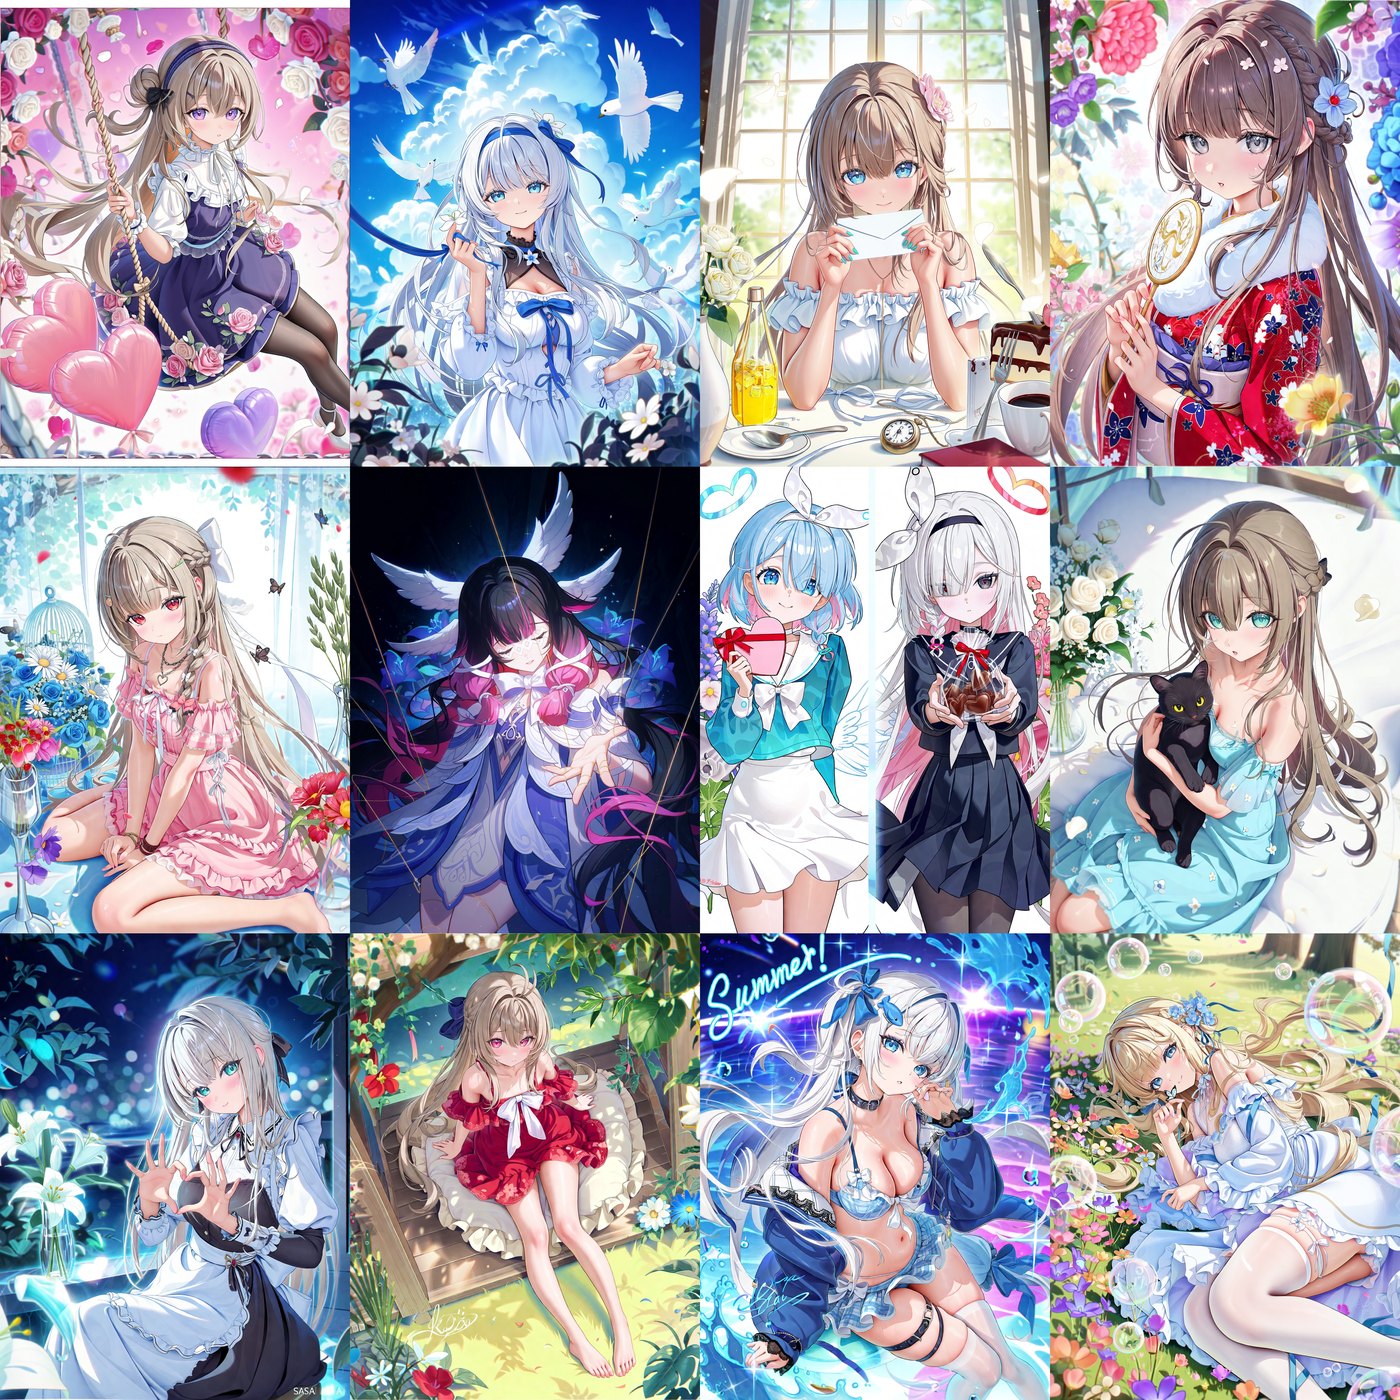
该模型面向动漫插画、角色与风格化艺术,由描述性段落驱动,而非标签堆叠。
有哪些变化,哪些没有变
| Anima-Light-Lavender | |
|---|---|
| 基础模型 | Anima-Base v1.0(anima-base-v1.0.safetensors) |
| 架构 | 未改变:约 2B 参数,28 层 DiT,未增加层,也未做蒸馏 |
| 文本编码器 | Qwen3-0.6B(qwen_3_06b_base.safetensors) |
| VAE | Qwen-Image VAE(qwen_image_vae.safetensors) |
| 权重 | anima-light-lavender.safetensors(BF16)和 anima-light-lavender_mxfp8.safetensors(MXFP8,推理更快) |
| 训练重点 | 512 token 规模的自然语言描述,以及更高质量的数据 |
由于层数、参数数量和文件布局都与基础模型一致,现有的 Anima 工作流只需替换其 checkpoint 即可。
在 ComfyUI 中安装
- 将一个权重文件放入
ComfyUI/models/diffusion_models/。请在 BF16 或 MXFP8 版本中二选一,不要两个都放。 - 复用你当前 Anima 环境中的文本编码器和 VAE:将
qwen_3_06b_base.safetensors放入ComfyUI/models/text_encoders/,将qwen_image_vae.safetensors放入ComfyUI/models/vae/。 - 在
ComfyUI/custom_nodes/中执行git clone https://github.com/aa0525/comfyui-zako-pe.git安装配套节点,然后重新启动 ComfyUI。
comfyui-zako-pe 节点包新增了两个节点:Danbooru Caption JSON,用于组装结构化描述;以及 Danbooru Prompt Extend (OpenAI),用于调用兼容 OpenAI 的服务器,将标签风格的 image_description 扩展为自然语言。配套模型 zako-pe(ZAKO-V0.1)则用于在本地完成这一扩展。
本次发布附带两个工作流,二者都可通过把 JSON 拖拽到 ComfyUI 画布上加载:
两者默认都使用 MXFP8 权重。如果你安装的是 BF16 文件,请在 UNet加载器 节点中切换 checkpoint。
使用结构化描述进行提示
该模型基于固定字段的描述进行训练,其中描述内容以散文形式写出:
{
  "year": 2025,
  "preference_level": "best",
  "artist": [...],
  "copyright": [...],
  "character": [...],
  "image_description": "...",
  "extra_tags": [...]
}| 字段 | 用途 |
|---|---|
year | 年份锚点,默认 2025 |
preference_level | normal、high、very_high 或 best(默认 best) |
artist | 画师与风格标签 |
copyright | 系列或作品标签 |
character | 角色标签 |
image_description | 图像内容,以详细自然语言段落写出 |
extra_tags | 补充内容标签 |
如果你不想撰写长段落,基础工作流可以接受标签,并由提示词扩展节点将其改写。作者本人给出的另一种做法是:描述图像内容,其余交给模型完成。发布说明指出,即使不使用质量词或负面提示词,结果依然干净。
推荐设置
| 参数 | 取值 |
|---|---|
| 采样器 | euler |
| 调度器 | simple |
| 步数 | 25 |
| CFG | 4.0 |
| 分辨率 | 约 1280×1280 |
| 负面提示词 | 留空 |
训练详情
训练以 BF16 运行,并在 MLP 与注意力的矩阵乘法中使用 MXFP8 GEMM,批处理大小为 1024,峰值学习率为 4e-5。MLP 与注意力的 2D 参数由 Muon 更新(动量 0.95、match_rms_adamw),其余参数则继续使用 AdamW(β 0.9 / 0.95,ε 1e-8)。描述的 preference_level 分层来自一个基于约 300 万样本训练的偏好模型,训练数据截止到 2025 年 11 月底。
评论
使用 GitHub 登录后即可参与讨论。