Fizgig v6 RefMods:MiniMax H3 免训练角色引用
Fizgig v6.0 为 MiniMax H3 打造 RefMod:把引用照片打包成一个小文件,针对模型本身调优,并可在进入 ComfyUI 之前于 RefMod Studio 中预览。
Fizgig v6.0 于昨天发布,在其 LoRA 与微调训练器之上新增了一项能力:面向 MiniMax H3 的 RefMod。一个 RefMod 会把一个包含引用照片或片段的文件夹打包成一个小文件,ComfyUI-MiniMaxH3Mod 节点会像加载 LoRA 一样加载它,并送入 H3 的引用路径。无需训练运行,几分钟就能得到一个文件,而且基础类型无需标注文本。
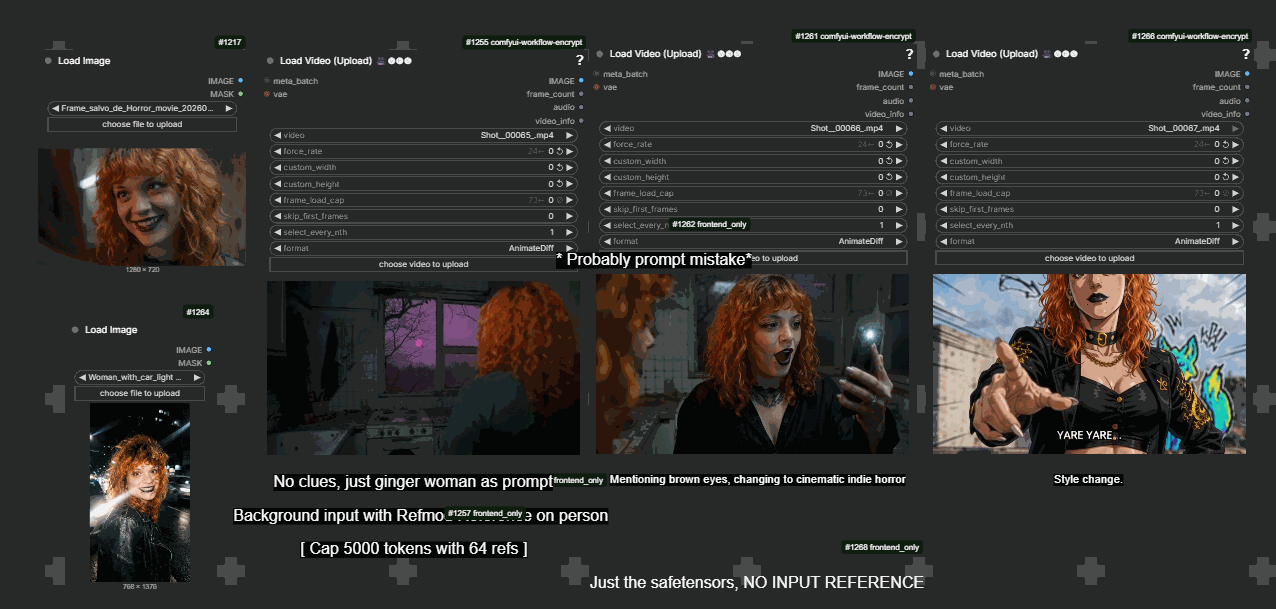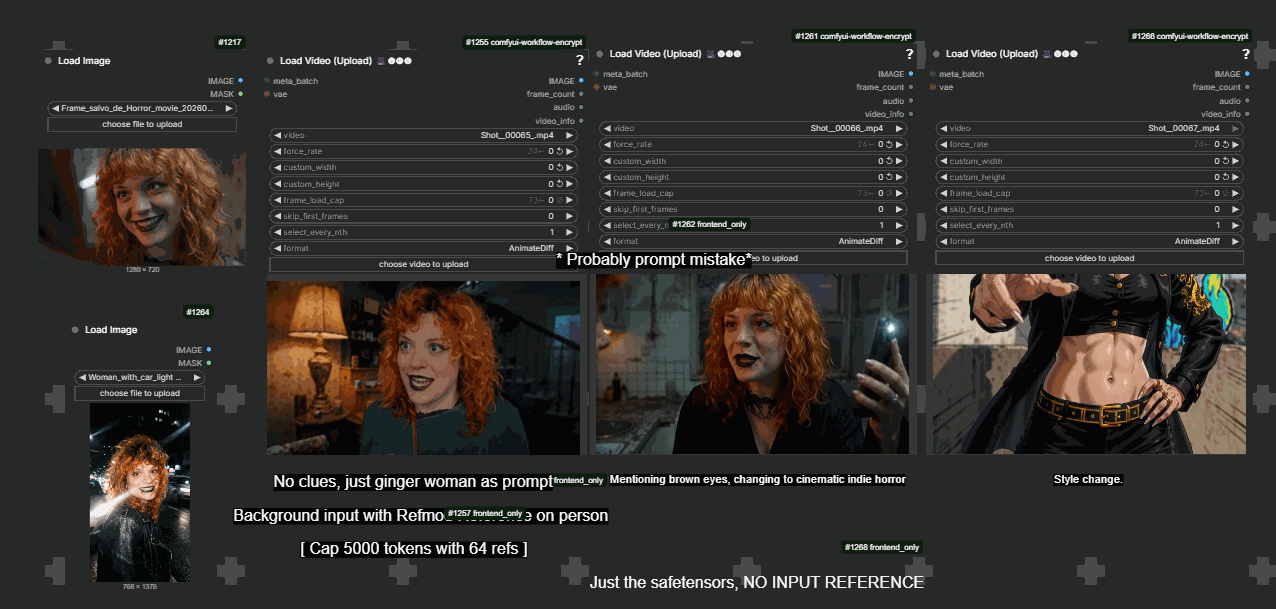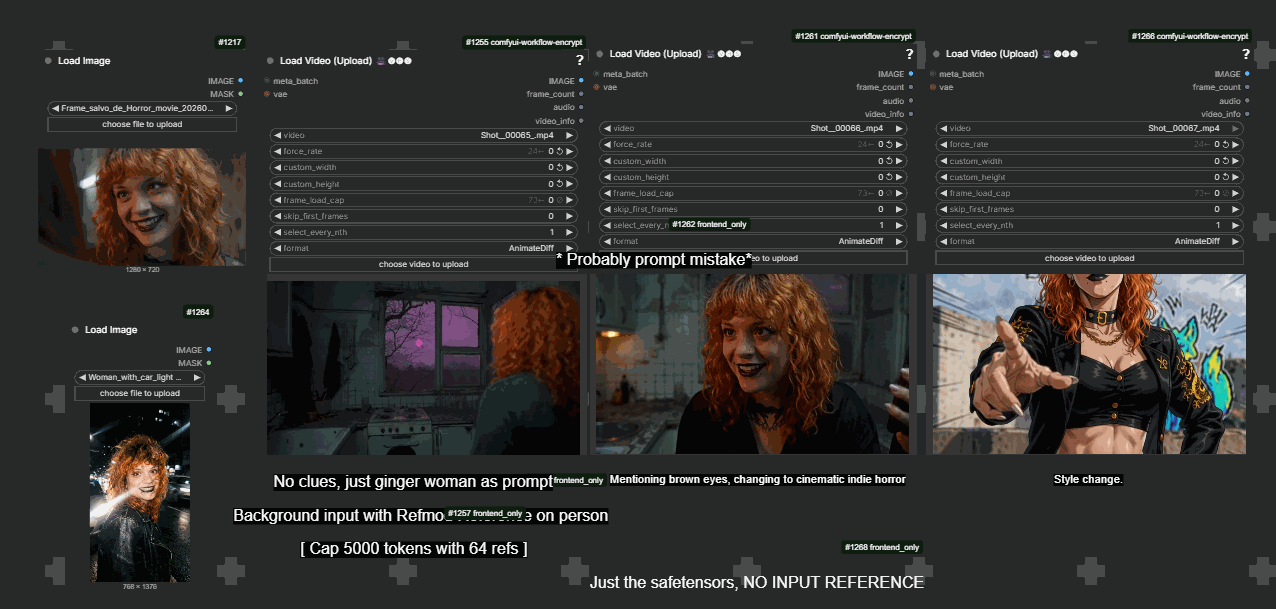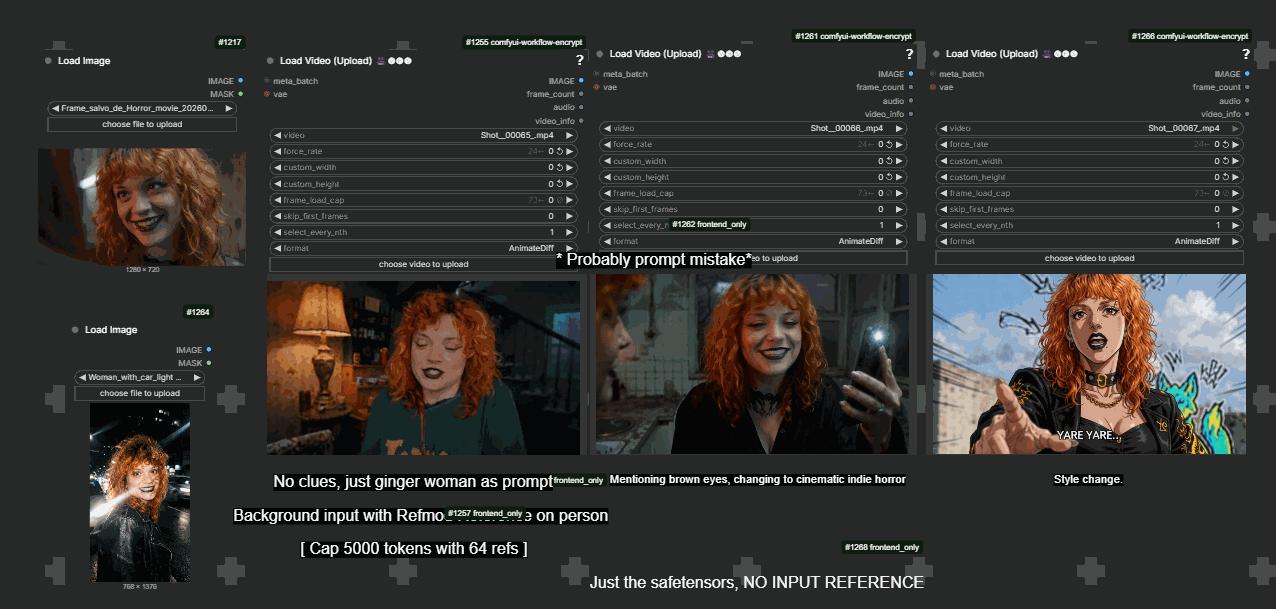
一个通过 MiniMaxH3Mod 节点在 ComfyUI 中生成的身份 RefMod,来自该项目的示例图库。
什么是 RefMod
RefMod 格式本身来自社区节点包 ComfyUI-MiniMaxH3Mod by @Luisacaotica(199 颗星),并配有来自 @malcolmrey 的 mod 库和指南。它把引用图像和视频压缩成微小的 Latent token,随 H3 的引用路径一同传递,因此不必在每次生成时把同样的照片塞进图像槽位,只需加载一个文件。Fizgig v6 增加了其他制作者都没有的一项功能:它可以针对 H3 本身来调优 RefMod,而不只是对照片做简单的编码。
Fizgig v6 新增了什么
- 五种面向人物和风格的预设:社区配方(对 8 张 1 MP 的照片做简单编码,与节点包自带提取器生成的完全相同)、Fizgig recipe lite(16 张 0.5 MP 照片,针对模型调优)、Fizgig recipe(同样的照片但采用 1 MP,以获得更锐利的结果),另外还有面向风格外观而非人物的风格预设。
- 模型在环调优:调优类预设会在创建过程中把文件跑过 H3 基础模型,作者称这能在照片从未展示过的镜头上获得更好的泛化能力,以及更干净、更锐利的输出。
- RefMod Studio 标签页:在你打开 ComfyUI 之前,先在 Fizgig 内把 mod 与基础模型做 A/B 对比。
- 片段可作为运动与音频 mod:用该节点包的 Gizmo 控件准备好的视频片段可以成为运动引用,而音频 mod 可以在视觉内容之外携带某个文件夹的声音。
- 即插即用兼容:只需把输出文件夹指向 ComfyUI 的
models/refmods一次,之后每个 mod 都能通过现有的 MiniMaxH3Mod 节点加载。ref2va 和 fl2va 工作流均适用。
RefMod 与 LoRA 的对比
作者在发布帖中的原话是:RefMod 快速且体积小,但它在概念理解上不如 LoRA,泛化能力也较差。权衡之处在于速度:LoRA 需要一次训练运行,而 RefMod 几分钟就能完成;对于与你引用素材相似的镜头上的角色一致性而言,质量差距很小。若追求最大程度的相似度和泛化能力,LoRA 仍是王者,而 Fizgig v6 完整保留了其 H3 和 Krea 2 LoRA 训练器,未做改动。
获取方式
Fizgig v6.0.1 已在 GitHub 上发布。在 ComfyUI 中,你需要 MiniMaxH3Mod 节点包来加载这些文件,作者的 RefMods - how do I...? 指南会带你走完从照片到加载 mod 的整个流程。
评论
使用 GitHub 登录后即可参与讨论。