YuE2 真实音频编码器:把你自己音乐带入 YuE2
社区为 YuE2-3B 打造的缺失音频编码器,可将你自己的录音转换为语义 token 用于 LoRA 训练,另附一个支持段落提示的纯音乐 LoRA。
YuE2 从未发布的缺失组件
YuE2-3B 能根据风格提示和歌词生成完整歌曲。它在内部写入“语义 token”,再解码为音频,但把已有录音映射回这些 token 的编码器从未发布。没有它,就无法把自己的音乐带入模型进行微调。
新的 yue2-mothersuperior-realaudio-tokenizer-v4 背后的诀窍是:让模型自我教学。YuE2 生成的每首歌都自带生成它的确切 token,这是无需人工标注的现成带标签样本。作者生成了数千首涵盖多种流派的歌曲,在这些配对数据上训练了一个小型编码器,然后让 YuE2 自己的解码器为编码器“打分”,从而将其适配到真实录音:如果这些 token 能重建出真实音频,它们就是正确的。真实音乐的 token 标签完全不需要。
本次发布包含什么
tokenizer 仓库提供了三个部分:
- Tokenizer 头:一个 8 层 transformer(d=512),将 MERT-v2-FullSong 第 20 层特征映射为 YuE2 在 25 Hz 下的 32,768 个语义码。在 YuE2 自身歌曲的留出集上,top-1 精确匹配率为 16.1%,近似码的渲染结果几乎一致,NAR 往返听测约 95%。
- NAR 分支 LoRA(
nar_lora_joint_v4):作用于 NAR 自注意力和 MLP 投影上的 rank-32 LoRA,与编码器头在真实音频上联合训练,使解码器能够渲染真实制作的 latent。 - 训练与推理脚本,任何人都可以复现或扩展该流程。
纯音乐 LoRA
后续发布的纯音乐 LoRA(ar_lora_inst_v3abc)在约 2,700 首、覆盖 100 多个流派的纯音乐曲目上训练,并配有带和弦标注的 ABC 乐谱。它让 YuE2 按段落规划创作纯音乐,并且需要开启 chain-of-thought(cot="full")运行,此时模型先写出自己的 ABC 乐谱,再依据该乐谱生成音乐 token。
歌词字段接受三种结构提示风格,各占训练数据的三分之一:
- 裸标签:只写
[instrumental],由模型自行选择结构和长度。 - 无时间标签:你决定段落顺序,模型决定时间,例如
[intro]/[verse]/[chorus]/[bridge]/[chorus]/[outro]。 - 带时间标签:每个段落还带有起止时间,如
[verse 0:15-0:45],这是最强的结构引导,不过模型对段落顺序和比例的遵循要好于对绝对结束时间的遵循。
在 ComfyUI 中使用
两个 LoRA 都提供了 *_comfyui.safetensors 变体,按 ComfyUI 原生 YuE2 布局打包(融合的 qkv / gate_up 键):
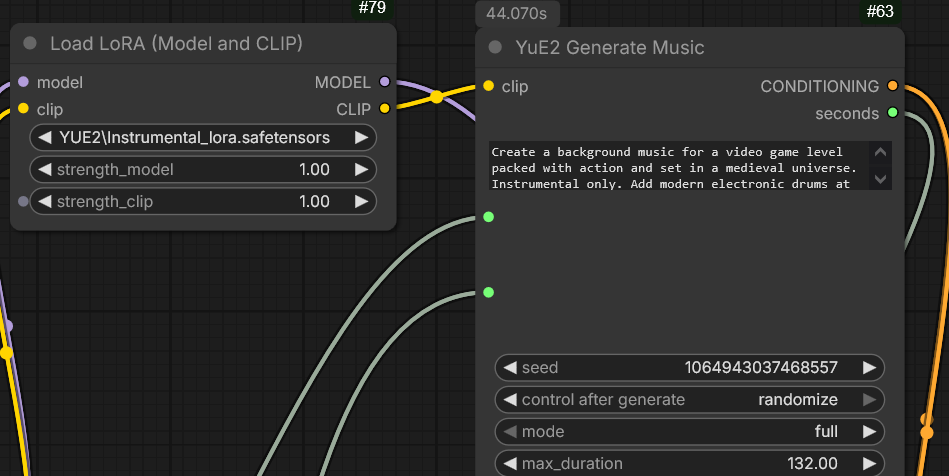
nar_lora_joint_v4_comfyui.safetensors通过标准 LoraLoader 加载到 YuE2 checkpoint 加载器的 MODEL 输出上。ar_lora_inst_v3abc_comfyui.safetensors加载到 CLIP 输出上,因为 AR 规划器位于 CLIP 槽位,并且需要将 YuE2 Generate 节点的mode设为 full,同时连接 ABC 节点。
纯音乐 LoRA 最初的 Reddit 版本在 ComfyUI 中无法生效,原因是 ComfyUI 的层命名约定;作者在几分钟内发布了兼容文件,帖中用户以“太棒了,简直太好了。你就是个巫师”之类的反应确认了修复。
对生态的影响
该编码器解锁了一批此前受阻的后续工作:作者自己的哼唱转歌曲适配器(哼出一段旋律,YuE2 生成完整歌曲)、一个社区 LoRA 训练器节点包,以及基于真实录音训练的流派或艺术家 LoRA。作者指出,YuE2 的 LoRA 训练“现在将开始遍地开花”,因为任何人都可以用这些脚本把自己的音乐训练成 LoRA。
获取方式
权重在 Hugging Face 上免费提供:真实音频 tokenizer v4、纯音乐 LoRA 以及哼唱转歌曲适配器。在 ComfyUI 中,将它们与原生 YuE2 pipeline 节点搭配使用;ComfyUI 兼容的 LoRA 文件可直接用自带 LoRA 加载器加载,无需转换。
评论
使用 GitHub 登录后即可参与讨论。