ComfyUI v0.36.0:原生支持 Marigold V2 与视频拼接节点
ComfyUI v0.36.0 原生支持 Marigold V2 深度、法线与反照率估算,并提供三个官方工作流,还新增了视频拼接节点、FastH3、YuE2 以及一批合作节点更新。
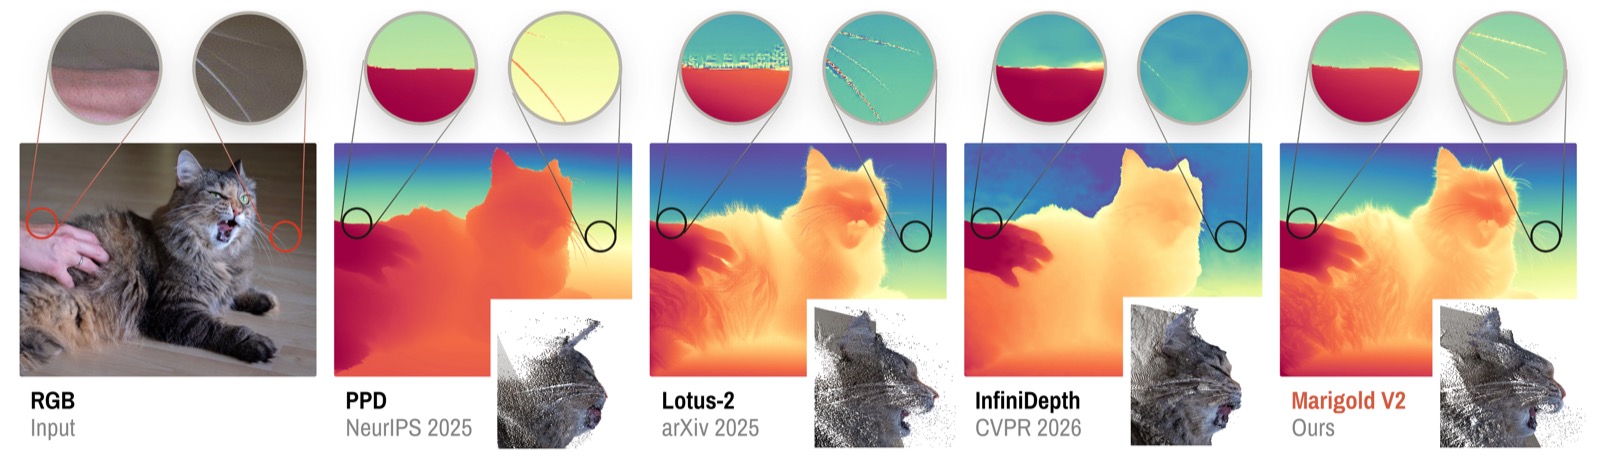
Marigold V2 可直接从单张图像中读取几何信息:同一系列模型即可输出深度、表面法线与反照率(预览图来自项目仓库)。
Marigold V2:深度、表面法线与反照率
Marigold V2 由华为拜耳实验室联合 EPFL 和博洛尼亚大学推出,并在 SIGGRAPH Asia 2026 上展示(arXiv:2609.08084)。它并非从头训练新的 diffusion 模型,而是通过各任务专属的 LoRA 权重和微调后的 VAE 解码器对 Qwen-Image-Edit-2509 进行微调,随后在单步采样中从 latent 中读取预测结果。
核心支持通过 Comfy-Org/ComfyUI#16232(CORE-431)合并,官方模板则使用 Comfy-Org 在 Comfy-Org/marigold-v2-0 重新打包的权重文件。共覆盖三项任务:
- 深度:来自论文默认
depth/Log-stage2模型的仿射不变对数深度,在 Hypersim 和 Virtual KITTI 2(约 7.4 万张图像)上训练。 - 表面法线:相机空间单位法线。
- 反照率:取值在 [0, 1] 范围内的线性 RGB 反照率。
上游发布还提供了可预测玻璃后方几何结构的透视(分层)深度模型,以及均匀深度和视差消融版本。ComfyUI 包中提供上述三种主要模态。
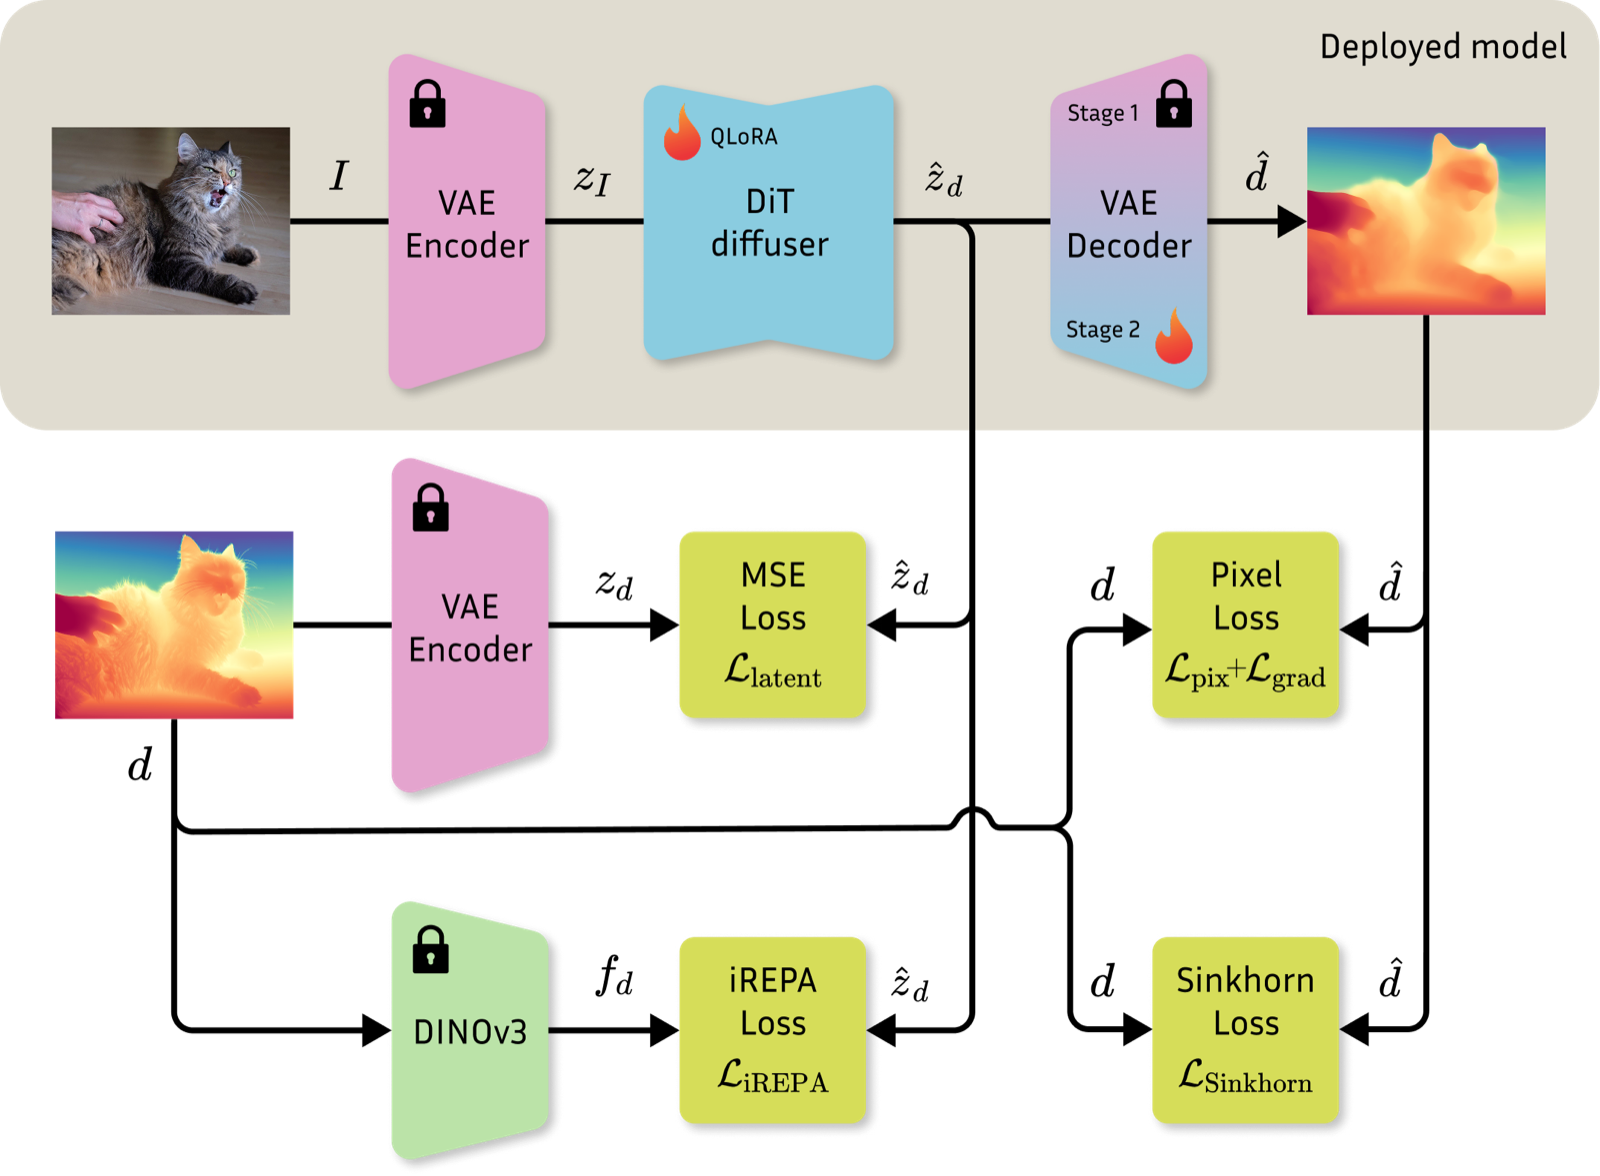
来自项目仓库的方法概览:同一个 Qwen-Image-Edit-2509 主干网络按不同的密集预测任务进行适配。
Marigold V2 工作流内部解析
每个模板都以子图形式构建。它加载 int8 ConvRot Qwen-Image-Edit-2509 基础模型 qwen_image_edit_2509_int8_convrot.safetensors,应用任务 LoRA,加载预先计算好的条件 embedding 和任务 VAE,然后使用 euler 在 0.5 -> 0 的 sigma 上采样,即一步完成。无需文本编码器:提示词 embedding 以 *_conditioning.safetensors 文件形式提供,通过 ConditioningLoader 加载。
新增的 Marigold V2 后处理节点(MarigoldV2PostProcess,类别 image/geometry estimation)可将解码后的预测转换为可视图像,并通过 prediction 开关选择 depth(归一化,近处更亮)、normals(单位法线)或 albedo(sRGB)。
模板所需的文件:
📂 ComfyUI/
└── 📂 models/
    ├── 📂 diffusion_models/
    │   └── qwen_image_edit_2509_int8_convrot.safetensors
    ├── 📂 loras/
    │   ├── marigold_v2_depth_log_stage2.safetensors
    │   ├── marigold_v2_normals.safetensors
    │   └── marigold_v2_albedo.safetensors
    ├── 📂 embeddings/
    │   ├── marigold_v2_depth_conditioning.safetensors
    │   ├── marigold_v2_normals_conditioning.safetensors
    │   └── marigold_v2_albedo_conditioning.safetensors
    └── 📂 vae/
        ├── marigold_v2_depth_log_stage2_vae.safetensors
        ├── marigold_v2_normals_vae.safetensors
        └── marigold_v2_albedo_vae.safetensors
随模型公布的零样本指标:在 NYUv2 上深度 AbsRel / δ1 为 3.6 / 98.0,KITTI 上为 5.4 / 97.4,ETH3D 上为 2.8 / 99.2,ScanNet 上为 3.7 / 97.9,DIODE 上为 5.2 / 97.1;在 NYUv2 上表面法线的平均角度误差为 16.6°;在 Hypersim 测试集上反照率 PSNR 为 20.78,SSIM 为 0.811。
视频拼接节点
v0.36.0 新增了拼接视频节点(ConcatenateVideo,类别 video),可在节点图中将多个片段首尾相接:
- 输入以
video1、video2等自动扩展,最多支持 100 个片段,并按输入顺序依次追加。 - 当各片段已使用兼容的编解码器编码时,可直接拼接而无需解码。
codec默认为auto(H.264),已编码的视频保持不变。- 可选的
complete_audio输入可覆盖各片段自带的音频,这在片段来自不同生成任务时非常实用。
FastVideo FastH3 与 YuE2 支持
本次发布还将两个更早的模型提升到核心构建中:
- FastVideo FastH3,即 8 步蒸馏版 MiniMax H3,用于文生视频和图生视频,并原生支持音频。有关模板所依赖的模型和 VSA 注意力设置,请参阅 FastH3 8-Step V2 获得原生 ComfyUI 模板。
- YuE2,可根据风格提示词与歌词生成音乐,并附带针对 AMD 系统的后续修复、更高的歌曲最大时长以及生成节点上更多的控制项。更早的报道:YuE2。
其他节点与核心变更
- 通用循环:同一版本中加入了开始循环与结束循环节点,用于在节点图内遍历列表,同时还有创建列表和从列表获取项目节点。
- 转换图像色彩空间新增了
linear目标色彩空间(线性 Rec.709),在现有的 sRGB、HDR 和 HDR PQ 色彩空间之外提供更多选择。 - Gemini 文本节点:新增
GeminiNodeV3,V2 节点已弃用。 - MiniMax H3:在 int8 ConvRot VAE 优化的基础上进一步降低了视频 VAE 的显存占用。
- Windows 上的 AMD:虚拟地址配额提升至 4TB(CORE-409),并从量化算子中移除了一个已失效的 ROCm triton 架构门控。
合作节点更新
- Tripo P2:文本、图像与多视图生成 3D模型的节点。
- Pruna P-Video-2:支持 720p/1080p 的文生视频与图生视频,并提供草稿模式。
- BFL:新增 Flux 视频编辑节点,可根据文本指令编辑源视频片段。
- Bria:新增图像编辑节点,以及一个视频擦除节点。
- OpenRouter:支持 Microsoft
mai-image-2.6模型,图像节点支持自动宽高比。 - Client:合作节点进度现在会读取预计时长响应头来显示进度。
修复与其他变更
- 修复了启用 ComfyUI 编译器时 H3 Fun ControlNet 的问题。
- 图像添加噪声节点不再向 Alpha 通道添加噪声。
- 修复了 Yue2 的 AMD 问题,并为生成 ABC 节点增加了更多控制项。
- RoPE 现在在更多基于 llama 的模型上使用快速内核,这覆盖了 Qwen-Image-Edit 类模型所使用的文本编码器。
- comfy-kitchen 更新至 0.2.34,comfyui-frontend-package 更新至 1.52.7,workflow templates 更新至 v0.11.62。
- 资源记录已从内容中分离,置于
--enable-assets标志之后。
获取 v0.36.0
通过管理器或你惯用的启动器更新 ComfyUI。Marigold V2 工作流和视频拼接节点需要 v0.36.0 或更高版本,Desktop 与 Cloud 构建则跟随稳定版发布。
评论
使用 GitHub 登录后即可参与讨论。