Rumik OSS 1: 3B 开源 TTS 模型,支持 22 种印度语言
Rumik AI 开源 rumik-oss 1:一个 3B 文本转语音模型,覆盖 22 种印度语言及英语,支持语码混合合成、风格条件控制与内联笑声标签。
<laugh>、<chuckle> 和 <sigh> 标签。同时提供了用于社区后训练的基础 checkpoint,并已上线可交互的 Hugging Face 演示。
概述
rumik-oss 1 在 tiny aya fire 的基础上扩展,引入来自 mimi codec 的离散语音 token。文本条件与音频生成共享同一个自回归序列:模型按 codebook 顺序为每个音频帧预测八个 codebook token,随后由冻结的 mimi 解码器以 24 kHz 重建波形。
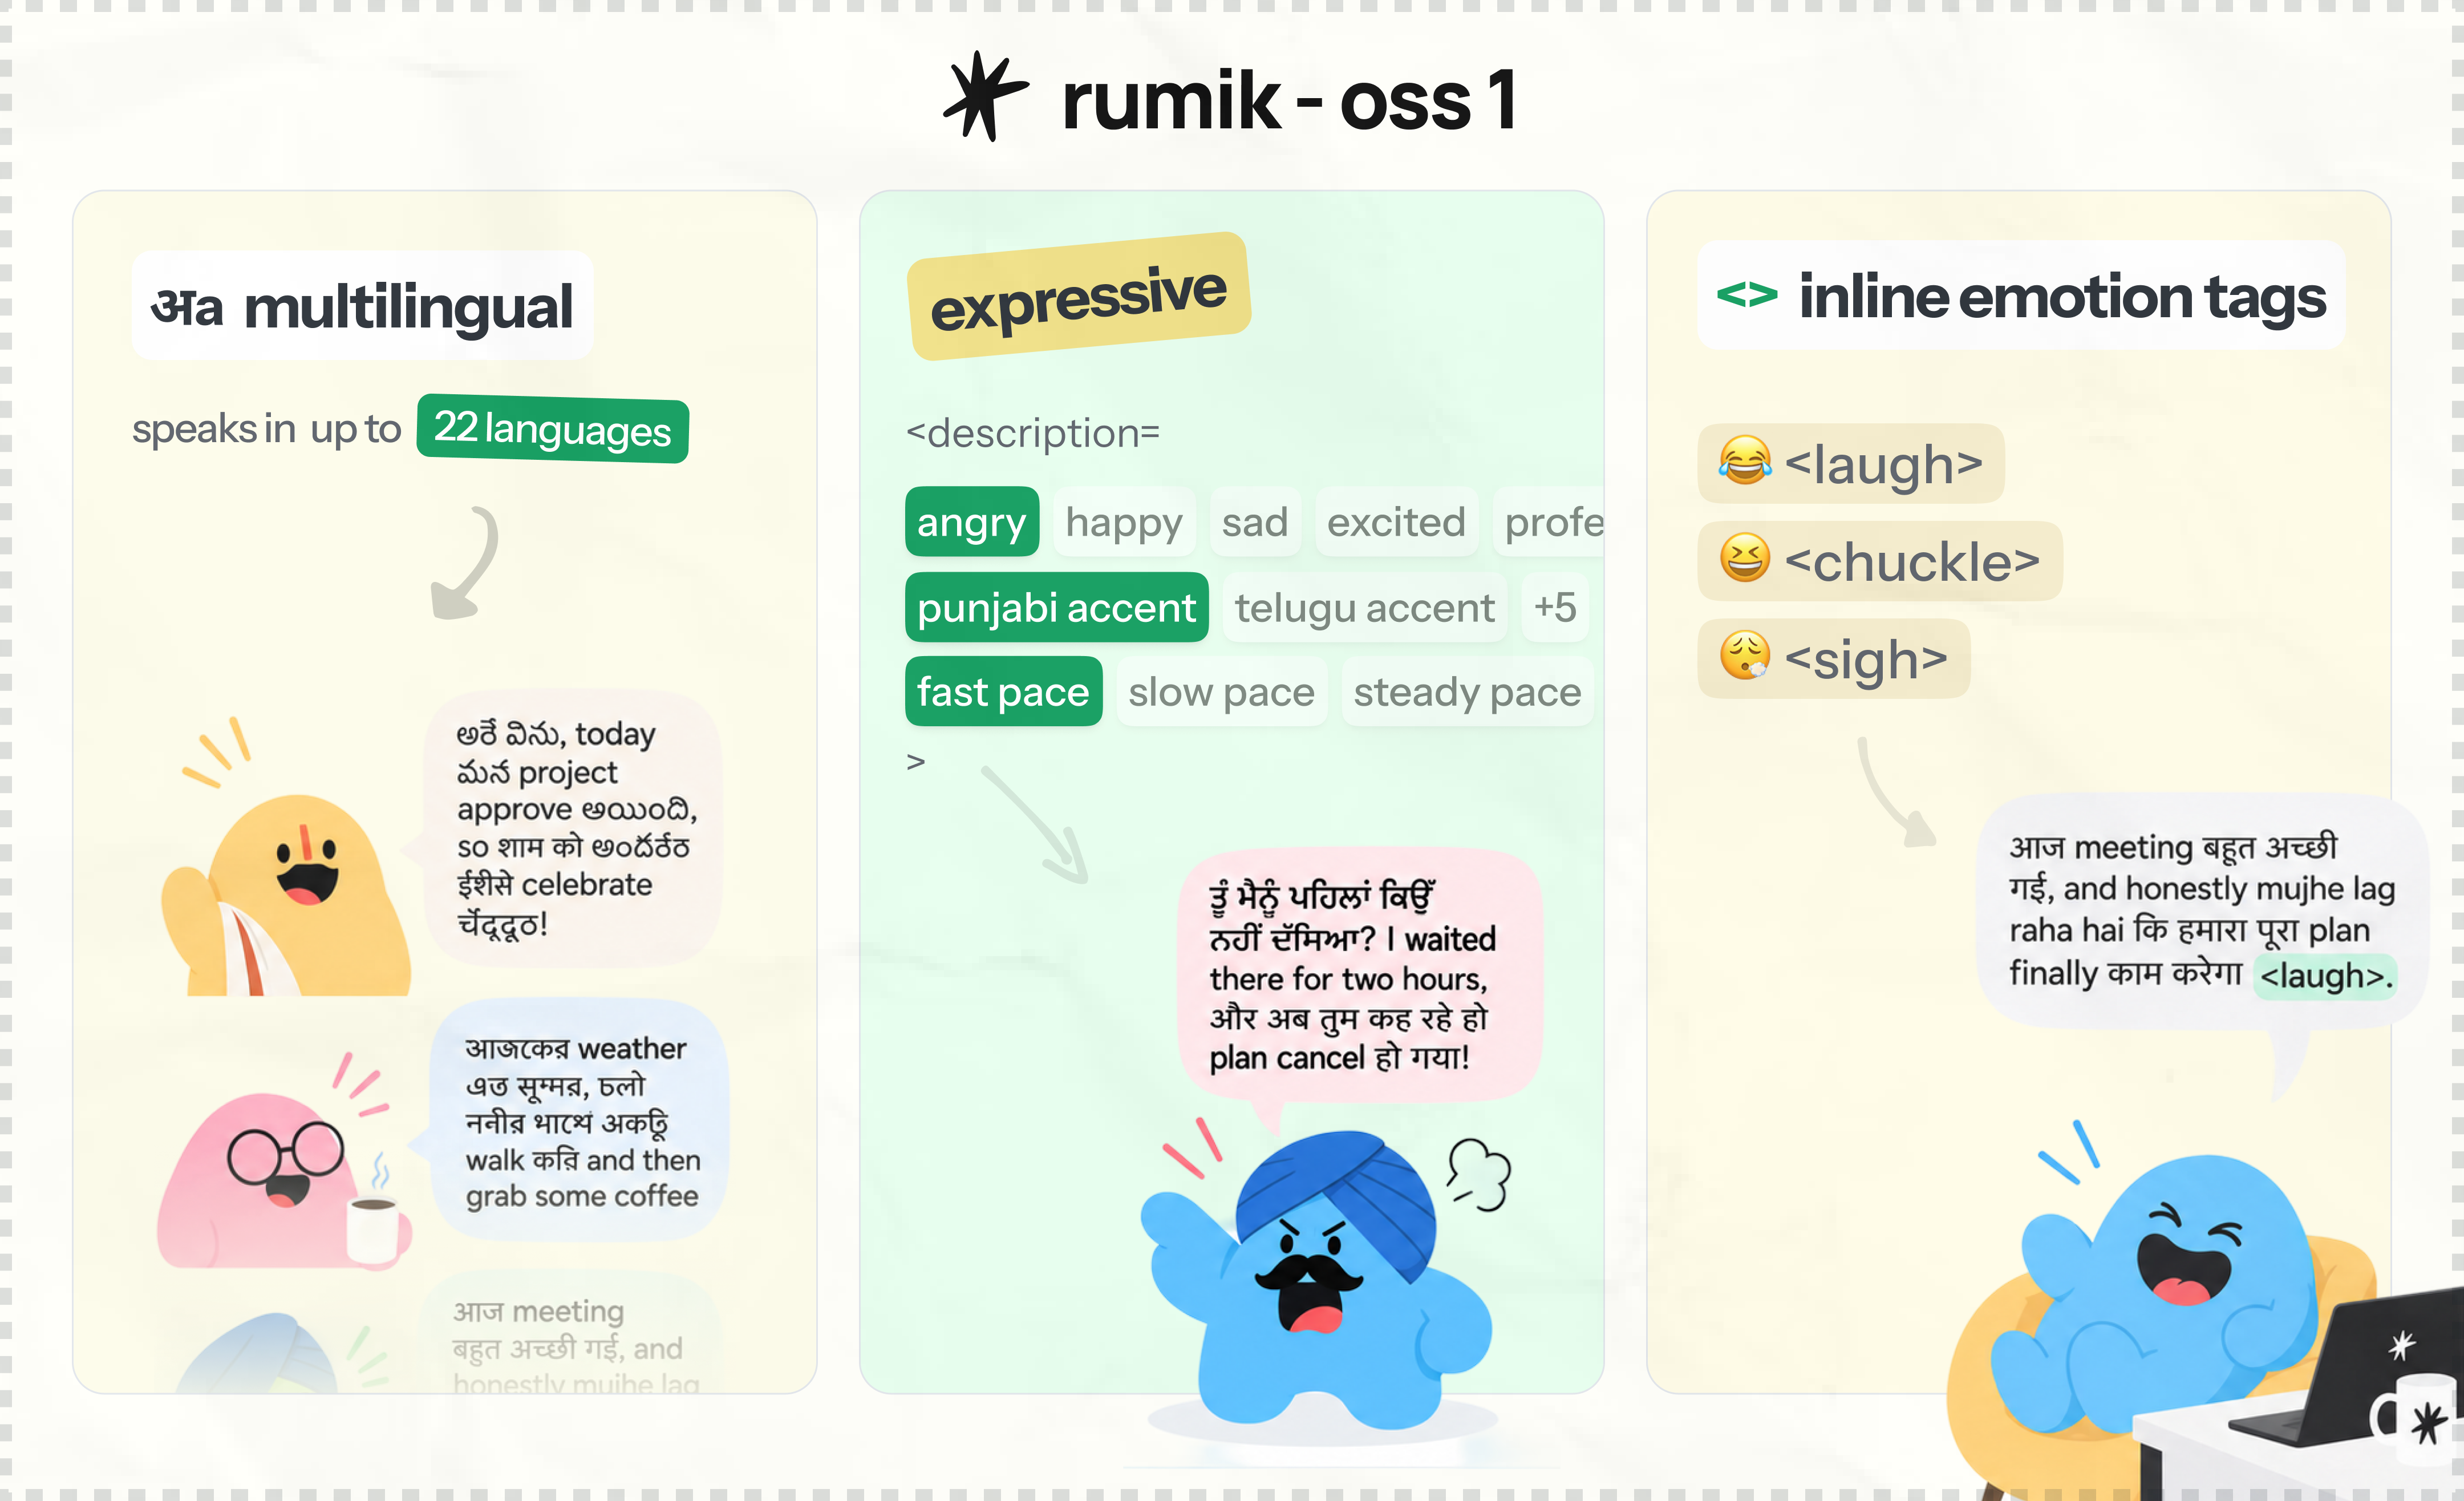
内置的四个音色(Ira、Aisha、Siya、Zoya)均可在全部 22 种语言中使用,这与将某一音色绑定到单一语言的 TTS 模型不同。<description="..."> 前缀可控制语调(开心、悲伤、愤怒、兴奋、专业)、口音和语速,内联标签则可在特定词语处插入笑声、轻笑和叹息:
<description="excited, Hindi accent, fast pace"> जल्दी आओ, हमारा नाम लिस्ट में है! <laugh> आज घर में जश्न होगा।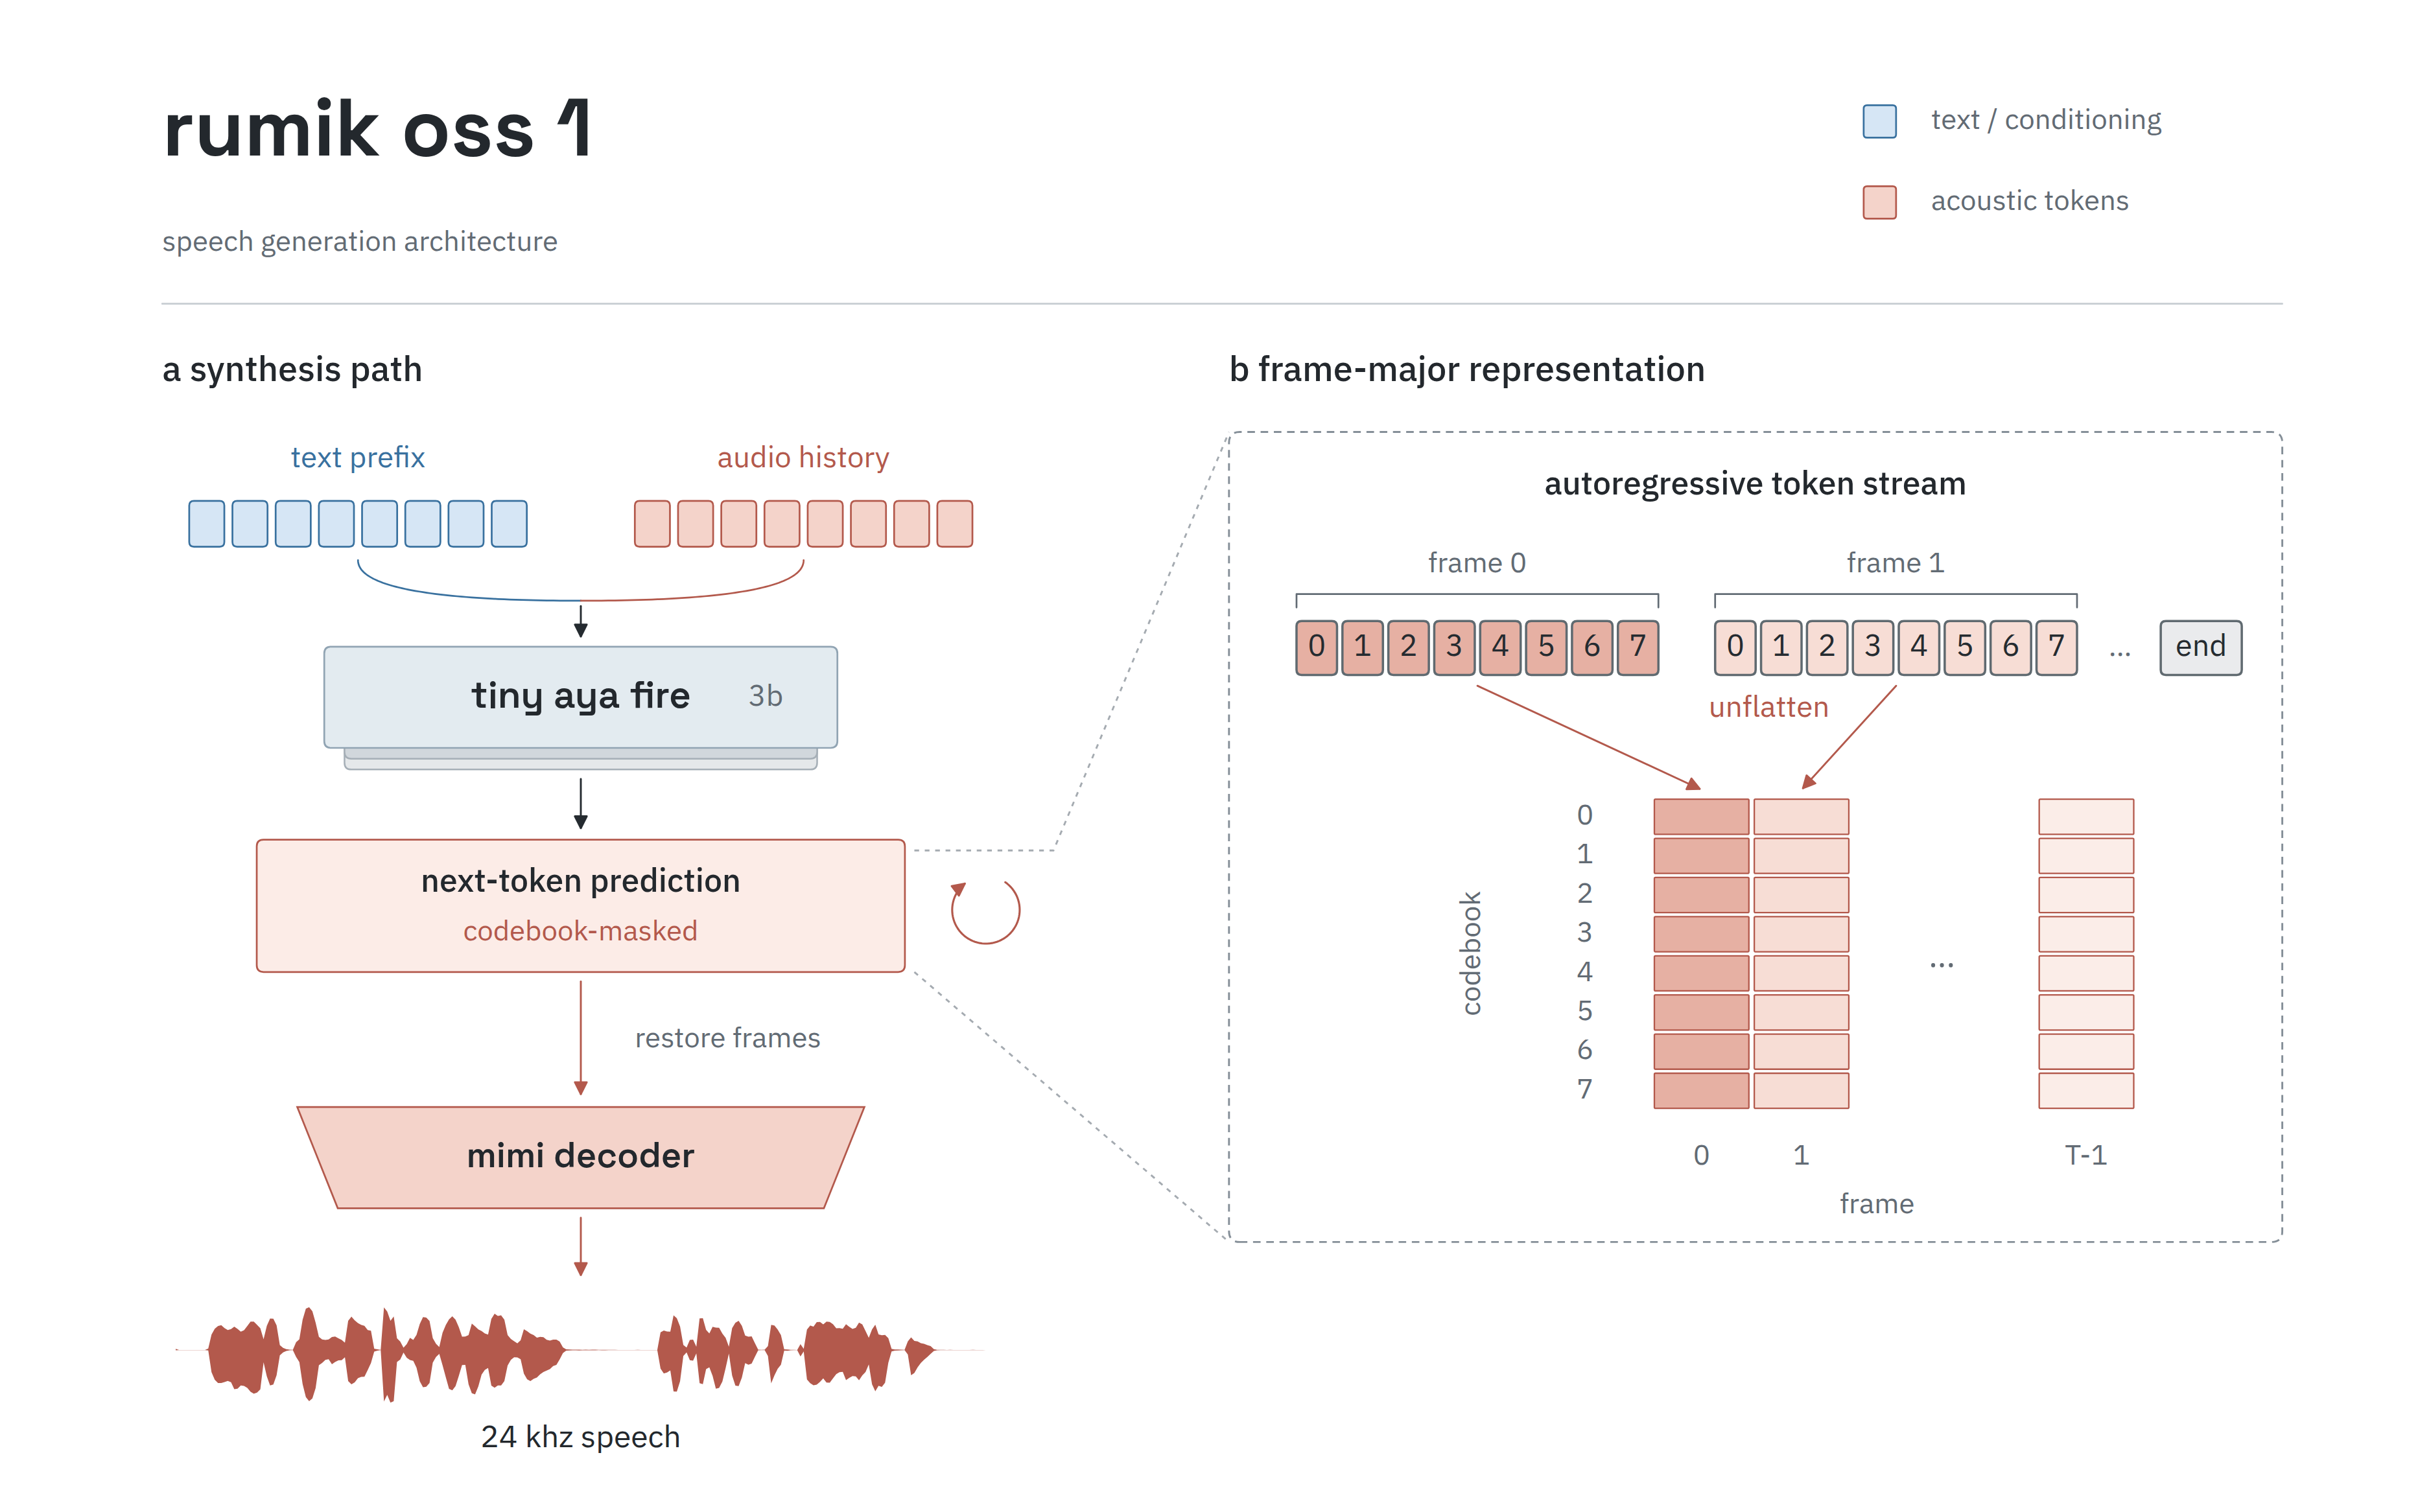
架构:以帧为主的 codec token 预测,由冻结的 mimi 解码器解码。
基准测试
团队随模型一同发布了三个新基准,全部提供公开代码与逐样本结果:
| 基准 | 衡量内容 | rumik-oss 1 | 最佳系统 |
|---|---|---|---|
| IndicEmo | 语码混合语音中的表现力表达 | 2.92 / 5 | Gemini 3.1 Flash TTS (4.58) |
| NoVA | 内联发声在正确位置上的呈现 | 0.884 | Grok TTS (0.972) |
| WER/CER | 15 种语言的转写保真度 | 按语言分别报告 | 参见 README |
在 NoVA 上,rumik-oss 1 将请求的笑声和叹息渲染到正确词位置的能力,比 ElevenLabs v3(0.705)和 Gemini 3.1 Flash TTS(0.664)更可靠,仅落后于 Grok TTS 和 Inworld tts-2。README 中的音频示例展示了全部四个音色在印地语、英语、泰卢固语、泰米尔语、孟加拉语、卡纳达语和旁遮普语中的表现,其中包括语码混合的印地语-英语和泰卢固语-英语生成。
局限性
训练语音最长不超过 30 秒,因此团队不建议生成超过 35 秒的语音,且未请求的发声会出现在 2.9% 至 5.4% 的输出中。音频 token 必须由随附的 mimi codec 解码;不支持标准的 transformers.pipeline("text-to-speech") 路径。
可用性
权重位于 Hugging Face,采用 CC-BY-NC 4.0 许可(研究与非商业用途),并搭配单独许可的 mimi codec,另有面向 Apple Silicon 的 MLX 量化版本。一个 Hugging Face Space 提供交互式演示。目前尚无原生 ComfyUI 集成;该模型面向通过仓库中一次性生成示例进行的 Python 推理。
评论
使用 GitHub 登录后即可参与讨论。