Direct3D-V3: уточнение воксельного меша без латентов в ComfyUI
Direct3D-V3 уточняет черновой 3D-меш воксельной диффузией без латентов вместо VAE, а пакет узлов ComfyUI от сообщества уже запускает его на Windows-видеокартах.
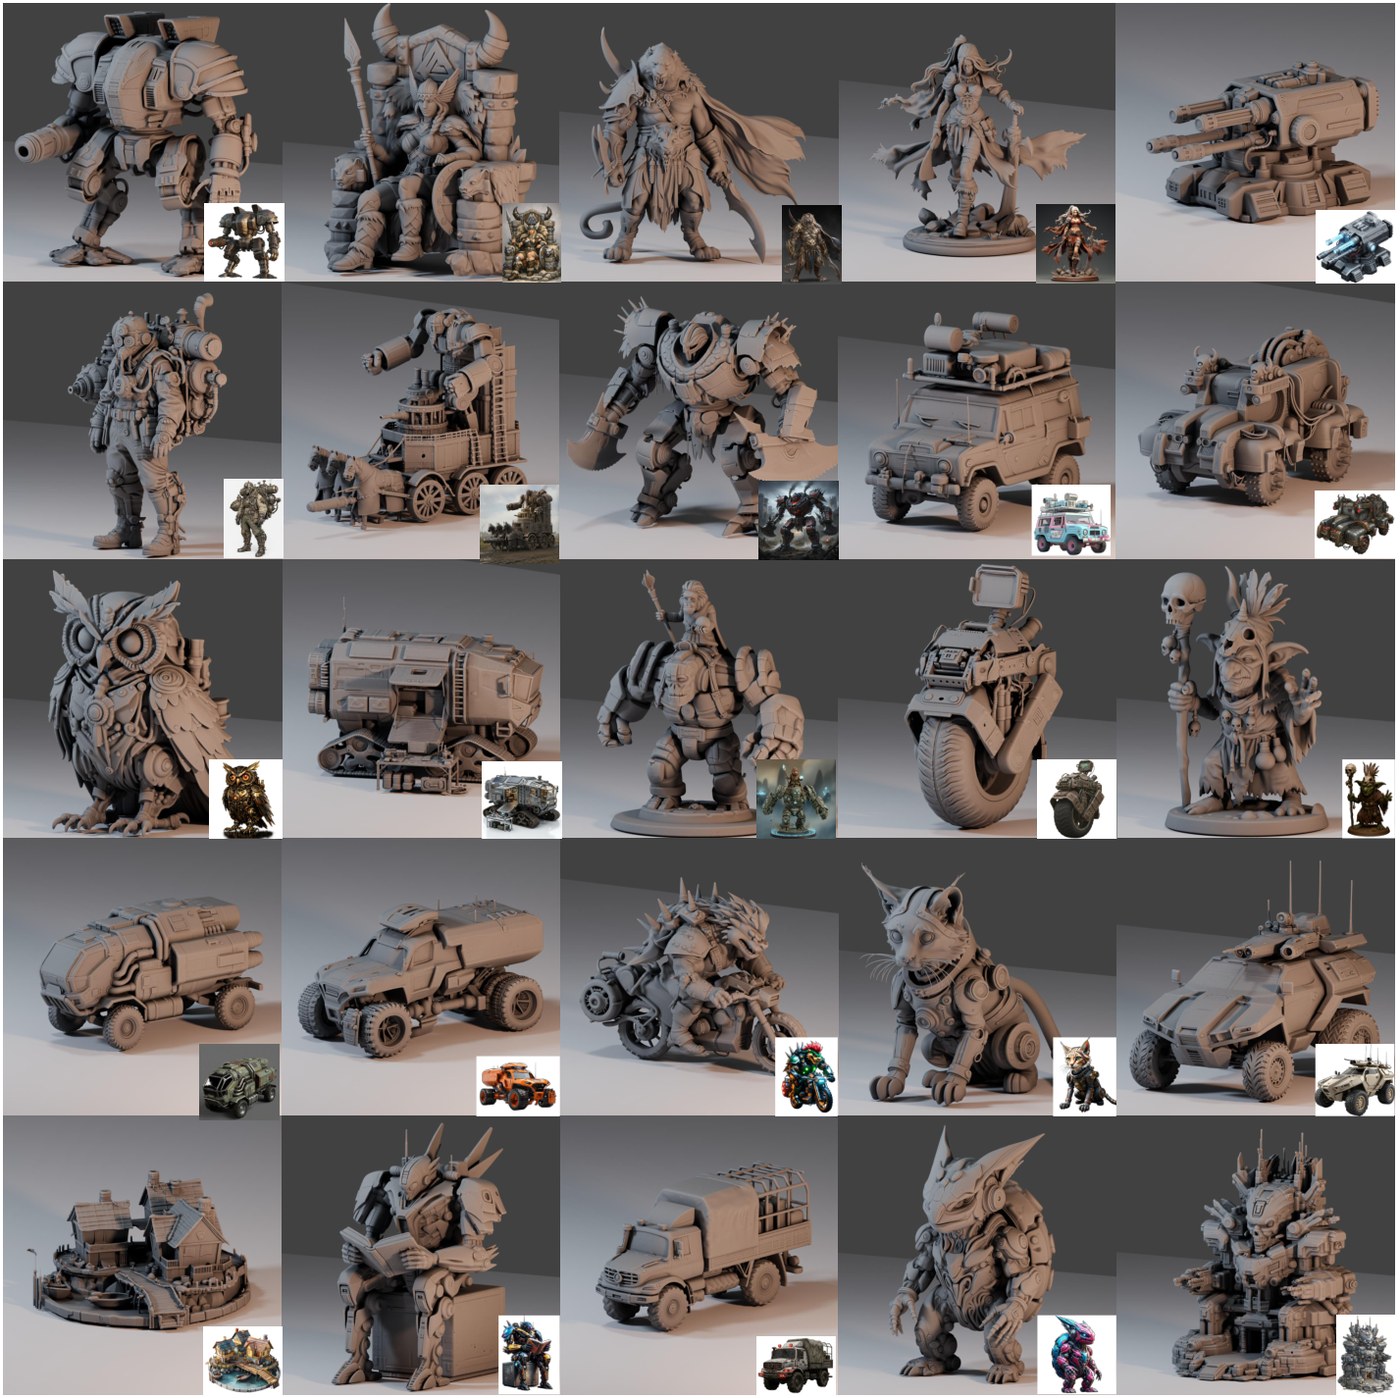
Сгенерированные меши и детализация поверхности из дополнительных результатов статьи.
Что он делает
Подайте на вход черновой меш в той же ориентации, что и референсное изображение, и он уточнит форму: канавки, фаски, тонкие структуры и острые рёбра, которые черновой этап сгладил. Неявная регуляризация многообразия держит поверхности замкнутыми. Меш по умолчанию упрощается до 2 млн треугольников (target_faces) и экспортируется в GLB.
Аргумент статьи в том, что любой image-to-3D пайплайн, построенный на латентной диффузии, теряет мелкую геометрию дважды: сначала когда VAE сжимает форму, а затем потому что VAE обучается на реконструкцию, тогда как генератор обучается на согласование распределений. Direct3D-V3 отказывается от VAE и моделирует сырые SDF-воксельные сетки напрямую с помощью diffusion transformer, добавляя регуляризацию многообразия по соседним вокселям и вспомогательную задачу предсказания камеры, чтобы изображение-условие совпадало со сгенерированной геометрией.
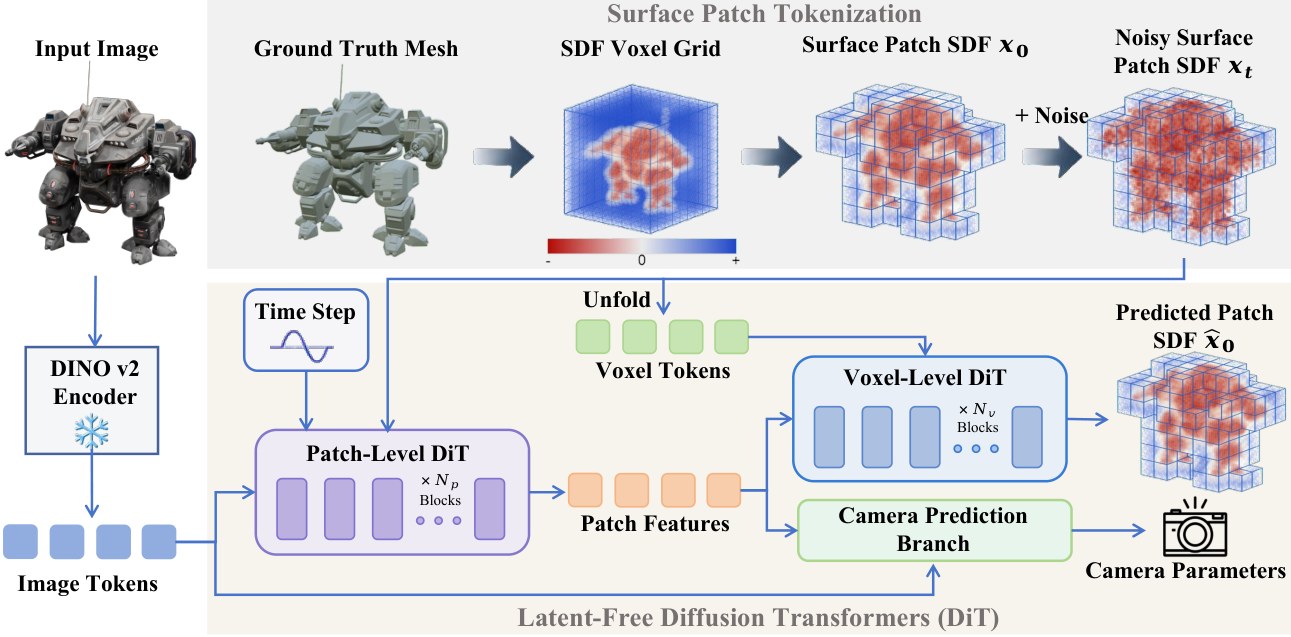
Обучение и выборка происходят непосредственно по воксельной сетке, а меши получаются через Marching Cubes.
Поставляются три чекпойнта: 512, 1024 и 1536. Их можно запускать каскадом или одним этапом, а стартовые ориентиры: 15 шагов и CFG 4 на 512 и 1024.
Запуск в ComfyUI
- Скачайте одну из сборок для Windows из Direct3D-V3_Comfyui_Nodes (cu128 для Python 3.12 и PyTorch 2.8, cu130 для Python 3.13 и PyTorch 2.12.1) и распакуйте папку в
ComfyUI/custom_nodes. - Запросите доступ к DINOv3 ViT-H+ на Hugging Face. Узел использует его как энкодер изображения, и при настройке потребуется токен на чтение.
- Запустите
setup.cmdв папке узла. Он создаёт отдельное окружение Python в.runtime, скачивает PyTorch, DINOv3 и чекпойнт 1536. Стоит заранее заложить несколько ГБ на диске. - Добавьте Direct3D-V3 Clean | Mesh File Path и Refine (Mesh File, Low VRAM), подключите путь к файлу меша, референсное изображение и маску переднего плана, затем начните с
resolution = 1536иstage_mode = single_stage.
Обе сборки узлов самодостаточны: не нужны CUDA Toolkit или Visual Studio, вокселизаторы для серий RTX от 20 до 50 уже собраны, а ComfyUI использует собственные Python и PyTorch. Внимание по умолчанию efficient; cudnn_fp16 быстрее на FP16, но меняет округление, поэтому фиксируйте seed при сравнении экспортов.
Что видят тестировщики
- MostAadTech, автор пакета узлов, прогнал этап 1536 со 114 832 воксельными патчами при пиковом зарезервированном VRAM 6 008 MiB и завершил полного дракона за 9 мин 56 с с пресетом cuDNN, при нулевом shrink.
- Во втором прогоне получено 4,15 млн вершин / 8,3 млн треугольников, а выполнение промпта заняло 325 с.
- Kijai замерил примерно 4,9 ГБ пиковых активаций при около 100 тыс. токенов, из которых примерно 2 ГБ приходится на skip-токены, постоянно находящиеся в памяти.
- Реальный полный пайплайн длиннее, чем один рефайнер: черновой меш из Pixal3D или TRELLIS.2, карта нормалей из Qwen-Image-2.1, затем Direct3D-V3, затем текстурирование с UltraTex.
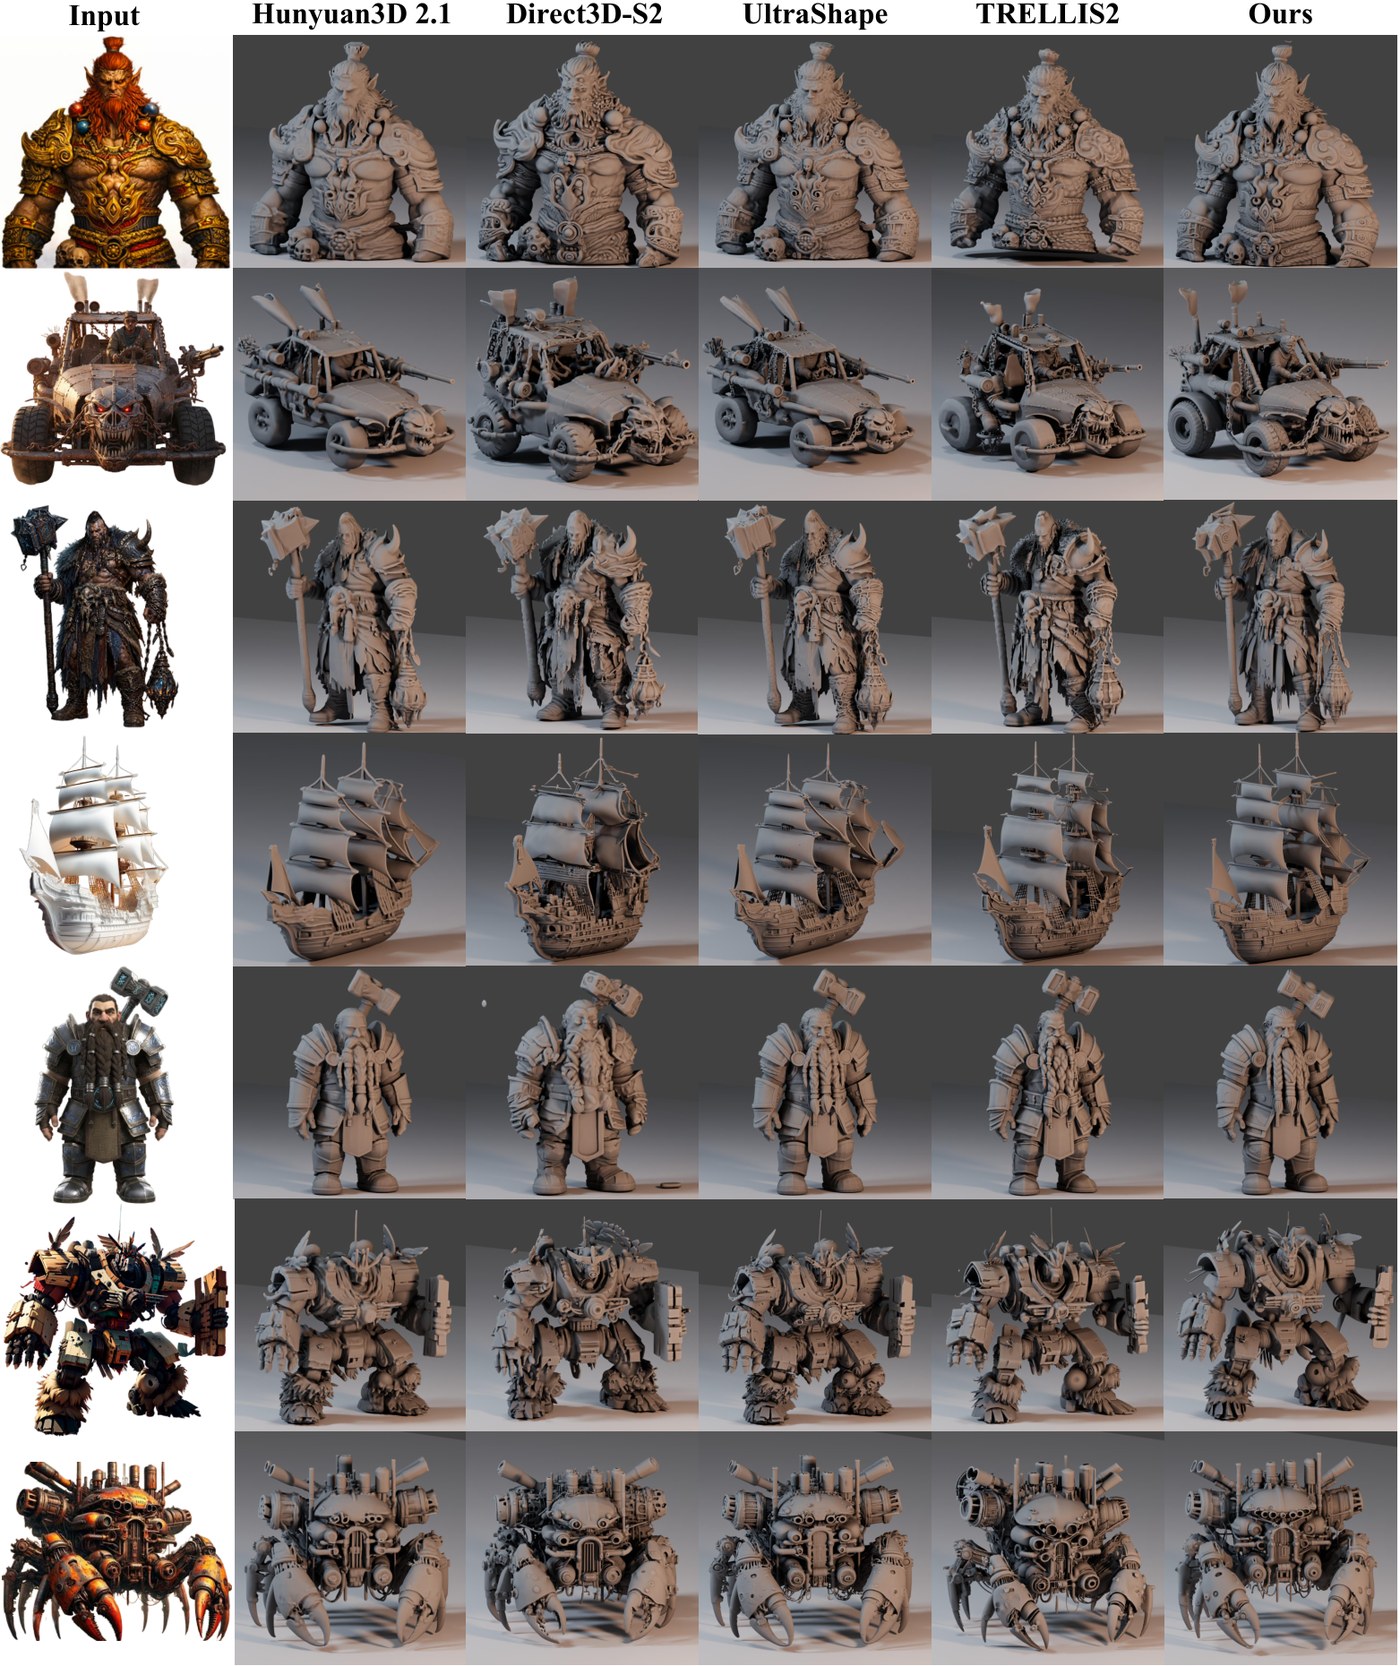
Качественное сравнение с другими open-source методами image-to-3D из статьи.
ДО начала
- В релизе нет чернового этапа. Авторы рекомендуют Hunyuan3D-2.1 или UltraShape-1.0 для начального меша; их собственные черновые модели пока остаются в списке задач.
- Референсное изображение значит больше, чем обычно. Карта нормалей поверхности или белый clay-рендер дают заметно более мелкую детализацию, чем текстурированное RGB-изображение. Репозиторий предлагает для такого преобразования ChatGPT (GPT Image 2.5) или Lotus-2, а Qwen-Image-2.1 подходит как бесплатный вариант.
- Опубликованные веса новее, чем в статье. Авторы сообщают, что выпущенные чекпойнты используют четыре слоя DINOv3, оптимизатор Muon и дают более тонкие поверхности, чем модель, оценённая в статье, поэтому цифры из статьи занижают текущий результат.
- Код текстурирования и обучения ещё не опубликован. В этом релизе есть только уточнение меша, поэтому текстуры берутся из отдельной модели.
Где взять
- Веса: wushuang98/Direct3D-V3 (чекпойнты этапов 512, 1024 и 1536)
- Официальный код, демо на Gradio и примеры вывода: DreamTechAI/Direct3D-V3
- Статья: SIGGRAPH Asia 2026, arXiv 2611.26511 с результатами на странице проекта
- Адаптер для ComfyUI (Windows): Mstafa-awad/Direct3D-V3_Comfyui_Nodes
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.