WeVisOne-VL в ComfyUI: боксы, маски и матты по одному промпту
Модель WeVisOne-VL от Tencent теперь работает в ядре ComfyUI. Одна нода Detect превращает текстовый запрос в боксы, маски, альфа-матты, точки, счётчики и OCR-боксы.
WeVisOne-VL — это модель компьютерного зрения от Tencent WeChat Vision, и теперь она работает в ядре ComfyUI. Поддержка появилась 2026-11-09 в PR 17632. Вы подаёте на вход изображение и фразу, а на выходе получаете боксы, маски, альфа-матты, точки, счётчик или OCR-боксы. Без SAM, без пользовательских нод, без отдельного бэкенда сегментации.
Чекпойнты 2B и 4B — это файнтюны Qwen3-VL с декодером масок на 9,6 млн параметров. Нода читает фразу, записывает координаты как обычные токены, а декодер превращает соответствующие токены в попиксельный результат.
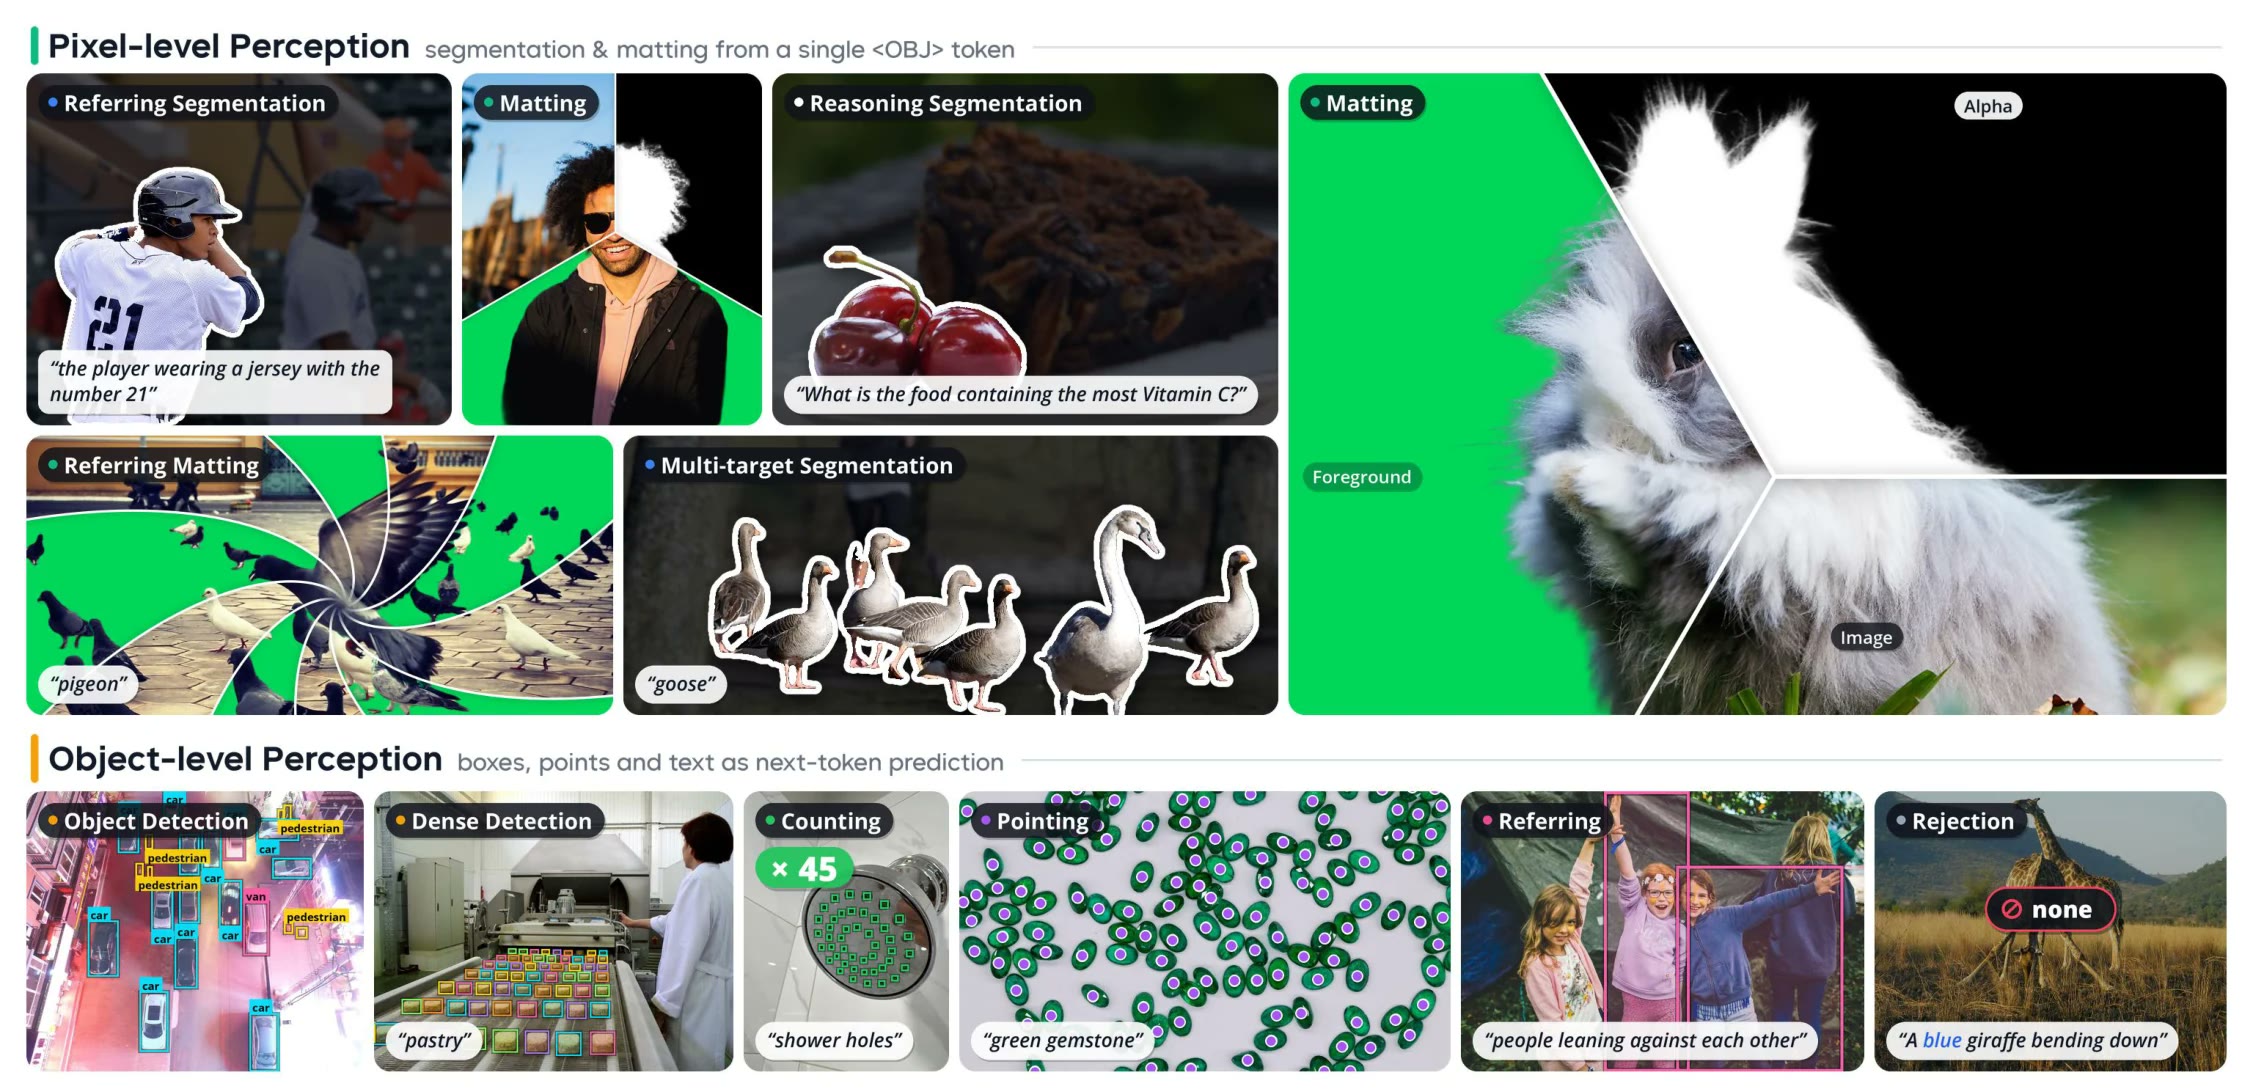
Одна модель покрывает точки, боксы, бинарные маски и непрерывные альфа-матты. Источник: страница проекта
Что возвращает нода
WeVisOne-VL Detect находится в категории image/detection и имеет четыре выхода: masks, bboxes, points (JSON в пиксельных координатах) и сырой текст ответа. Что именно вы получите, зависит от выбранной задачи.
| Задача | Что вводите | Выход |
|---|---|---|
segmentation | фразу, например person | боксы плюс альфа-матты для каждого экземпляра |
detection | одну метку на строку | боксы, готовые для Draw BBoxes |
referring | описывающую фразу | боксы для подходящего объекта |
point | одну метку на строку | координаты точек в виде JSON |
count_box / count_point | субъект, например cars | счётчик с боксами или точками |
ocr | оставить пусто | каждое слово как бокс |
ocr_grounding | текстовую строку | где находится этот текст |
visual_prompt | референсные боксы из другого прогона | объекты, похожие на референс |
freeform | весь ваш промпт | сырой ответ |
Включите individual_masks, чтобы сохранять по одной маске на бокс вместо единой объединённой маски. Для вырезания подайте masks и изображение в InvertMask + JoinImageWithAlpha.
Каждая координата — это один токен от <0> до <1000>, поэтому бокс стоит четыре токена. Источник: страница проекта
Как это запустить
-
Обновите ComfyUI. Нода есть в master; последний тег (v0.44.2) её пока не содержит.
-
Скачайте веса из Comfy-Org/WeVisOne-VL в
ComfyUI/models/text_encoders/. В репаке четыре файла:Файл Размер wevisone_vl_4b_bf16.safetensors9,7 ГБ wevisone_vl_4b_int8_convrot.safetensors5,3 ГБ wevisone_vl_2b_bf16.safetensors4,9 ГБ wevisone_vl_2b_int8_convrot.safetensors2,9 ГБ -
Загрузите
CLIPLoaderс типомstable_diffusionи выберите один из этих файлов, затем подключите его к входуclipноды.
Пример с тремя группами из PR: альфа-матирование на человеке, детекция и OCR. Замените три ноды LoadImage на свои изображения.
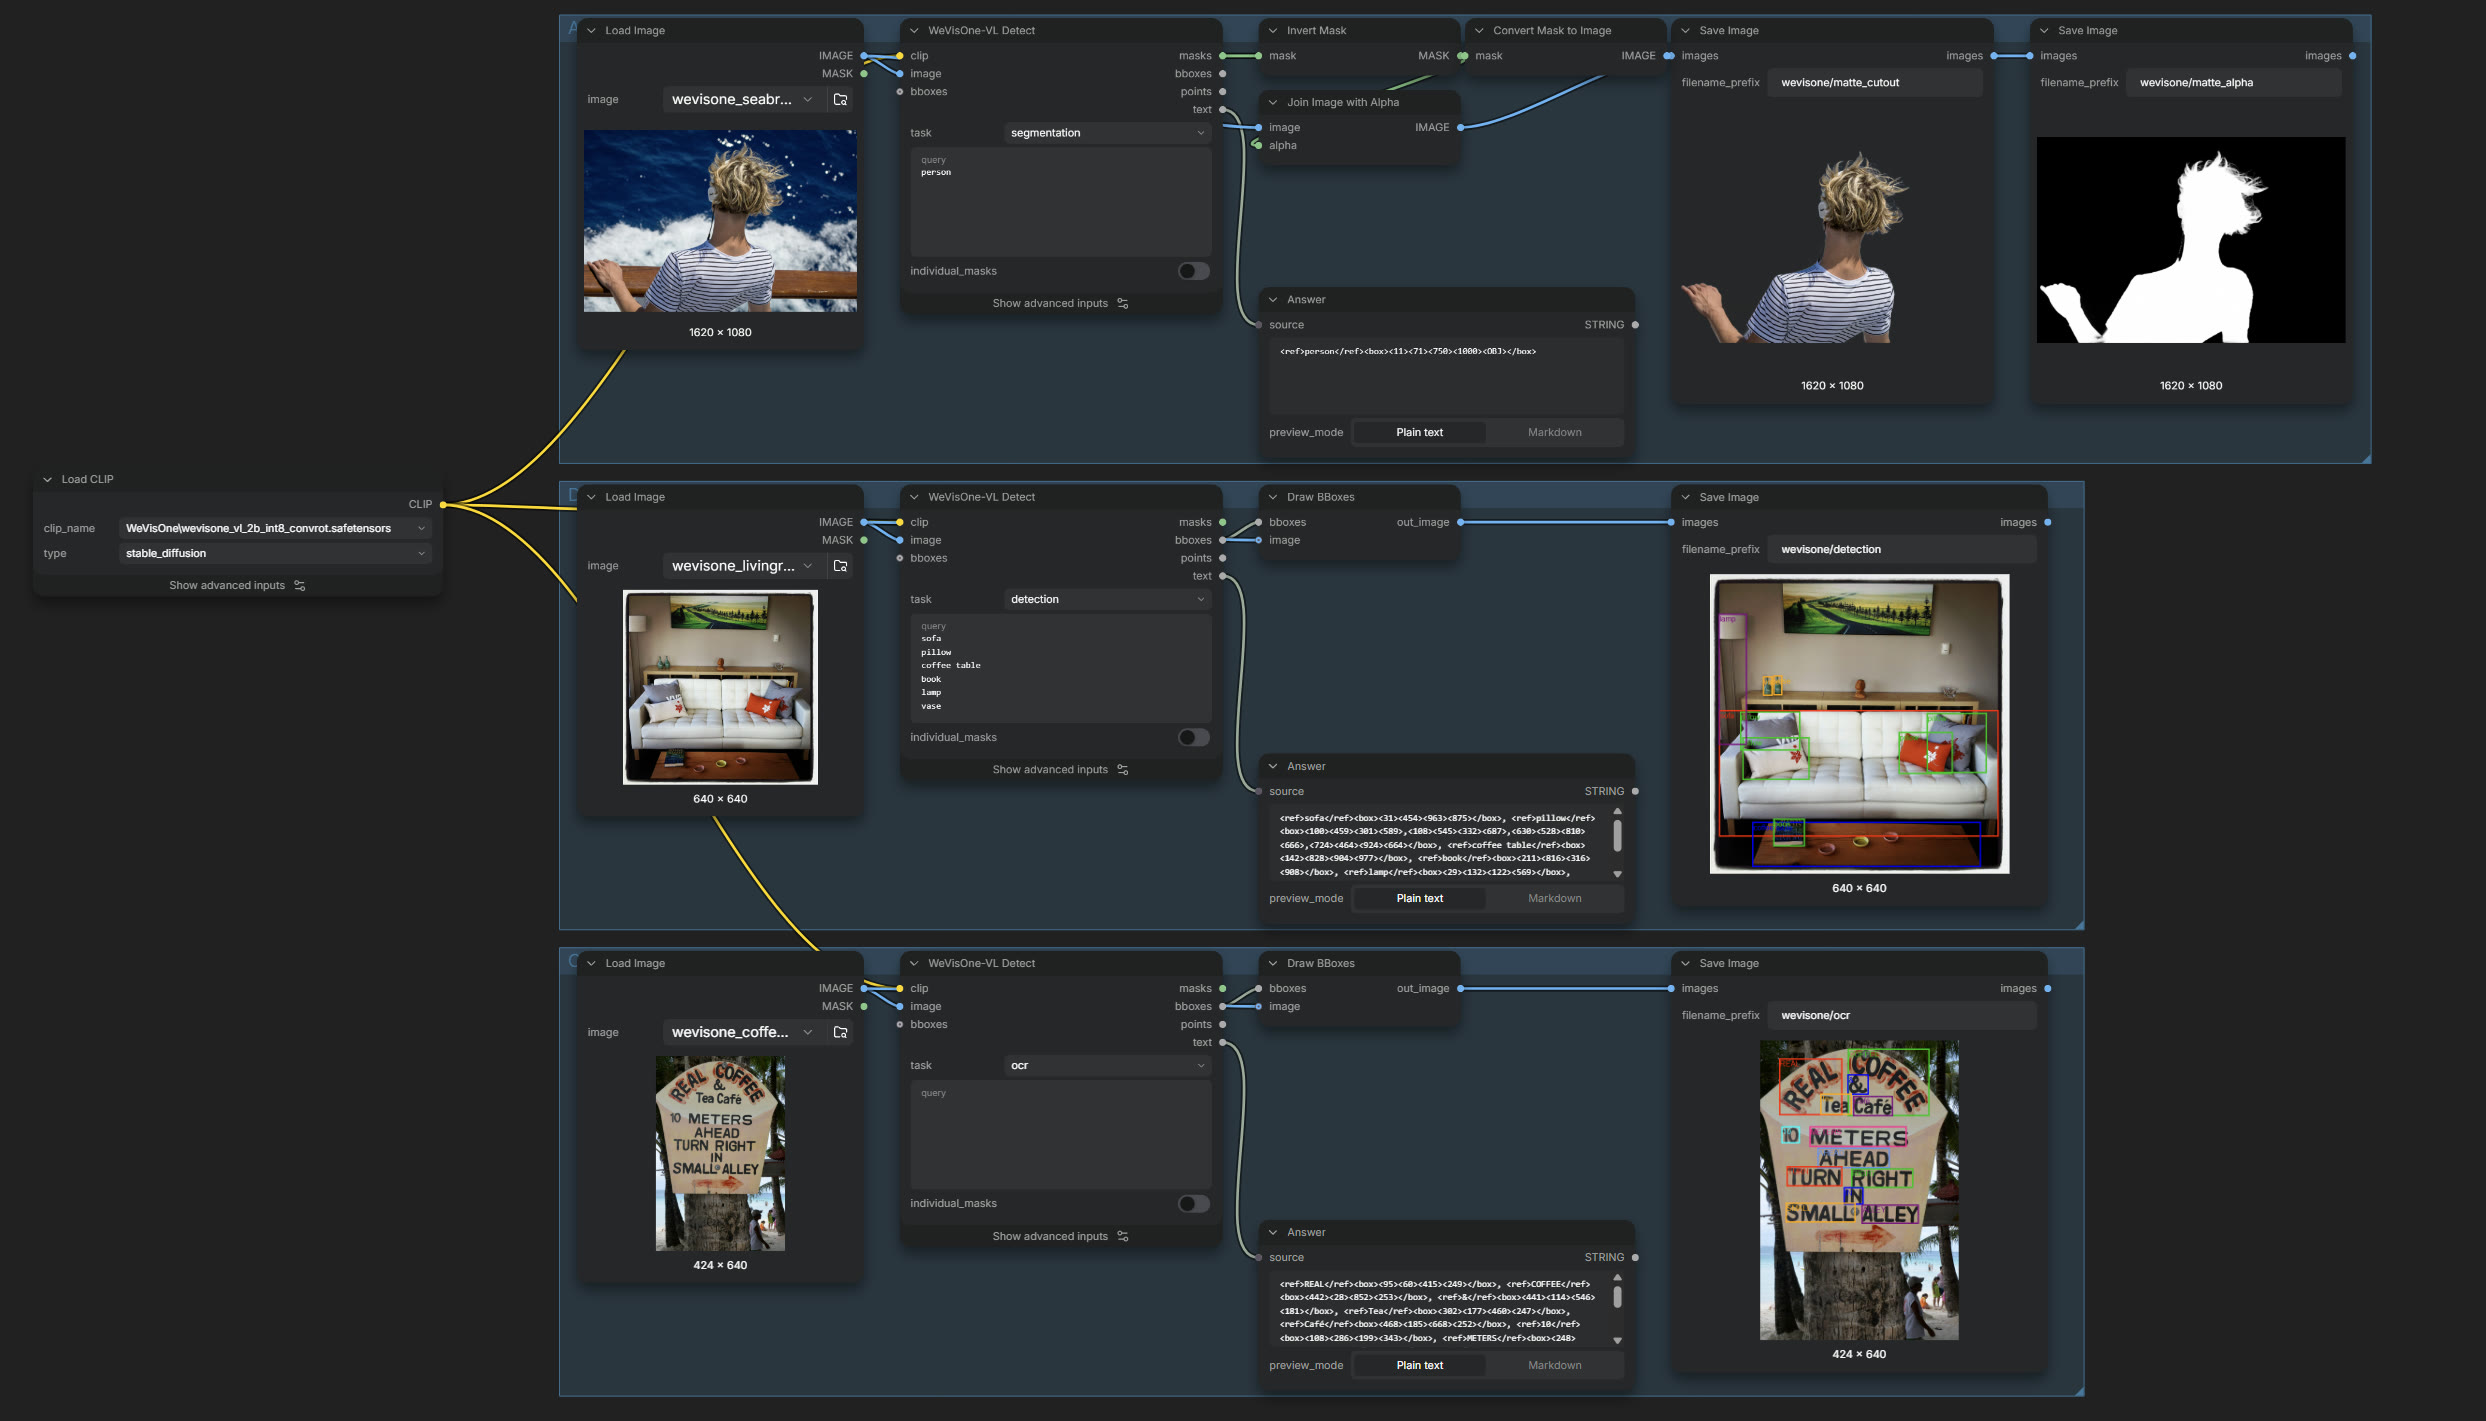
Альфа-матирование, детекция и OCR в одном графе. Источник: PR 17632
Насколько это хорошо
Ключевые цифры для модели 4B в сравнении с сильнейшим открытым бейзлайном в каждом бенчмарке:
| Задача | Бенчмарк | Бейзлайн | WeVisOne-VL-4B |
|---|---|---|---|
| Детекция | LVIS, F1 | 50,7 | 55,3 |
| Отказ от отсутствующих целей | WeRef-Bench | 73,0 | 96,4 |
| OCR | TotalText, F1 | 43,3 | 52,0 |
| Referring-сегментация | ReasonSeg, gIoU | 65,0 | 71,2 |
| Маттинг по боксу | P3M-500-NP, MAD (меньше — лучше) | 15,4 | 7,3 |
Строка про отказ важнее всего в графе: попросите то, чего нет в кадре, и модель напишет None вместо того, чтобы выдумать бокс.
Ограничения
- Только отдельные изображения. Пиксельный декодер не принимает видеосетки, так что это не нода трекинга.
- Тонкие альфа-края всё ещё «плывут» при сильном перекрытии или прозрачных объектах, а формулировка запроса меняет результат.
detectionиpointждут по одной метке на строку; список через запятую читается как одна фраза.
Оригинальные веса: tencent/WeVisOne-VL-4B и 2B. Загружается именно репак ComfyUI, указанный выше.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.