Anima RGBA даёт Anima настоящий альфа-канал в ComfyUI
Anima RGBA объединяет 4-канальный Qwen-Image VAE с LoRA для Anima, и модель рендерит прозрачные PNG без пользовательских нод: alpha MAE 0.0027 на отложенной выборке.
transparent background в промпте, и VAE Decode вернёт прямой RGB вместе с альфой, которую Save Image запишет как RGBA PNG. Без пользовательских нод.
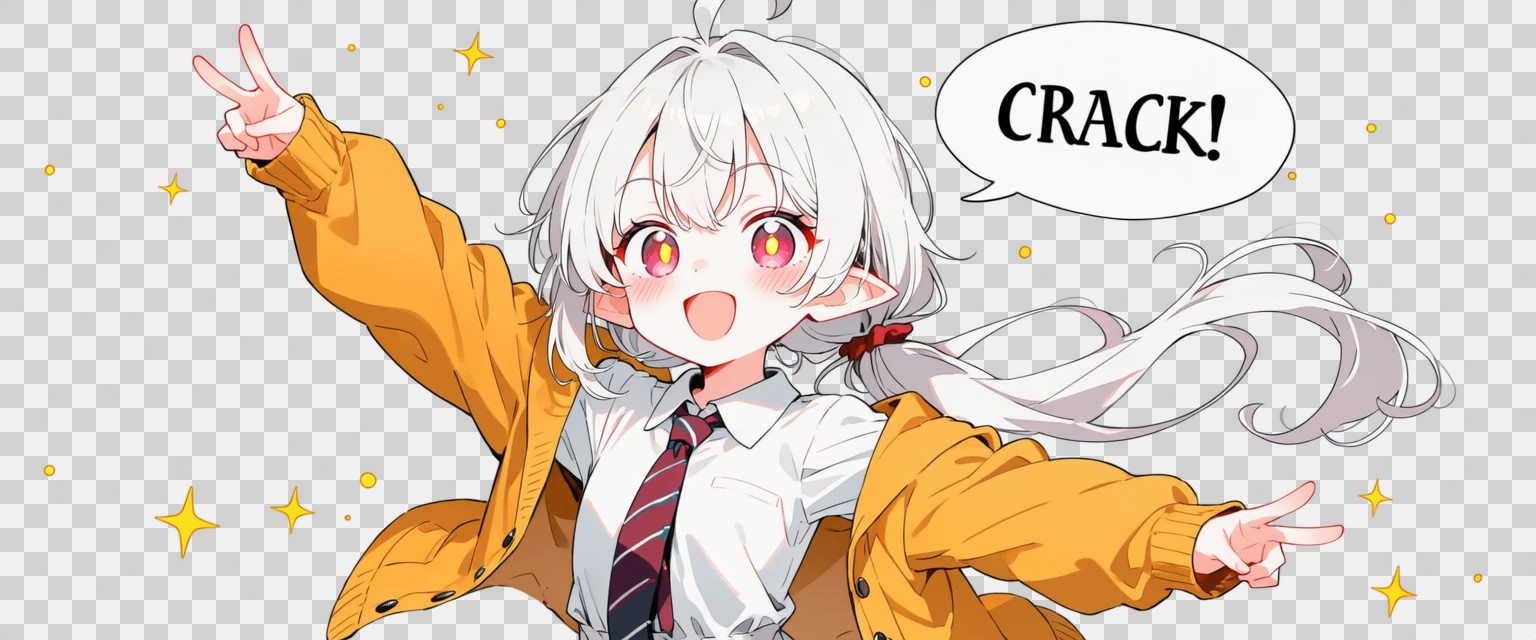
Сгенерировано с RGBA VAE и LoRA, показано поверх шахматной доски.
Anima использует Qwen-Image VAE, который декодирует в три канала. Поэтому запрос прозрачного фона приводит к тому, что субъект рисуется на фоне, который модель представляет пустым, а вырезание выполняется потом отдельным проходом матирования. RGBA VAE переносит это в декодер: последний слой просто имеет четыре канала вместо трёх.
Как превратить 3-канальный VAE в 4-канальный
Приём проще, чем кажется. VAE сохраняет свой 16-канальный латент с разрешением 1/8, поэтому латентное пространство Anima не меняется. Энкодер принимает RGB, скомпонованный поверх белого, плюс альфа-канал; декодер выдаёт прямой, без премультипликации, RGB плюс альфу.
Инициализация делает остальное: 3-канальные веса копируются, новый входной столбец альфы начинается с нуля, а новый выходной ряд альфы начинается с нуля со смещением +1, поэтому до любого обучения модель воспроизводит оригинальный VAE и декодирует всё как непрозрачное. Затем обучение подтягивает новый энкодер к латентам замороженного оригинала для той же белой композиции, что сохраняет латентное пространство там, где Anima уже работает, и оставляет LoRA лишь небольшой альфа-остаток для изучения.
Композиционирование поверх белого выбрано намеренно: RGB не определён там, где альфа равна нулю, а белую композицию Anima и так рисует для промптов с прозрачным фоном, поэтому RGBA-латенты остаются близки к тем, что выдаёт базовая модель. Измеренный дрейф составляет RMS-расстояние 0.058 в единицах стандартного отклонения латента, около 6% от одной сигмы, и именно этот разрыв закрывает LoRA.
Как выглядят цифры
VAE обучался 12 000 шагов с пакетом 4 на кропах 512 px, с L1-лоссом композиции по случайным сплошным фонам, LPIPS с весом 0.2, L1 по альфе, членом градиента Собеля по альфе и MSE латента относительно оригинального энкодера; 15% каждого пакета составляли непрозрачные изображения для регуляризации. На отложенном наборе из 200 прозрачных и 50 непрозрачных изображений 512 px, ни одно из которых не участвовало в обучении:
| Метрика | Значение |
|---|---|
| Альфа MAE | 0.0027 (около 0.7 / 255) |
| Альфа RMSE | 0.0157 (около 4 / 255, сосредоточено на рёбрах) |
| PSNR при композиции поверх белого | 34.94 dB |
| PSNR при композиции поверх чёрного | 33.17 dB |
| PSNR непрозрачных, оригинальный Qwen-Image VAE | 34.26 dB |
| PSNR непрозрачных, Anima RGBA VAE | 34.74 dB |
Реконструкция непрозрачных изображений немного лучше, чем у оригинала, а не хуже, и это полезный результат: замена VAE ничего не стоит на обычных изображениях.
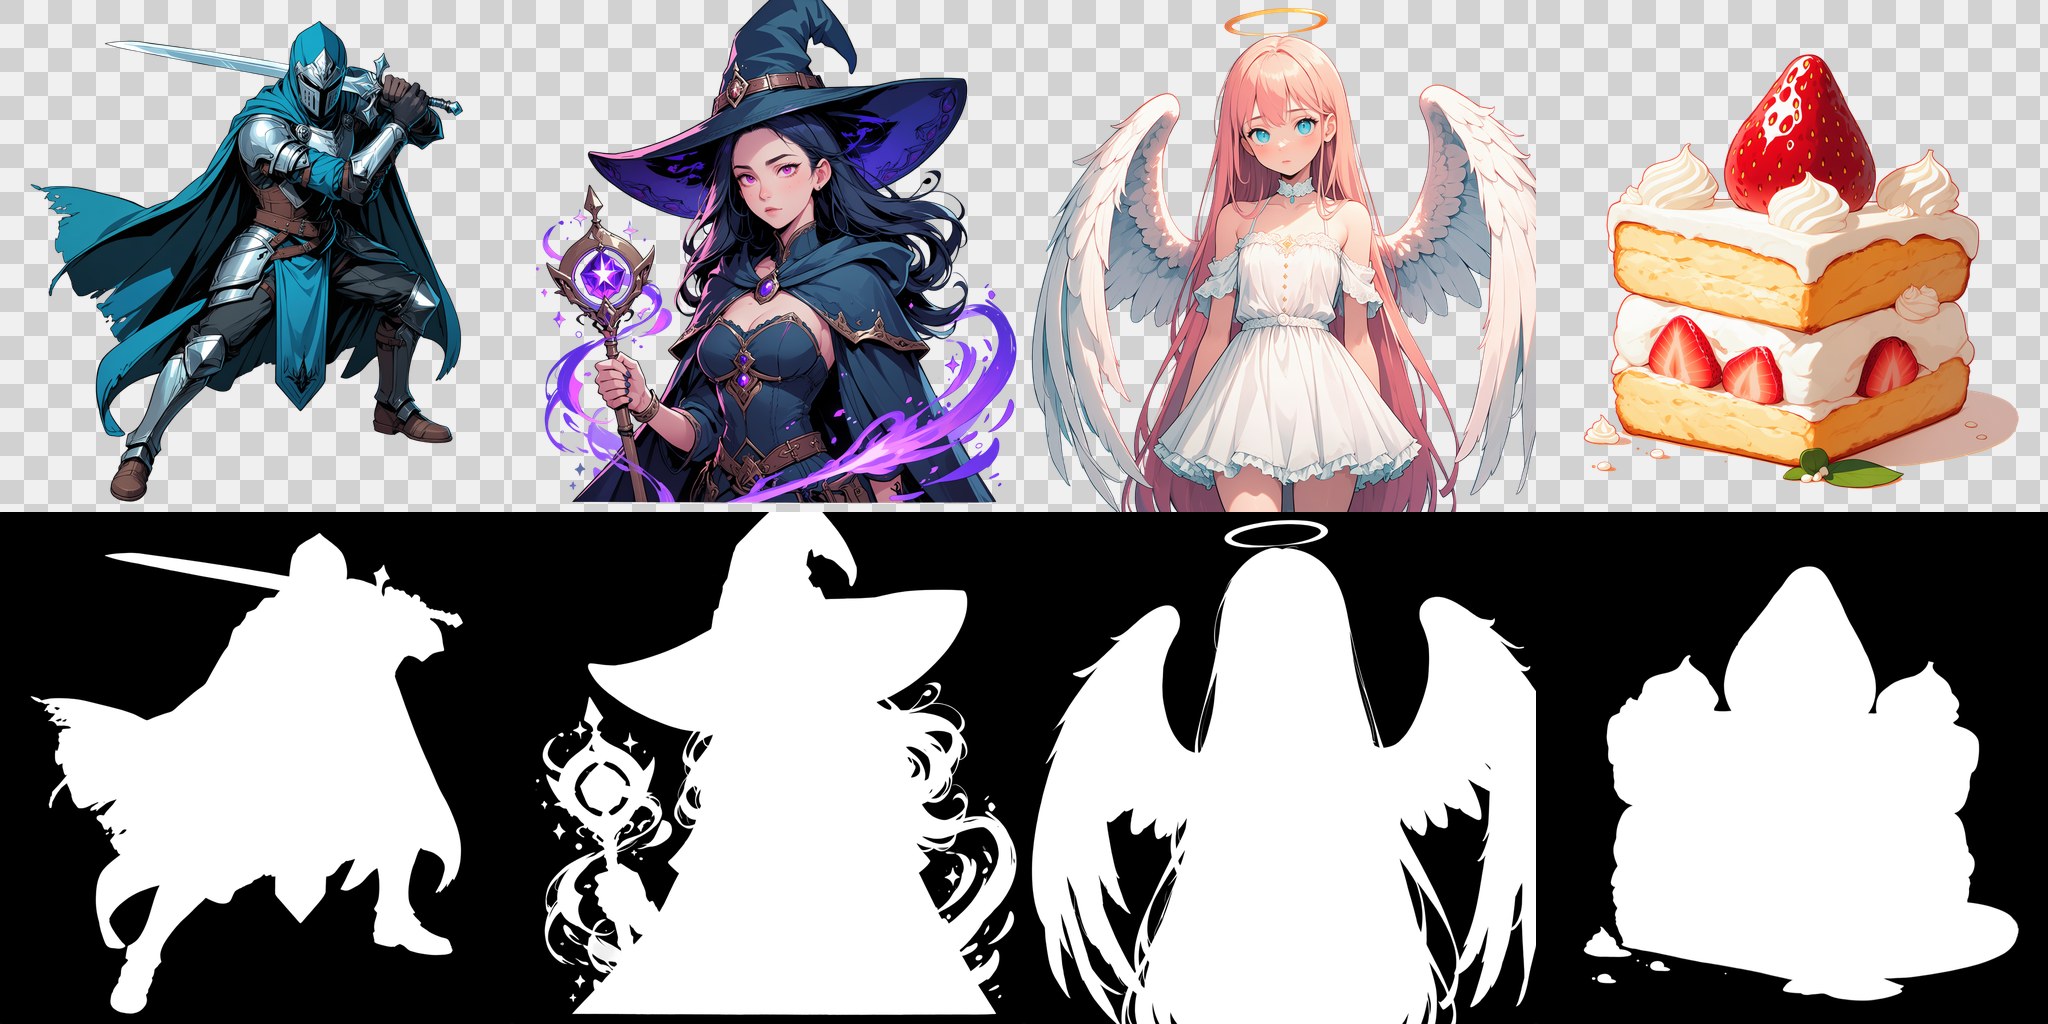
Верхний ряд: выход RGBA поверх шахматной доски. Нижний ряд: альфа-канал отдельно.
Зачем всё ещё нужна LoRA
Без неё VAE всё равно выдаёт альфа-канал, но размытый: персонажи и белая одежда получаются частично прозрачными, потому что латенты базовой модели лишь приблизительно соответствуют тому, что ожидает новый декодер. LoRA обучена на латентах из этого VAE при ранге 32, 25 000 шагов, на 18 426 изображениях, с замороженными текстовым энкодером Qwen3 и LLM-адаптером. Прозрачные изображения подписаны двумя чередующимися триггерными строками, transparent background и isolated on a transparent background, а непрозрачные изображения для регуляризации не имеют триггера.
Тестовая таблица из карточки модели, 8 промптов на 2 сида при 1024 x 1024, показывает, что происходит при изменении настроек:
| Сила LoRA | Вес триггера | Прозрачные | Полупрозрачные пиксели |
|---|---|---|---|
| нет | 1.0 | 16 / 16 | 12.8% |
| 1.0 | 1.0 | 16 / 16 | 0.9% |
| 1.2 | 1.0 | 16 / 16 | 1.0% |
| 1.5 | 1.0 | 16 / 16 | 1.4% |
| 1.0 | 1.2 | 16 / 16 | 0.9% |
| 1.0 | 1.5 | 16 / 16 | 0.9% |
Каждая настройка даёт прозрачный результат, поэтому важна доля лишних полупрозрачных пикселей: 12.8% без LoRA против 0.9% при значениях по умолчанию. Повышение LoRA до 1.5 не помогает и добавляет полупрозрачный мусор и дым вокруг субъекта; повышение веса триггера, наоборот, почти не меняет изображение и альфу. Это противоположно обычному инстинкту, и карточка прямо это говорит: повышайте вес триггера, а не силу LoRA.
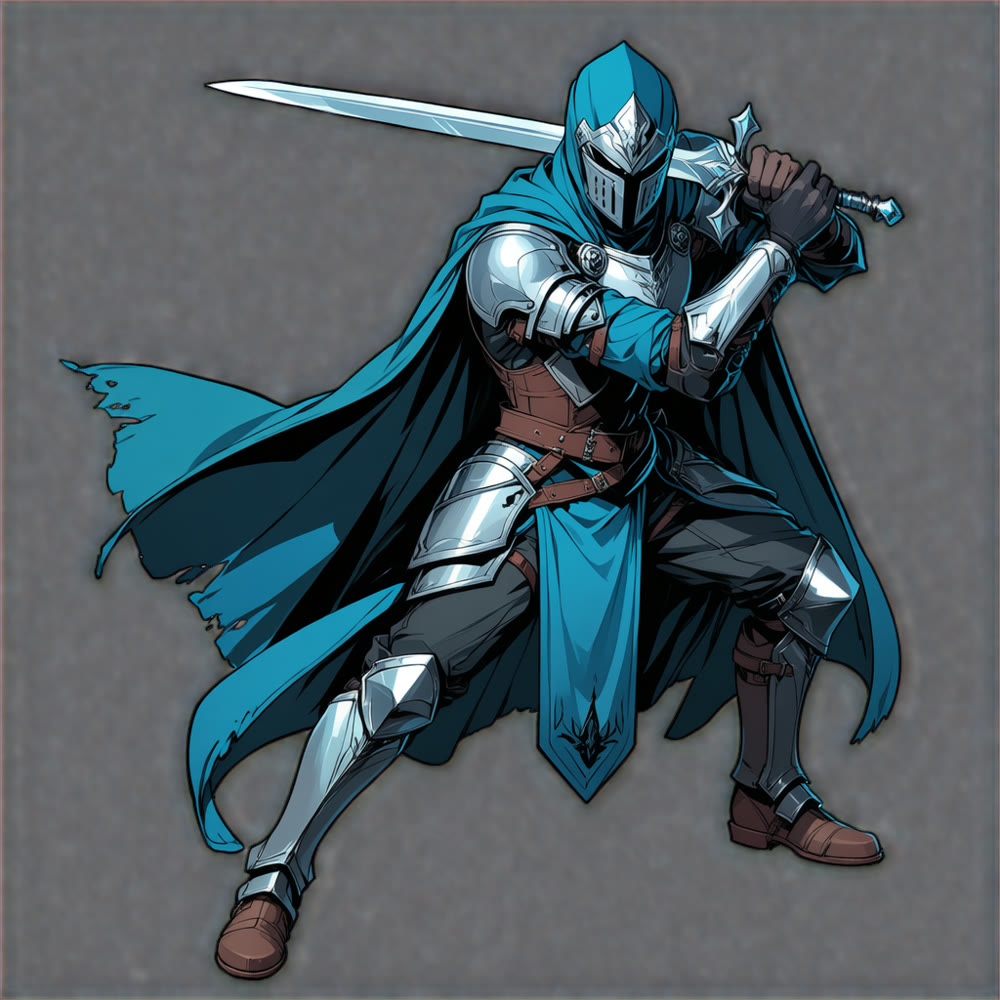
Персонаж в полный рост при LoRA 1.0, 30 шагах, CFG 4.5, er_sde с simple.
Где он слаб
VAE обучался на кропах 512 px и декодирует при более высоких разрешениях, но мелкие полупрозрачные детали, такие как пряди волос, стекло и дым, остаются самым слабым местом. Сгенерированная альфа в основном бинарная, поэтому просвечивающая одежда обычно получается непрозрачной. Крупные планы, заполняющие кадр, иногда сохраняют непрозрачный белый фон, чаще при добавлении других LoRA. VAE создан для аниме и иллюстраций, то есть для того, что рисует Anima.
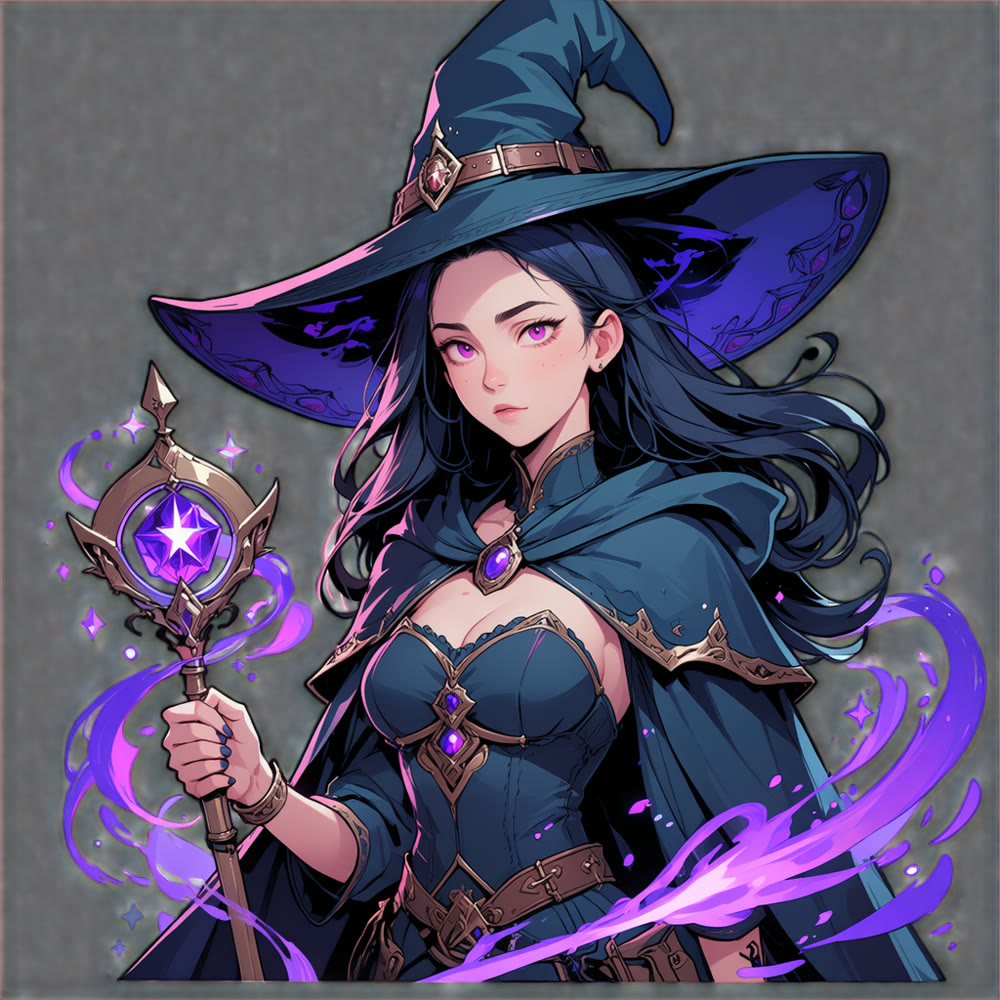
Тот же рецепт на другом субъекте: альфа сохраняется сквозь шляпу и посох.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.