Krea 2 Turbo за 3 шага: LoRA-дистилляция с лучшей детализацией
LoRA ранга 64 сокращает Krea 2 Turbo с 8 шагов до 3 при cfg 1.0: мелкая текстура в 1.11 раза выше, чем у учителя, плюс рабочий процесс ComfyUI только на штатных нодах.
Тот же автор, который перевёл Krea 2 Turbo с 8 шагов на 4, а затем на 2, закрыл промежуток между ними: этот адаптер запускает модель за 3 шага, примерно в 2.6 раза быстрее денойзинг (с 65.4 с до 24.9 с при 1024x1024, float16, без учёта кодирования текста и декодирования VAE), при этом мелкая текстура в 1.11 раза выше, чем у 8-шагового учителя, на 22 тестовых промптах автора, против 1.04x у 4-шагового адаптера. Штатный Turbo на 3 шагах даёт 0.58x, и именно этот разрыв закрывает LoRA.
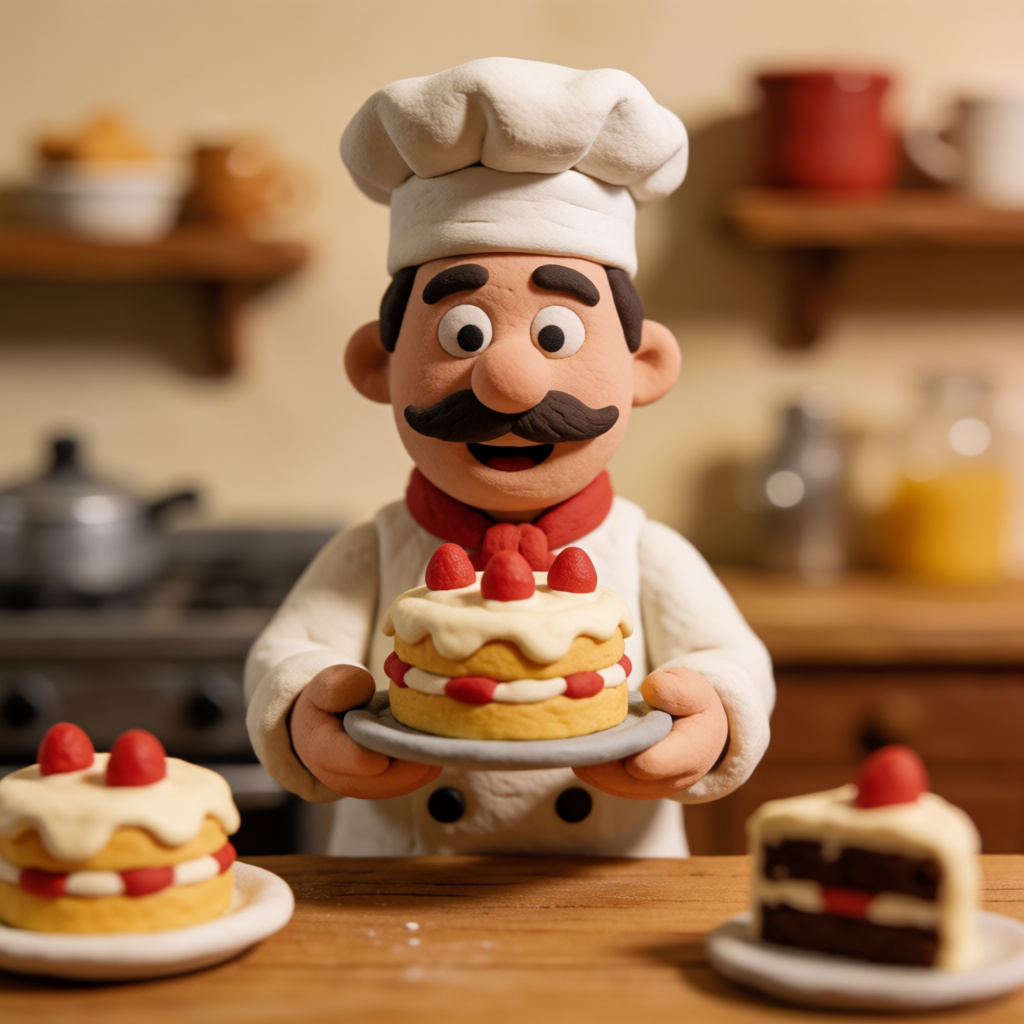 | 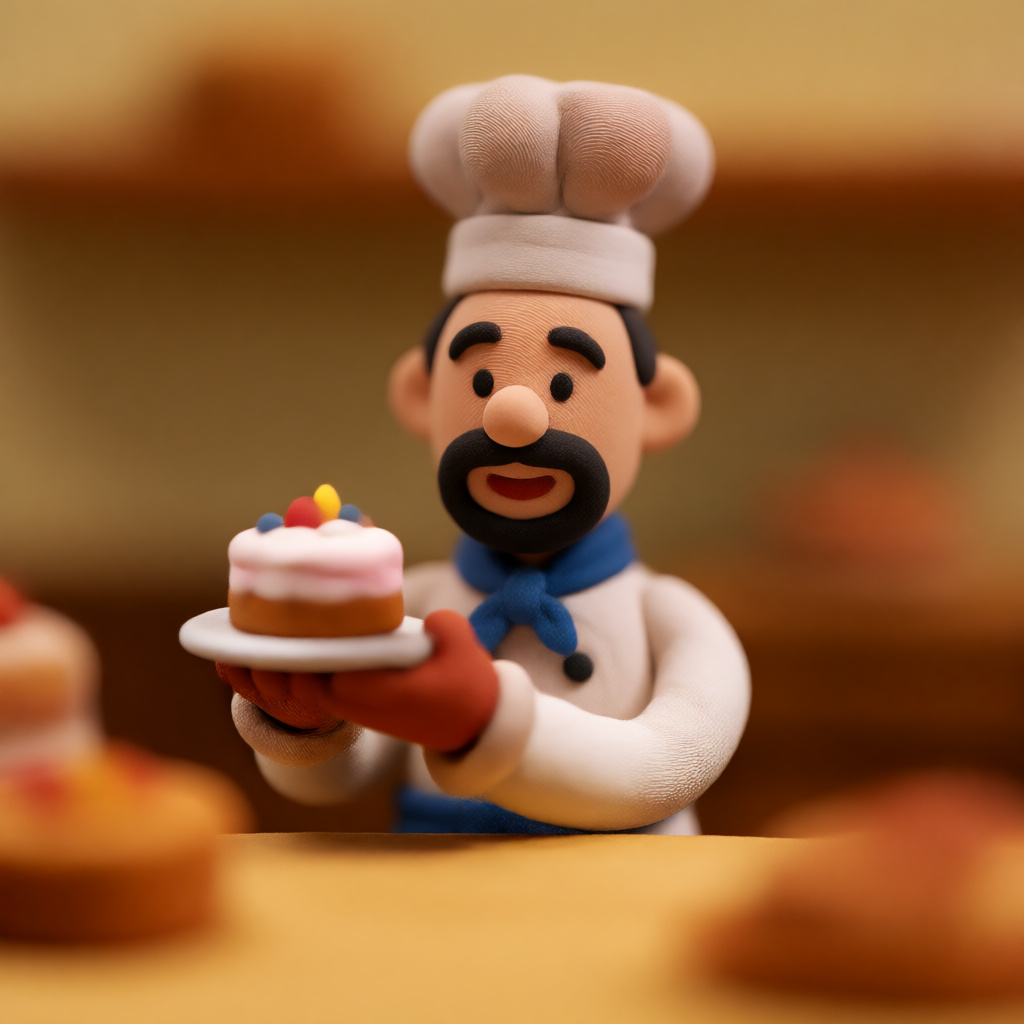 | 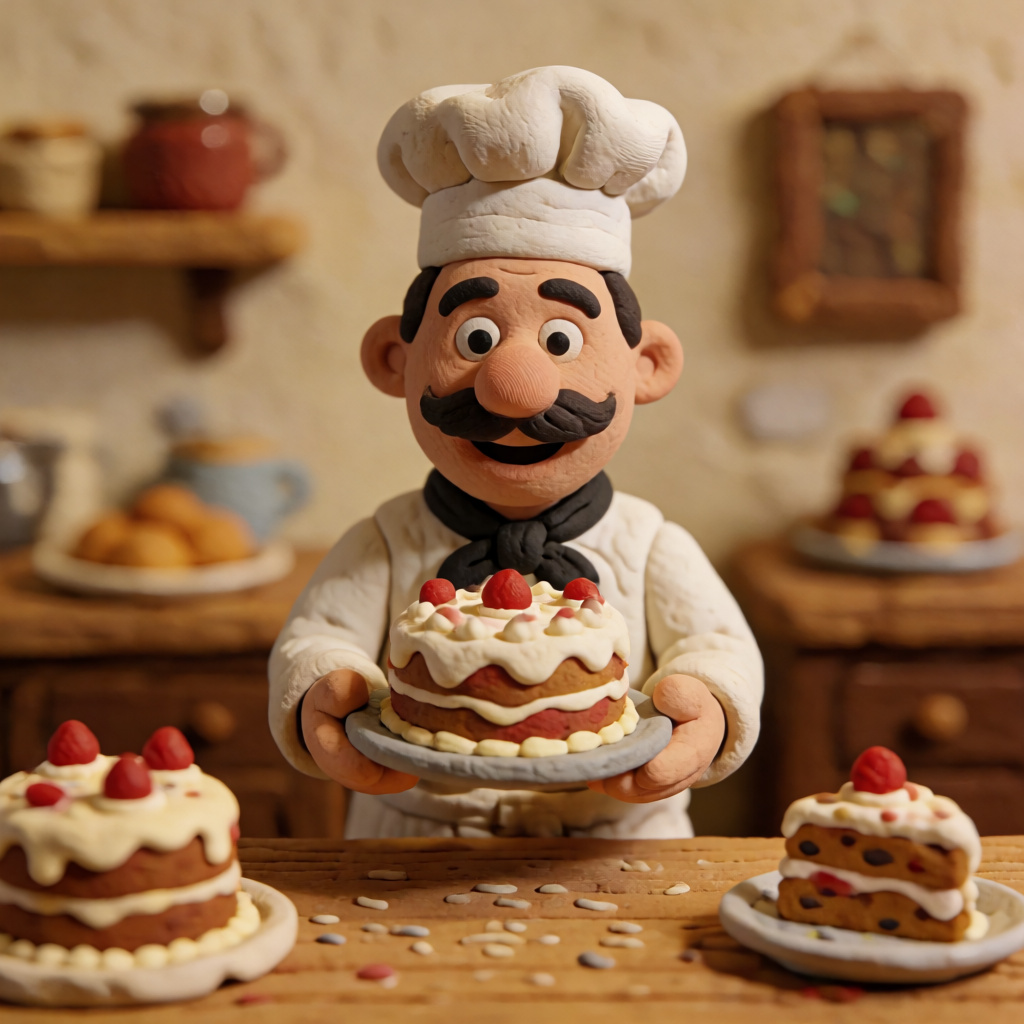 |
|---|---|---|
| Turbo, 8 шагов: эталон качества | Turbo на 3 шагах без LoRA: мягко и плоско | 3 шага с LoRA: детализация восстановлена |
Проект всё ещё обучается: сейчас выложен чекпойнт chk00030000, снятый с устоявшихся весов, где последние 600 сэмплов снижают скорость обучения до нуля, и автор ожидает дальнейших чекпойнтов. Два файла весов в репозитории содержат один и тот же чекпойнт под именами ключей diffusers и ComfyUI.
Три шага на собственном расписании Turbo
Студент делает три вызова по собственным 3-шаговым сигмам Turbo, [1.0, 0.8633, 0.6123], с каноническим mu модели 1.15 и без guidance. Обучение началось с весов выпущенной 4-шаговой адаптерной LoRA с сохранением её формы: ранг 64 на тех же 228 модулях. Около 30 000 сэмплов было взято из записанных траекторий учителя на 11 разрешениях, от 512x768 до 1440x1440 и 1824x1024.
Два момента отличаются от предыдущих адаптеров. Базовая модель работала в bf16 на одной H100/H200 (проекты для 4 и 2 шагов обучались на одной RTX 3090 против weight-only int8 базы), около 91 часа на 30 000 сэмплов. И цель по-прежнему в согласовании распределений, а не в имитации траектории: работу студента оценивают восемь критиков, опирающихся на собственные признаки середины сети замороженной базовой модели, покрывающие артефакты, правдоподобие реальной фотографии, компоновку первого вызова, содержимое, соответствие промпту, надписи, крупные лица и весь трёхшаговый роллаут. Совпадение с тем, что учитель правдоподобно выдал бы, вместо его точного пути, и не даёт трём шагам усредниться в размытие и удвоенные края.
Измеренные полосы это подтверждают: мелкая текстура 1.11x относительно учителя, полосы 16 и 8 пикселей на 1.10x и 1.12x, а цвет на уровне учителя.
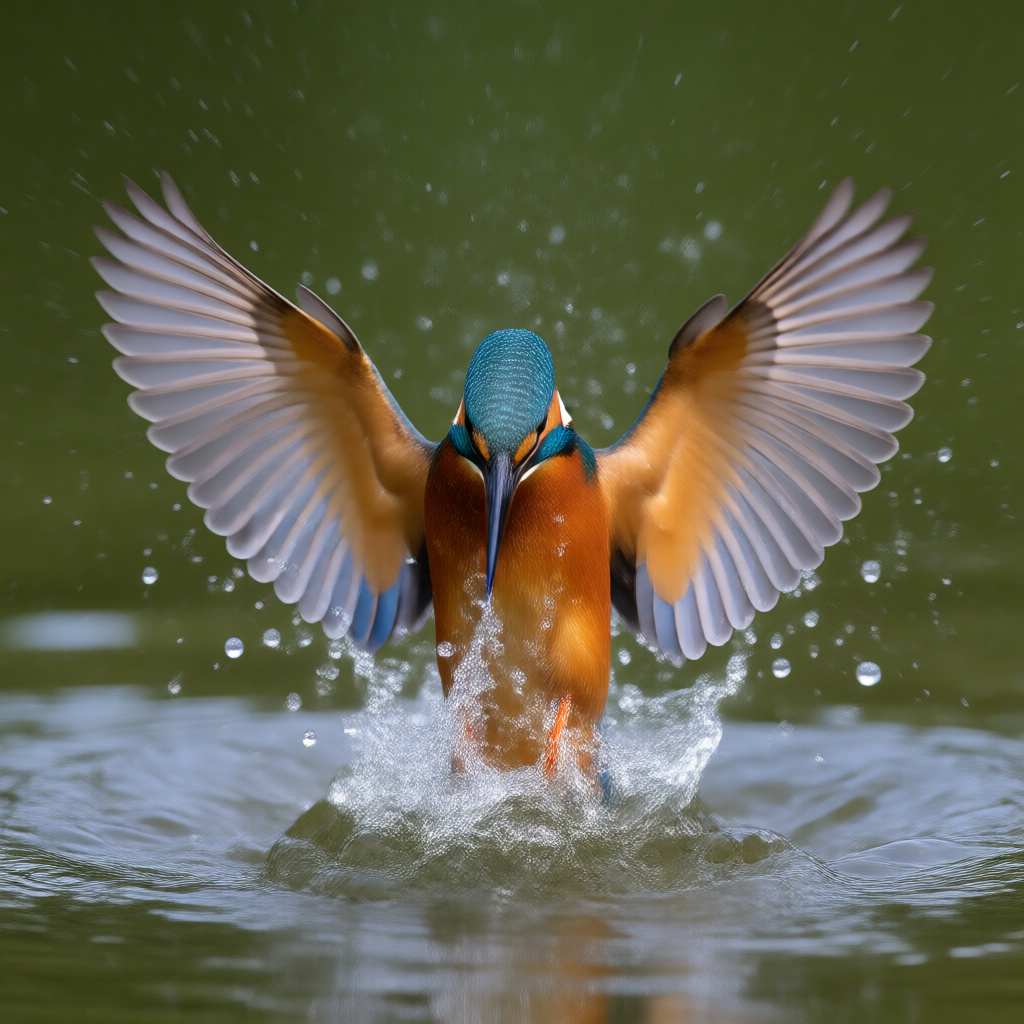
Turbo на 3 шагах с промптом kingfisher, без адаптера. Версия с LoRA для того же сида и промпта: на обложке.
Чем приходится платить
Автор публикует издержки вместе с выигрышем, и их стоит прочитать перед заменой:
- Дальше от картинки учителя, чем 4-шаговый адаптер: расстояние 0.401 против 0.320, согласованность деталей 0.26 против 0.39. Три шага это более короткий путь из того же шума, поэтому кадрирование, поза или мелкий элемент могут отличаться от 8-шагового рендера при том же сиде. Изображение учителя это эталон качества, а не цель для воспроизведения.
- Текстура сильнее, чем у учителя: зерно в плоских областях измеряется в 1.57x от учителя, больше 1.29x в прошлом релизе. Бумага для акварели, поры кожи и плёночное зерно выглядят заметнее; сила ниже 1.0 смягчает это.
- Слабые удвоенные края на волосах, струях дождя и тонких конечностях, чаще всего на 768x1024 и 1024x768: индекс призрачности 1.14x от учителя, тогда как 4-шаговый адаптер держится на 1.02x.
- Мелкие лица в толпе остаются слабым местом любого малошагового адаптера.
Полезное окно силы LoRA узкое, около 1.0, поскольку на трёх шагах адаптер делает всю работу по превращению грубых вызовов в готовое изображение. Когда близость к собственному рендеру учителя важнее скорости, 4-шаговый адаптер лучше подходит.
Использование в ComfyUI
Репозиторий содержит krea2_turbo_3step_rank_64_lora_comfyui.safetensors под именами ключей ComfyUI и krea2_turbo_3step_lora_t2i.json: рабочий процесс, собранный только из штатных нод.
| файл | куда положить |
|---|---|
krea2_turbo_3step_rank_64_lora_comfyui.safetensors | ComfyUI/models/loras/ |
krea2_turbo_bf16.safetensors (из Comfy-Org/Krea-2) | ComfyUI/models/diffusion_models/ |
qwen3vl_4b_bf16.safetensors (тот же репозиторий) | ComfyUI/models/text_encoders/ |
qwen_image_vae.safetensors (тот же репозиторий) | ComfyUI/models/vae/ |
Настройки: шаги 3, cfg 1.0, сэмплер euler / simple, сила LoRA 1.0.
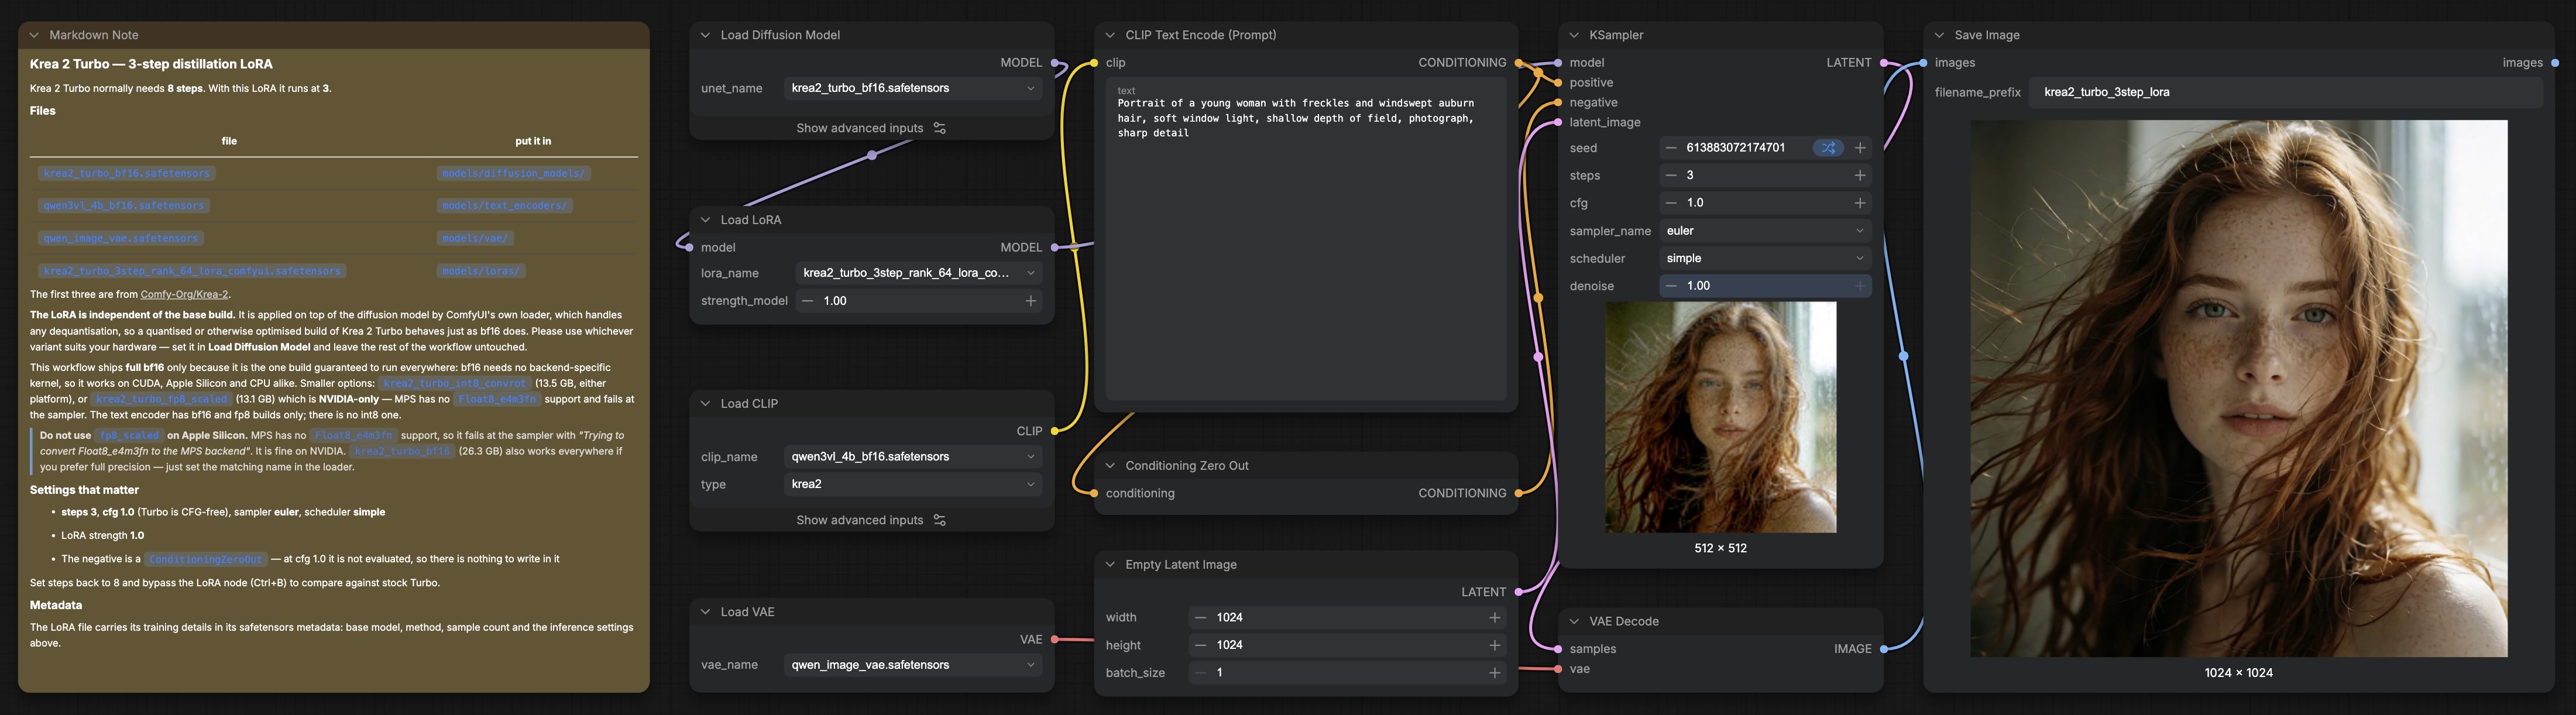
Входящий в комплект рабочий процесс: Krea 2 Turbo плюс 3-шаговая LoRA, только штатные ноды.
guidance_scale=0.0 в примере для diffusers это та же настройка, записанная способом diffusers.
Две оговорки из карточки модели. Квантованная база меняет детализацию на память: на 4-битном (nvfp4) Turbo в Comfy Cloud мелкая текстура адаптера оказалась примерно на пятую часть ниже, чем при полном рендере в bf16. А на Apple Silicon сборки fp8_scaled не загрузятся, потому что в MPS нет Float8_e4m3fn; в репозитории есть отдельный MLX рабочий процесс, который запускает ту же LoRA через ноду LVNodes Krea 2 MLX от автора.
Бонусом она также загружается на Krea 2 Raw, у которой та же архитектура: на Raw при 13 шагах с CFG 3.5 она сохраняет композицию Raw и добавляет детали, которых Raw не хватает при таком числе шагов. Автор прямо говорит, что это необученная территория, а не поддерживаемый режим.
Доступность
- Hugging Face: lvladikov/Krea2-Turbo-Distill-3step-LoRA: 22 листа сравнений и полное описание обучения в
DETAILED-README.md - 4-шаговая LoRA остаётся более близкой к 8-шаговому выходу Turbo; 2-шаговая LoRA остаётся вариантом для предпросмотра
- Все измерения выше сделаны самим автором на 22 тестовых промптах; в карточке перечислены известные проблемы в порядке частоты их появления
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.