Primal VAE: сжатие 2x с латентами как у Flux
Ostris выпустил Primal VAE: два автоэнкодера примерно на 80M параметров, которые уменьшают разрешение всего в 2 раза и не используют коэффициенты масштабирования.
2x1 уменьшает изображение в 2 раза в один канал, 2x2 в два канала.
Большинство современных VAE сжимают изображение в 8 раз, а затем передают модели диффузии латент, который приходится масштабировать заново с помощью измеренного коэффициента масштабирования, коэффициента сдвига или статистик batch norm. Primal VAE идёт другим путём: VAE выполняет только 2-кратное пространственное уменьшение, а оставшиеся 4 раза обеспечивает собственный шаг patchify модели DiT. Одноканальный латент при 2x, разбитый на патчи 4 способами, становится 16 каналами при 8x, то есть той же формы, которую даёт Flux.1 VAE; вариант с двумя каналами даёт 32 канала при 8x, форму Flux.2 VAE.
| модель | латент | патч 4 | та же форма, что у |
|---|---|---|---|
2x1 | 1 кан. @ 2x | 16 кан. @ 8x | Flux.1 VAE (16 кан. @ 8x) |
2x2 | 2 кан. @ 2x | 32 кан. @ 8x | Flux.2 VAE (32 кан. @ 8x) |
Оба чекпойнта содержат около 80M параметров, а стороны изображения должны быть кратны 16.
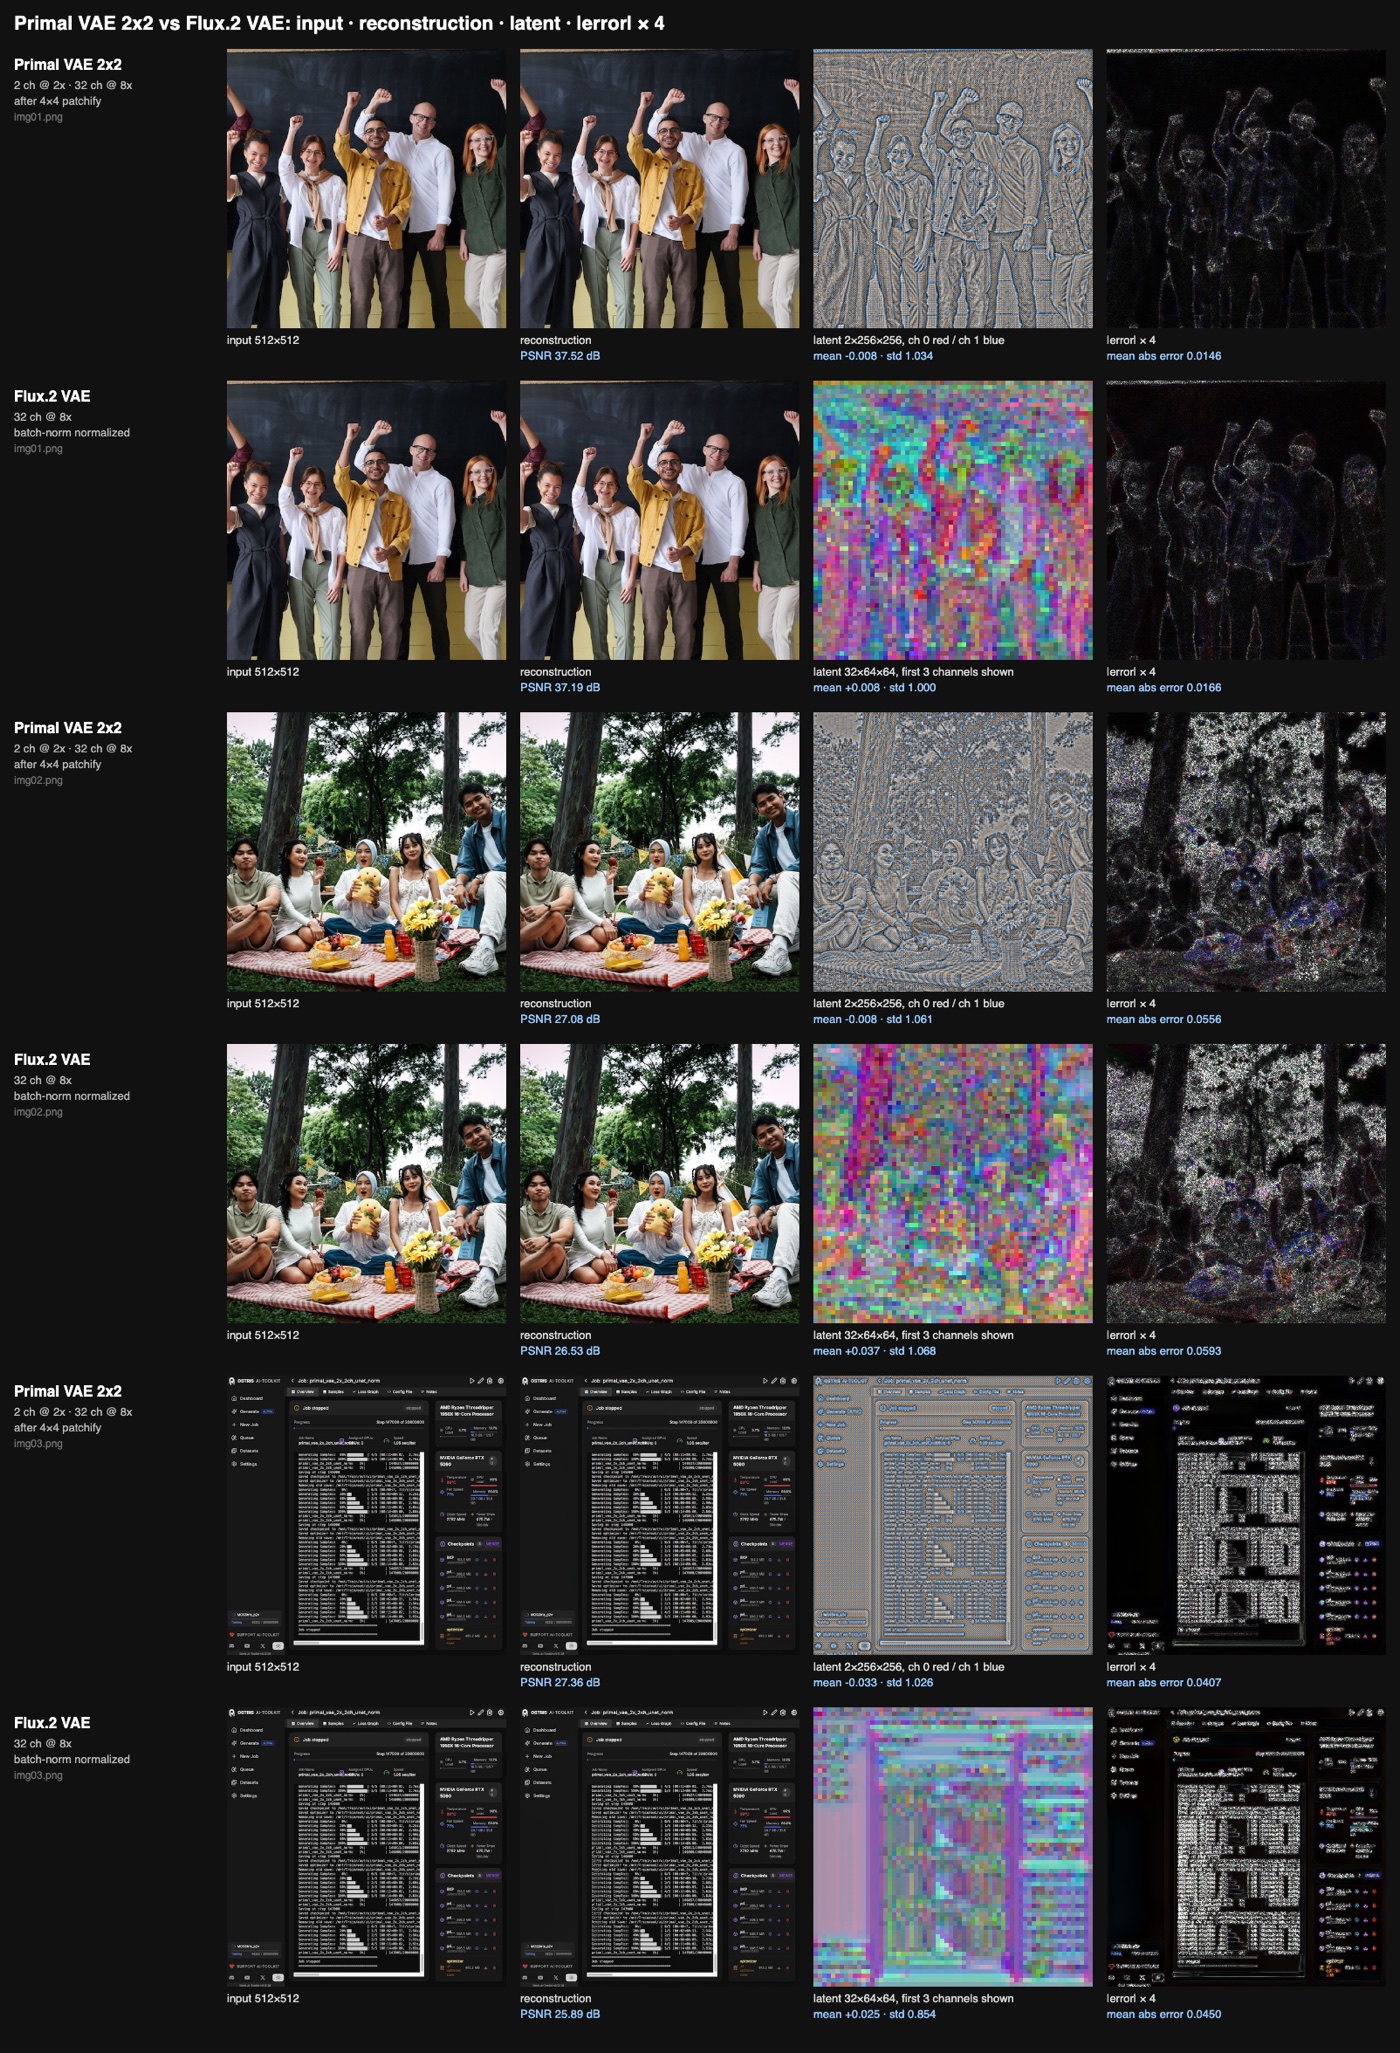
В каждой строке: вход, реконструкция, латент и |error| x 4. Под каждой строкой Primal VAE находится Flux VAE с той же раскладкой латента, на том же изображении. Латентные представления отрисованы при 3 сигма; в двухканальном латенте канал 0 показан красным, а канал 1 синим.
Качество реконструкции на трёх изображениях 512 px из репозитория, в дБ:
| изображение | Primal 2x1 | Flux.1 VAE | Primal 2x2 | Flux.2 VAE |
|---|---|---|---|---|
| img01 (люди, студия) | 32.1 | 35.7 | 37.5 | 37.2 |
| img02 (пикник, листва) | 22.0 | 24.2 | 27.1 | 26.5 |
| img03 (скриншот интерфейса) | 21.3 | 24.7 | 27.4 | 25.9 |
Автор прямо говорит, что три изображения и PSNR это не бенчмарк, и что KL VAE платит «налог» на реконструкцию за счёт шума апостериорного распределения, которого нет у детерминированного варианта. Вариант 2x2 не уступает Flux.2 VAE или превосходит его при одинаковом информационном бюджете в 32 значения на блок 8x8 пикселей. Вариант 2x1 уступает Flux.1 VAE на текстурированном содержимом: один канал при 2x это сжатие 12:1 без запаса, и он получил заметно меньше половины шагов обучения, что и прогон 2x2 (62k против 147k).
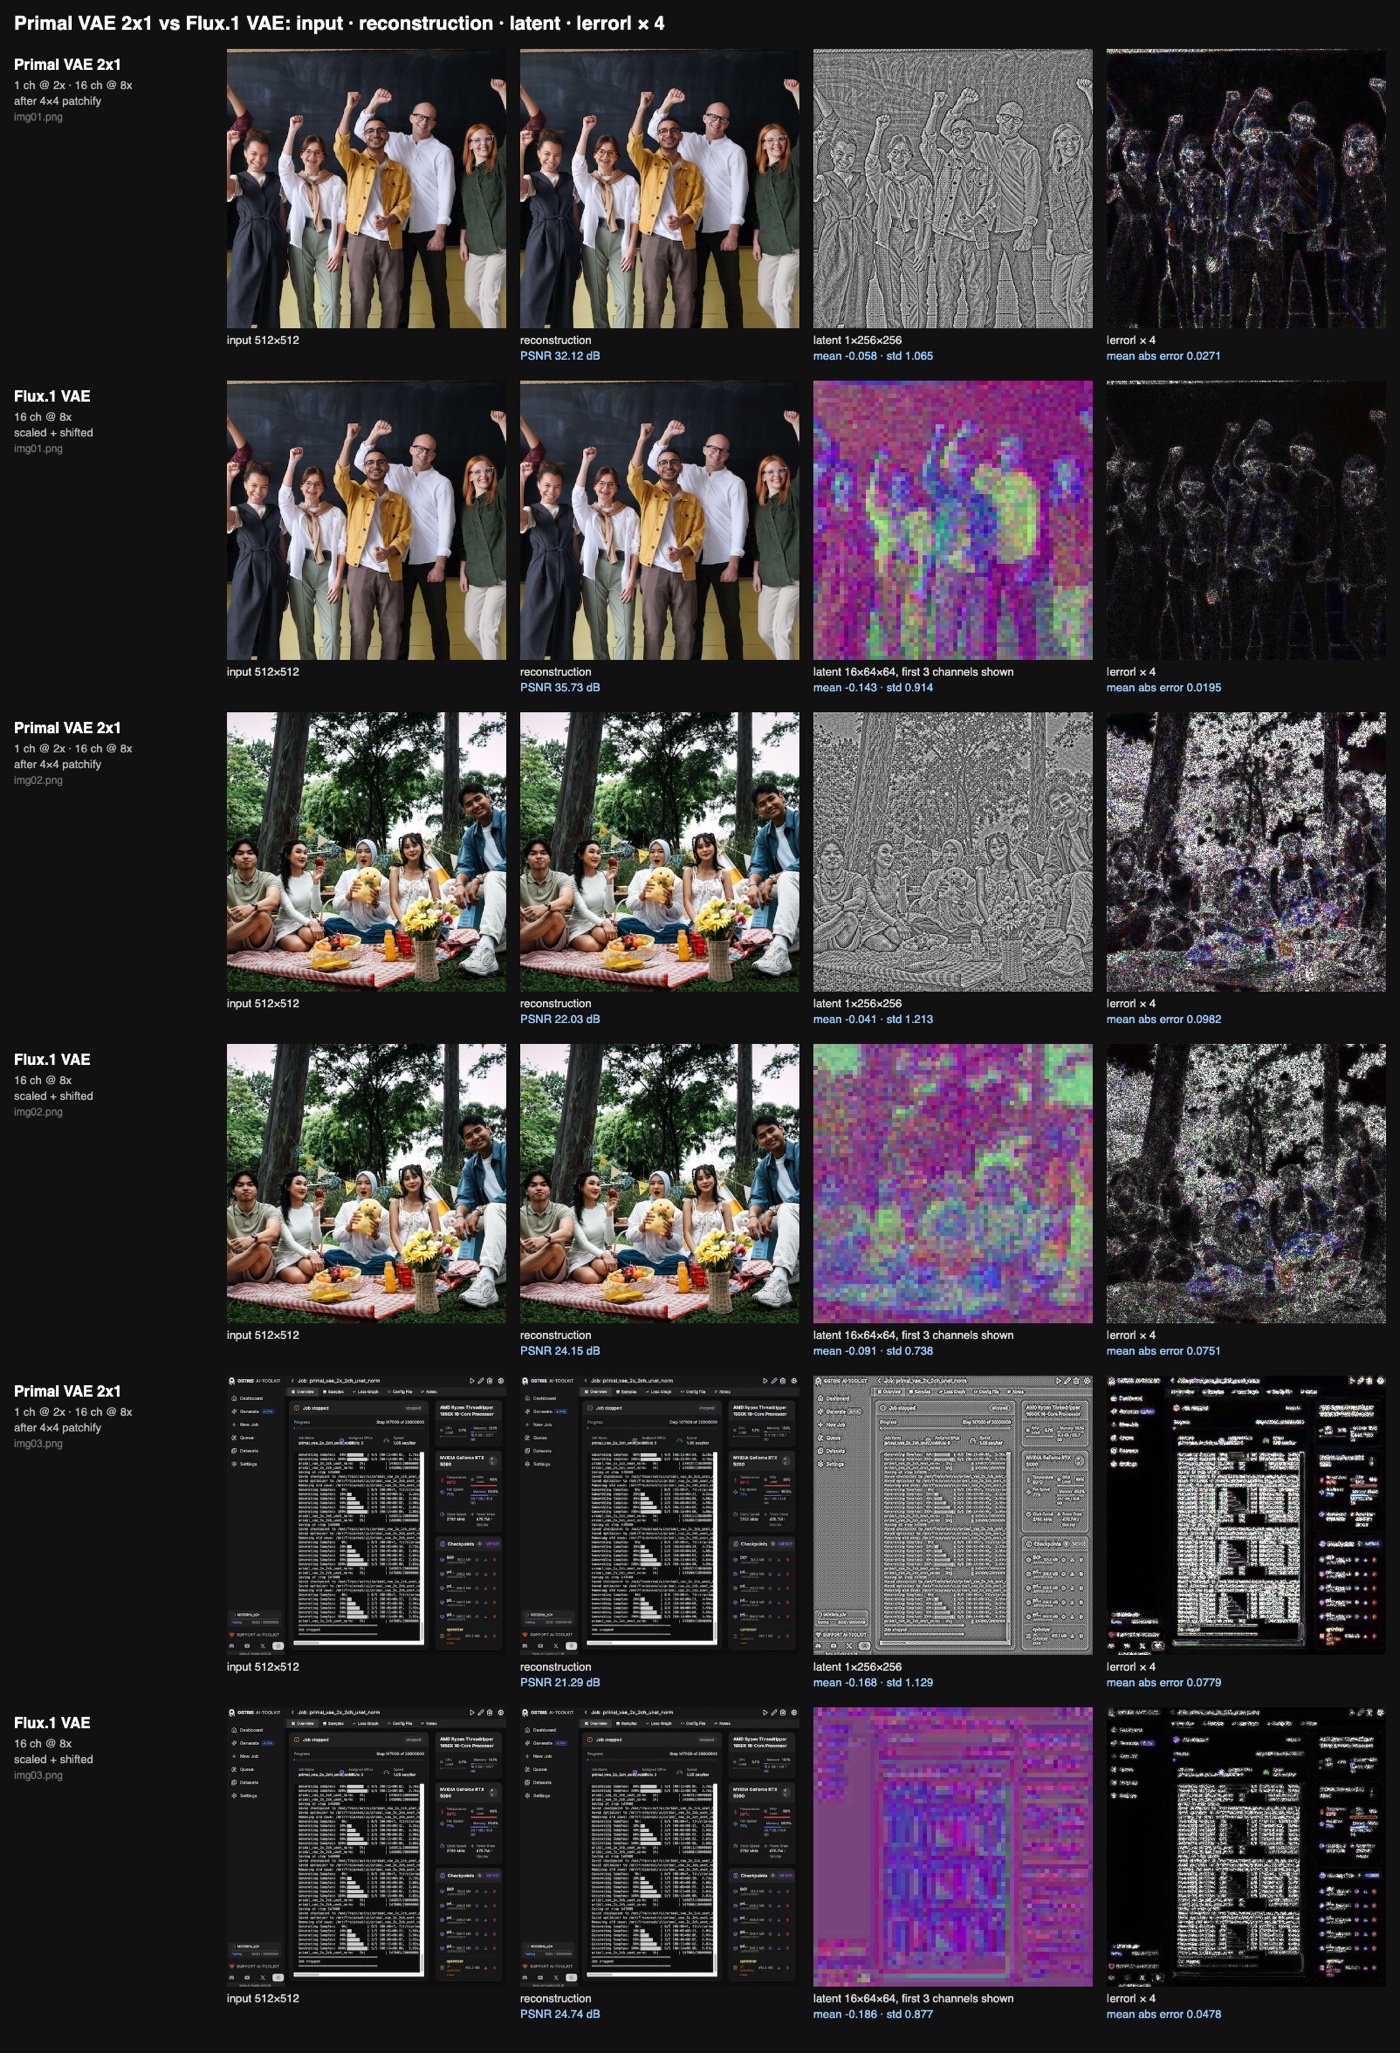
Сравнение одноканального варианта. Одноканальный латент показан в оттенках серого, и его стандартное отклонение по изображению всё ещё дрейфует, от 1.07 до 1.21, потому что нормализацию по изображению он получал только последние 9k шагов.
Архитектура
Оба варианта это одна и та же сеть, они различаются только числом выходных каналов:
- Вход проходит через
pixel_unshuffle(2), поэтому RGB превращается в 12 каналов при половинном разрешении. Всё выполняется при латентном разрешении или ниже, что сохраняет латент пространственно честной картой изображения. - Энкодер и декодер это зеркальные свёрточные U-Net с четырьмя уровнями при 1/2, 1/4, 1/8 и 1/16 размера изображения, ширинами 96 / 192 / 384 / 384 и остаточными блоками с дилатациями, циклично меняющимися 1, 2, 4.
- Нормализация это RMSNorm по каналам в каждой позиции. Пространственной статистики и внимания нет, поэтому тайл кодируется и декодируется так же, как полное изображение, при наличии некоторого перекрытия.
- Энкодер заканчивается обычной свёрткой 3x3 в 1 или 2 канала. Никакого апостериорного распределения, никакого KL-члена, никаких квантующих свёрток.
Согласование латента с шумом
Модель диффузии обучается против гауссова шума, поэтому латент уже должен выглядеть как гауссов шум. Вместо добавления KL-члена и последующего измерения коэффициента масштабирования статистики входят напрямую в функцию потерь на выходе энкодера:
- Loss по моментам:
mean^2 + (std - 1)^2с весом 0.1, вычисляемый по каждому изображению и каждому каналу, так что каждое изображение получается со средним 0 и стандартным отклонением 1, а не только набор данных в среднем. - Loss по порядковым статистикам гауссова распределения: значения латента каждого изображения и канала сортируются и сопоставляются с ожидаемыми порядковыми статистиками стандартного нормального распределения того же размера с использованием приближения Блома. Это закрепляет форму всего распределения, а не только первые два момента, поэтому плоское серое изображение всё равно кодируется в нечто похожее на шум, а не в константу.
Благодаря этому не нужно носить с собой коэффициент масштабирования, коэффициент сдвига и нормализацию латента, а кодирование возвращает обычный тензор вместо распределения: encode даёт [B, 1, H/2, W/2] без .latent_dist и без шага выборки.
Обучение
Реконструкция это MAE с весом 0.5 и LPIPS с весом 1.0, плюс L1-член по логарифму амплитуды 2D-спектра с весом 0.1, который подталкивает высокочастотную энергию, не требуя точной фазы. Сверх этого несколько приёмов нацелены на то, чтобы латент было легче диффузировать:
- Отражения и повороты латента, взятые из EQ-VAE: на 50% шагов латент отражается или поворачивается на 90 градусов и декодируется против так же преобразованного изображения, поэтому латент должен быть картиной изображения, а не произвольным кодом.
- Декодирование с шумовым возмущением: на 20% шагов декодер получает
z + sigma * noise, гдеsigmaвыбирается для каждого изображения изU(0, 0.5), и всё равно должен восстановить чистое изображение, что учит декодер терпеть ошибку диффузии. - 5% изображений заменяются случайным однородным цветом, потому что однородные области это сложный случай для латента, нормированного по изображению.
- Вариант 2x1 провёл последние 9k шагов под критиком: замороженный SigLIP2 NaFlex ViT поставляет признаки патчей со слоёв 4, 8 и 12 реального и реконструированного изображения в нативном разрешении, небольшие свёрточные головы со спектральной нормализацией обучаются с hinge loss плюс R1, а декодер получает член генератора с весом 0.1. Вариант 2x2 обучался без критика.
Опубликованные файлы весов это неизменённые обучающие чекпойнты в fp32. Загрузка их с torch_dtype=torch.bfloat16 для вывода стоит около 0.05 дБ.
Доступность
Primal VAE пока нельзя использовать внутри ComfyUI. Нет ни пользовательского узла загрузчика VAE, ни перепаковки от Comfy-Org, ни поддержки в ядре: репозиторий поставляет реализацию diffusers AutoModel с trust_remote_code=True (modeling_primal_vae.py плюс config.json), а документированный путь это AutoModel.from_pretrained("ostris/primal_vae", variant="2x1") с последующими patchify / unpatchify для получения раскладки токенов Flux.1 или Flux.2.
Обсуждение в репозитории, открытое 31 октября, напрямую спрашивает, можно ли запустить это в ComfyUI, и рабочего ответа пока нет; отдельное обсуждение в сообществе предлагает однофайловую сборку на Rust для локального вывода на GPU или CPU.
Всё остальное остаётся в Python: vae.encode(x) возвращает латент, vae.patchify(latent, compression=8) превращает его в токены формы Flux.1 или Flux.2, а vae.decode(vae.unpatchify(tokens)) возвращает обратно, причём ни с одной стороны не применяются масштабирование или сдвиг. Архитектура считывается из форм тензоров, поэтому файнтюн, экспортированный из ai-toolkit, можно загрузить с weights_name="my_finetune.safetensors".
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.