Pika H3 Flex превращает MiniMax H3 в шестишаговую LoRA для ComfyUI
Pika дообучила MiniMax H3 в Pika H3 Flex: шестишаговую модель в виде двух LoRA для ComfyUI, с тремя официальными шаблонами и управлением по 12 референсам.
Pika H3 Flex представляет собой дообученную Pika версию MiniMax H3: та же 33B omni-модель, переобученная на собственном аудио-видео корпусе, дистиллированная от 50-шагового учителя до шести шагов выборки, а затем улучшенная с помощью reward learning и оптимизации предпочтений. Pika опубликовала веса на Hugging Face, открыла исходный код пакета вывода на GitHub и вместе с постом о запуске выпустила техническое описание 29 октября 2026 года.
Для ComfyUI важно то, что Flex не является новой архитектурой. Он поставляется как два LoRA-адаптера в нативной структуре модулей MiniMax H3, поэтому загружается через штатный узел LoraLoaderModelOnly поверх базовой H3, которая у вас уже есть, вместе с тремя официальными шаблонными рабочими процессами в библиотеке шаблонов.
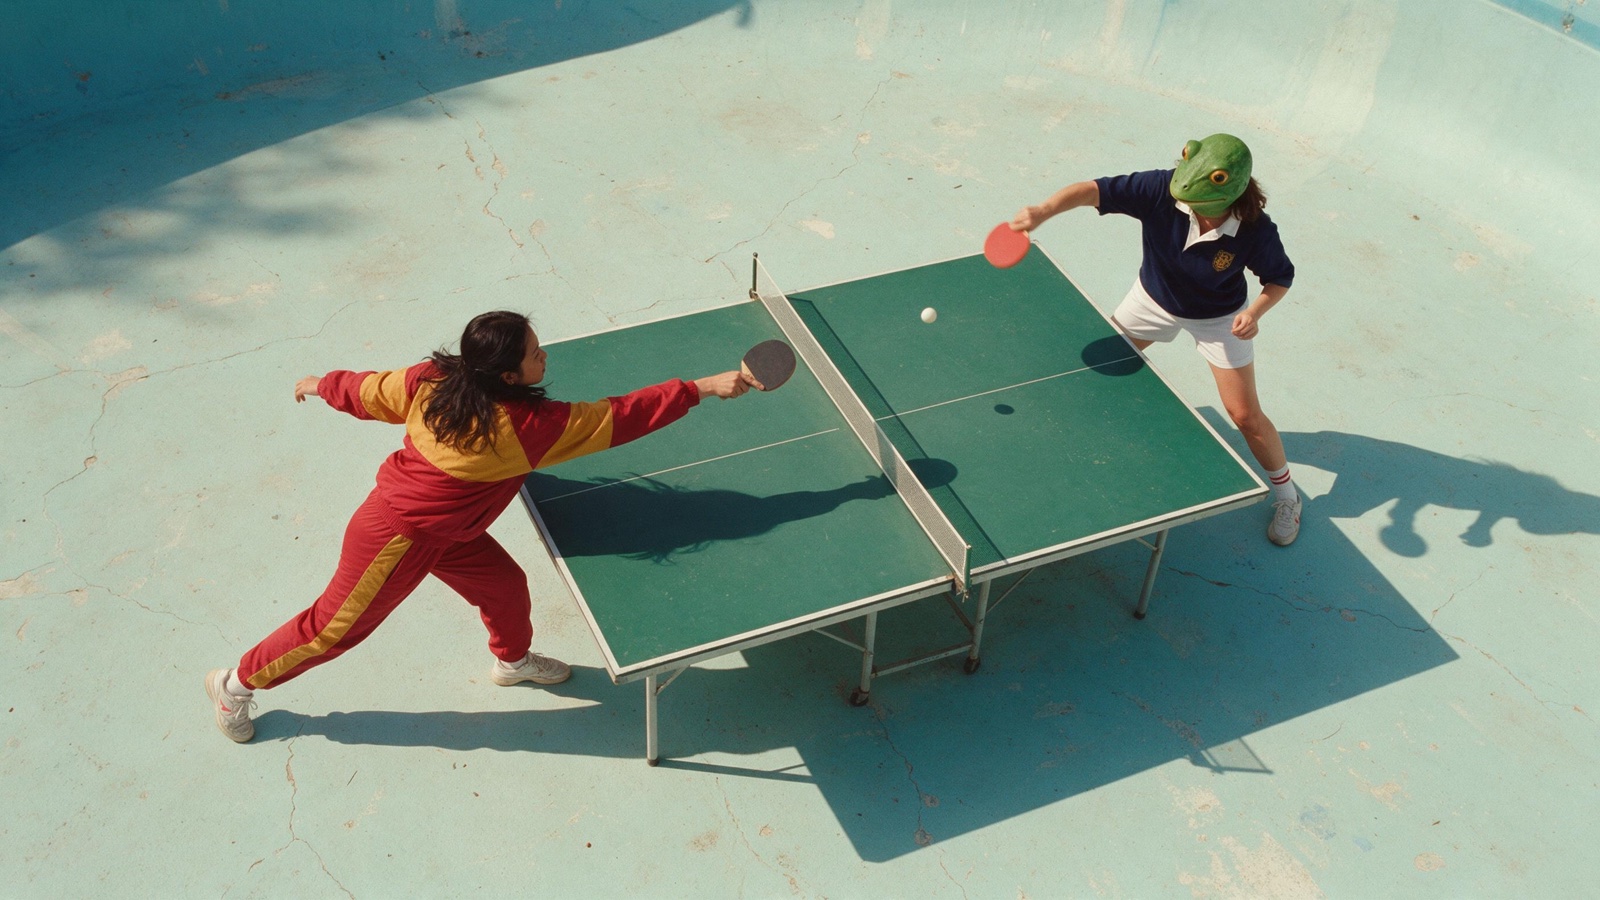 | 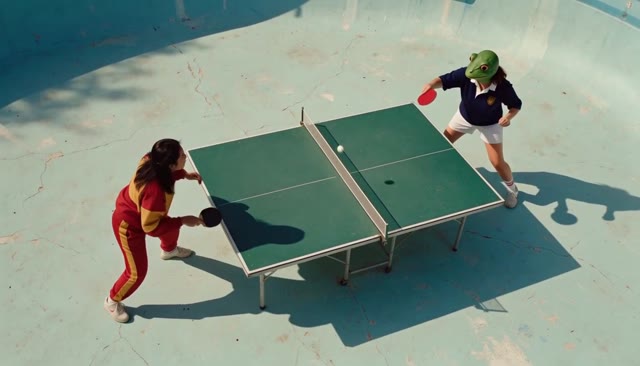 |
|---|---|
| Референс первого кадра | Один кадр вывода за шесть шагов |
Демонстрация настольного тенниса: на вход подаётся один кадр, а промпт требует пять запрограммированных движений камеры (верхний ракурс, опускание крана, резкие панорамы, орбита на 180 градусов, низкий проезд) в пределах 15-секундного дубля. Источник: карточка модели Pika H3 Flex
Полный клип с «камерной каруселью» и сгенерированной звуковой дорожкой из набора примеров Pika в репозитории модели.
Два адаптера, одна шестишаговая схема
Flex разделяет два пути условий H3 на отдельные адаптеры, повторяя собственное разделение базовой модели:
| Адаптер | Условия на | Задачи |
|---|---|---|
| FL2VA | текст, плюс опционально первый и/или последний кадр | текст в видео (T2V), первый кадр (I2V), последний кадр, первый и последний кадры |
| Ref2VA | текст, плюс упорядоченные референсы: изображения, видео и аудио | референс в видео, перенос движения, замена персонажа, редактирование по референсу |
Ref2VA принимает до 9 изображений, 3 видео и 3 отдельных аудиоклипов, всего до 12 референсных файлов, и требует хотя бы одного изображения или видео. Каждое референсное видео или отдельный аудиоклип должно длиться от 2 до 15 секунд, при этом суммарная длительность каждой из этих двух групп ограничена 15 секундами. Собственная звуковая дорожка видео остаётся привязанной к этому видео и не считается дополнительным аудиофайлом.
Выход: 480p или 768p нативно в 11 соотношениях сторон, при 24 fps, со стерео аудио 32 кГц, смикшированным в файл, при запрошенной длительности от 5 до 15 секунд. Сетка кадров H3 округляет эти значения вверх: 5-секундный запрос возвращает 124 кадра, 15-секундный возвращает 362.
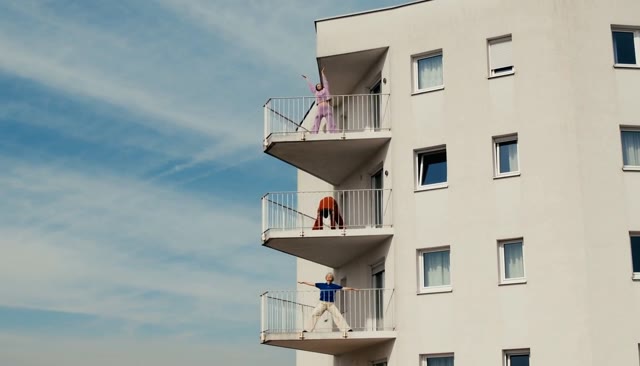
Один промпт управляет тремя отдельно анимированными людьми на ярусах балконов через орбиту, наезд, вертикальный подъём и обратную орбиту, без склеек.
Релиз для ComfyUI
Три шаблона поставляются в библиотеке шаблонов ComfyUI в разделе Video: video_pika_h3_flex_t2v.json, video_pika_h3_flex_fl2va.json и video_pika_h3_flex_ref2va.json, все описаны на странице учебника ComfyUI. Каждый из них объединяет pruned int8 диффузионную модель H3 с соответствующим адаптером и запускает опубликованную Pika схему: LCM-сэмплер с ManualSigmas и CFG 1.0 через BasicGuider, сила адаптера зафиксирована на 1.0.
Две детали важны, если вы строите собственный граф вместо загрузки шаблона:
- Сетка сигм является частью контракта чекпоинта. Манифест Pika перечисляет узлы
1000/750/500/250/100/40/0, video shift 12, audio shift 3 и свежий промежуточный шум. Выбор шести шагов в универсальном сэмплере не воспроизводит этот контракт. - Не добавляйте вторую ускоряющую LoRA. Адаптер уже дистиллирован до шести шагов, и учебник отмечает, что добавление turbo или Lightning LoRA поверх ломает вывод.
Коннекторы представляют собой обычные BF16-конверсии, а не новый чекпоинт: обычные модули сохраняют rank 128, а слитые Q/K/V-проекции объединены до rank 384, и конверсия переупорядочивает половины SwiGLU под нативную структуру H3. В readme адаптера Pika прямо указано, что целостность файлов и конвертация тензоров проверены, но ни один сквозной рендер в ComfyUI не был проверен в рамках загрузки. Ожидайте некоторого расхождения с эталонным пакетом вывода.
Ранний отчёт о практическом тестировании из #pika-h3-flex-early согласуется с этим: тестировщик NebSH объединил 6-шаговый проход 960x544 с латентным апскейлом и 4-шаговым проходом 1920x1088, получив результат 2560x1440 за 3 мин 17 сек, тогда как WAS отметил артефакты (popping) на высокочастотных деталях, например на далёких птицах, при четырёх шагах и рекомендовал оставить шесть.
Как Pika пришла к шести шагам
Технический разбор описывает три этапа пост-обучения поверх выпущенной H3 с дистилляцией guidance:
- Обучение с учителем (supervised fine-tuning) на собственном эстетически отобранном аудио-видео датасете, охватывающем задачи генерации и редактирования, всё ещё при 50 шагах учителя.
- Projected Distribution Matching Distillation (PDMD, Wang et al. 2026), чтобы сократить выборку с 50 шагов до шести. Pika сообщает, что стандартный DMD в их прогонах был нестабилен, а PDMD обучался надёжнее и давал лучшее качество вывода.
- Reward learning после дистилляции через ReFL (эстетика и чёткость) и DPO (следование инструкциям, реализм, визуальное качество), обученные как две отдельные LoRA и объединённые в один адаптер, так что комбинированное поведение не требует дополнительных шагов выборки.
Отдельный стек обслуживания делает остальное: кешированные зависящие от таймстепа проекции AdaLN, слитые ядра, FlashAttention-4 и блочно-разреженное внимание со сжатой коммуникацией. На восьми GPU B300 при 5-секундном 768p с аудио это сократило полный вывод с 3,409 с до 2,129 с, ускорение в 1,60x, при фиксированных чекпоинте и шестишаговой схеме.
Что говорят цифры, и о чём они молчат
Pika оценила Flex против официальной MiniMax H3, Fal H3 Max и HeyGen Video (quality) при 768p на одном наборе промптов и сообщает о наивысшем балле по всем пяти метрикам визуального и аудио качества:
| Метрика | Pika H3 Flex | MiniMax H3 | Fal H3 Max |
|---|---|---|---|
| Техническое качество видео | 12.3 | 11.7 | 10.6 |
| Эстетика видео | 5.41 | 5.28 | 5.00 |
| Эстетика аудио | 7.02 | 6.85 | 6.89 |
| Выравнивание аудио и видео | 0.212 | 0.208 | 0.216 |
Выравнивание аудио с видео и текста с видео примерно на уровне конкурентов, и эти цифры взяты из собственной оценки Pika. В их слепом попарном исследовании Flex лидирует по анатомии человека, сложной композиции и синхронизации аудио для генерации по тексту и изображению, а также по визуальному стилю, кадрированию и движению камеры для генерации по референсу. Pika также заявляет, что другие системы остаются предпочтительнее в физике, многосценном повествовании, освещении и материалах, а также в насыщенных действиями референсных задачах.
A/B-тесты сообщества пока немногочисленны, но согласуются с представлением о работоспособной шестишаговой модели, а не о бесплатном обеде. Kijai прогнал один и тот же пример промпта T2V через DMAD и Flex по шесть шагов каждый и сообщил, что DMAD не справился с этим случаем, тогда как djbfilmz сравнил шестишаговый Flex с двадцатишаговым прогоном без адаптера и сказал, что будет дорабатывать на Flex, а для финальных версий делать полный двадцатишаговый рендер. Заявление самого учебника: 5-секундный клип 1344x768 примерно за минуту на одной карте.
 |  |
|---|---|
| Многосценный продуктовый ролик | Референсы персонажа и окружения плюс клип с движением |
Ещё два показательных случая: девятисценный рекламный ролик по одному референсу продукта и перенос движения, где хореография берётся из видео, а идентичность и стиль из двух неподвижных изображений.
Доступность
Репозиторий содержит два FP32-адаптера (fl2va/adapter.safetensors, ref2va/adapter.safetensors, по 2,77 ГБ каждый) для пакета вывода Pika, BF16-конверсии для ComfyUI (по 1,96 ГБ каждая) в comfy/loras/ и базовые компоненты H3 в формате Diffusers, которые, по словам Pika, в сумме занимают около 210 ГБ. Каждый шаблон ComfyUI загружает только нужный ему раздел трансформера.
Расширения Pika с хостингом остаются вне загрузки: апскейл до 1080p, 2K и 4K из черновика 768p, пять отдельных аудиодорожек (диалоги, музыка, SFX, фоли, эмбиент), улучшение промптов и ускоренный стек обслуживания относятся к API-функциям. Локальный вывод открытых весов покрывает 480p и 768p.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.