Ядро ComfyUI: латентное увеличение H3 и Sol-H3-VAE
Два принятых PR в ядро ComfyUI добавляют латентные апскейлеры MiniMax H3 и дистиллированный декодер Sol-H3-VAE: декодирование 2K H3 ускоряется с 14,5 с до 0,89 с.
28 октября 2026 года в ComfyUI приняли два pull request в ядро, которые переносят путь высокого разрешения MiniMax H3 из пользовательских нод в ядро. PR 17412 добавляет поддержку моделей латентного апскейлера с отдельной нодой для H3, а PR 17411 учит загрузчик VAE открывать Sol-H3-VAE, дистиллированный быстрый декодер от команды Efficient-Large-Model из NVIDIA. Оба написал Kijai, и оба попали в код после тега v0.43.1, поэтому они есть в master и ночных сборках, но не в текущем релизе 0.43.x.
Эта пара нацелена на две дорогие части работы с H3 в 2K: увеличение латентного представления без полного прохода через VAE и декодирование готового клипа.
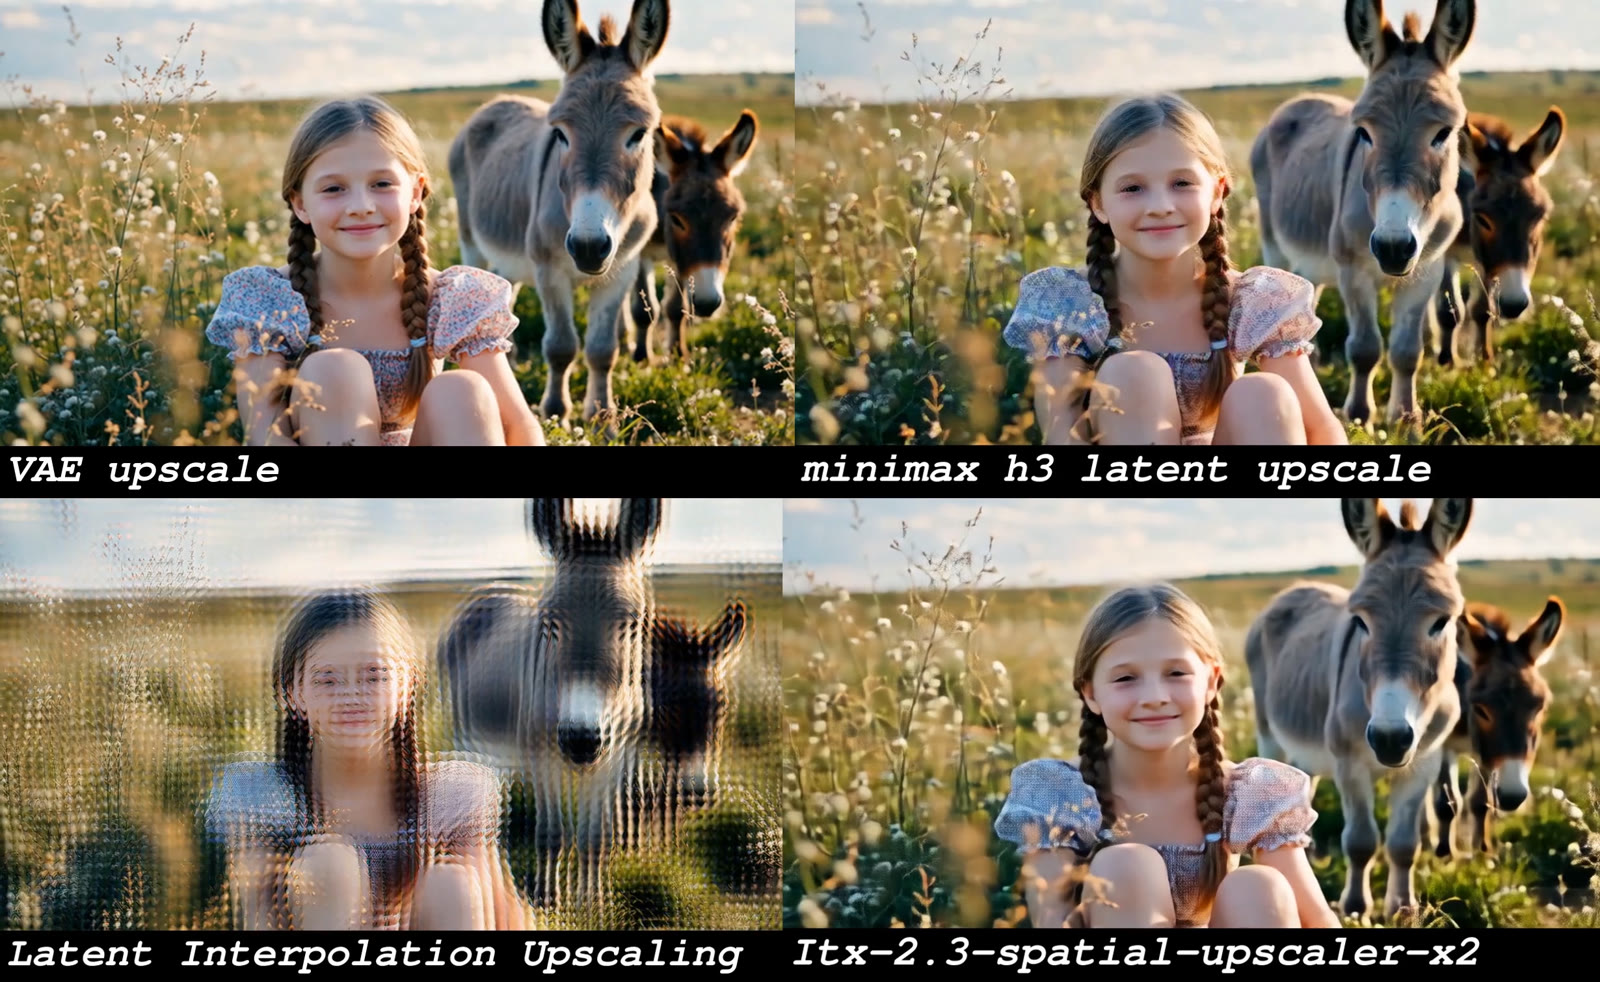
Проход низкого разрешения, увеличенный в латентном пространстве латентным апскейлером H3, из его карточки модели.
Видеосравнение из того же репозитория.
Что появилось в ядре
| PR | Слияние | Что меняется |
|---|---|---|
| 17412 | 2026-10-28 20:05 UTC | Новый модуль comfy/ldm/minimax/latent_upscaler.py, ветвь H3 в Load Latent Upscale Model, новая нода MiniMax H3 Latent Upscale With Model |
| 17411 | 2026-10-28 23:46 UTC | Детекция Sol-H3-VAE и пересопоставление ключей в загрузчике VAE, путь noncausal-декодера, поддержка int8-квантованного декодера, оценка памяти декодера |
Ни один из PR не поставляет чекпойнт. Они позволяют загружать существующие веса сообщества штатным загрузчиком, так что апскейлер H3, для которого раньше требовался пакет узлов, теперь работает только на нодах ядра.
Увеличение разрешения внутри латентного пространства
Латентные представления H3 содержат 24 канала и отдельный аудиопоток. Латентный апскейлер от LBH-123-AI работает напрямую с латентным представлением видео на 3D-свёрточном бэкбоне: 345 280 216 параметров, 24 входных и выходных канала, 512 базовых каналов, 12 входных и 12 выходных блоков, с временной свёрткой каждые два блока при размере ядра 5.
Смысл в том, чтобы пропустить цепочку decode -> pixel upscale -> encode через VAE H3, который в карточке модели описан как примерно 5 млрд параметров. Автор также отмечает, что обычная билинейная или бикубическая интерполяция латентов H3 даёт «гостинг» (двоение), которого обученный апскейлер избегает. Для обучения использовали около 80 000 парных примеров: примерно 70 000 видеопар и 8000 пар 2K-изображений, причём доминирующий масштаб в наборе это 2x.
Ядро читает архитектуру из state dict, поэтому число блоков, ширина каналов и временное ядро берутся из самих весов, а не из отдельного конфига. Выход ноды сохраняет вложенный латент H3, то есть аудиополовина проходит без изменений, и сгенерированная звуковая дорожка переживает увеличение. Маска шума на входном латенте отбрасывается.
Стоит знать о двух отличиях от сопутствующего пакета узлов:
- Нода ядра принимает целевой размер, а не коэффициент масштаба.
MiniMax H3 Latent Upscale With Modelпо умолчанию использует 2560x1440, с шагом 32 и обычным потолком разрешения. Нода сообщества вместо этого даёт непрерывный масштаб от 1.0x до 4.0x. - Одно только увеличение не добавляет деталей. Оно меняет размер латента, поэтому детали возвращает второй проход выборки в новом разрешении. При малом числе шагов на этом проходе результат остаётся мягким.
Если запрошенный размер совпадает с размером латента, нода ядра возвращает вход без изменений, не запуская модель.
Sol-H3-VAE как декодер на замену
Sol-H3-VAE это быстрый видеодекодер для H3, который заменяет штатный 36-слойный декодер VAE на 24-слойный noncausal-декодер с 1,62 млрд параметров, дистиллированный из него. Он декодирует целые кадры с оконным вниманием вместо пространственных тайлов и декодирует каждый нативный блок из 5 латентов двунаправленно. Согласно его карточке модели, он принимает те же нормализованные латенты и возвращает те же кадры, что и декодер VAE H3, а аудиодекодер не трогает.
| Один 5-секундный клип | H3 VAE | Sol-H3-VAE |
|---|---|---|
| 768p, RTX 5090 | 12,5 с | 5,0 с |
| 720p, GB200 | 6,16 с | 0,34 с |
| 2K, GB200 | 14,5 с | 0,89 с |
В карточке указано 45,4 дБ PSNR относительно декодера H3 на отложенных латентах от 720p до 2K и 38,2 дБ на сгенерированном клипе 768p. Цифры для GB200 получены с записанного CUDA-графа, показатель RTX 5090 относится к eager-режиму.
Чтобы открыть этот чекпойнт в ядре, потребовалось больше, чем новый шаблон имени файла:
- В выпущенном файле декодер хранится без префикса
decoder., поэтому загрузчик на лету пересопоставляет ключи и подставляет среднее и стандартное отклонение латентов H3, если их нет. - Noncausal-декодер меняет арифметику кадров. На выходе 4 кадра на латент, причём первый латент каждого блока из 5 латентов даёт один кадр:
4t - 3 * ceil(t/5)кадров дляtлатентов, с соответствующей обратной формулой для кодирования. - Поскольку весь клип декодируется сразу, а не тайлами, PR добавляет отдельную оценку памяти, чтобы загрузчик мог спланировать VRAM до начала декодирования.
- Квантованные сборки Sol VAE тоже загружаются: загрузчик определяет int8 с весами conv-rotation и переключается на операции смешанной точности.
Выпущенный файл это один sol_h3_vae.safetensors примерно на 6,5 ГБ в fp32.
Как подключить в граф
- Поместите чекпойнт апскейлера в
ComfyUI/models/latent_upscale_models/. Релиз для H3 включает bf16 и fp16 примерно по 691 МБ каждый, а также fp32.pthна 1,38 ГБ. - Поместите
sol_h3_vae.safetensorsвComfyUI/models/vae/и загрузите его обычным загрузчиком VAE. - Соедините
Load Latent Upscale ModelсMiniMax H3 Latent Upscale With Modelмежду проходом выборки низкого разрешения и вторым проходом сэмплера при 2560x1440 или выше. - Декодируйте уточнённый латент с помощью Sol VAE.
Веса апскейлера распространяются по Apache-2.0. В библиотеке шаблонов ComfyUI по-прежнему есть только шаблоны размещённого H3 API, поэтому официального локального шаблона 2K для этой пары пока нет, а приведённые выше тайминги это измерения из самих карточек моделей, а не бенчмарки ComfyUI.
Доступность
- Апскейлер: LBH-123-AI/Minimax_h3_latent_Upscaler (Apache-2.0, чекпойнты bf16 / fp16 / fp32, плюс два примера рабочих процессов в репозитории)
- Быстрый декодер: Efficient-Large-Model/Sol-H3-VAE, с эталонным пакетом Python в
code/и стадией ComfyUI более широкого рантайма в ветви Sol-Engine репозитория NVlabs/Sana - Изменения в ядре: PR 17412, PR 17411
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.