TARA: нативное временное выравнивание для референсов MiniMax H3
ComfyUI-BFSNodes добавляет TARA: экспериментальный патч, который сохраняет нативным референс движения MiniMax H3 и смещает внимание к соответствующему моменту гайда.
Перенос движения на MiniMax H3 обычно работает через внедрение латентов управляющего клипа в качестве гайда: Add Guide или маскированный латент в том же латентном пространстве. TARA идёт другим путём. Клип подаётся как нативный референс <Video N> в MiniMax H3 Reference to Video, его временное начало RoPE выравнивается по часам выхода, а внимание от каждого момента выхода к далёким моментам гайда штрафуется. В формулировке репозитория режим «сохраняет нативный видео-референс, выравнивает его временные координаты RoPE с целевыми и мягко штрафует целевые запросы, обращающиеся к далёким моментам гайда».
Для самого патча ничего не обучается. Он не добавляет обучаемых весов и не загружает собственный LoRA; временное предпочтение вычисляется во время выборки и затрагивает только запросы выхода, которые обращаются к выбранному видео движения. Референсные изображения сохраняют нативные координаты, а текст, референсное аудио и собственное self-attention цели сохраняют обычное правило.
Временное правило
Изменяются только связи от запросов выходного видео к ключам выбранного видео движения:
dt = abs(output_time - guide_time)
penalty(dt) = min(strength * (max(dt - window, 0) / falloff)^2, cap)
score = dot(Q, K) / sqrt(head_dim) - penalty(dt)
По умолчанию свободное окно составляет 0.20 с, falloff 0.25 с, strength 2.0 и cap 6.0; на узле они доступны как window, falloff, strength и cap. Внутри свободного окна штрафа нет вообще. За его пределами штраф растёт квадратично, пока не достигнет cap, поэтому далёкие кадры гайда остаются доступными с малым весом, а не маскируются. При значениях по умолчанию локальная коррекция обнуляется примерно на 0.633 с.
| Разница во времени | Штраф | Коэффициент внимания |
|---|---|---|
| 0.00 с | 0.00 | 1.000000 |
| 0.40 с | 1.28 | 0.278037 |
| 0.80 с | 6.00 | 0.002479 |
Одна оговорка описана прямо: если задать strength равным нулю, смещение исчезнет, но выравнивание RoPE останется, поэтому настоящее сравнение «с выключенной TARA» означает обход узла и подачу оригинальной модели и в guider, и в scheduler.
Подключение
Отдельный узел называется BFS MiniMax H3 TARA - Native Temporal Alignment (Experimental) и ставится на путь MODEL после загрузки LoRA и перед guider. Клип движения это обычный нативный референс <Video N>, а motion_video_index выбирает, какой из них поставляет движение; нумерация изображений и видео независима.
Репозиторий требует 24 fps с обеих сторон и совпадающих окон кадров (107 кадров это допустимое количество), предупреждает о том, чтобы не наслаивать второй временной патч, и требует держать Add Guide, гайды по первому кадру, VSA, SLA и неизвестные замены внимания или блоков вне пути MODEL. Обычные маски генерации по-прежнему разрешены, потому что маска не создаёт временной гайд. На путях CFG каждая ветка условия, которую оценивает пропатченная модель, должна сохранять референс движения.
Внутри Shot Planner (BFS Shot H3 Conditioning) то же поведение включается одним пунктом выпадающего списка: guide_mode = TARA - Native Temporal Alignment (experimental). Узел условия возвращает пропатченную модель, и сэмплируется именно упакованная временная сетка текущего шота.
Три бэкенда
- Flash Partitions (по умолчанию с 1.115.11) сохраняет правило, но вычисляет его через нативные ядра CUDA FlashAttention с выходами log-sum-exp, объединяя три неотрицательных вклада вместо построения плотного тензора смещения или ядра
torch.compile. Требует CUDA FP16/BF16 и примитива FlashAttention-with-LSE из PyTorch. - Однопроходные ядра Comfy Kitchen (1.115.16 и новее) встраивают правило в плотные ядра INT8 и sol-attn и убирают цикл внимания по кадрам. Готовые библиотеки поставляются для SM80, SM86, SM89, SM90, SM100 и SM120 на Linux, а также DLL для Windows для SM86, SM89 и SM120; драйвер должен поддерживать CUDA 13, даже если PyTorch работает на 12.x. С 1.115.17 настройка при первом использовании автоматическая на Linux SM120, а строка лога во время выборки сообщает, действительно ли работал fused-путь.
- Совместимость с sol-attn (1.115.14) поддерживается с документированными ограничениями, а официальный узел Model Attention Backend учитывается с 1.115.13.
Что говорят цифры
Репозиторий разделяет один изолированный микробенчмарк и логи полного рабочего процесса одного пользователя и помечает оба. На RTX PRO 6000 Blackwell при 107 126 токенах, 8 головах и BF16:
| Бэкенд | Вызов внимания |
|---|---|
| Нативный FlashAttention | 0.327 с |
| Flash Partitions | 0.422 с |
| Оригинальный временной FlexAttention | 0.628 с |
Это примерно в 1.5 раза быстрее оригинального временного бэкенда для такой формы; измерение проводилось, пока работал процесс обучения, с 8 головами вместо 56 у H3, и это не заявление о скорости всей модели. Прогон пользователя на RTX 5090 при 544×928 и 360 кадрах показал 179.18 с для первой полной оценки модели при guide scale 1.0 (52 751 строка гайда) и 54.45 с при scale 0.5 (11 984 строки), со второй оценкой в 47.19 с. Старый путь FlexAttention был зафиксирован на 603.40 с для первого шага, включая инициализацию, и документация называет эти числа несопоставимыми с прогретым вызовом внимания.
Что ещё понадобится
TARA не заменяет LoRA переноса движения, она меняет то, как обусловлен референс. Документация предлагает использовать с узлом checkpoint, обученный через ветку feat/h3-native-temporal-motion в ai-toolkit (native_temporal_v1), тогда как публичное сравнение в репозитории использует LoRA шага 10500, обученный для Add Guide. Под временным патчем эта LoRA следует за исполнением источника и сохраняет одежду референсного персонажа, что автор фиксирует как экспериментальное наблюдение, а не гарантию. Свежий native-temporal checkpoint на шаге 750 упоминается в документации как показывающий более слабое удержание идентичности и не опубликован для скачивания, поэтому согласованного публичного адаптера пока нет.
В Discord Banodoco один пользователь попробовал узел на RTX 4090 и H100 в день релиза и сообщил, что обе карты его запускают, причём путь Kitchen на этом железе немного медленнее, чем flash partitions.
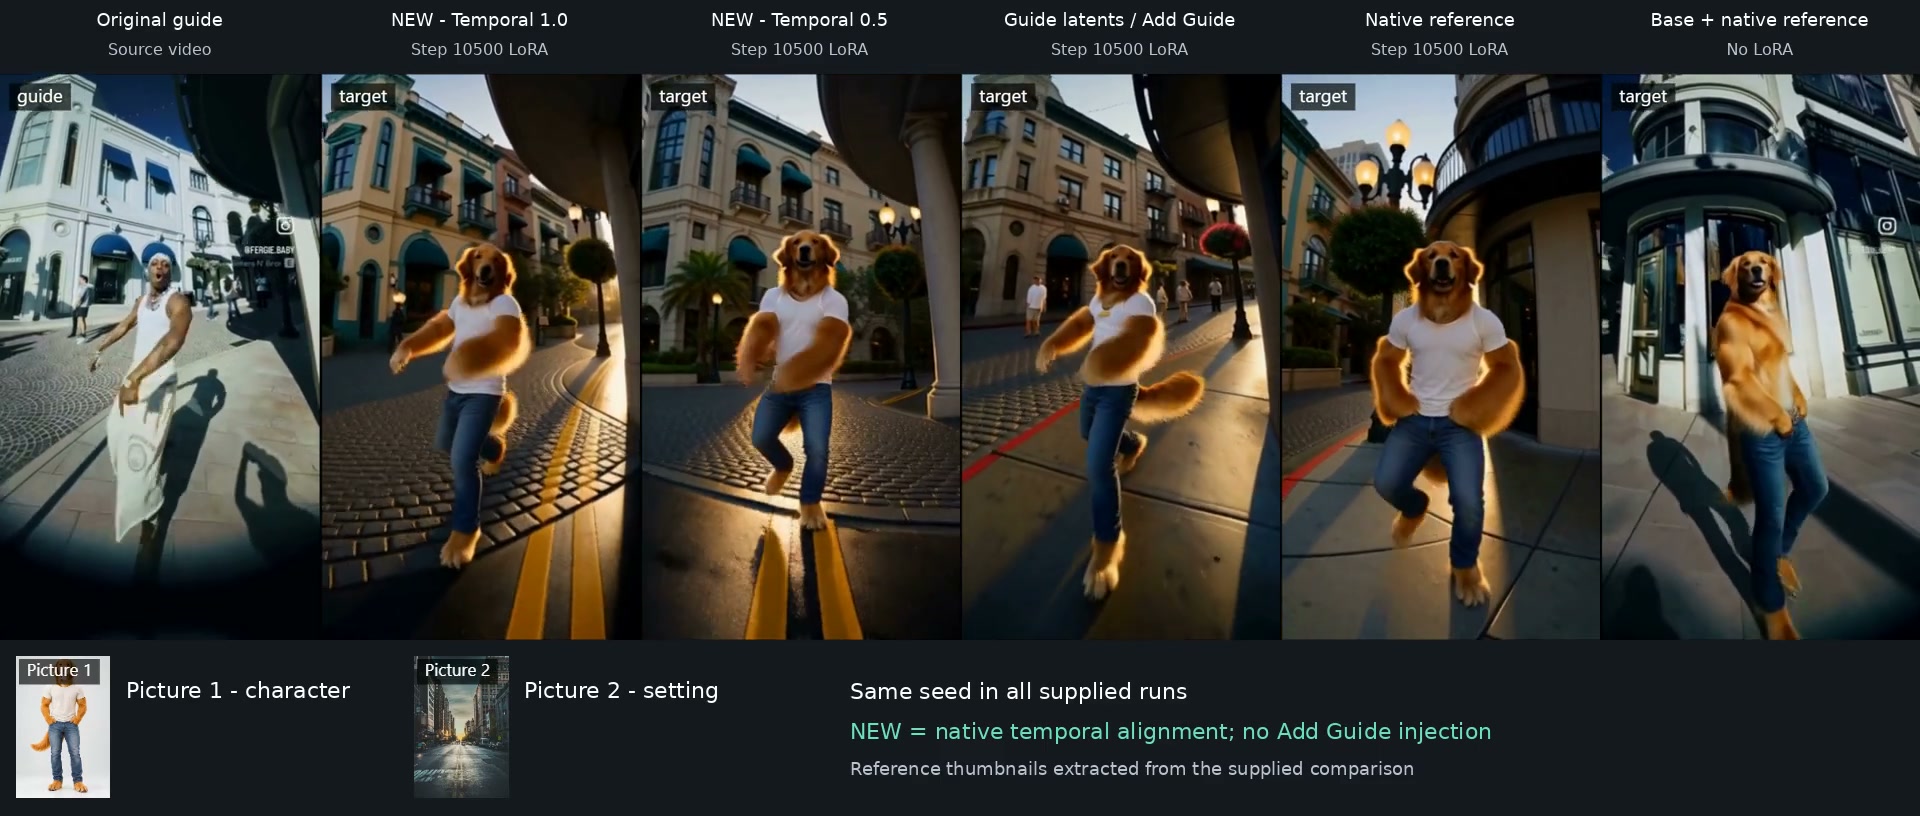
Один кадр из сравнения по шести колонкам, слева направо: оригинальный гайд, LoRA шага 10500 с TARA при guide scale 1.0, та же LoRA с TARA при 0.5, та же LoRA с латентами Add Guide, нативный референс без временного патча и базовая модель с нативным референсом. Временные колонки отмечены в видео как NEW.
Полный 15-секундный экспорт side-by-side из репозитория, все шесть колонок воспроизводятся одновременно.
Настройка четырёх параметров
Пакет также содержит анимированное руководство по параметрам с офлайн HTML-версией, ползунки которой анимируют то же правило. Совет такой: начинать со значений по умолчанию, держать seed, LoRA, промпт, источник и выход фиксированными и менять по одному параметру. Дрейф движения это в первую очередь проблема таймлайна: неверный <Video 1>, несовпадение частоты кадров или сдвинутое окно кадров нельзя исправить более сильным смещением. Дрейф идентичности указывает на назначение референса, LoRA и условия по изображению, а не на временные параметры.
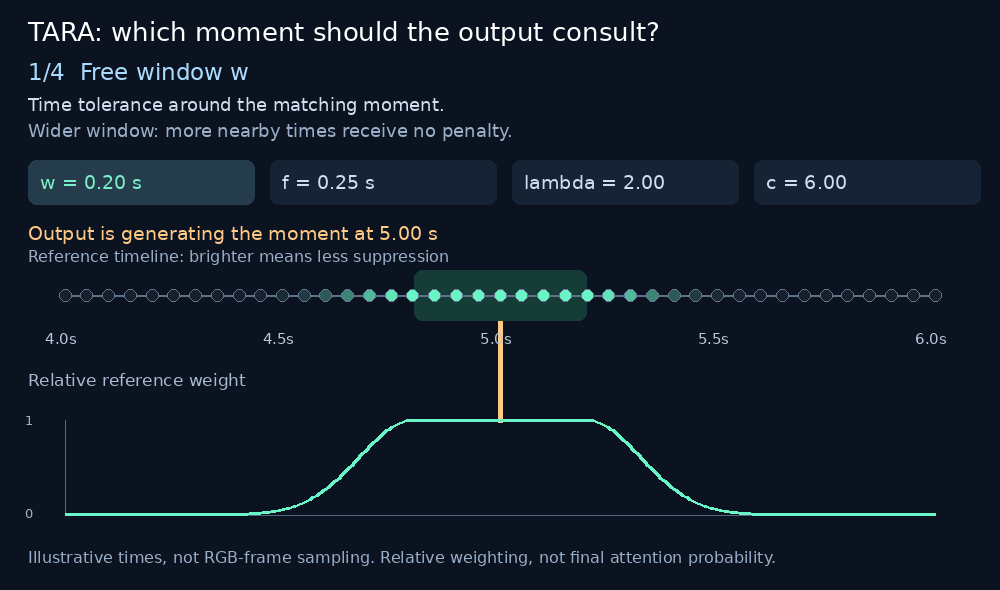
Свободное окно, falloff, strength и cap из руководства по параметрам репозитория.
Ограничения
- Функция экспериментальная и включается по желанию; по умолчанию в Planner по-прежнему Add Guide, и документация говорит, что полная валидация визуального качества не завершена.
- Опубликованное демо носит качественный характер: seed одинаковы во всех колонках, но не все настройки генерации были зафиксированы, а запрошенная замена фона остаётся частичной.
- Оба клипа должны иметь совпадающие временные сетки, а подход сохраняет плотную квадратичную работу внимания.
- Валидация пока состоит из проверок математики на CPU и тестов маршрутизации плюс оценок пользователей на RTX 5090. Аудио гайда упаковывается нативно, но временного смещения не получает.
Доступность
ComfyUI-BFSNodes опубликован в реестре Comfy как bfsnodes и устанавливается через ComfyUI Manager либо клонируется в custom_nodes/. TARA работает поверх нативных узлов MiniMax H3 и весов Comfy-Org/MiniMax-H3, используемых для обычной генерации H3.
Полный контракт условий описан в H3_NATIVE_TEMPORAL.md, вывод бэкендов и таблицы таймингов в H3_FLASH_PARTITIONS.md, а исследовательская ветка, лежащая в основе метода, в alisson-anjos/ai-toolkit. Для использования вне этого пакета узлов есть руководство по ручной установке.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.