Qwen-Image 2.1 за 2 шага: DMD2 LoRA при CFG 1
Дистилляционная LoRA DMD2 запускает текст-в-изображение и редактирование с несколькими референсами в Qwen-Image 2.1 за 2 шага при CFG 1, с демо Space.
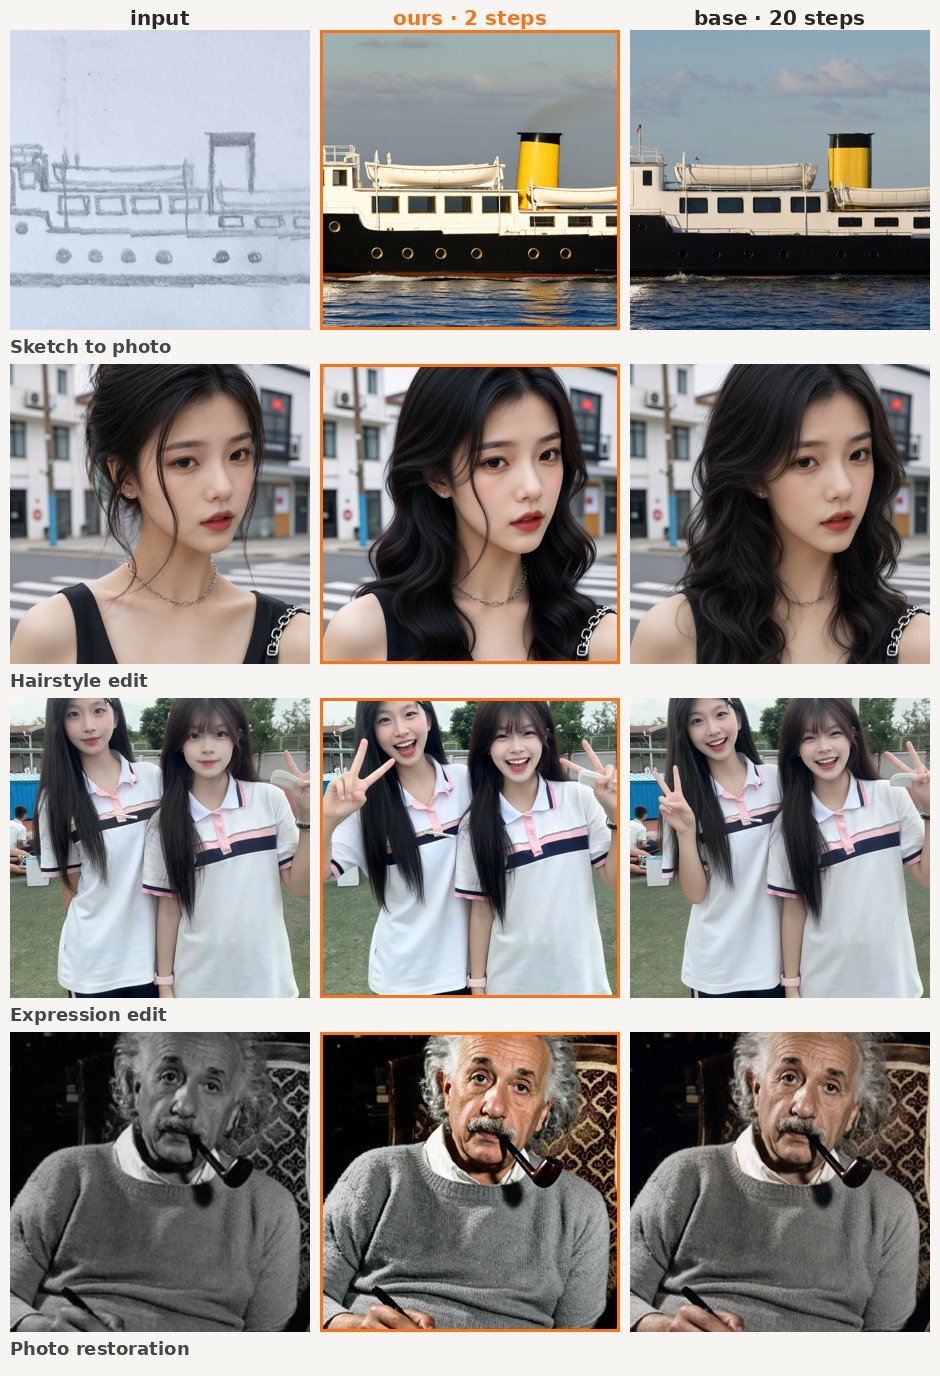
Из наброска в фото, причёска, выражение лица и восстановление фото, один и тот же вход, промпт и seed. В каждой строке: вход, LoRA за 2 шага, затем базовая модель за 20 шагов.
Почему 2 шага это другой уровень
Qwen-Image 2.1 поставляется с 40 шагами, а опубликованные до сих пор ускорители опускаются до 8 (собственный Turbo checkpoint Alibaba) и 4 (Lightning LoRA от LightX2V). Этот адаптер нацелен на нижнюю границу этого диапазона, и расписание здесь фиксированное, а не рекомендуемое:
| Параметр | Значение |
|---|---|
| Шаги | 2 |
| Расписание сигм | [1.0, 0.5], фиксированное |
| CFG | 1 (true_cfg_scale=1.0) |
| Ранг / alpha LoRA | 32 / 32 |
| Адаптированные модули | только attention: to_q, to_k, to_v, to_out.0 |
| Размер файла | 64 МБ (256 тензоров) |
Карточка явно указывает, что LoRA обучалась на этой самой паре сигм, поэтому планировщик нужно закрепить с use_dynamic_shifting=False и shift=1.0. Если оставить динамический сдвиг включённым, он пересчитывает сигмы под каждое разрешение, и адаптер уже выбирает не тот путь, на котором его дистиллировали.
Адаптация только attention это второй осознанный выбор. В карточке утверждается, что это точнее сохраняет входное изображение при редактировании, чем дополнительная адаптация feed-forward блоков, на которые у более ранних few-step адаптеров для этой модели уходила большая часть бюджета.
Как её обучали
DMD2 (Distribution Matching Distillation) с on-policy сопоставлением распределений и направлением CFG учителя, без regression loss и без GAN loss в целевой функции. Обучение длилось 2 000 шагов на одной H100 на кропах с разным соотношением сторон примерно при 1 МП, что соответствует диапазону разрешений, который используется в демо. 20-шаговый учитель это эталон, с которым сравнивает карточка, а не 40-шаговый дефолт модели.
Что сохраняется за 2 шага
Редактирование и композиция с несколькими референсами продолжают работать. Qwen-Image 2.1 принимает список изображений-условий, и промпт ссылается на них по позиции, поэтому двухшаговый запуск по-прежнему разрешает промпты вроде "place the cat from Picture 1 on the beach from Picture 2", не схлопываясь до одного референса:
image = pipe(
    prompt="Place the cat from Picture 1 on the beach from Picture 2.",
    image=[cat, beach],
    num_inference_steps=2,
    sigmas=[1.0, 0.5],
    true_cfg_scale=1.0,
).images[0]
Текст в изображение это тот же вызов с отброшенным аргументом image. Выход RGBA не меняется, поскольку альфа-канал берётся из базовой модели, а не из адаптера.
Демонстрационный Space автора, Qwen Image 2.1 Realtime, ставит то же расписание за живой интерфейс: режим реального времени стримит результат 512px, который обновляется по мере изменения промпта, а режим полного качества переключается на 1024 и 1536.
Запуски сообщества
В канале #qwen-image Banodoco тестировщики запускали адаптер внутри ComfyUI поверх нативных узлов Qwen-Image 2.1 и публиковали сравнения по шагам. RuneX сообщил, что замена головы за 2 шага работает и что один дополнительный шаг был немного лучше, на семплерах Euler, ER-SDE и LCM. patientx измерил 2, 3 и 4 шага подряд и обнаружил, что 3 шага "очень близки к настоящему результату", 4 пригодны, а 8 это регресс, при этом общее время выполнения почти не меняется между 2 и 4 шагами, потому что доминирует загрузка модели.
Единственная загвоздка для ComfyUI это именование. Safetensors сохранён в форме diffusers/PEFT, transformer.transformer_blocks.N.attn.to_q.lora.down.weight и соответствующие .lora.up тензоры, тогда как загрузчик ComfyUI ориентируется на собственные имена параметров модели, начинающиеся с transformer_blocks.N. Ведущий transformer. нужно срезать до того, как загрузчик что-либо сопоставит, иначе он сообщит о ключах как о несопоставленных, и LoRA ничего не сделает.
Доступность
Веса LoRA: linoyts/Qwen-Image-2.1-DMD2-2steps на Hugging Face. Базовая модель: Qwen/Qwen-Image-2.1. Демо: Qwen Image 2.1 Realtime.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.