Hi3D v1.0 уточняет грубые меши до геометрии 1536³
Hi3D v1.0, выпущенный 23 октября 2026 года, уточняет грубый меш до геометрии высокого разрешения трёхпроходным конвейером по одному референсу.
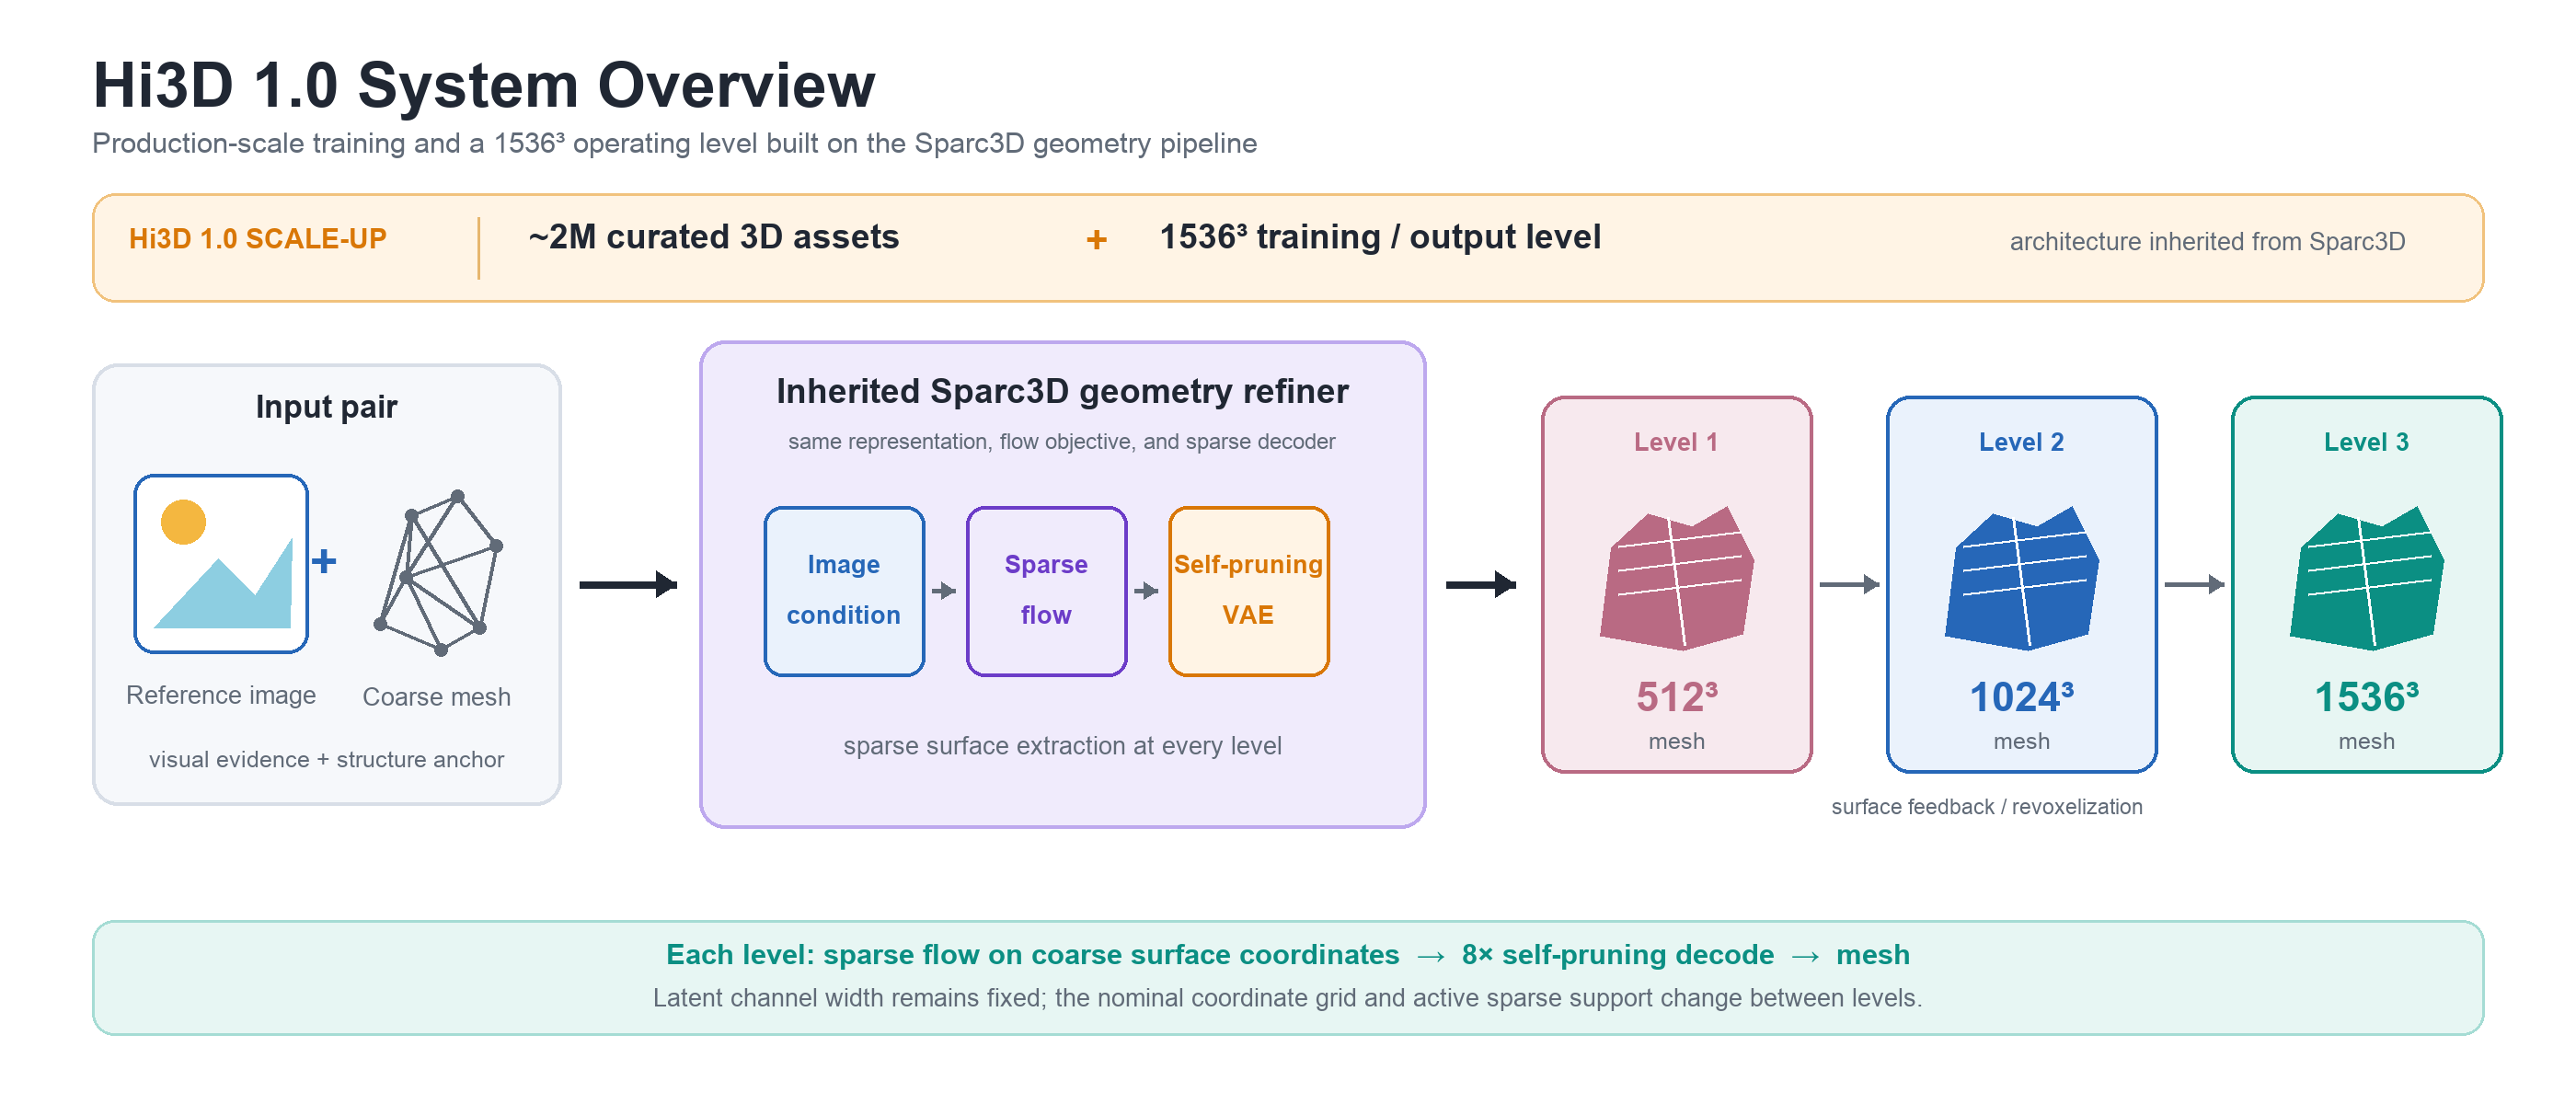
Обзор системы из репозитория проекта: признаки изображения обусловливают разреженный поток по координатам, взятым из грубой геометрии, а каждый извлечённый меш ревокселизуется, чтобы служить затравкой для следующего прохода.
Вторая стадия вместо ещё одного генератора
Конвейеры Image-to-3D в ComfyUI, включая ноды TRELLIS.2 и Pixal3D, завершаются одним мешем, созданным в единственном каскаде. Любая деталь, которую этот каскад упускает, потеряна: тонкий рельеф уплощается, молдинги и зубы размываются, а результат настолько резок, насколько резкой была стадия формы.
Hi3D v1.0 создан для шага после этого. Он не генерирует меш из изображения сам по себе: предполагается, что грубый меш уже существует, а ёмкость сосредоточена на том, чтобы сделать его геометрию плотнее и точнее, используя то же референсное изображение как сигнал условия, а не как цель реконструкции. Грубый меш может происходить от любого генератора или от художника.
Проект построен на Sparc3D, а Python-пакет и публичный API сохраняют исходные имена для совместимости: импорт конвейера уточнения по-прежнему выглядит как from sparc3d import Sparc3DPipeline.
Лестница из трёх проходов
Проход выполняет выборку латентного представления в каждой занятой координате вокселя, декодирует его в поле знаковых расстояний, извлекает меш, а затем ревокселизует этот меш, чтобы обеспечить разреженную поддержку для следующего прохода. Запрос более высокого разрешения просто выполняет больше проходов поверх предыдущего меша.
| Проход | Номинальная сетка структуры | Бюджет вокселей | Трансформер | Сетка извлечения |
|---|---|---|---|---|
| 1 | 64³ | 80 000 | transformer_512 | 512³ |
| 2 | 128³ | 90 000 | transformer_1024 | 1024³ |
| 3 | 192³ | 110 000 | transformer_1024 | 1536³ |
Запрос 512³ выполняет первый проход, 1024³ выполняет два, а 1536³ выполняет все три. Проект прямо указывает, что эти числа описывают разреженные координатные сетки и сетки извлечения, а не плотный латентный тензор 1536³ и не гарантированное количество треугольников, поэтому запуск 1536³ не означает фиксированный объём вокселей 1536³.
Работу выполняют два трансформера. У каждого 24 блока, ширина 2112 каналов при 22 головах внимания и примерно 1,8 млрд параметров. Каждый блок применяет разреженное самовнимание по вокселям, кросс-внимание к токенам изображения и MLP, с ротационными позиционными эмбеддингами и RMS-нормализацией к запросам и ключам самовнимания. Выборка по умолчанию использует 25 обновлений сэмплера на проход с сэмплером второго порядка.
Условие изображения поступает от двух замороженных энкодеров: DINOv2-large при 756×756, дающий 2917 токенов изображения по 1024 канала, и CLIP ViT-L/14 при 224×224, дающий пулированное эмбеддинг-представление, которое транслируется на эти позиции. Объединённый результат вычисляется один раз и переиспользуется каждым проходом.
Что меняется на поверхности
Самое наглядное свидетельство в релизе это сравнение крупным планом, где каждый метод просят описать один и тот же референсный участок: слоистый рельеф, архитектурные молдинги, изогнутые границы, чешуя и зубы, концентрические канавки. Hi3D v1.0 это крайний правый столбец.
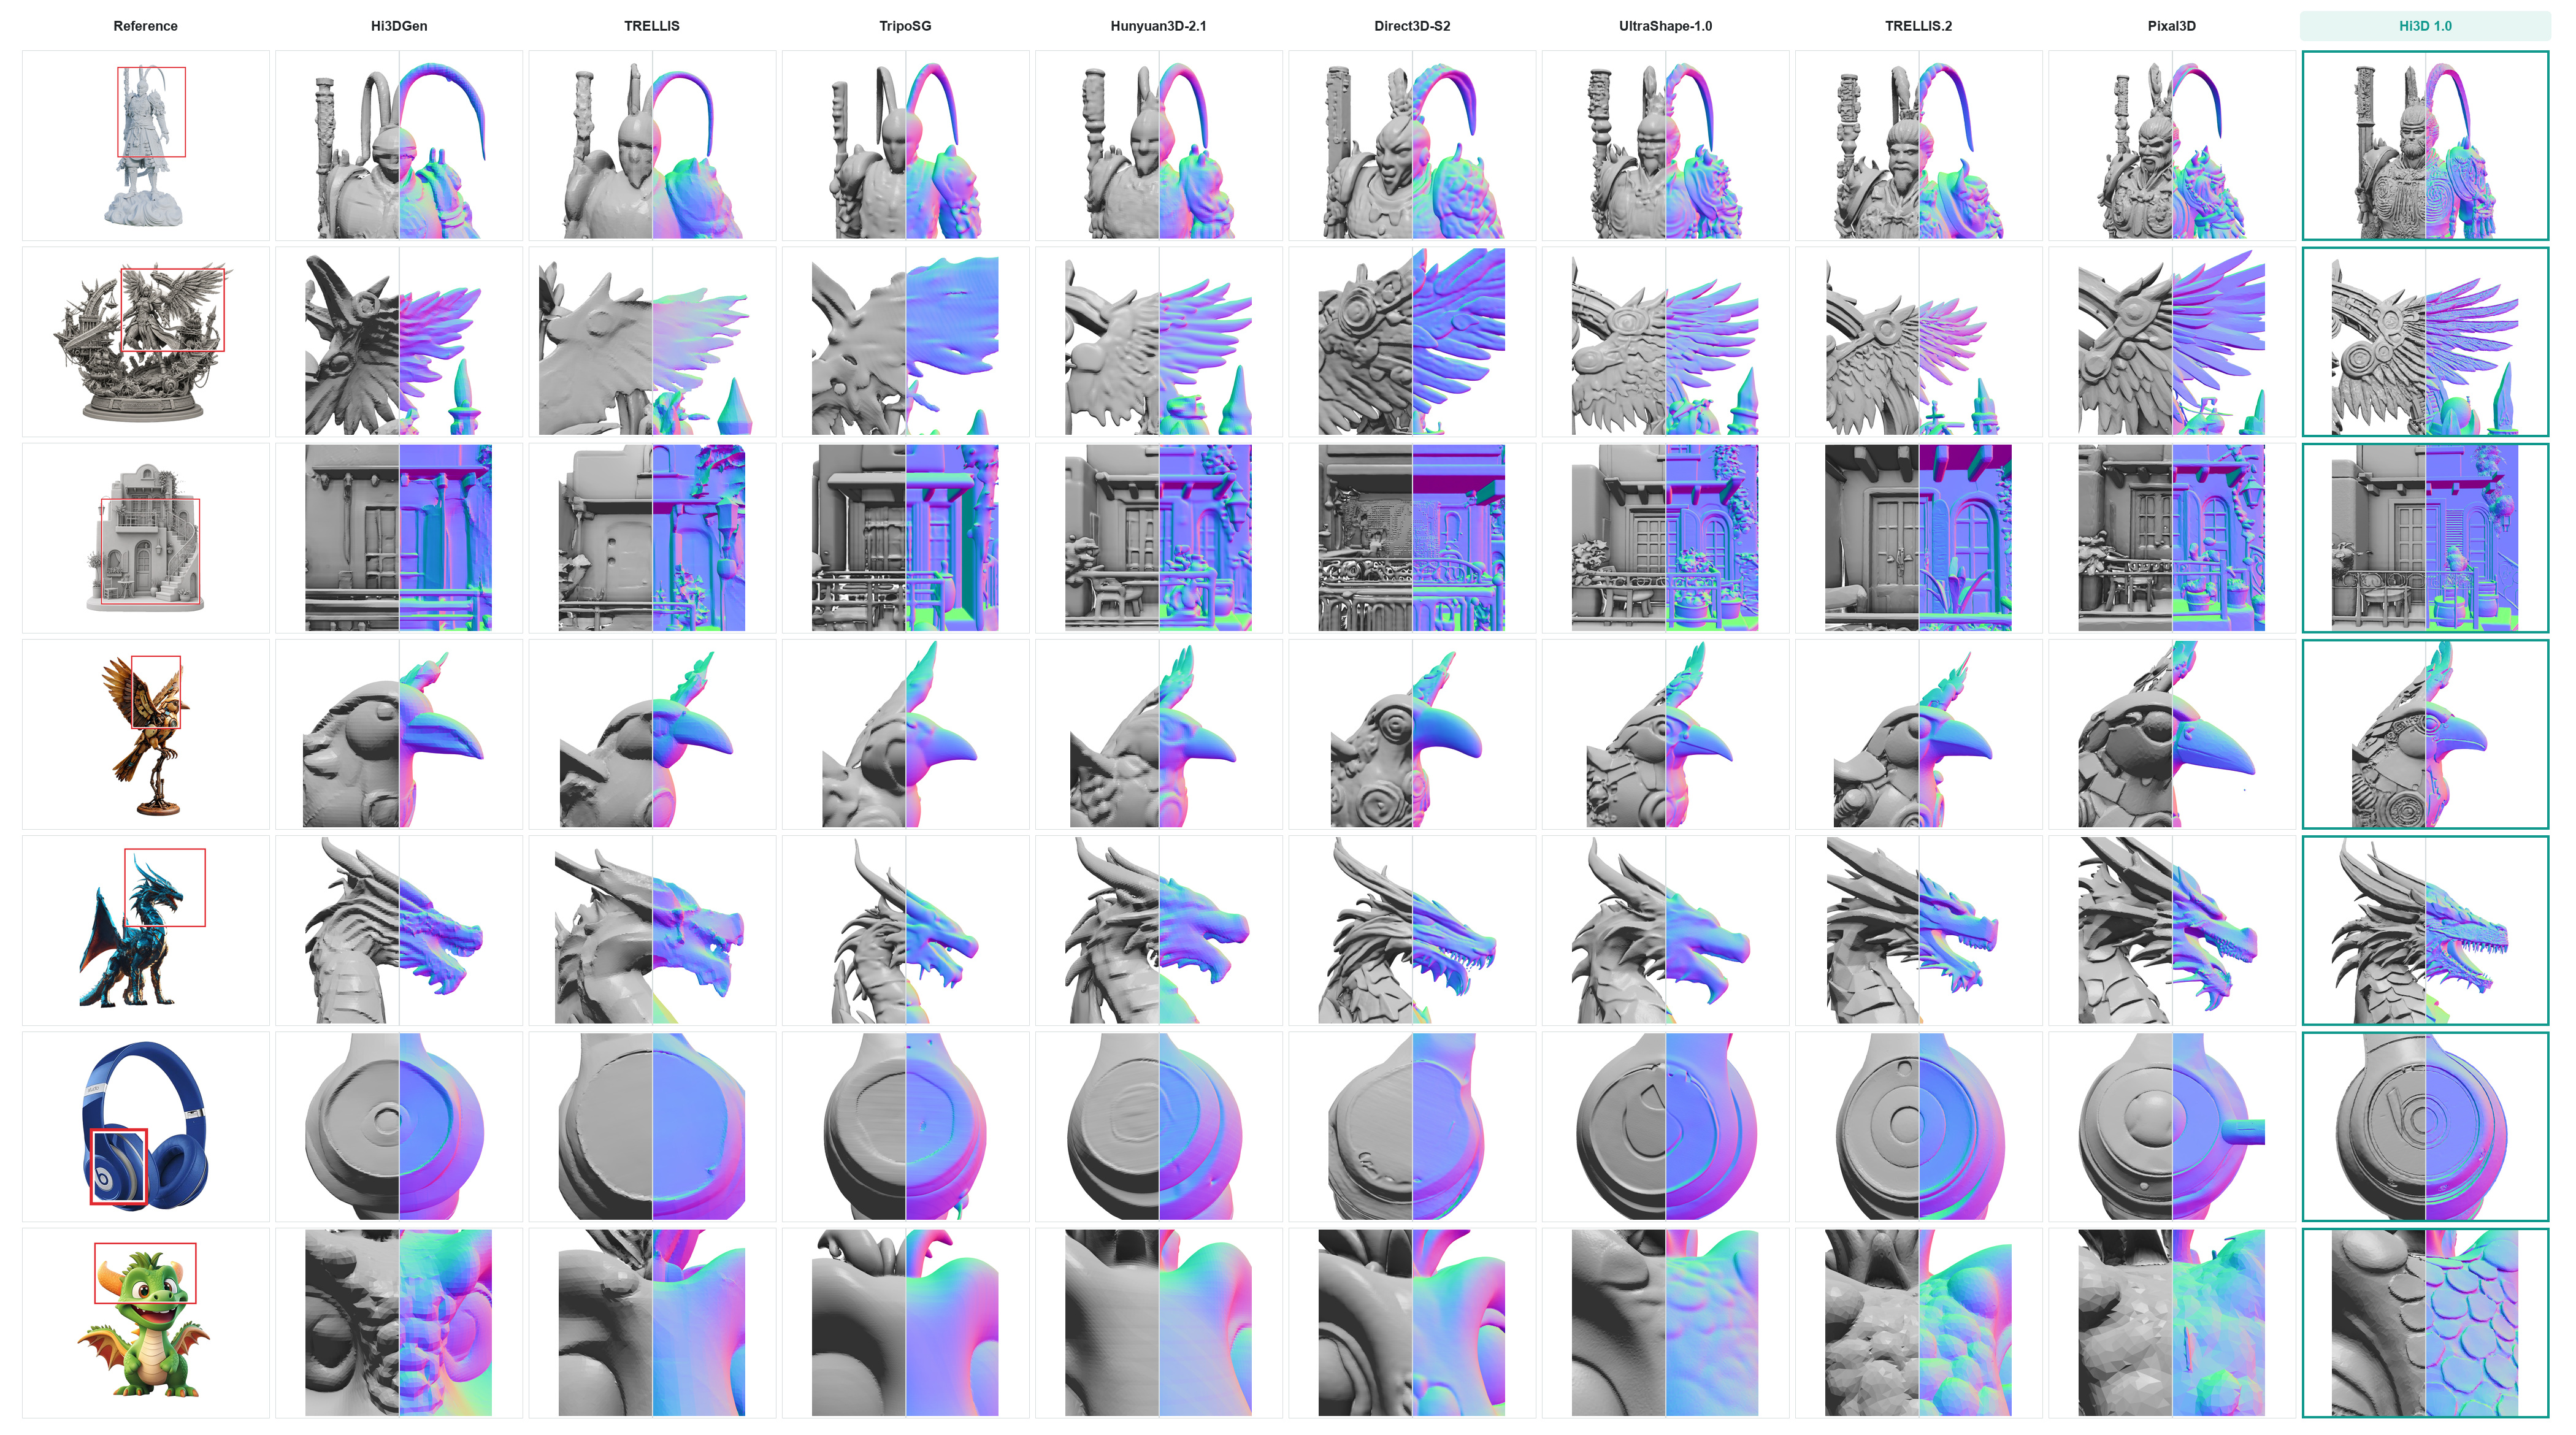
Референсные участки отмечены красными рамками и показаны увеличенными по строкам, как затенённая геометрия и как цветные нормали поверхности.
Более широкий тест это четыре объекта (транспортное средство, персонаж в броне, кресло, женская сумка), показанные спереди, сзади и снизу, где стадия уточнения либо сохраняет цельный силуэт, либо уходит от референса.
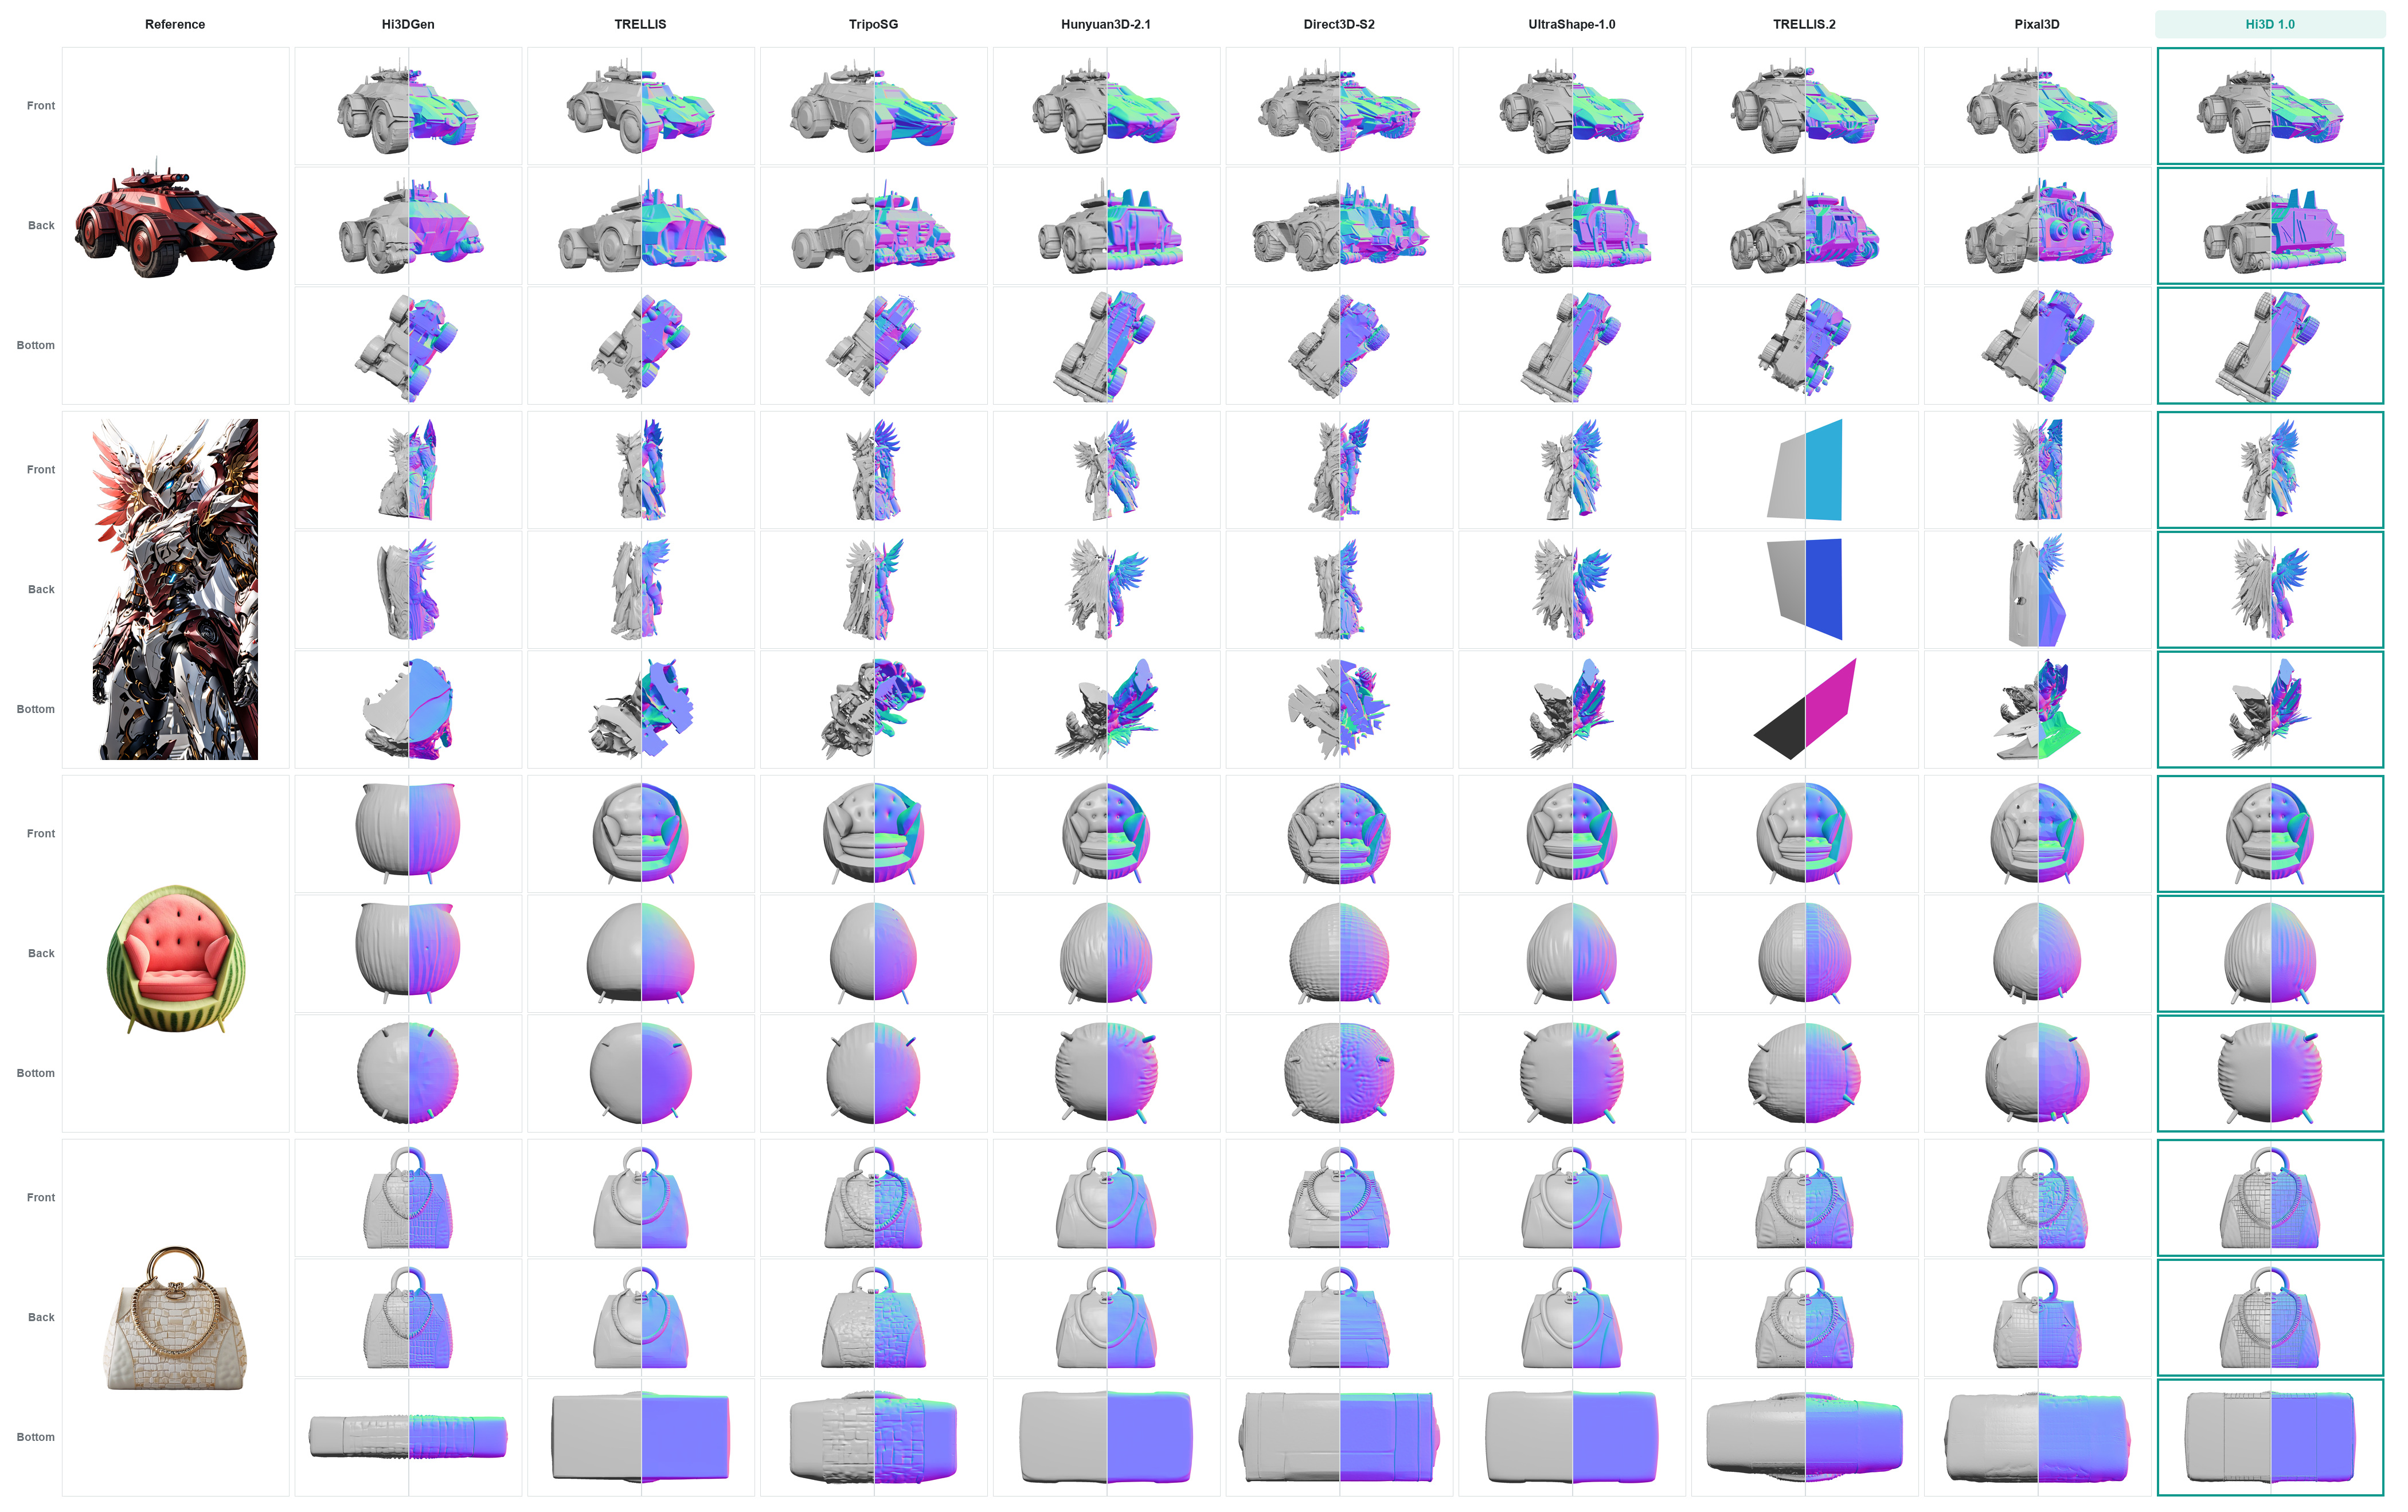
Затенённая геометрия и рендеры нормалей поверхности рядом. Скрытые ракурсы иллюстрируют правдоподобное достраивание, а не точную реконструкцию невидимых поверхностей.
В отчёте, лежащем в основе релиза, описано обучение примерно на двух миллионах отобранных 3D-ассетов. Код обучения, стенд оценки и сравнительные меши не входят в релиз, поэтому опубликованные таблицы нельзя воспроизвести только из репозитория; приведённые выше числа принадлежат самому проекту.
Чего стадия уточнения не делает
Формулировки границ применимости в карточке модели необычно прямые и правильно задают ожидания:
- Только геометрия. Никаких текстур, материалов и цветов вершин. Hi3D возвращает меш
trimesh, а выход перецентрируется и нормализуется до единичного максимального радиуса, поэтому мировые координаты и абсолютный масштаб не сохраняются. - Грубая стадия решает многое. Серьёзные структурные ошибки во входном меше могут пережить уточнение, а геометрия, которую референсное изображение никогда не показывает, становится правдоподобным достраиванием, а не реконструкцией.
- Разрешение это запрос, а не гарантия. Запуск, который не может достичь запрошенного разрешения, выдаёт ошибку вместо тихого возврата более грубого меша.
Доступность
Hi3D v1.0 поставляется как Python-пакет для вывода с весами на Hugging Face: восемь файлов среды выполнения, разложенных в корне репозитория, причём два трансформера загружаются как отдельные компоненты. Необязательная грубая стадия это адаптер для Hunyuan3D-2 mini, и она явно не является зависимостью: demo/refine_mesh.py и Sparc3DPipeline принимают любой треугольный меш напрямую. Хостинговое демо доступно онлайн, чтобы попробовать уточнение без установки.
Интеграции с ComfyUI пока нет. В репозитории нет пользовательских нод, шаблонов рабочих процессов и упоминаний ComfyUI, поэтому Hi3D сейчас работает вне ComfyUI через собственный конвейер. В 3D-каналах Banodoco, где релиз был опубликован 27 октября, первым делом спросили, последуют ли нативные ноды; там модель используют как стадию уточнения перед рабочими процессами TRELLIS.2 и Pixal3D, которые люди уже запускают.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.