Hy-Nomas: интерактивная модель мира от Tencent Hunyuan
Tencent Hunyuan выпустила Hy-Nomas: интерактивную модель мира с 8 шагами выборки, которая генерирует видео 720p под управлением текста и камеры, а порт для ComfyUI уже вышел.
Hy-Nomas — интерактивная модель мира от Tencent Hunyuan: вы описываете мир, а затем продолжаете управлять им текстовыми инструкциями и движениями камеры, пока модель продолжает генерировать. 21 октября 2026 года команда опубликовала веса, код вывода, обучения и разметки данных (tencent/Hy-Nomas | GitHub), а также онлайн-демо и отдельный бенчмарк. Порт для ComfyUI от сообщества появился днём позже.
Релиз ещё очень молод по счётчикам: 21 лайк на Hugging Face и 21 звезда на GitHub на момент написания. Всё ниже взято из карточки модели, репозитория и официальной галереи, а не из сторонних тестов.
Один мир, генерируемый сегментами
Hy-Nomas работает авторегрессивно по сегментам видео, а не по кадрам. Каждый сегмент очищается от гауссова шума в сжатом латентном пространстве модели, одновременно обращаясь к key/value-кэшу всех сегментов, созданных до него. Промпт текущего хода, траектория камеры и этот кэш — единственные входы, а внимание между сегментами причинное, поэтому для генерации сегмента никогда не нужен будущий.
Дистиллированная конфигурация выполняет 8 шагов удаления шума решателем Euler ODE при направлении текста и камеры 1.0 и выдаёт 720 × 1280 при 24 FPS. Длина сегмента задаётся в файле промпта: в JSON-запросе перечисляются segments с начальными и конечными метками времени, visual_description_long для открывающего сегмента, description_change для каждого следующего хода и contained_actions с собственными метками времени. Если задать inference.video_length=event, длины сегментов вычисляются по времени этих событий.
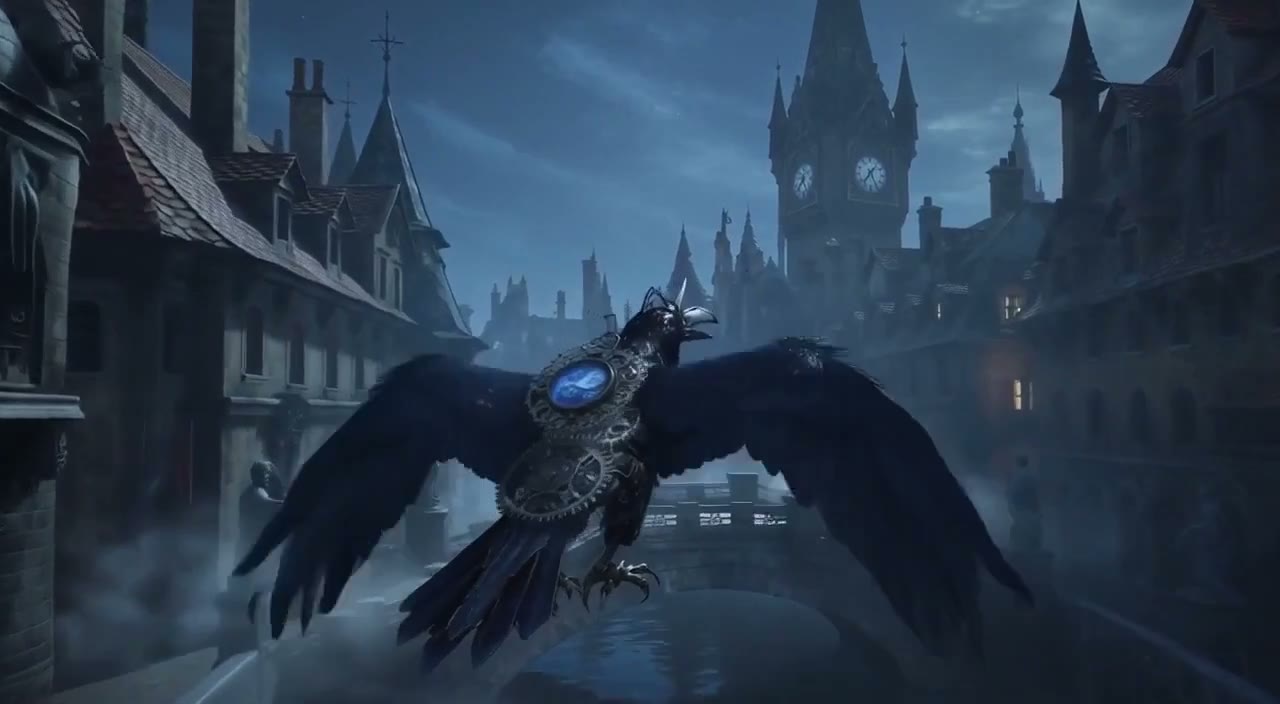
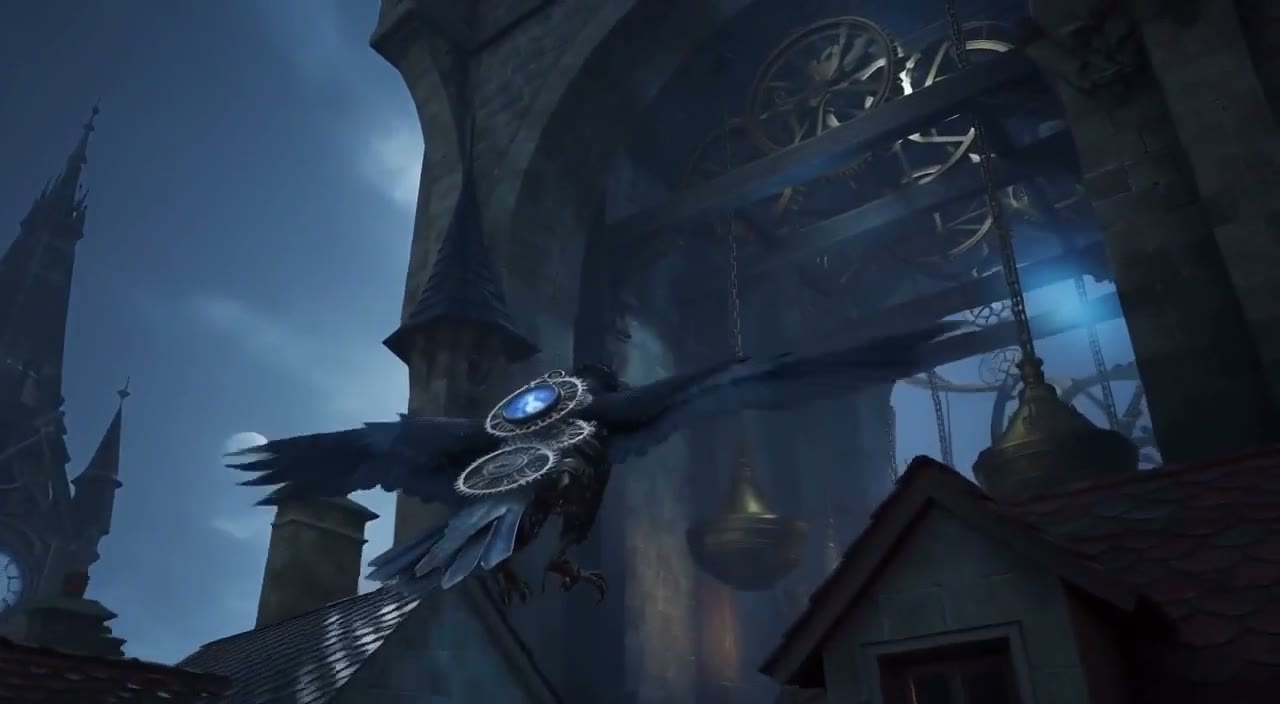
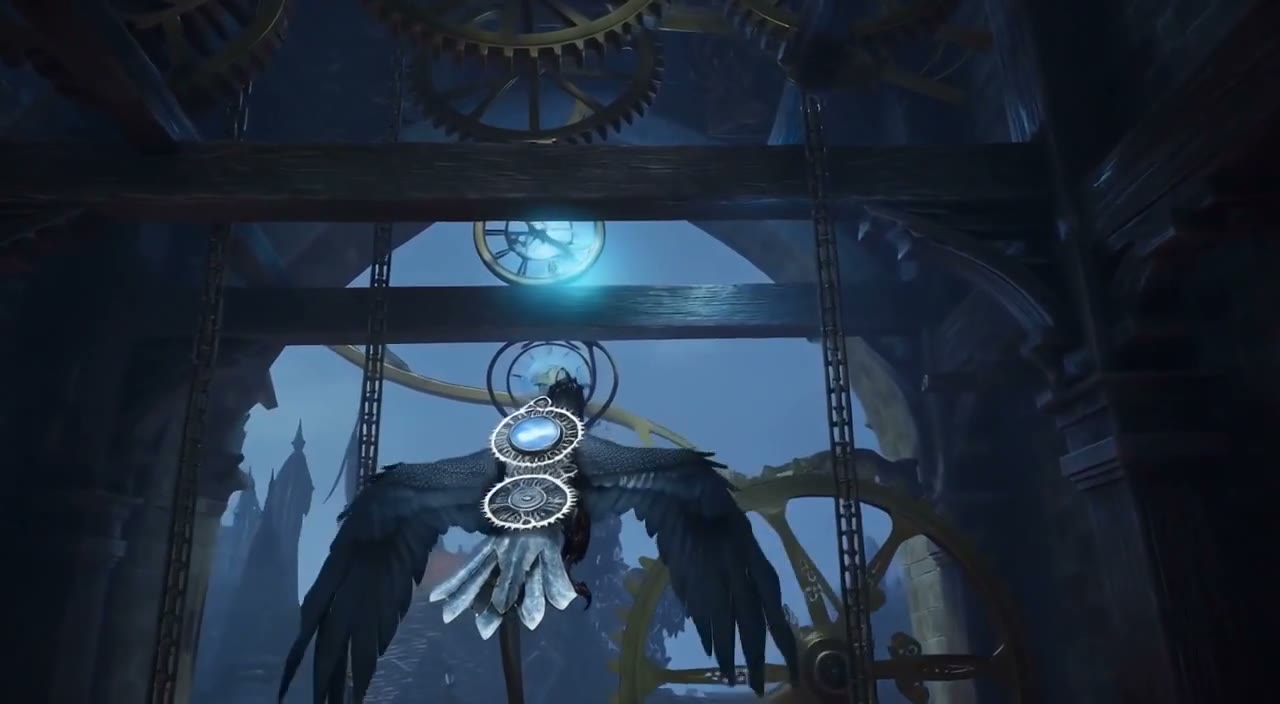
Официальная галерея показывает, как это выглядит на длинном прогоне. Это один 60-секундный клип clockwork-flight, собранный из пяти чисто текстовых ходов по 12 секунд каждый, со следящей камерой от третьего лица в CG-стиле:
 |  |  |
|---|---|---|
| 1 с: «Механическая птица летит над крышами, впереди высокие шпили». | 30 с: «Она огибает арку и направляется к шестерням и конструкциям внутри башни». | 48 с: «Птица движется под шестернями над головой и синим светом внутри башни». |
Шестисекундный фрагмент того же клипа, из хода, где птица влетает в часовую башню. Сгенерировано Tencent Hunyuan, записано из официальной галереи.
Управление камерой как полноценный вход
Движение камеры — не подсказка в промпте, а отдельный путь условия. Файл траектории содержит матрицы «камера-в-мир» c2ws формы [N, 4, 4] и внутренние параметры формы [N, 3, 3]; модель нормализует внешние параметры, группирует их по четыре видеокадра и разворачивает каждую группу во вход размерности 64, к которому видео-токены обращаются через cross-attention в каждом блоке с двумя потоками. Управление доступно в двух масштабах: trajectory_translation_scale по умолчанию равен 1.0, а trajectory_rotation_scale — 2.5.
Текст и камера также могут чередоваться в рамках одного прогона. Галерея разделяет свои примеры по стилю (реальная съёмка, CG, видеоигра, анимация и аниме) и по перспективе (от первого лица, следящая от третьего лица, наблюдатель от третьего лица), а демо позволяет удерживать WASD и стрелки или тянуть мышь, чтобы двигаться по сгенерированному миру, при этом движение записывается при 24 FPS и воспроизводится на следующем ходе.
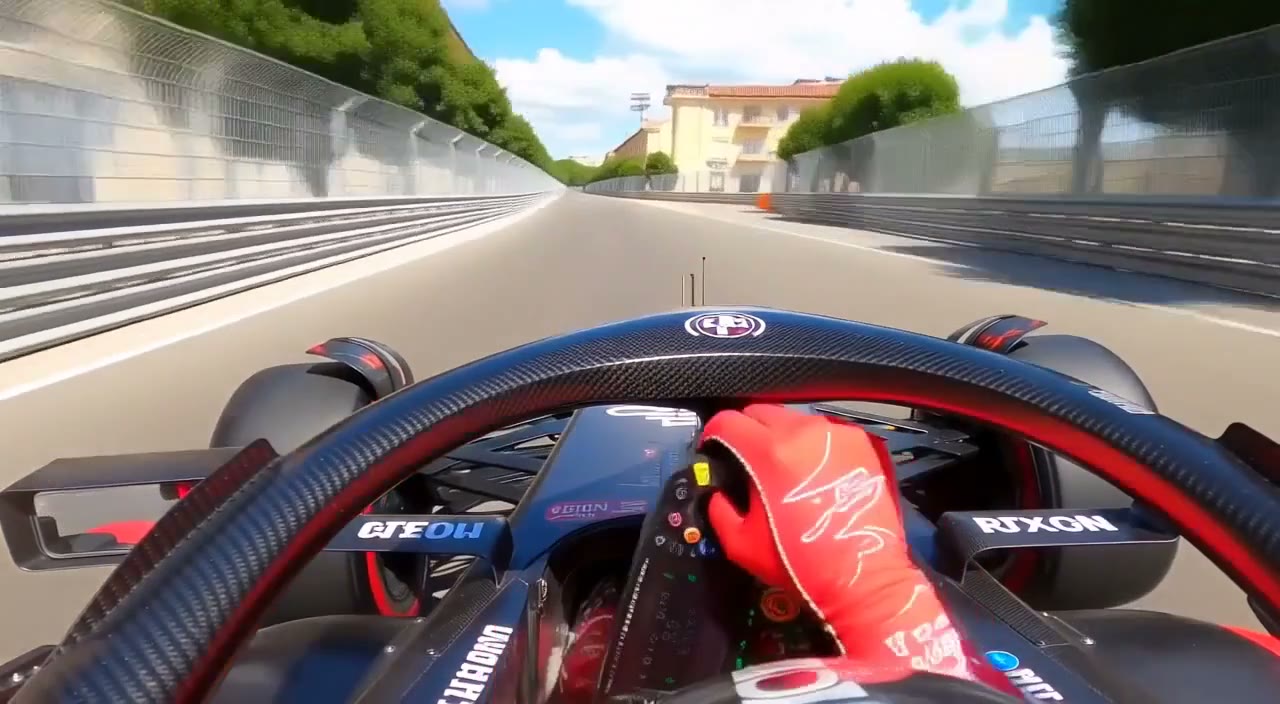
Пример от первого лица из галереи, circuit-drive: уличная трасса, вид из кокпита гоночного автомобиля. Сгенерировано Tencent Hunyuan.
Внутри модели
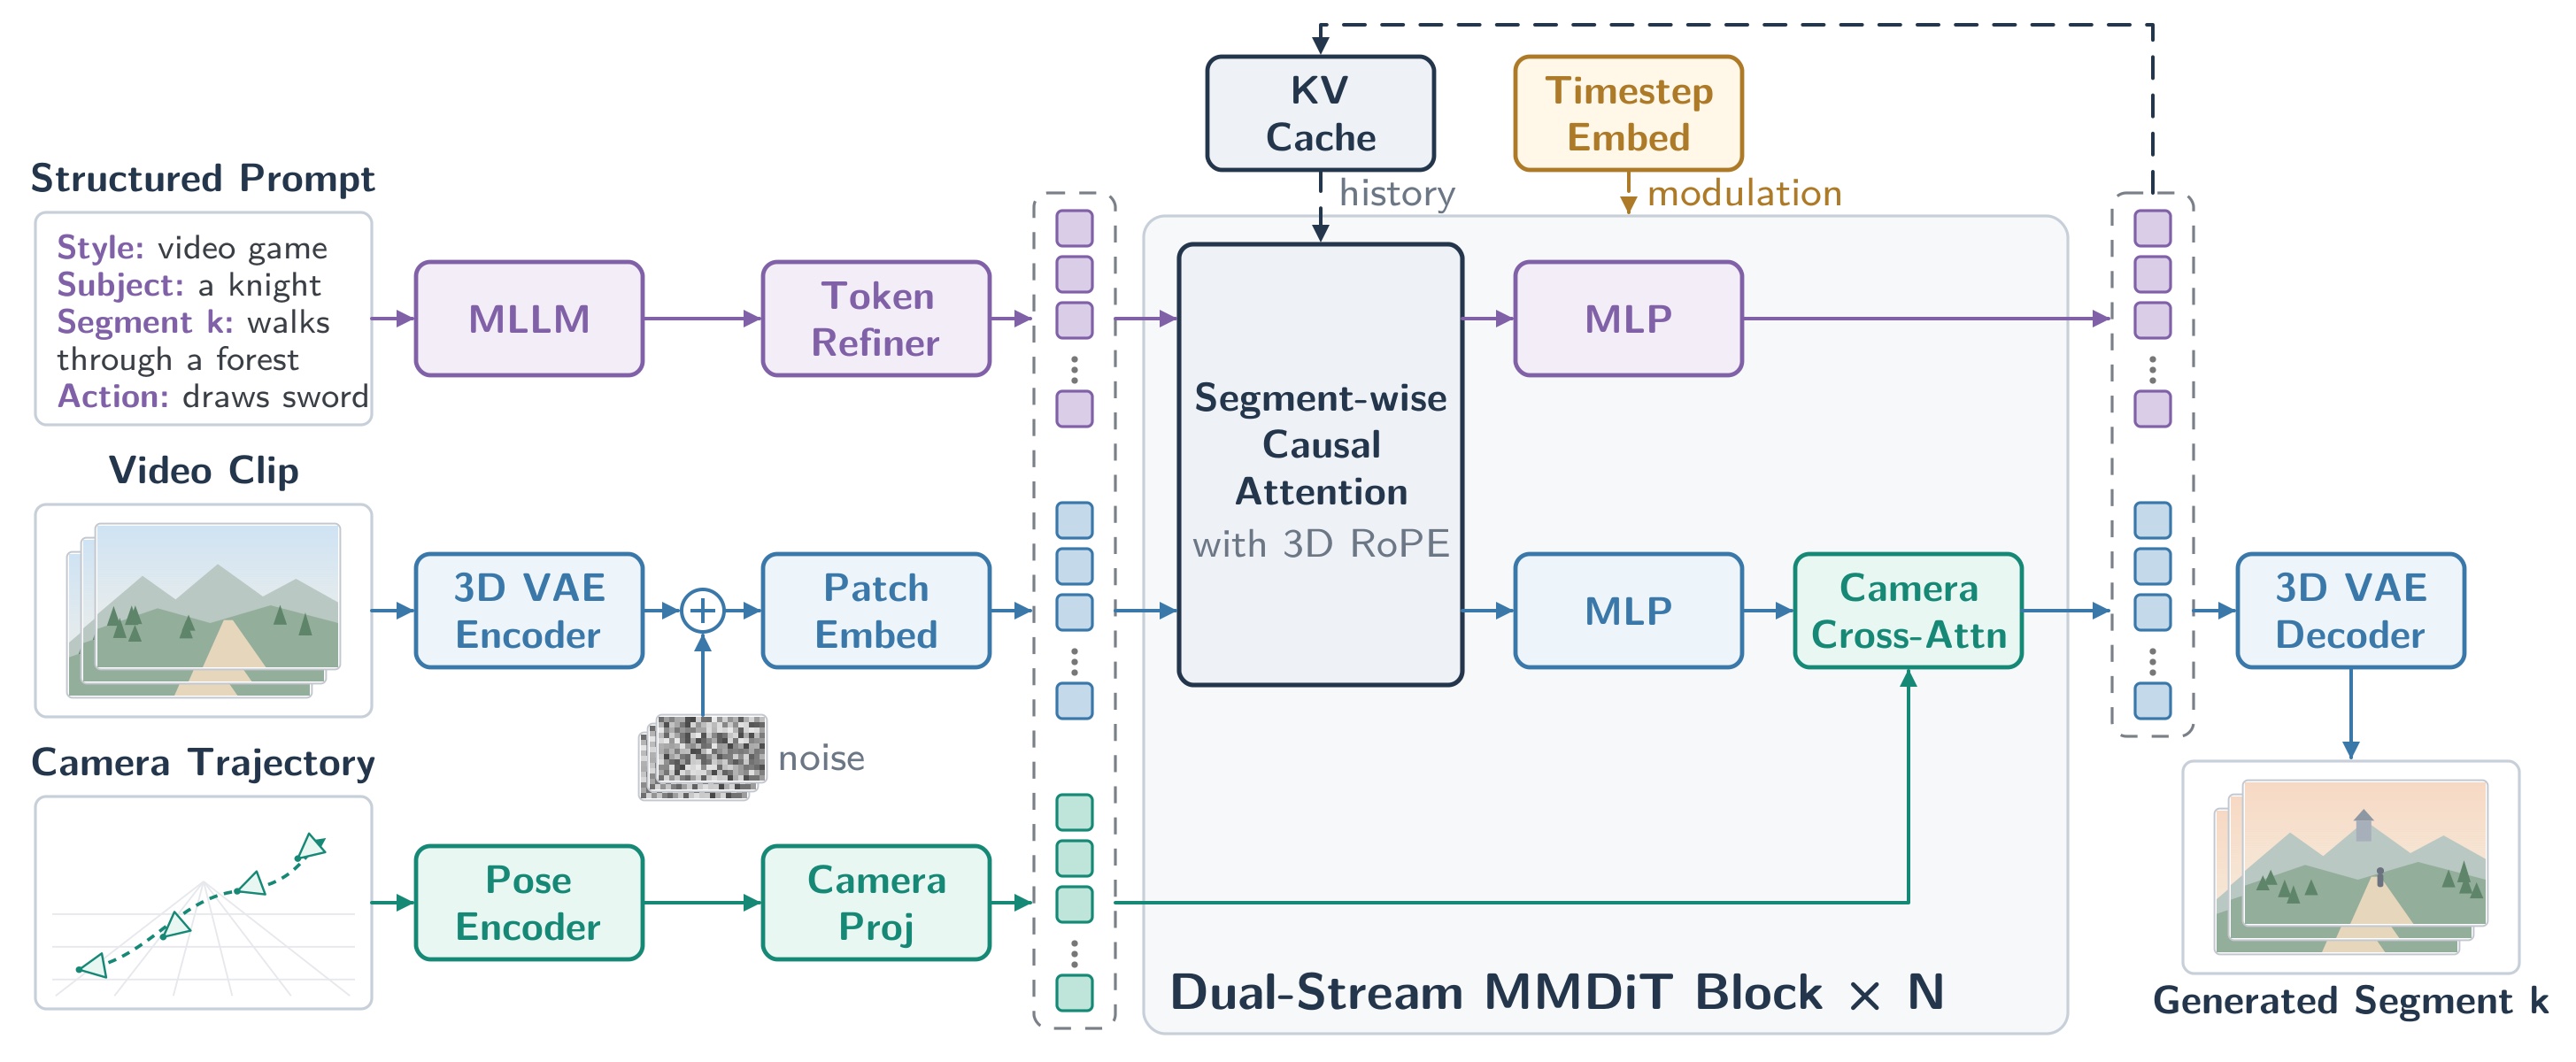
Схема архитектуры из репозитория релиза: текст, латентные представления видео и траектории камеры подаются в двухпоточные блоки MMDiT.
| Свойство | Конфигурация |
|---|---|
| Основа | 54 двухпоточных блока MMDiT, без однопоточных блоков |
| Размер скрытого слоя | 2 048, 16 голов по 128 измерений |
| Feed-forward | Расширение в 4 раза, промежуточный размер 8 192 |
| Латентные представления | 32 канала на входе и выходе, патч 1 × 1 × 1 |
| Кодирование положения | 3D RoPE, размеры [16, 56, 56], theta 256 |
| Текстовое условие | Скрытые состояния Qwen2.5-VL-7B-Instruct размерности 3 584, двухслойный уточнитель токенов |
| Условие камеры | Эмбеддинги внешних параметров через cross-attention в двухпоточных блоках |
| Предсказание | Скорость потока, выборка Euler ODE |
Видео хранится в латентах DCAE-V f32t4c32: 32 канала, 32-кратное пространственное сжатие по каждому направлению и 4-кратное временное сжатие. Декодированием занимается дообученный декодер PixelUMM с 36 слоями, скрытым размером 4 096, 32 головыми запросов и 8 KV-головами, который восстанавливает RGB в 4 × 16 × 16 тьюблетах по временным окнам в 10 латентных кадров с перекрытием в 5 кадров. Это декодирование выполняется за один шаг и отдельно от 8 шагов удаления шума в DiT.
Конфигурация для одной RTX 4090
Эталонная установка распределяет одну группу вывода по восьми GPU с 8-кратным параллелизмом по последовательности и распределённым декодированием. Вторая конфигурация рассчитана на одну RTX 4090, и все изменения касаются управления памятью:
- Веса DiT и закэшированные ключи и значения хранятся в INT8, при этом линейные слои и внимание по-прежнему вычисляются в BF16.
- Декодер PixelUMM работает в FP8 через ядра CUTLASS, а в DiT используется FlexAttention.
- Текстовый энкодер, DiT и декодер перемещаются на GPU для своего этапа и после него выгружаются на CPU.
- История на GPU ограничена 18 историческими латентными кадрами, выбираемыми через
temporal_context, а более старая история архивируется в системной RAM.
Карточка прямо говорит о компромиссах: системная RAM должна вмещать выгруженные модели и растущий архив истории, передача данных с CPU на GPU добавляет задержку, а бюджет истории не ограничивает память для текущего сегмента. Время на сегмент не публикуется, поэтому скорость на 4090 на момент написания не проверена.
Дообучение LoRA и сервис промптов
С релизом поставляются два адаптера. Cinematic LoRA предлагается как опциональный адаптер визуального качества для совместимого DiT с плавающей точкой, а Robotics LoRA обучен на наборе данных роботизированной руки RealSource-World и предназначен для слияния с дистиллированным DiT, чтобы усилить имитацию манипуляций в генерируемом мире. Загрузчик INT8 не может загрузить отдельную LoRA во время вывода, поэтому работа с адаптерами идёт через веса BF16 или FP32.
Репозиторий также содержит путь дообучения: подготовка данных SFT, офлайн-упаковка последовательностей для длинных последовательностей, затем обучение и слияние. Для веб-демо есть одна жёсткая зависимость: Nomas-PE, отдельный сервис, который превращает инструкцию пользователя в структурированный промпт генерации; офлайн-вывод может читать подготовленные файлы промптов и обходиться без него. Готовый Docker-образ (hynomasoss/hynomasoss:cu130) содержит PyTorch, FlashAttention и MagiAttention, что избавляет от ручной сборки ядер CUDA.
Hy-Nomas-Bench
Вместе с моделью команда выпустила Hy-Nomas-Bench — четыре бенчмарка с 280 тестовыми случаями, охватывающими многоходовое свободное текстовое взаимодействие, навигацию камерой, чередующееся управление текстом и камерой, а также пространственную память. Набор данных поставляется со структурированными промптами, последовательностями взаимодействия, таймлайнами клавиатуры и эталонными траекториями камеры, что делает его пригодным для оценки согласованности на длинном сгенерированном прогоне, а не на отдельных клипах.
Доступность
В этом релизе нет нативной поддержки ComfyUI: ни основных нод, ни перепаковки от Comfy-Org. Официальные пути — репозиторий GitHub с Docker-образом и размещённое интерактивное демо.
Для ComfyUI порт от сообщества Nynxz/ComfyUI-HyNomas появился 23 октября с конвертированными весами в nynxz/Hy-Nomas:
| Файл | Папка | Размер |
|---|---|---|
nomas_dit_distilled_int8_convrot.safetensors | models/diffusion_models | 9,0 ГБ, INT8 ConvRot |
nomas_dit_distilled_bf16.safetensors | models/diffusion_models | 17,1 ГБ, база для слияния LoRA |
nomas_pixelumm_vae_bf16.safetensors | models/vae | 15,8 ГБ, декодер PixelUMM плюс энкодер DCAE-V |
Порт загружает DiT через штатную ноду Загрузить модель диффузии, текстовый энкодер через Загрузить CLIP, используя собственный файл ComfyUI qwen_2.5_vl_7b.safetensors с типом qwen_image из Comfy-Org/Qwen-Image_ComfyUI, а декодер через Загрузить VAE, поэтому пользовательские ядра не нужны. Автор порта сообщает о примерно 21 секунде на 3-секундный ход на RTX 5090 с INT8-чекпоинтом при 1280 × 704, плюс около 4 секунд декодирования на окно. Считайте эти цифры измерением одного пользователя на порте, которому был один день, и не путайте их с целевыми показателями официальной конфигурации для 4090.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.