MiniMax H3 Character Swap v1.1: LoRA на 80 МБ с лучшим сходством
Alissonerdx выпускает MiniMax H3 Character Swap v1.1: SVD на 80 МБ с динамическим рангом и лучшим сходством, плюс два воркфлоу ComfyUI, один на нативных узлах.
Это тот же репозиторий, в котором появились LoRA для замены персонажа H3 и живых обоев, где ранее в октябре рассматривалась v1.0; на момент написания у него около 458 лайков и 144 700 загрузок. Каждый адаптер в пакете обучен на весах ref2va модели H3 и использует одну и ту же идею условия: исходный клип подаётся через MiniMaxH3AddGuide как выровненная решётка гайда, а не как свободный видео-референс.
v1.1 не меняет задачу. Это та же замена тела под управлением гайда с триггером body_swap:, и весь релиз посвящён одной жалобе на v1.0: заменённый персонаж выглядел недостаточно похоже на референсное изображение.
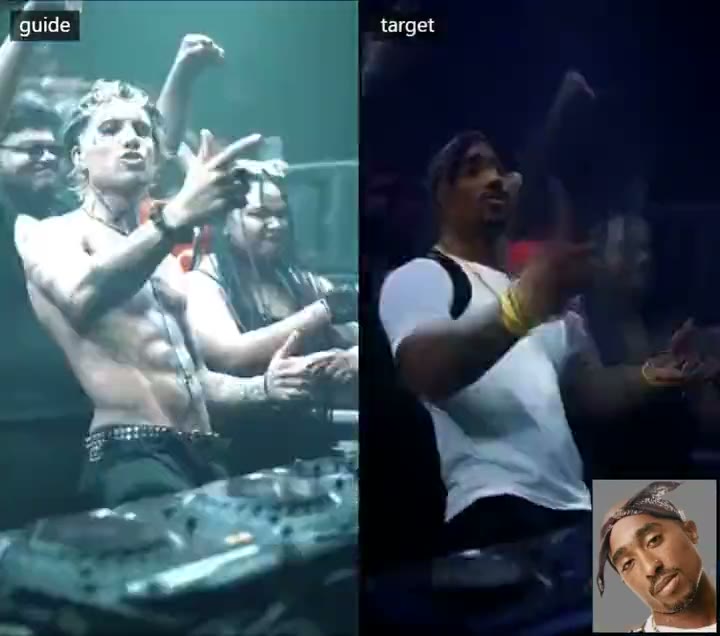
Кадр из сравнительного клипа гайда и цели в тестах v1.1 автора.
Что изменилось в v1.1
Автор не обучал новый адаптер для этого релиза. v1.1 представляет собой SVD-извлечение на 80 МБ из обучающего прогона v1.1, с динамическим рангом, выбираемым для каждого слоя по анализу энергии Фробениуса: каждый из 208 слоёв сохраняет минимальный ранг, удерживающий 95% собственной энергии, что даёт значения от ранга 4 до ранга 34 при медиане 7. Благодаря этому файл примерно в восемь раз меньше checkpoint ранга 64 из v1.0, но при этом лучше по сходству: референс точнее переносится на лицо, волосы, тело и одежду, а гайд по-прежнему задаёт сцену, камеру и игру.
| Checkpoint | Размер | Что это |
|---|---|---|
minimax_h3_character_swap_v1.1_ref2va_fro | 80 МБ | Динамический ранг по слоям (от 4 до 34, медиана 7), рекомендуемый релиз |
minimax_h3_character_swap_v1.0_ref2va_r64_gl | 620 МБ | Ранг 64, предыдущий релиз, сохранён для сравнения бок о бок |
Гайд требует strength 1.0, это же правило автор использует при публикации: LoRA, которая не работает при 1.0, не выпускается.
Автор опубликовал три сравнения рангов, пока релиз ещё был в процессе. Первое использует ранги, извлечённые анализом энергии, второе смешивает две стадии обучения, питающие v1.1, третье: полное сравнение гайда и цели.
Извлечение рангов по энергии Фробениуса: схема, которая вошла в v1.1.
Тест со смешанными рангами, объединяющий обе стадии обучения, лежащие в основе v1.1.
Сравнение бок о бок: гайд и клип после замены.
Два рабочих процесса v1.1
v1.1 поставляется с новой парой графов, и выбор между ними в основном зависит от длины клипа.
| Рабочий процесс | Что используется |
|---|---|
| Shot Planner | ComfyUI-BFSNodes 1.113.0 или новее. Длинные видео делятся на шоты, каждый шот рендерится и соединяется, референсы и {details} описываются в планировщике, а граф строит сравнение бок о бок. |
| Только нативные узлы | Generate Text смотрит на референсное изображение и пишет полный промпт, затем MiniMax H3 Reference to Video и Add Guide рендерят один клип. Пакет узлов сообщества не нужен. |
Оба работают за 8 шагов с DMD turbo LoRA, и у обоих есть опциональный второй проход, который добавляет LoRA резкости LMS и латентный апскейлер при 1280×704. Каждый рабочий процесс содержит заметку со ссылкой на скачивание каждой загружаемой модели, а загрузчики моделей сохраняют имена папок, с которыми были сохранены, поэтому каждый загрузчик нужно выбрать заново, если ваши файлы лежат в другом месте.
Шаблон промпта
Описание персонажа решает, сколько от референса сохранится. Гайд теперь поставляется с фиксированным шаблоном: используйте его в одну строку и заменяйте только {details} на описание референсного персонажа через запятую, начиная с указания пола.
body_swap: subject_definitions: <Subject 1> is the {details} shown in <Picture 1>, whose identity, face, head, hair or fur, skin, body shape, proportions and clothing define the character in the target video. The guide video provides the scene and the performance: its background, environment, lighting, camera, framing, body pose, hand and arm movement, head rotation, gaze direction, lip movement and facial expression, frame by frame; only the main subject of the guide video is replaced: its face, hair, body and clothing become <Subject 1>. summary: [video generation + reference] Replace the guide subject with <Subject 1>, keeping the scene, camera and the complete motion and performance of the guide video. detailed_description: [Shot 1] <Subject 1> takes the exact place of the guide subject and moves with the same timing, body pose, gestures, head motion, gaze, speech and facial expressions, while keeping the complete identity from <Picture 1>: facial structure, hair or fur, skin, body shape and clothing stay stable in every frame. The background, lighting, colors and camera of the guide video are preserved. Prevent identity drift, clothing changes, texture crawling and flicker.{details} предназначен для описания с головы до ног: пол, рост и телосложение, форма лица и тон кожи, волосы, верхняя и нижняя одежда с цветами и материалами, обувь, аксессуары и отличительные черты вроде татуировок, шрамов или морщин. Гайд запрещает описывать в этом слоте фон, камеру или освещение.
Есть два способа заполнить его автоматически. В Shot Planner {details} остаётся в промпте, а действие Describe refs на панели пишет описание каждого референса, либо языковая модель пишет его при запуске рабочего процесса. В нативном рабочем процессе Generate Text получает референсное изображение и инструкцию, возвращающую полный промпт, и гайд рекомендует установить max_length около 768, чтобы конец промпта не обрезался.
Доступность
Поместите LoRA в ComfyUI/models/loras/, загрузите один из рабочих процессов v1.1 и проверьте заметку внутри графа на предмет ожидаемых моделей. Опубликованная конфигурация загружает диффузионную модель H3 ref2va (pruned-сборку int8_convrot в примере автора), текстовый энкодер H3, VAE для видео и аудио и DMD turbo LoRA на 8 шагов. Опциональная vision-language модель qwen3.5_9b_w4a8_gptq используется только для описания референса.
Порядок входов важен. Отправьте оригинальный клип в MiniMaxH3AddGuide при frame_idx = 0, так как LoRA обучалась на латентах гайда, а изображение персонажа отправьте через нативный путь референса изображения H3 как <Picture 1>. Держите соотношение сторон и количество кадров выходного видео согласованными с гайдом, используя количество кадров H3 по формуле 17n + 5 (5, 22, 39, 56, 73, 90, 107, 124 и так далее), и тестируйте на коротком диапазоне, прежде чем запускать длинный клип.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.