LoRA H3 Anti-Burn против выгорания лиц в цепочках клипов MiniMax H3
LoRA ранга 32 для клипов-продолжений MiniMax H3 снижает выгорание лиц с +44% до 0% на цепочках lightx2v с 8 шагами и с +61% до +4% на невидимой turbo-модели.
diffusion_model.*), поэтому пользовательская нода не нужна.
Какую проблему он решает
Длинное видео H3 обычно собирают цепочкой: клип 2 продолжает последние кадры клипа 1, клип 3 продолжает клип 2 и так далее. Каждое продолжение копирует полученную концовку и добавляет немного собственной ошибки. После нескольких клипов лица выгорают: кожа и линии становятся грубыми и «протравленными», а весь кадр жёстче.
LoRA загружается только на проходах-продолжениях и удерживает их близко к виду первого клипа, который генерируется обычным образом. Для клипа 1 она не предназначена: там нечему выгорать.
Как её использовать
- Загружайте её через
LoraLoaderModelOnlyна модель, которая рендерит только клипы-продолжения: со второго клипа и далее. - Начните с силы 0.5. Повышайте, если лица всё ещё становятся грубее от клипа к клипу, понижайте, если лица становятся мягкими или восковыми.
- Сила зависит от turbo-модели и от пайплайна. Слияние LoRA с 8-битным чекпойнтом ослабляет её, поэтому рекомендуется перебрать несколько значений на цепочке из 4–5 клипов, прежде чем останавливаться.
Что измеряли
Цепочки из 10 клипов, каждый длиной около 37 секунд, на четырёх сценах (кухня, та же кухня с другим сидом, парк и крыльцо), с усреднением по всем цепочкам для каждой настройки. «Выгорание лица» это то, насколько изменилась мелкая текстура лица между клипом 1 и клипом 10: ноль означает, что клип 10 так же чист, как клип 1, положительное значение означает выгорание, отрицательное значит, что лицо стало мягче, чем в клипе 1.
| Turbo | Без LoRA | 0.4 | 0.5 | 0.6 | 0.8 |
|---|---|---|---|---|---|
| Невидимая модель (не участвовала в обучении) | +61% | +29% | +4% | −13% | |
| HyperFlow, 8 шагов | +25% | +4% | −1% | −14% | |
| lightx2v 8-step v1.0 768p | +44% | +14% | 0% | −7% | −37% |
| Larry Turbo v4 (шаг 600 EMA) | +261% | +212% | +159% | +57% |
Столбец с невидимой моделью важнее всего: LoRA обучалась на Larry Turbo v4, HyperFlow и lightx2v, и всё же удержала четвёртую turbo-модель, которую никогда не видела, на +4% при 0.6.
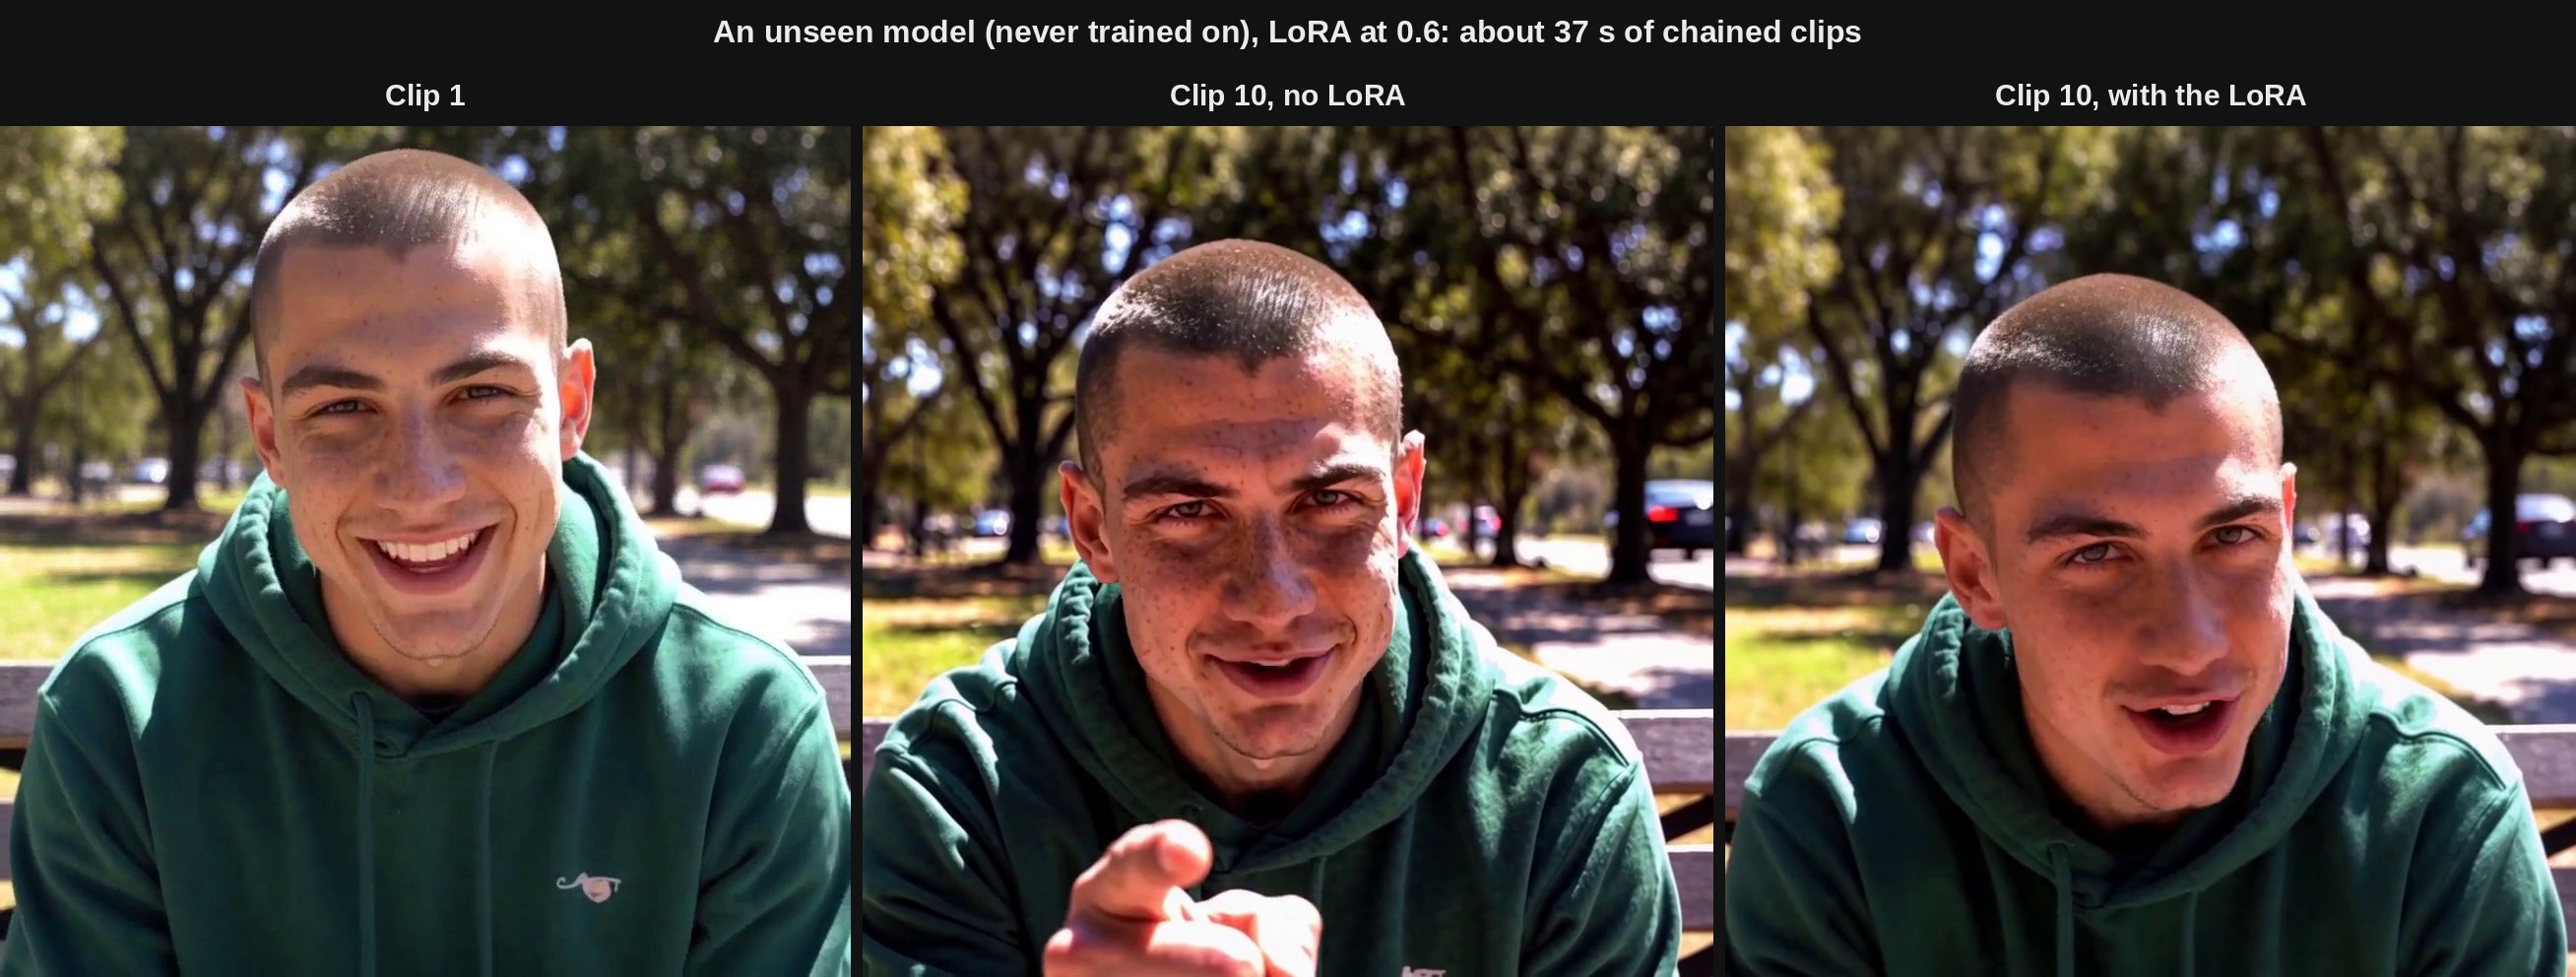
Turbo-модель, на которой LoRA никогда не обучалась. Клип 1, затем клип 10 без LoRA, затем клип 10 с ней при 0.6. В этой сцене выгорание лица падает с +51% до −4%.
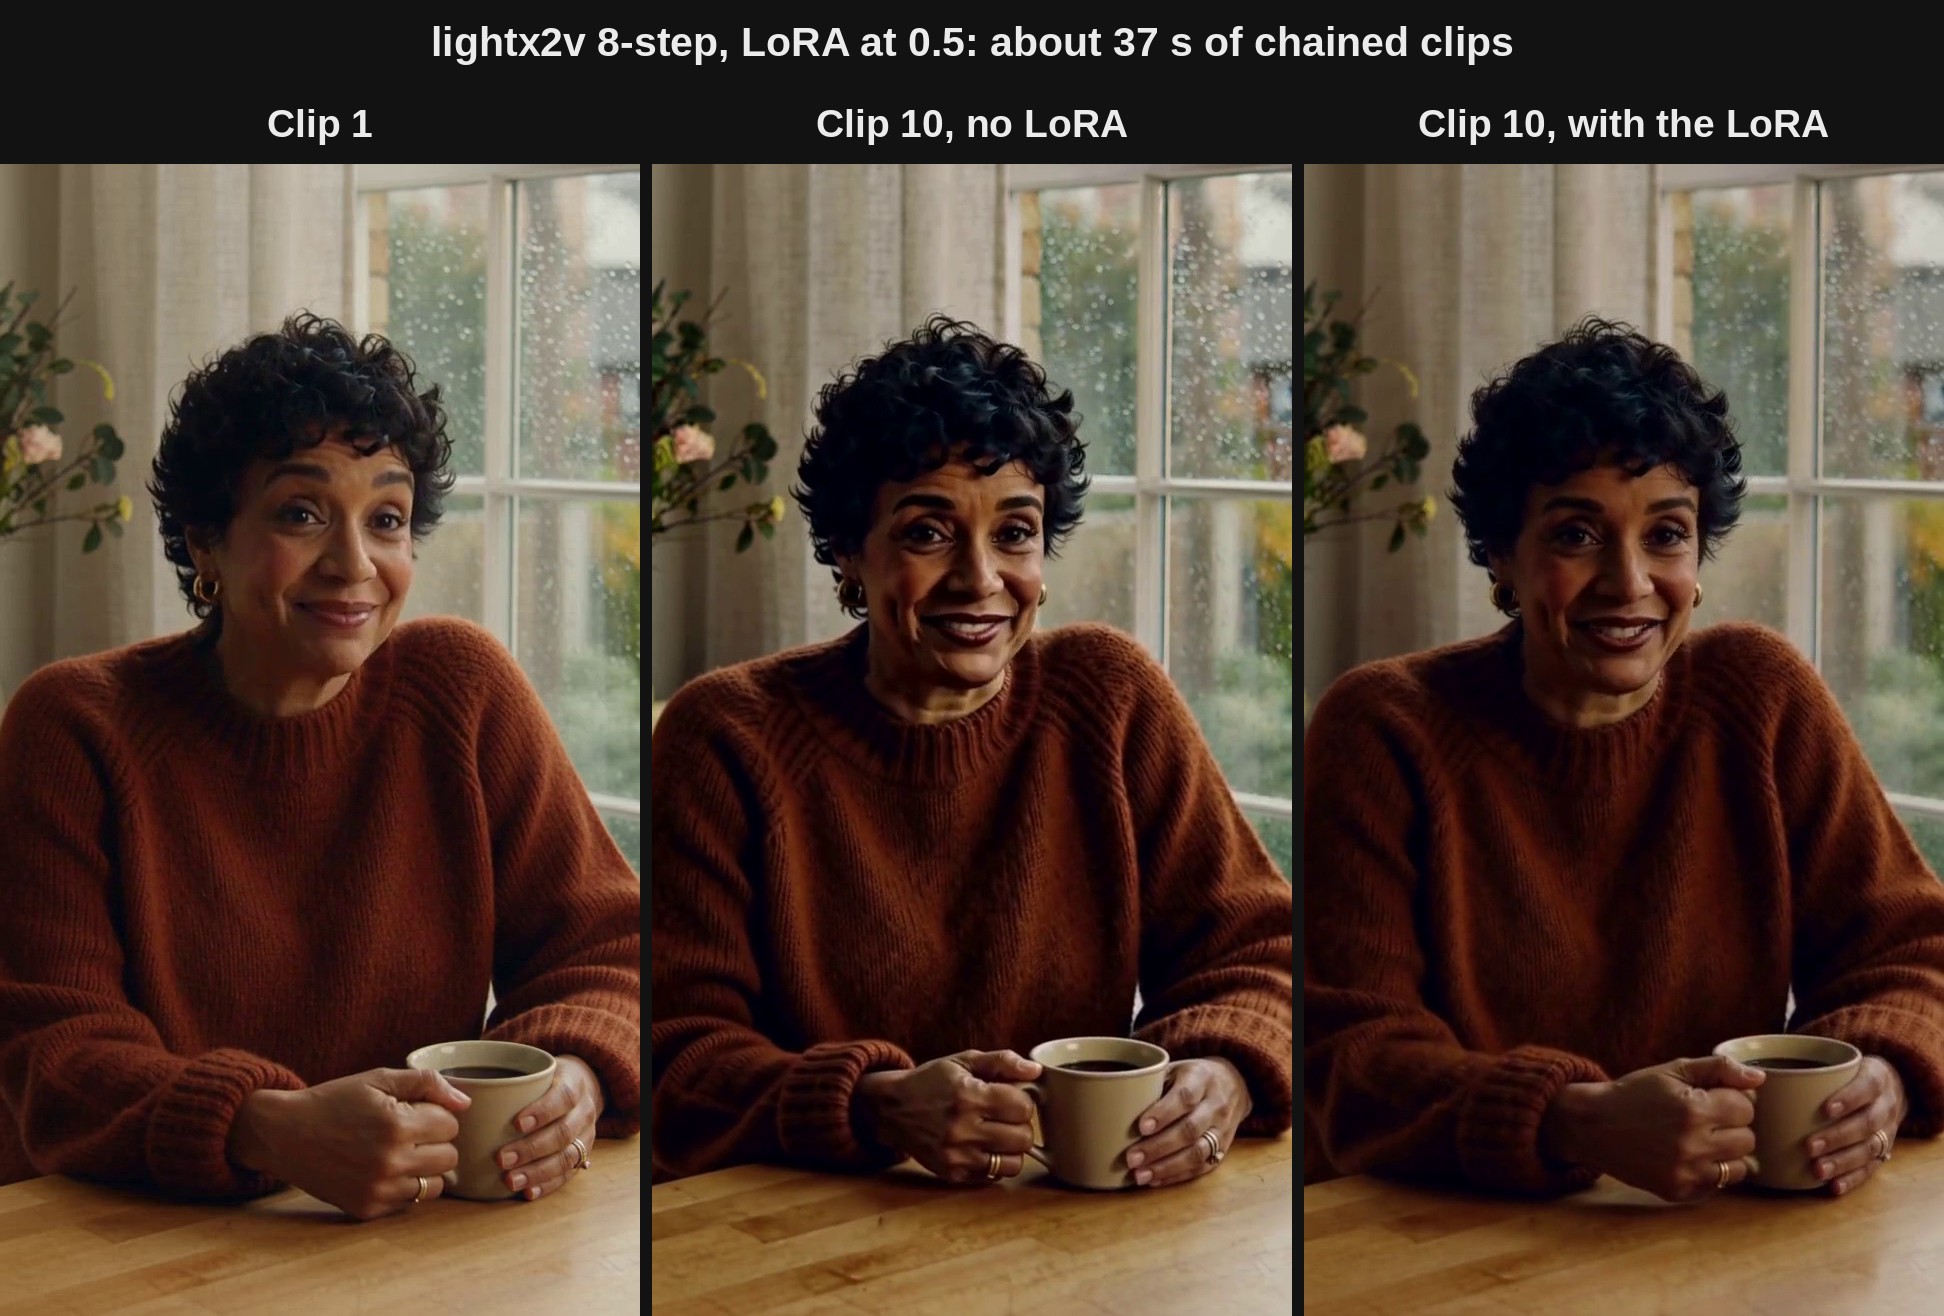
lightx2v 8-step v1.0 768p на сцене с кухней: +52% без LoRA, +6% с ней при 0.5.
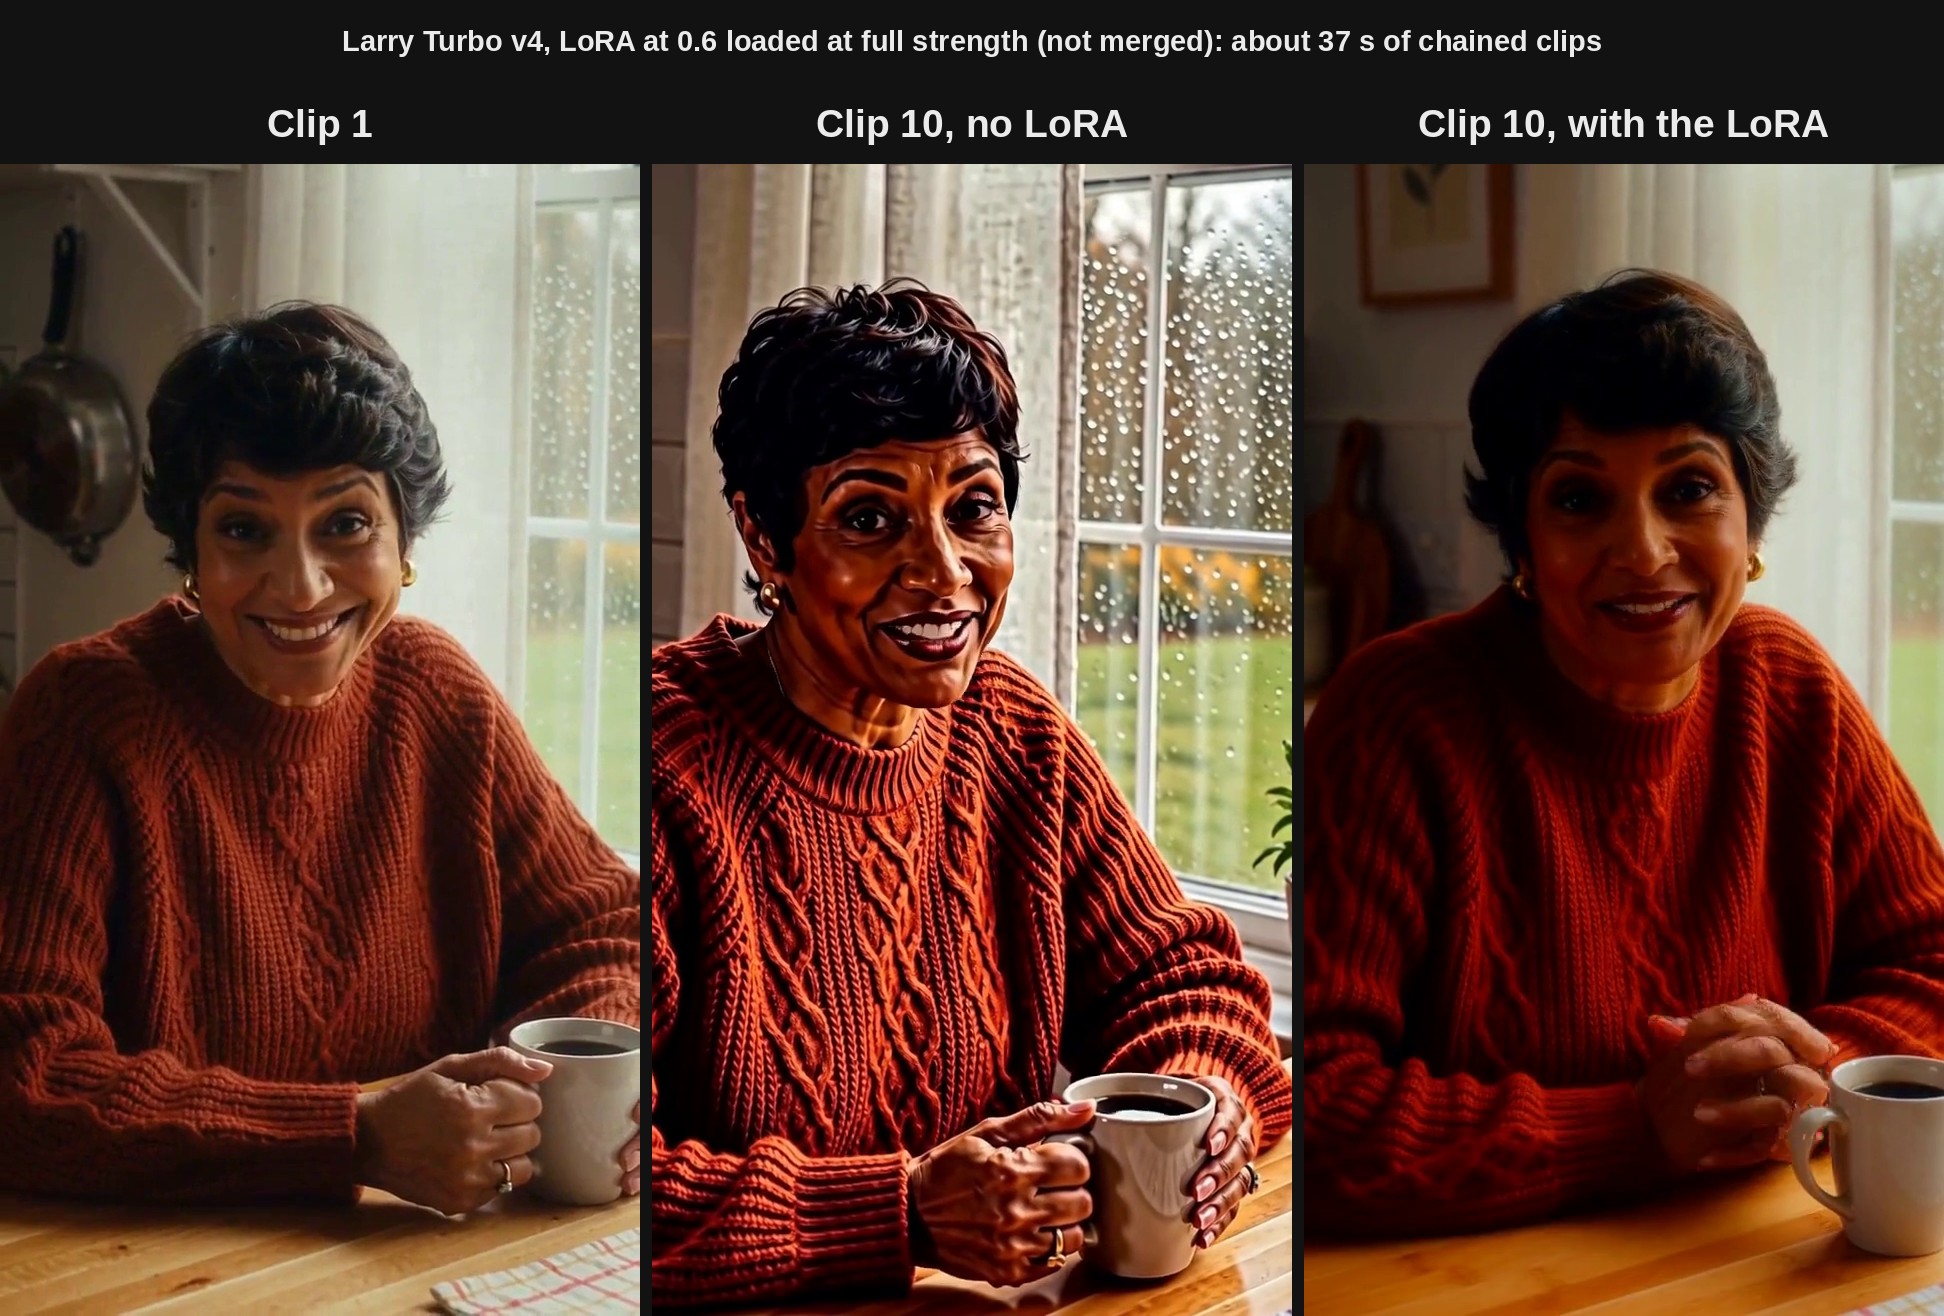
Larry Turbo v4, самый сильный источник выгорания в тесте: +189% без LoRA, −15% с ней при 0.6, загруженной на полной силе. Larry всё равно смягчает изображение и уводит его в более тёплые и тёмные тона.
Larry требует больше 0.8 при слиянии. При 1.0 выгорание лица исчезло (−19%, две цепочки), но кадрирование камеры начало меняться; при загрузке на полной силе вместо слияния 0.6 снизила показатель с +261% до −5%.
Насыщенность, краснота кожи и липсинк остаются такими же, как без LoRA. Мелкая детализация слегка падает: на 4–14% ниже клипа 1 против 3–18% выше него без LoRA. Слишком большая сила видна по мягким, восковым лицам.
Настройки, стоящие за этими цифрами
- Чекпойнты MiniMax H3, обрезанные (pruned) методом int8 ConvRot в ComfyUI, из Comfy-Org/MiniMax-H3; клип 1 использует
fl2va, продолжения используютref2va. - LoRA сливается через
LoraLoaderModelOnlyперед turbo-LoRA. - Каждое продолжение несёт последние 39 кадров предыдущего клипа и их аудио как защищённый маскированный контекст.
- 8 шагов, CFG 1, при 640×1152, 1152×640 и 864×864.
Другие чекпойнты (bf16, fp8, GGUF), другое число шагов и другие способы продолжения потребуют другой силы.
Ограничения
Карточка прямо говорит о границах применимости. Четыре сцены на настройку это небольшой тест, и одна цепочка из 10 клипов может давать разброс ±15 пунктов. LoRA предотвращает выгорание, но не восстанавливает уже выгоревшее видео. Её тестировали только на продолжениях из маскированного контекста, не на других способах продления видео, и только на говорящих людях с лицами на среднем и близком расстоянии.
Как её обучали
Обучение построено на самодистилляции траекторий. Автор записал, что каждая turbo-модель реально делает при свежей генерации в 8 шагов: всего 150 прогонов полного размера, по 50 от Larry, HyperFlow и lightx2v. Затем LoRA обучалась в режиме продолжения, где начало того же видео закреплено как защищённый контекст, а цель это собственный свежий прогон turbo-модели, так что продолжение учится выглядеть как свежая генерация, а не усиливать то, что было в его контексте. Синтетического выгорания и лосса на свежем шуме не было; более ранние версии, где они использовались, смягчали всё.
Настройки запуска: 300 шагов, ранг 32, скорость обучения 1e-4, вес сети 0.6, разрешение 864, 124 кадра, на одной RTX PRO 6000.
Доступность
Адаптер это h3_antiburn_universal_v1.safetensors в репозитории Hugging Face: 416 тензоров, bf16, покрывает слои внимания и MLP в 50 блоках DiT и 2 блоках token-refiner, без adaLN. Положите его в ComfyUI/models/loras/. Код обучения, конфиги, а также скрипты записи и оценки лежат в ветке h3-antiburn форка ai-toolkit.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.