SMD: 4-шаговая дистилляция для изображений, видео, 3D и MiniMax H3
SMD это рецепт дистилляции только на регрессии для генерации в 4 шага: студенты для FLUX, Qwen-Image, Wan2.1, MiniMax H3 и 3D, плюс workflow ComfyUI для H3.
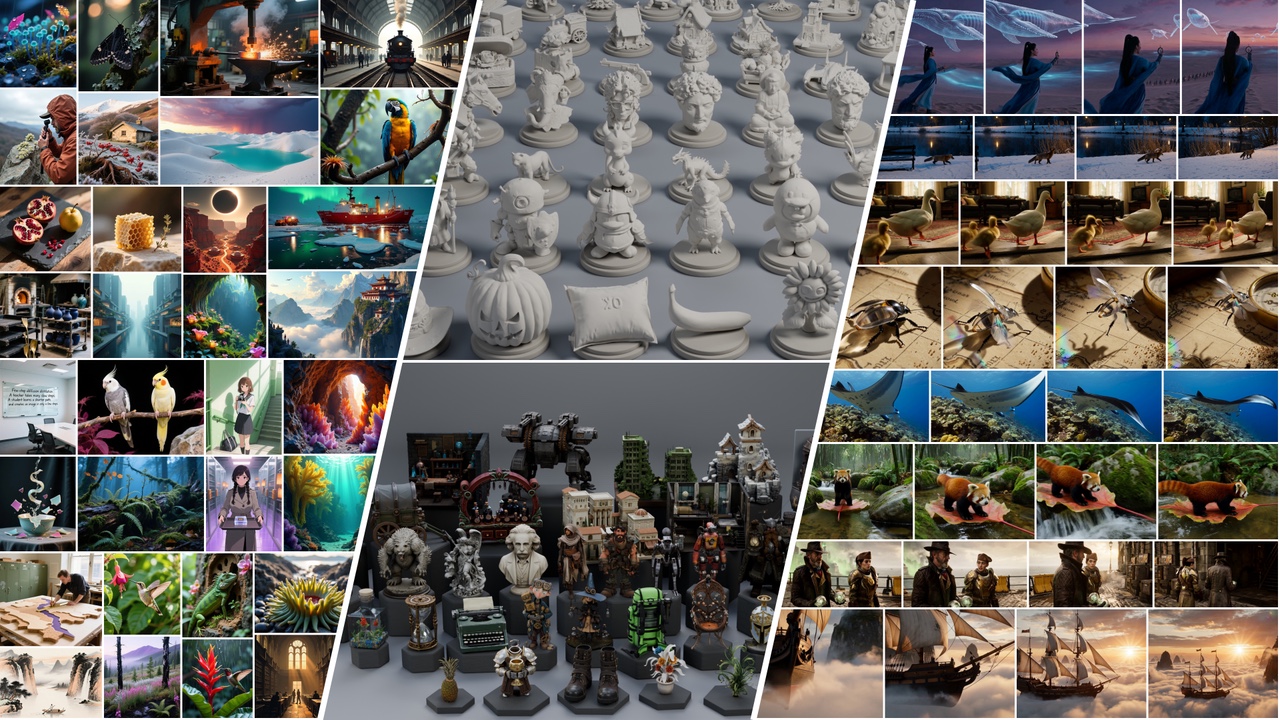
Выходы выпущенных студентов SMD: генерация и редактирование изображений, 3D-ассеты и видео с синхронизированным аудио.
Что меняет SMD
SMD начинается с обычной on-policy регрессии скорости: студент обучается на собственной траектории, а не на образцах учителя. Остальную часть метода составляют два дополнения. Pivot это прокси-остаток, используемый только при обучении, который отделяет локальные поправки, вносимые учителем внутри грубого перехода, от собственного предсказания интервального среднего у студента, так что 4-шаговый студент может выразить вариацию скорости учителя, которую не смог бы представить сам. Второе: член отталкивания, который отводит студента от более слабых предсказаний учителя; в статье это описано как лёгкий способ избежать нежелательных мод.
В вывод ничего не добавляется: нет онлайн-оценки score, нет модели фиктивного score, нет состязательного дискриминатора, а развёрнутый генератор сохраняет свою архитектуру. Именно это позволяет выпустить один и тот же метод и как LoRA поверх существующего checkpoint, и как полный denoiser в одном релизе. В статье сообщается о масштабировании до 33 миллиардов параметров и о поддержке кросс-модельной, мульти-учительской дистилляции и дистилляции причинного видео.
Что было выпущено
| Задача | Студенты | Формат |
|---|---|---|
| Текст в изображение | FLUX.1-dev, Qwen-Image, SD3.5-Medium, FLUX.2 Klein 4B, Lens | LoRA, SD3.5 дополнительно как полный transformer |
| Редактирование изображений | Qwen-Image-Edit-2511 | LoRA |
| Текст в видео | Wan2.1 1.3B, Wan2.1 14B, причинный Wan2.1 1.3B | LoRA |
| Аудио-видео | MiniMax H3 T2VA 4-step и 8-step, H3 Ref2VA 4-step и 8-step | адаптеры LoRA |
| Изображение в 3D | Hunyuan3D-2.1 Shape, TRELLIS.2 shape и texture | LoRA для каждой дистиллируемой стадии |
Две боковые ветви выходят за рамки дистилляции с одним учителем. FLUX.2 9B используется как учитель и для Klein 4B, и для Lens, а SD3.5-Medium поставляется в шести вариантах: self, clipscore, geneval, ocr, pickscore и multi, где каждый специалист оптимизирует свою награду.
Каждый репозиторий в коллекции содержит веса плюс разобранный пример с его промптом или референсными входами, seed и настройками выборки. Пакетам LoRA нужна соответствующая базовая модель и ревизия, а полный transformer по-прежнему берёт свои энкодеры и декодеры из базовой модели.
Примеры по всему релизу
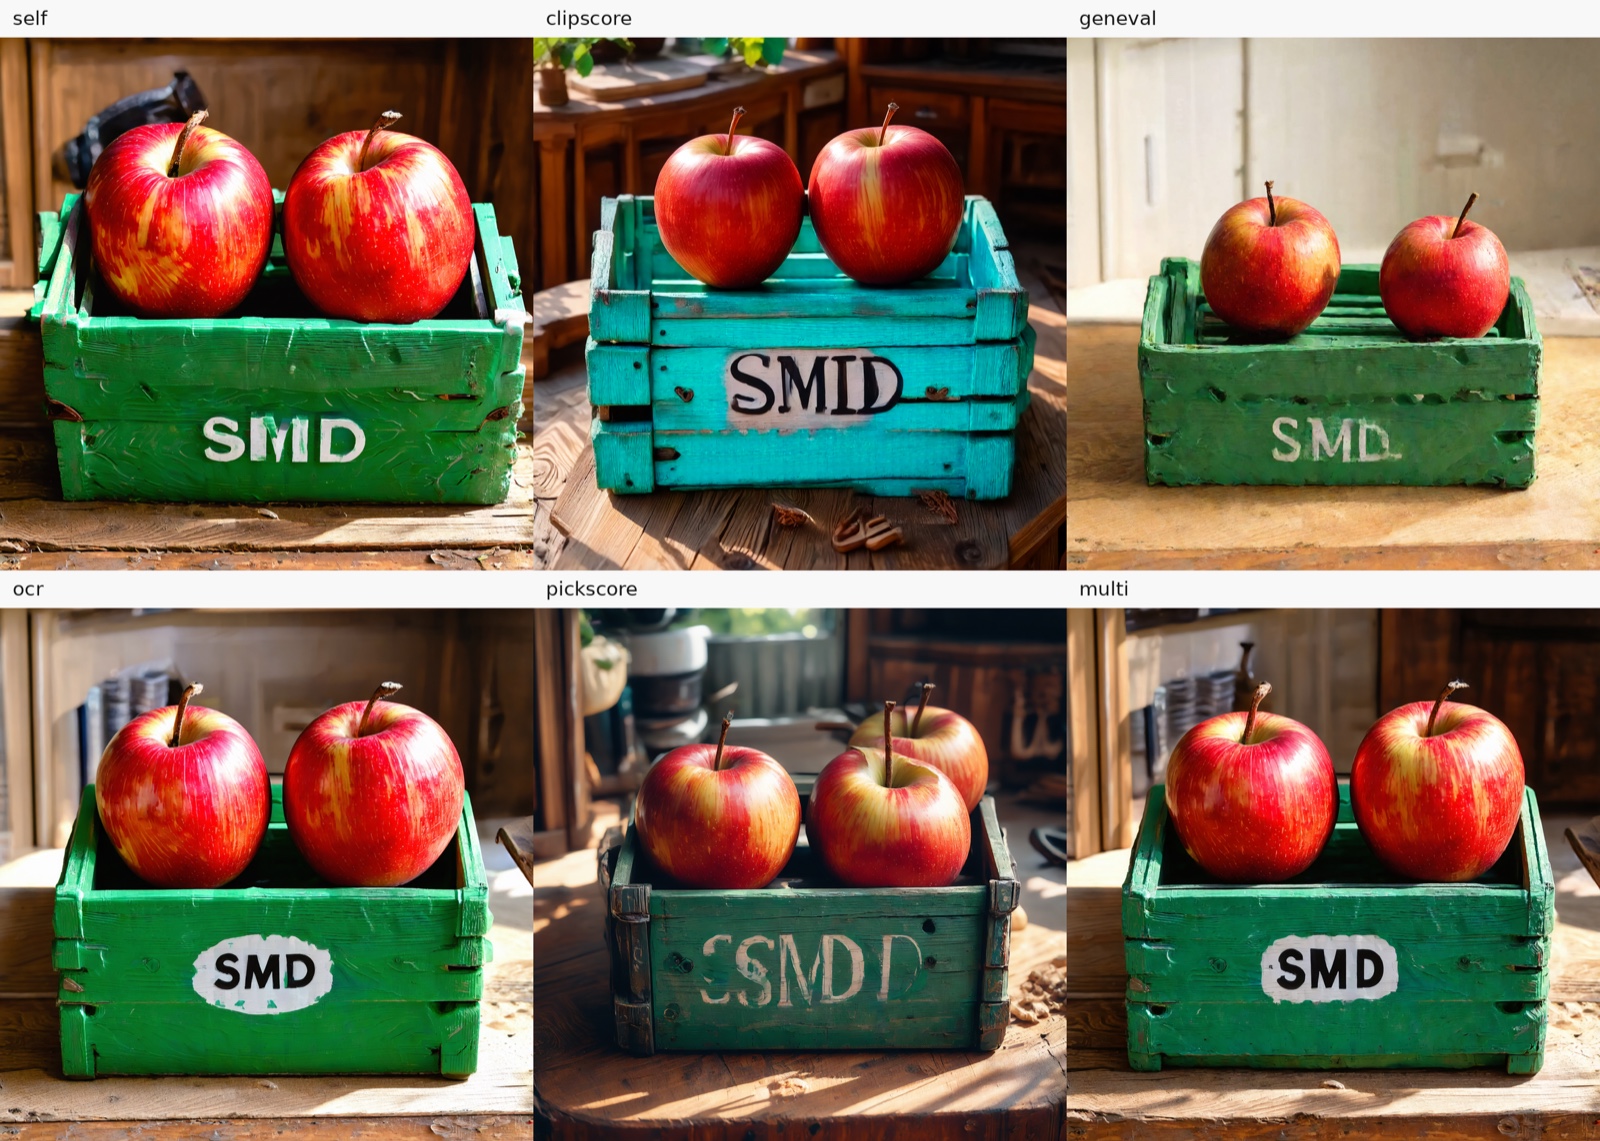
Шесть студентов SD3.5-Medium в сравнении друг с другом, включая мульти-учительский вариант multi.
Студенты для изображений используют по четыре шага выборки, и карточки моделей показывают настройки, которые их дали: холщовая сумка-тоут для FLUX.1-dev, послеполуденный чай для Qwen-Image, пара «источник и отредактированное» для Qwen-Image-Edit-2511 и сравнения с двумя учителями для FLUX.2 Klein 4B и Lens. Видео работает на четырёх шагах на Wan2.1 14B и на причинной модели 1.3B, а для 3D поставляются четырёхшаговые LoRA для Hunyuan3D-2.1 Shape и для обеих стадий TRELLIS.2, с видео с вращением для каждой.
MiniMax H3 в ComfyUI
У четырёх студентов H3 есть собственные пакеты, которые работают на стандартных узлах ComfyUI, без пользовательского пакета узлов и без клонирования обучающего репозитория SMD:
| Пакет | Шаги | Пример клипа |
|---|---|---|
| SMD-MiniMax-H3-T2VA-4step-ComfyUI | 4 | текст в аудио-видео |
| SMD-MiniMax-H3-T2VA-8step-ComfyUI | 8 | текст в аудио-видео |
| SMD-MiniMax-H3-Ref2VA-4step-ComfyUI | 4 | референсные изображения в аудио-видео |
| SMD-MiniMax-H3-Ref2VA-8step-ComfyUI | 8 | референсные изображения в аудио-видео |
Каждый пакет содержит конвертированную LoRA, полный рабочий процесс и примеры входов. Его download_models.py проверяет файлы моделей, копирует примеры входов и добавляет рабочий процесс в пользовательскую библиотеку ComfyUI по умолчанию, так что он появляется под SMD в боковой панели Workflows; JSON рабочего процесса также можно перетащить на холст. Графы с референсным кондиционированием используют UNETLoader, LoraLoaderModelOnly, MiniMaxH3SigmaShift, MiniMaxH3ReferenceToVideo и ManualSigmas, поэтому работу выполняет LoRA, а расписание выборки задаётся пакетом. Переключение между 4 и 8 шагами означает открытие рабочего процесса и LoRA соответствующего пакета.
Пятисекундный дубль H3 reference-to-audio-video из 4-шагового пакета Ref2VA, сгенерированный с двумя референсными изображениями, поставляемыми в репозитории.
Пакеты предупреждают об одной ловушке: подстановка весов H3 в стандартный шаблон изображения ComfyUI может завершиться ошибкой об отсутствующем audio_scale, поэтому вместо этого следует использовать полный рабочий процесс из пакета.
Обучение собственного студента
Код обучения находится в том же репозитории, что и примеры вывода. Он работает на Linux x86_64 с Conda: environments/setup_conda.sh создаёт окружение с Python 3.12, PyTorch 2.7.1 и колёсами CUDA 12.6, а FlashAttention компилируется из исходников. Запуск это вызов torchrun с одним из обучающих конфигов и путём к данным, например два GPU с Parquet-файлом, содержащим столбец prompt для Qwen-Image, а --download-resources загружает то, что нужно конфигу.
Обучение опирается на NVIDIA FastGen для инфраструктуры обучения и использует реализации моделей из Hugging Face Diffusers; путь экспорта H3 записывает адаптер LoRA вместе с его метаданными выборки, поэтому объединённый базовый checkpoint не нужен. Репозиторий также поставляет навыки агента для настройки окружения, обучения и вывода, а также для подключения новой модели.
Ограничения
- Число шагов и заявления о качестве принадлежат авторам: при 4 NFE сообщается, что SMD превосходит сильные малошаговые базовые решения и обходит многошаговых учителей на нескольких бенчмарках. Эти числа взяты из статьи, а не из независимого воспроизведения здесь.
- Дистиллированные студенты привязаны к базовым ревизиям и настройкам выборки в своём пакете. Студенты H3, в частности, это адаптеры LoRA с кэшированными условиями.
- Обучающий репозиторий рассчитан на Linux с Conda и драйвером NVIDIA с поддержкой CUDA 12.6; стадиям 3D нужно второе окружение.
- Среди выпущенных студентов два пакета H3 с референсным кондиционированием пока имеют больше всего загрузок (около 1 500 и 1 200 на момент написания), тогда как репозитории для изображений и 3D всё ещё остаются в однозначных или двузначных числах.
Доступность
Код: zjwfufu/SMD
Страница проекта: zjwfufu.github.io/SMD-Page
Статья: arXiv 2610.18472
Веса: коллекция Hugging Face
Датасеты: zjwfufu/smd-data
Пакеты H3: T2VA 4-step · T2VA 8-step · Ref2VA 4-step · Ref2VA 8-step
Базовая модель: MiniMax H3
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.