LightX2V Lightning: 4-шаговый LoRA для Qwen-Image 2.1
LightX2V публикует 4-шаговый LoRA Lightning, дистиллированный методом DMD, для Qwen-Image 2.1: генерация по тексту и редактирование с несколькими референсами.
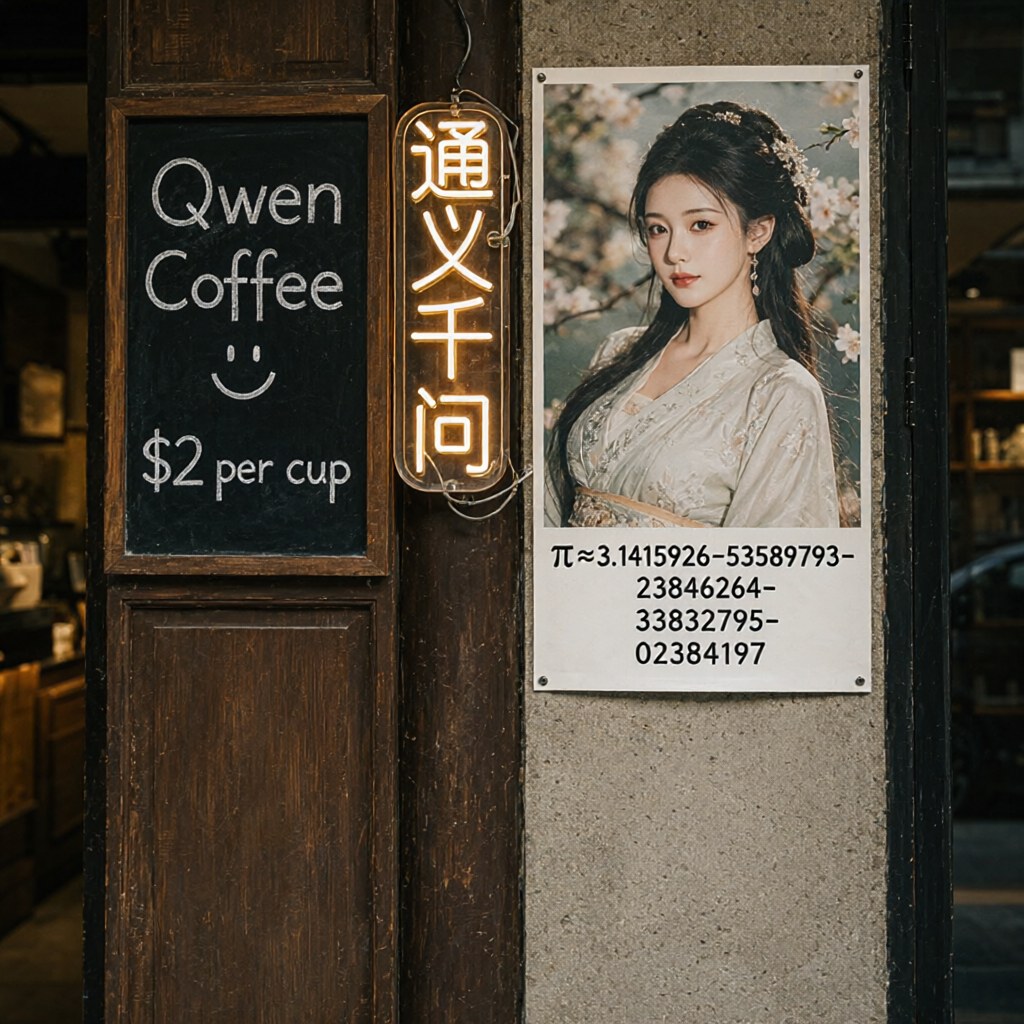
Витрина кофейни, сгенерированная Lightning LoRA за 4 шага, с фиксированными текстовыми эмбеддингами базовой модели и тем же seed.
Что меняет LoRA
Qwen-Image 2.1 по умолчанию генерирует за 40 шагов. Адаптер Lightning сокращает это до четырёх, при этом расписание задаётся прямо в вызове сэмплера:
pipe.scheduler = FlowMatchEulerDiscreteScheduler.from_config(
    pipe.scheduler.config, shift_terminal=None
)

image = pipe(
    prompt=prompt,
    width=1024,
    height=1024,
    num_inference_steps=4,
    sigmas=[1.0, 0.75, 0.5, 0.25],
    true_cfg_scale=1.0,
    use_kv_cache=False,
).images[0]
CFG отключён (true_cfg_scale=1.0), а четыре значения сигм фиксированы, поэтому от обычного рабочего процесса Qwen-Image 2.1 отличаются только загрузка LoRA и переключение сэмплера на конфигурацию из 4 шагов без CFG.
Четыре шага против сорока
Карточка модели содержит пять сравнений text-to-image с одинаковыми промптами, seed и размерами выхода, при этом CFG отключён для обеих сторон. Изображения базовой модели взяты из более раннего запуска на 40 шагов.
| Базовая модель, 40 шагов | Lightning LoRA, 4 шага |
|---|---|
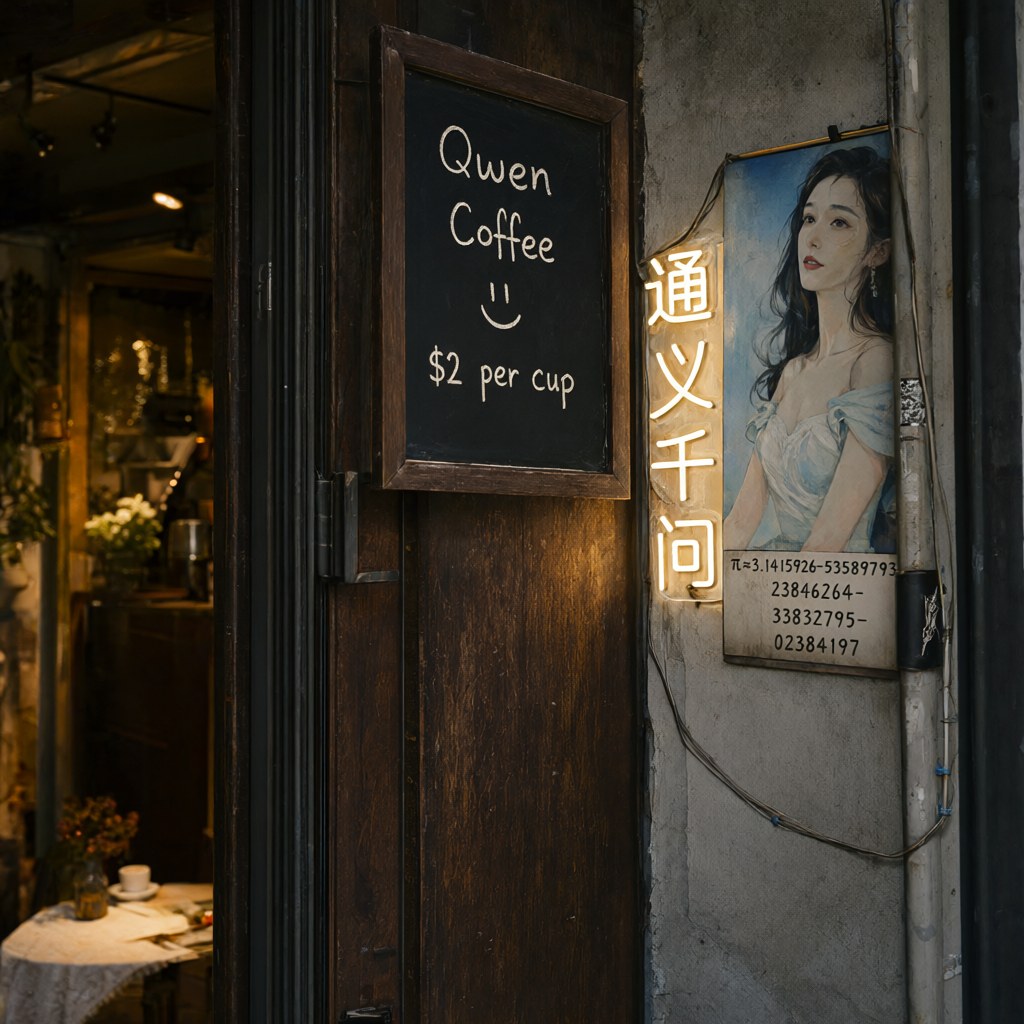 | |
| Вывеска кофейни | Вывеска кофейни |
Остальные примеры в репозитории охватывают девятиголового лиса-зверя, дизайнерскую игрушку в виде овцы, селфи офисной коровы и рекламу цветочного вина.
Редактирование с несколькими референсами
Тот же адаптер обучен и для пайплайна редактирования, включая входы с несколькими референсами. В первом примере целью является куртка человека:
| Референс | Базовая модель, 40 шагов | Lightning LoRA, 4 шага |
|---|---|---|
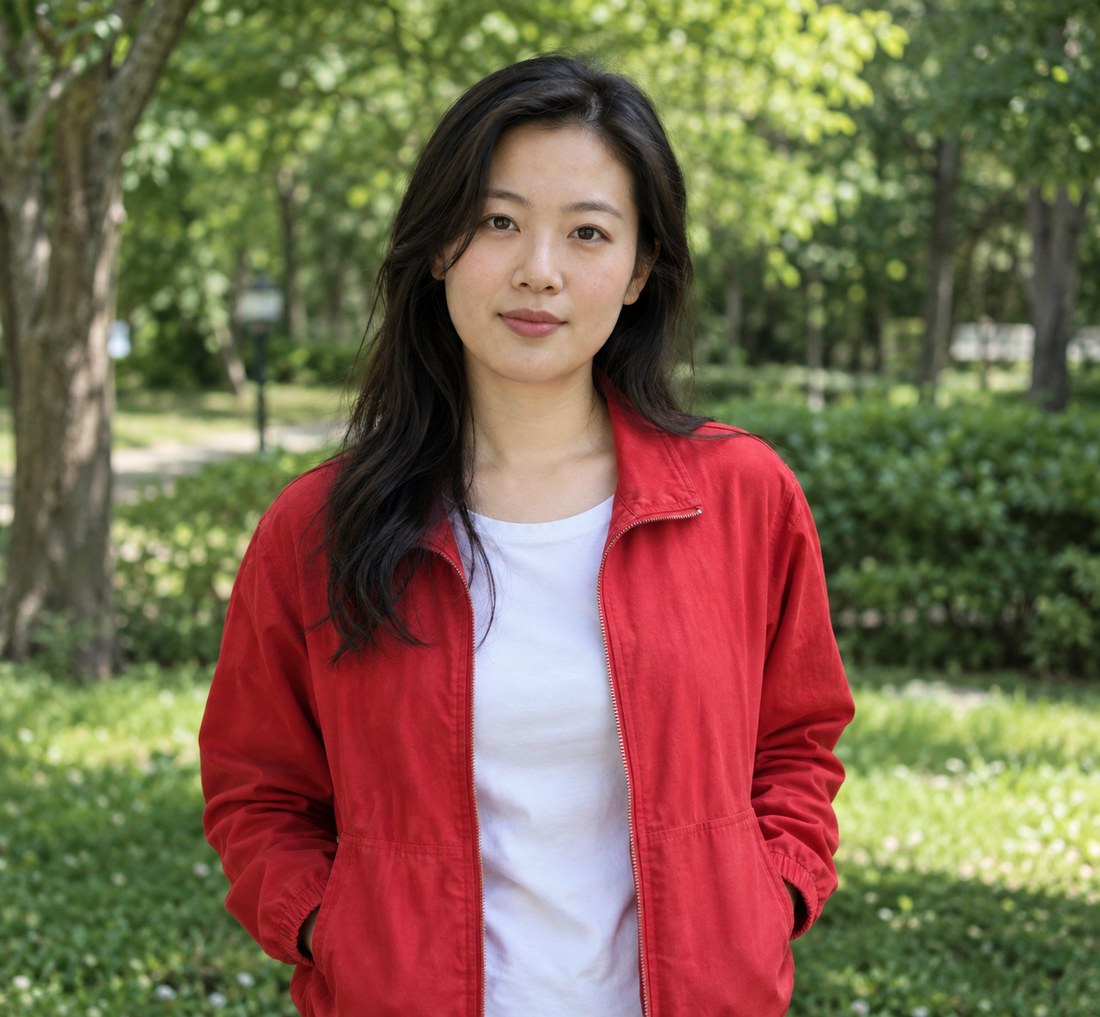 | 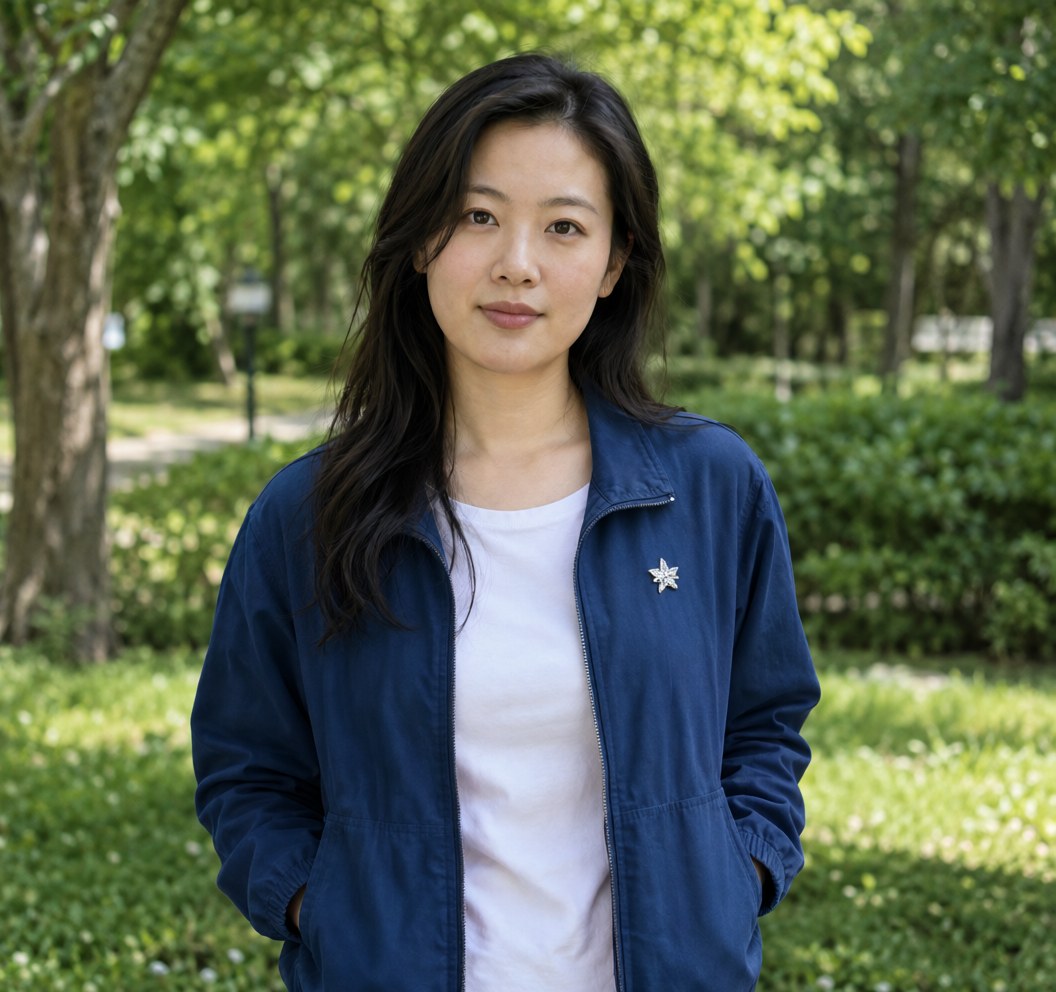 | 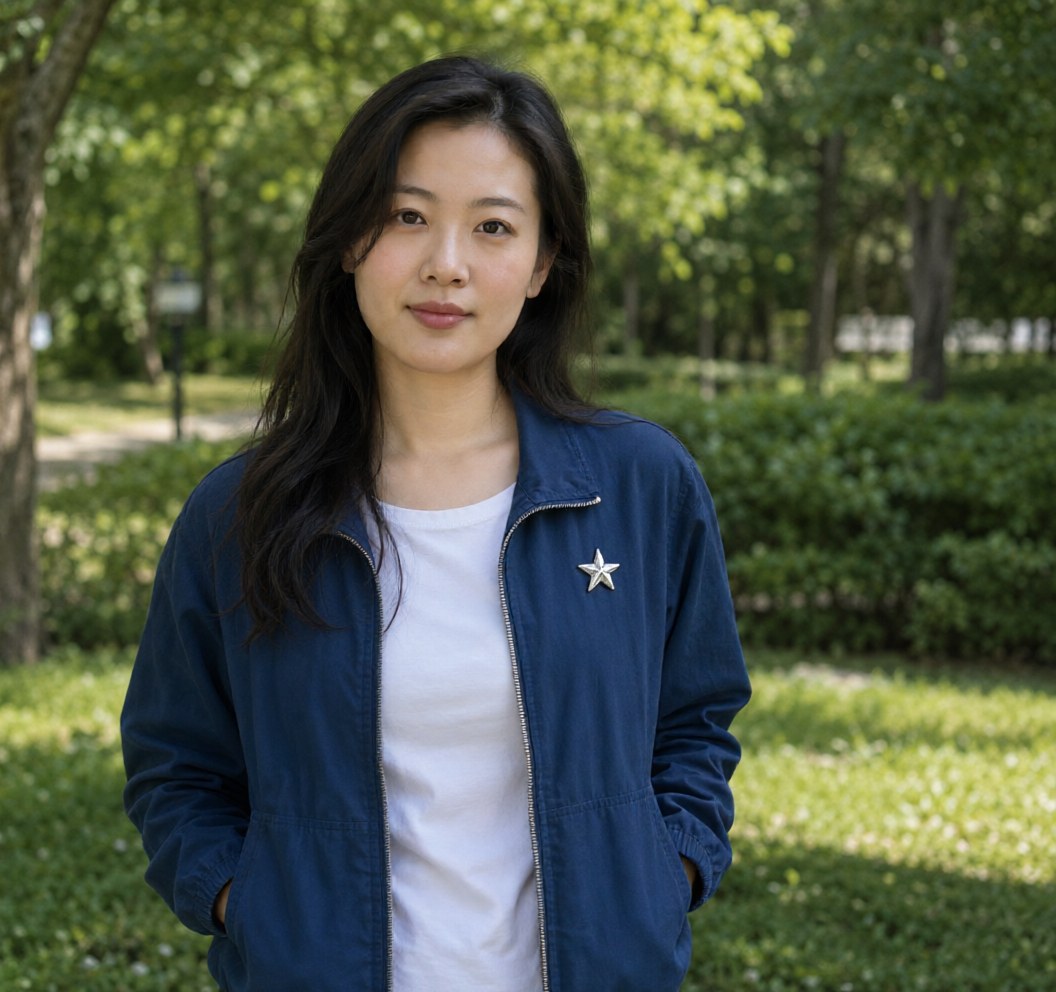 |
"Замените красную куртку на тёмно-синюю и добавьте небольшую серебряную брошь в форме звезды на левой стороне груди. Сохраните внешность, выражение лица, причёску, позу человека, а также материал и складки куртки; фон и освещение оставьте без изменений. …"
Ещё семь примеров редактирования приведены в карточке модели: одежда и ночная сцена, человек и кот, реклама продукта, диван и подвесной светильник, перенос материала пола, отражение в зеркале и примерка рюкзака. Для каждого из них рядом с результатами на 40 шагах и на 4 шагах указаны соответствующие референсные изображения.
Использование
Веса представляют собой один файл pytorch_lora_weights.safetensors (67 МБ), который загружается поверх checkpoint Qwen-Image 2.1, поэтому ComfyUI подхватывает его через обычный загрузчик LoRA для графа Qwen-Image 2.1 с настройкой на 4 шага при CFG 1. Собственные скрипты платформы LightX2V покрывают оборудование не от NVIDIA, включая NPU Ascend, на которых обучался адаптер.
Доступность
Веса LoRA: lightx2v/Qwen-Image-2.1-Lightning на Hugging Face. Базовая модель: Qwen/Qwen-Image-2.1. Фреймворк для вывода: ModelTC/LightX2V.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.