FluxSR: одношаговая LoRA 4x суперразрешения для Flux.1-dev
FluxSR публикует свою одношаговую LoRA 4x суперразрешения реальных изображений для Flux.1-dev вместе с кодом обучения и вывода и готовым пакетом узлов ComfyUI от сообщества.
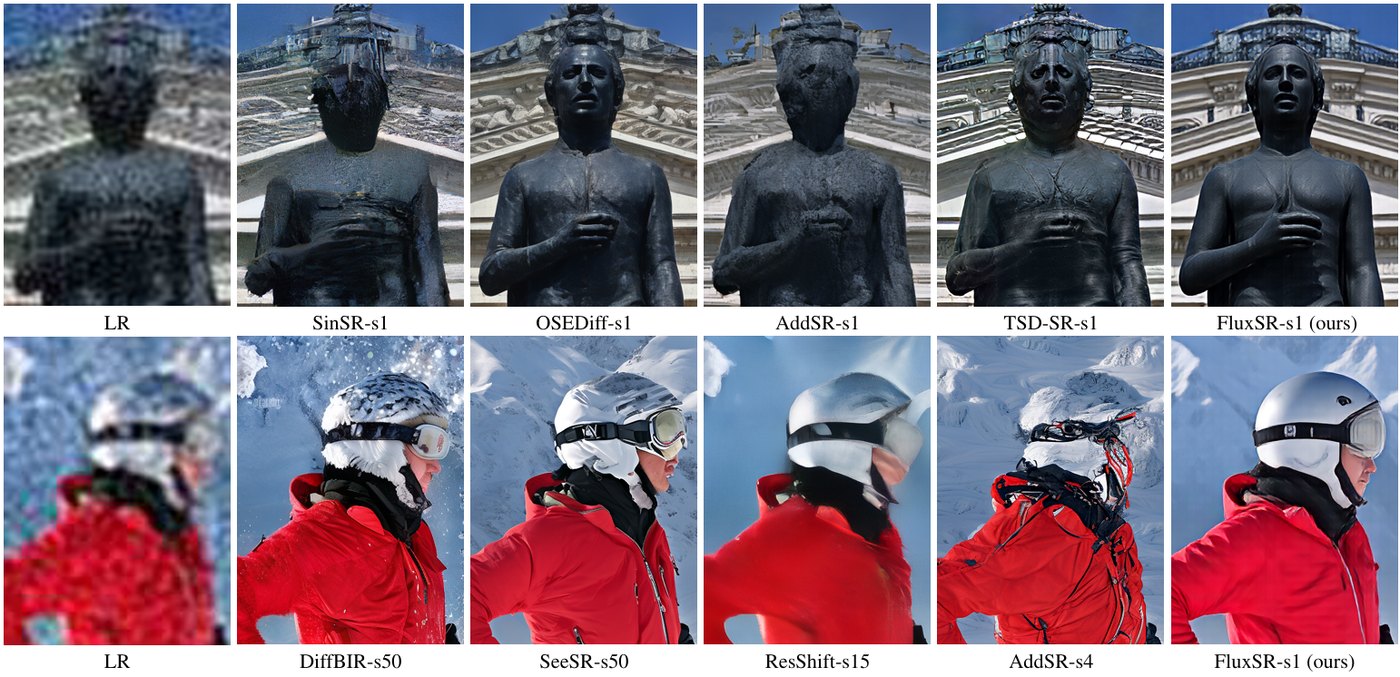
Из репозитория проекта: реконструкции FluxSR рядом с другими одношаговыми и многошаговыми методами суперразрешения.
Что делает FluxSR
Многошаговое диффузионное суперразрешение точное, но медленное, а более ранние одношаговые варианты наследуют артефакты того учителя, из которого они дистиллировались. FluxSR сохраняет Flux.1-dev и как учителя, и как базовую модель, добавляя поверх три компонента:
- Дистилляция траектории потока (FTD) дистиллирует многошаговую flow-matching модель в один шаг выборки, так что один проход через transformer даёт 4x изображение.
- TV-LPIPS заменяет обычную перцептивную функцию потерь на вариант со взвешиванием по полной вариации, который авторы статьи используют, чтобы подтолкнуть реконструкцию к реалистичным текстурам вместо сглаженных средних.
- Attention Diversification Loss (ADL) - это регуляризатор, снижающий схожесть токенов внутри transformer; именно оттуда обычно берётся высокочастотная зернистость в одношаговых выходах.
Результат поставляется как LoRA-адаптер, а не как полный checkpoint. Адаптер весит 717 МБ, ранг и альфа равны 64, а вывод выполняется на временном шаге 350 при guidance 4, и всё это считывается из приложенного training_config.json.
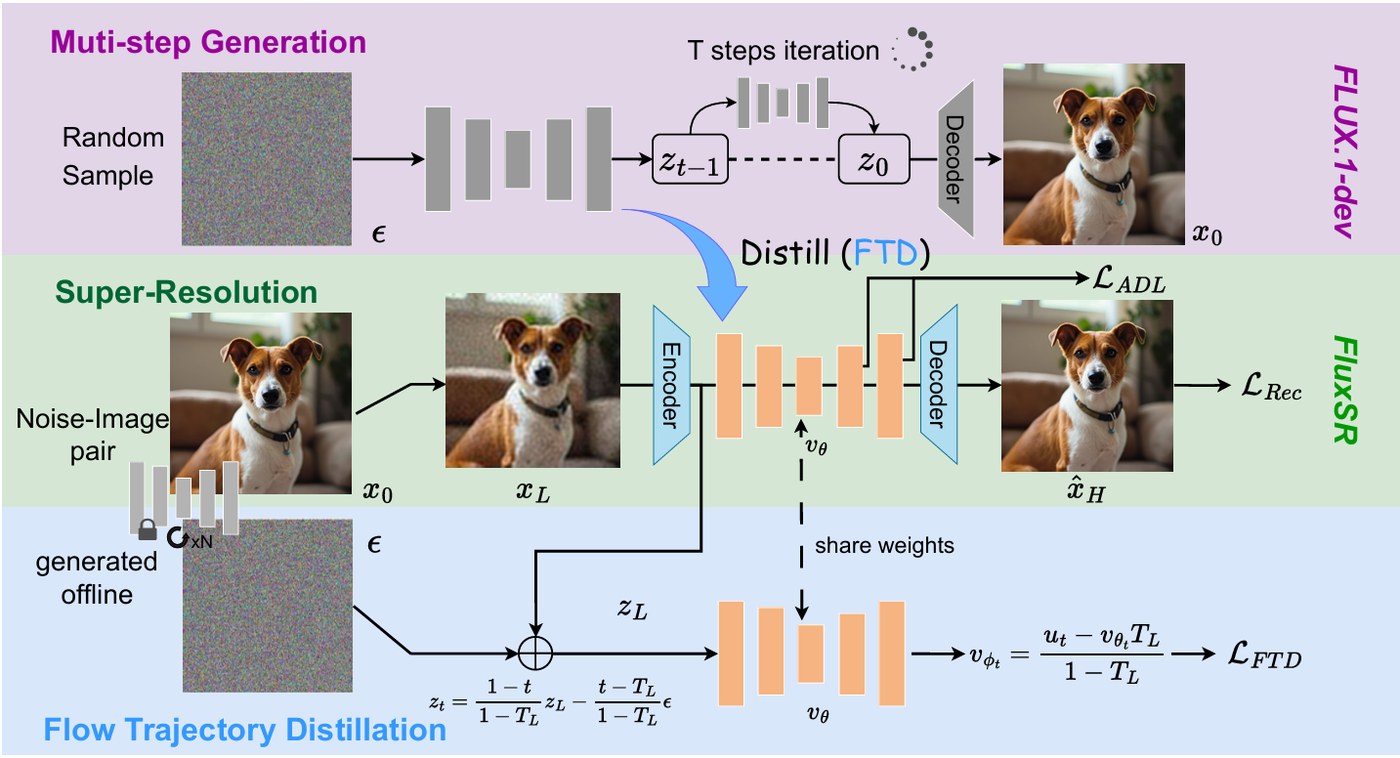
Пайплайн обучения FluxSR: учитель Flux.1-dev генерирует обучающие пары, а LoRA-студент дистиллируется в один шаг с помощью TV-LPIPS и ADL.
Что входит в релиз
| Файл | Что это |
|---|---|
pytorch_lora_weights.safetensors | LoRA-адаптер трансформера FluxSR (717 МБ) |
training_config.json | Временной шаг, guidance и ранг/альфа LoRA, используемые при выводе |
t5_embedding.pth, clip_embedding.pth | Фиксированные текстовые эмбеддинги, которые ожидает адаптер |
prompts_10k.json | 10 000 промптов, использованных для генерации обучающих пар |
Репозиторий документирует весь цикл, а не только вывод. Обучающие данные генерируются учителем Flux.1-dev при 50 шагах и guidance 3.5, сохраняя парные шум, латентный выход учителя, декодированное изображение и seed, а scripts/evaluate.py сообщает PSNR, SSIM, LPIPS, DISTS и MUSIQ относительно ground truth, когда он доступен.
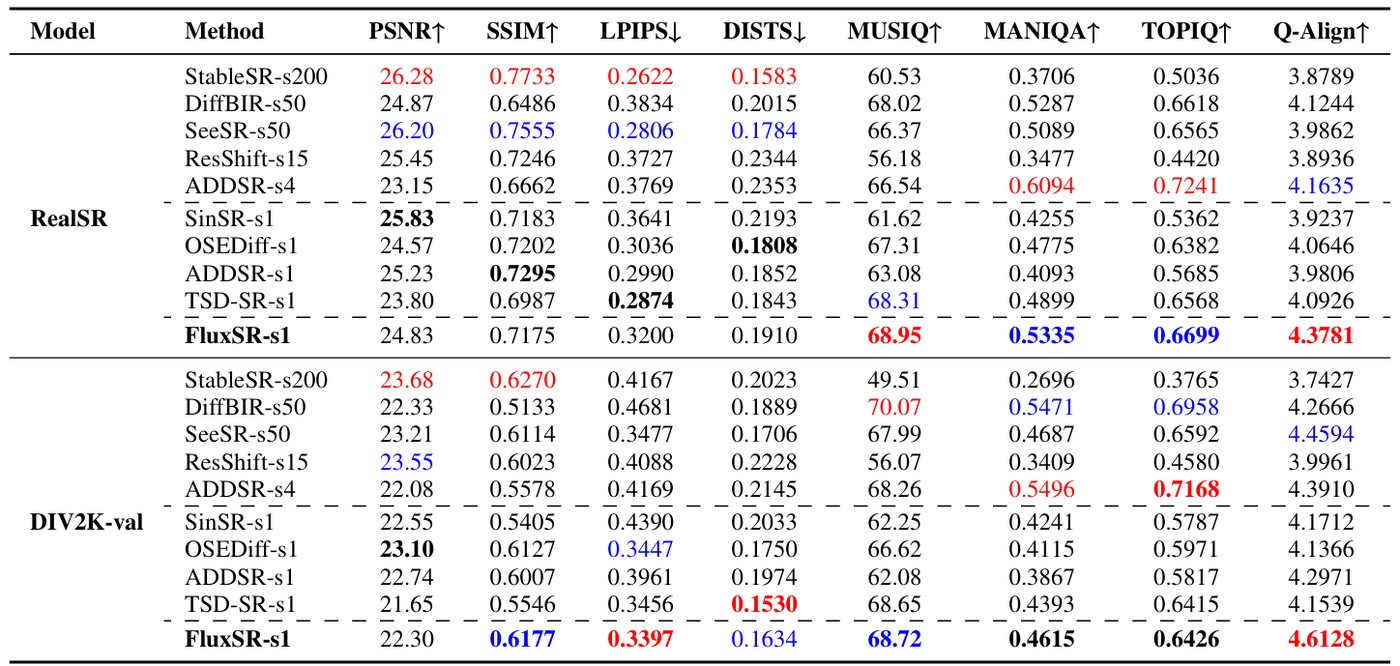
Таблица 1 из статьи: количественное сравнение с другими методами суперразрешения реальных изображений.
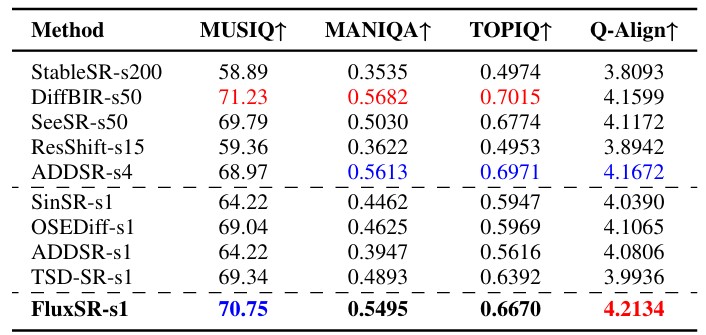
Таблица 2 из статьи приводит то же сравнение на RealSet65.
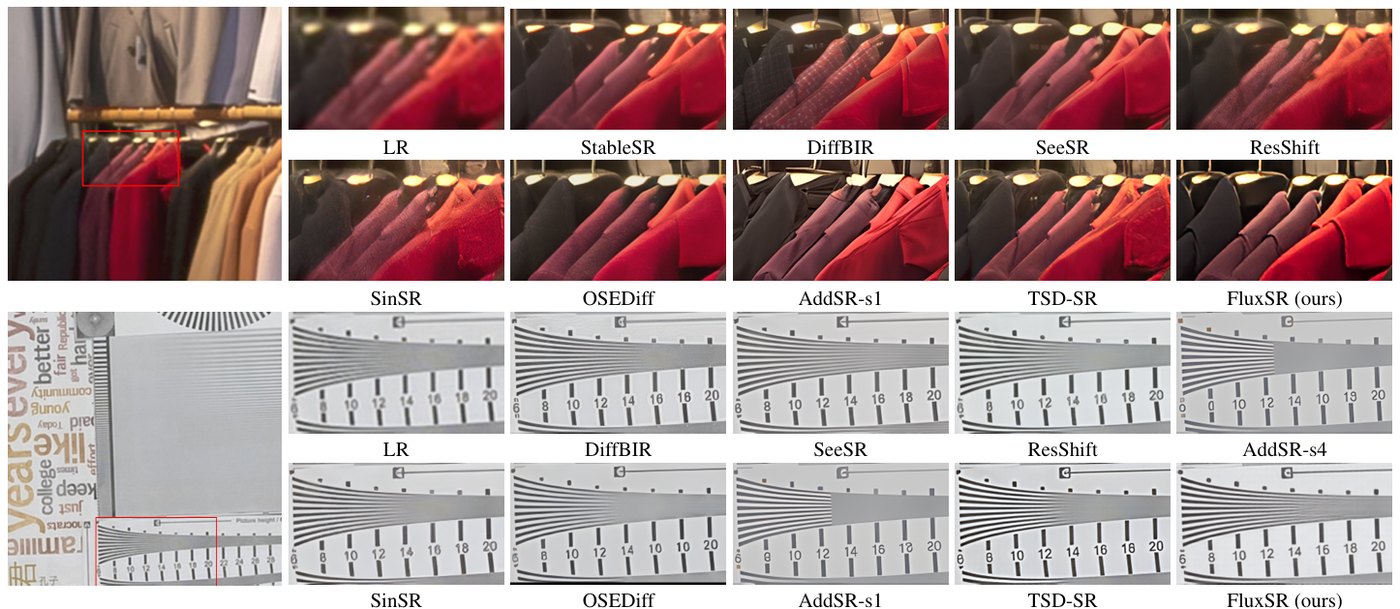
Качественное сравнение из статьи: FluxSR против других методов суперразрешения на реальных входах низкого разрешения.
Запуск в ComfyUI
Проект сам не поставляет ноду ComfyUI, но пакет узлов от сообщества появился в тот же день. JohnDopamine опубликовал пакет узлов FluxSR в канале #flux Banodoco 13 октября 2026 года (версия 1.0.1 исправляет пути к эмбеддингам T5 и CLIP) и сообщил о двух запусках на машине с примерно 84 ГБ доступной VRAM:
| Вход | Выход | Время |
|---|---|---|
| 446 x 448 | 1784 x 1792 | 3.18 с |
| 688 x 864 | 2752 x 3456 | 34.91 с |
Пакет запускает Flux.1-dev с LoRA плюс два фиксированных файла эмбеддингов из пакета на Hugging Face, так что всё, что уже умеет запускать Flux.1-dev, сможет запустить и его. Существуют пакетный и плиточный режимы для больших входов, а скрипт вывода предоставляет --offload sequential и --vae-tiling для конфигураций с меньшим объёмом памяти.
Пакет узлов сейчас распространяется в канале сообщества как zip, а не как репозиторий, поэтому установка ручная.
Доступность
Веса LoRA, фиксированные эмбеддинги и обучающие промпты находятся на Hugging Face, а код обучения, вывода и оценки - на GitHub. Базовые веса Flux.1-dev нужно скачивать отдельно, приняв их условия доступа.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.