Spark-H3: блочное разреженное внимание ускоряет MiniMax-H3 в ComfyUI
Spark-H3 приносит блочное разреженное внимание Spark-Attn в MiniMax-H3 для ComfyUI: готовые узлы для серий RTX 40 и 50 и DiT в 1.73 раза быстрее при плотности 10%.
Из репозитория проекта: один и тот же промпт, seed и расписание, отрендеренные с плотным вниманием, Spark-H3 при плотности 10% и Sol-H3.
Что меняет Spark-Attn
Блочное разреженное внимание разделяет проход внимания по видео на две ветви: точную ветвь, которая полностью вычисляет блоки ключей/значений с наивысшим рейтингом, и сжатую ветвь, которая дёшево покрывает всё остальное. Spark-Attn перерабатывает обе половины, а Spark-H3 это его реализация для MiniMax-H3. Технический блог был опубликован 23.09.2026, последнее обновление: 08.10.2026.
- Spark-Reblock заменяет фиксированные пространственно-временные тайлы адаптивным разбиением. Два запроса считаются похожими, когда они дают похожие паттерны оценок внимания по ключам, что измеряется косинусным расстоянием Махаланобиса, индуцированным вторым моментом противоположной стороны. Иерархический разделитель продолжает дробить группы, пока каждый лист не достигнет целевого размера блока, за время
O(N log N), так что компоновка блоков следует за входом, слоем и головой, а не за фиксированной окрестностью. - Spark-Reweight заменяет усреднённую сводку ключей/значений сжатой ветви (mean pooling) на взвешенные сводки плюс смещение по лог-массе. Усреднение недооценивает массу внимания, потому что внимание экспоненцирует логиты перед нормализацией: оно подставляет
exp(E[x])вместоE[exp(x)]. Смещение восстанавливает потерянную массу, а для оценки используется среднее запросов видео как один якорь на голову, так что дополнительные затраты остаются линейными.
Обе части измеряются по отдельности, при бюджете Top-K в 10%:
| Аблация | Полнота массы внимания | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| Фиксированное разбиение на блоки | 68.66% | 18.61 | 0.68 | 0.26 |
| + Spark-Reblock | 81.54% | 22.41 | 0.80 | 0.14 |
А для сжатой ветви:
| Аблация | Абсолютная ошибка лог-массы (нат) | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| Усреднение (mean pooling) | 3.86 | 18.61 | 0.68 | 0.26 |
| + Spark-Reweight | 2.78 | 19.17 | 0.70 | 0.24 |
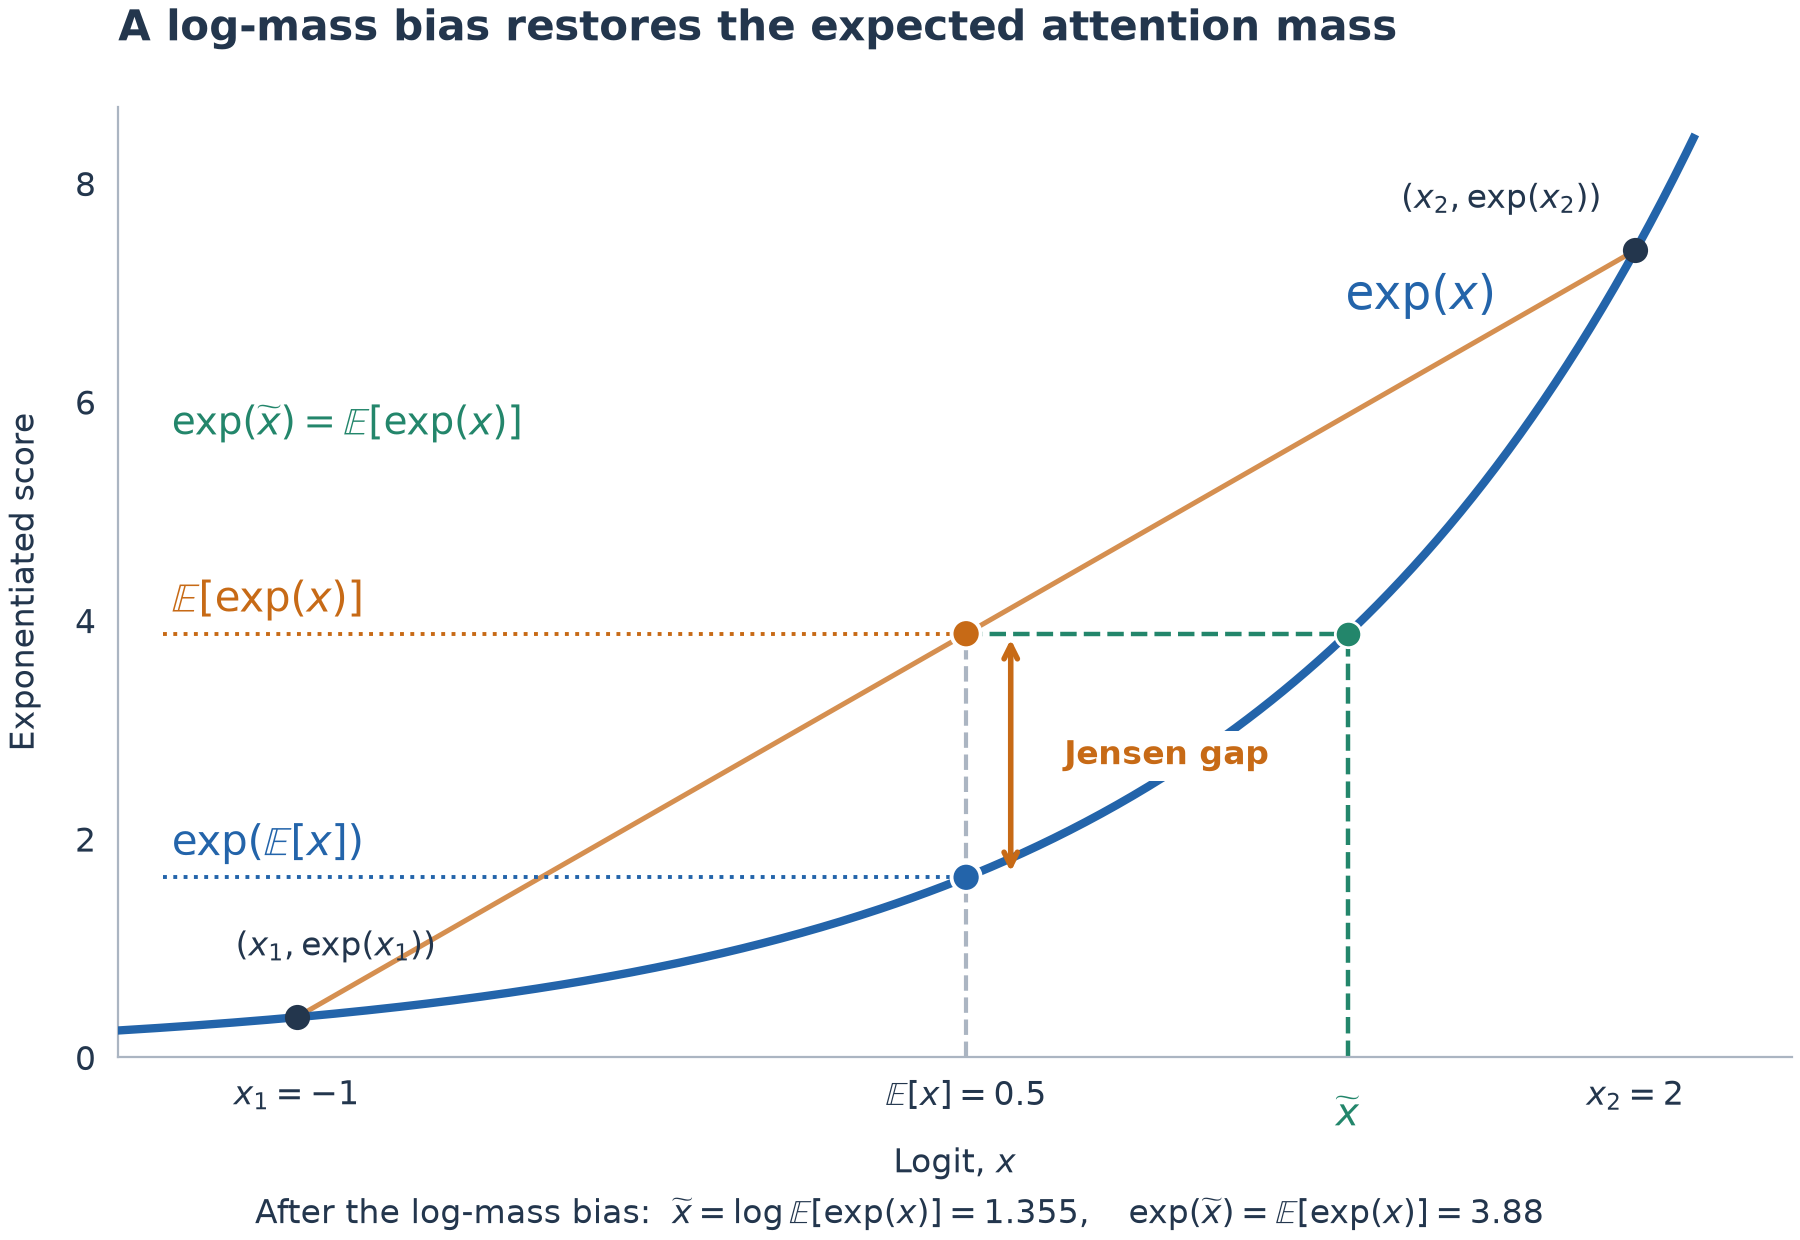
Усреднение даёт exp(E[x]), обозначенную синим, ниже ожидаемой экспоненты E[exp(x)], обозначенной оранжевым. Зелёная точка это эффективный усреднённый логит после смещения по лог-массе, экспонента которого совпадает с ожидаемой экспонентой.
Бенчмарки
Сравнительные цифры получены на промптах VBench при 1344x768, 240 кадрах при 24 fps и 19-шаговом расписании MiniMax-H3 на одной RTX PRO 6000 Blackwell. Все разреженные методы здесь используют общий 20%-й плотный прогрев, сохраняют первый слой Transformer плотным на всём протяжении и сравниваются с плотными результатами на тех же промптах и seed.
| Метод | Плотность | Задержка DiT | Ускорение DiT | PSNR | SSIM | LPIPS | Ускорение ATTN |
|---|---|---|---|---|---|---|---|
| Плотный | 100% | 583.3 с | 1.00x | эталон | 1.00 | 0.00 | 1.00x |
| Sol-H3 | динамическая | 355.4 с | 1.64x | 20.36 | 0.71 | 0.20 | 2.19x |
| Spark-H3, Скорость | 10% | 337.4 с | 1.73x | 23.30 | 0.80 | 0.14 | 2.33x |
| Spark-H3, Баланс | 20% | 371.1 с | 1.57x | 25.38 | 0.85 | 0.09 | 1.96x |
| Spark-H3, Точность | 30% | 404.1 с | 1.44x | 27.07 | 0.88 | 0.07 | 1.76x |
| Spark-H3-Lite, Скорость | 10% | 330.2 с | 1.77x | 23.34 | 0.80 | 0.14 | н/д |
При плотности 10% Spark-H3 даёт прирост 2.94 dB PSNR относительно Sol-H3, работая при этом немного быстрее, а повышение плотности монотонно обменивает скорость обратно на точность. Spark-H3-Lite это более дешёвый вариант, который вдвое сокращает задержку переразбиения ценой небольшой потери точности при 20% и 30%. По измерениям VBench все варианты Spark-H3 остаются в пределах примерно 0.3 балла от плотного варианта по согласованности субъекта и фона, плавности движения, качеству изображения и эстетическому качеству.
Узлы ComfyUI
Пакет добавляет два узла внимания для собственной реализации MiniMax-H3 в ComfyUI: MiniMax H3 Spark Attention (SM89) и MiniMax H3 Spark Attention (SM120). Один из них ставится на провод MODEL между загрузчиком модели и BasicGuider, и на одну модель следует применять только один патч внимания. Всё остальное в графе остаётся нетронутым, поэтому он сочетается с LoRA сообщества, которые используются в примерах.
| Требование | Значение |
|---|---|
| ComfyUI | 0.38.x или 0.39.x |
| Python | 3.12+ |
| PyTorch / CUDA | CUDA 13.0, BF16 |
| ОС | Linux или Windows x86_64 |
| SM89 | серия GeForce RTX 40 |
| SM120 | серия GeForce RTX 50, RTX PRO 5000 / 6000 Blackwell |
Установщик выбирает подходящий бэкенд для вашей версии ComfyUI: comfy-kitchen 0.2.36 на 0.38.x и 0.2.37 на 0.39.x. Релиз v0.1.2 добавил проверенные пакеты для Windows и обновил входящие в комплект рабочие процессы и документацию по установке; CUDA 12.8 доступна только через путь сборки из исходников. Файлы модели по-прежнему берутся из репозитория Comfy-Org MiniMax-H3, а руководство по ComfyUI также ссылается на китайское руководство по установке.
Сквозной замер в ComfyUI на той же RTX PRO 6000 Blackwell для клипа 1344x768 длительностью 14.4 секунды:
| Вариант | Плотный | Точность (20%, прогрев) | Скорость (20%, без прогрева) |
|---|---|---|---|
| MiniMax-H3, 20 шагов | 1018.5 с | 461.7 с · 2.21x | 323.3 с · 3.15x |
| MiniMax-H3 + LightX2V 8 шагов | 408.0 с | 199.5 с · 2.05x | 129.6 с · 3.15x |
Плотное внимание, Точность и Скорость в одном клипе, сгенерированном с помощью нативного рабочего процесса MiniMax-H3 в ComfyUI. Промпт взят из набора промптов Video DeltaNet.
Рабочие процессы
Вместе с релизом поставляются пять примеров рабочих процессов, и каждый из них фиксирует topk_mode=topk_ratio и reblock_layout=q_reuse_k. Примеры Native, LightX2V, Larryvrh и DMAD используют topk_ratio=0.2; двухпроходный пример LBH использует 0.1, чтобы соответствовать пути h3_lbh в Diffusers.
| Пример | Конфигурация |
|---|---|
| Native MiniMax-H3 | Базовый пример: 20 шагов, без LoRA, без дополнительных узлов |
| LightX2V 8-step LoRA | Требуется LightX2V Turbo LoRA в models/loras |
| Larryvrh 8-step LoRA | Требуется конвертированная LoRA, загружаемая штатным LoraLoaderModelOnly из ComfyUI |
| DMAD 4-step LoRA | Использует сэмплер повторного шума DMAD |
| LBH two-pass + LightX2V 4-step | Требуется официальный узел апскейлера LBH и его латентная модель апскейлера |
Пакет никогда не устанавливает дополнительные LoRA молча: они остаются в models/loras, и решение за вами. Скрипт конвертации для весов Larryvrh сохраняет 208 LoRA бэкбона и проецирует 51 обновление AdaLN на восьмимерную кривую временных шагов пруненной модели.
Минималистичный промпт для рекламы продукта, отрендеренный с бэкендом Spark-H3, из набора примеров в репозитории проекта.
Доступность
Spark-H3 находится на github.com/zechengtang/Spark-H3, есть зеркало только с кодом Aazeus/Spark-H3 и описание в zechengtang.github.io/Spark-H3. Это бэкенд вывода, а не checkpoint, поэтому веса модели не распространяются, и Spark-H3 можно комбинировать с существующими LoRA для H3. В дорожной карте проекта валидация SM120 указана как «в процессе», автономный релиз без зависимости от comfy-kitchen и ядра для SM90 и SM100 запланированы, а технический отчёт ещё не опубликован. Первый релиз для ComfyUI тоже совсем новый, так что упаковка и детали маршрутизации будут меняться.
Если вы уже пробовали разреженное внимание Veda на MiniMax-H3, в блоге есть разбор того, чем отличаются Spark-Attn, Sol-Attn, Veda и обычное блочное разреженное внимание: Veda обучает скорер для выбора Top-K, Sol-Attn использует контентно-адаптивный порог, а Spark-Attn меняет компоновку блоков и обработку невыбранных блоков.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.