Qwen-Image 2.1 Restore LoRA: апскейл без дрейфа
Общинный LoRA для Qwen-Image 2.1 удерживает восстановленное или увеличенное фото в исходной рамке: 0,3 px против 2,2 px без него, с воркфлоу ComfyUI.
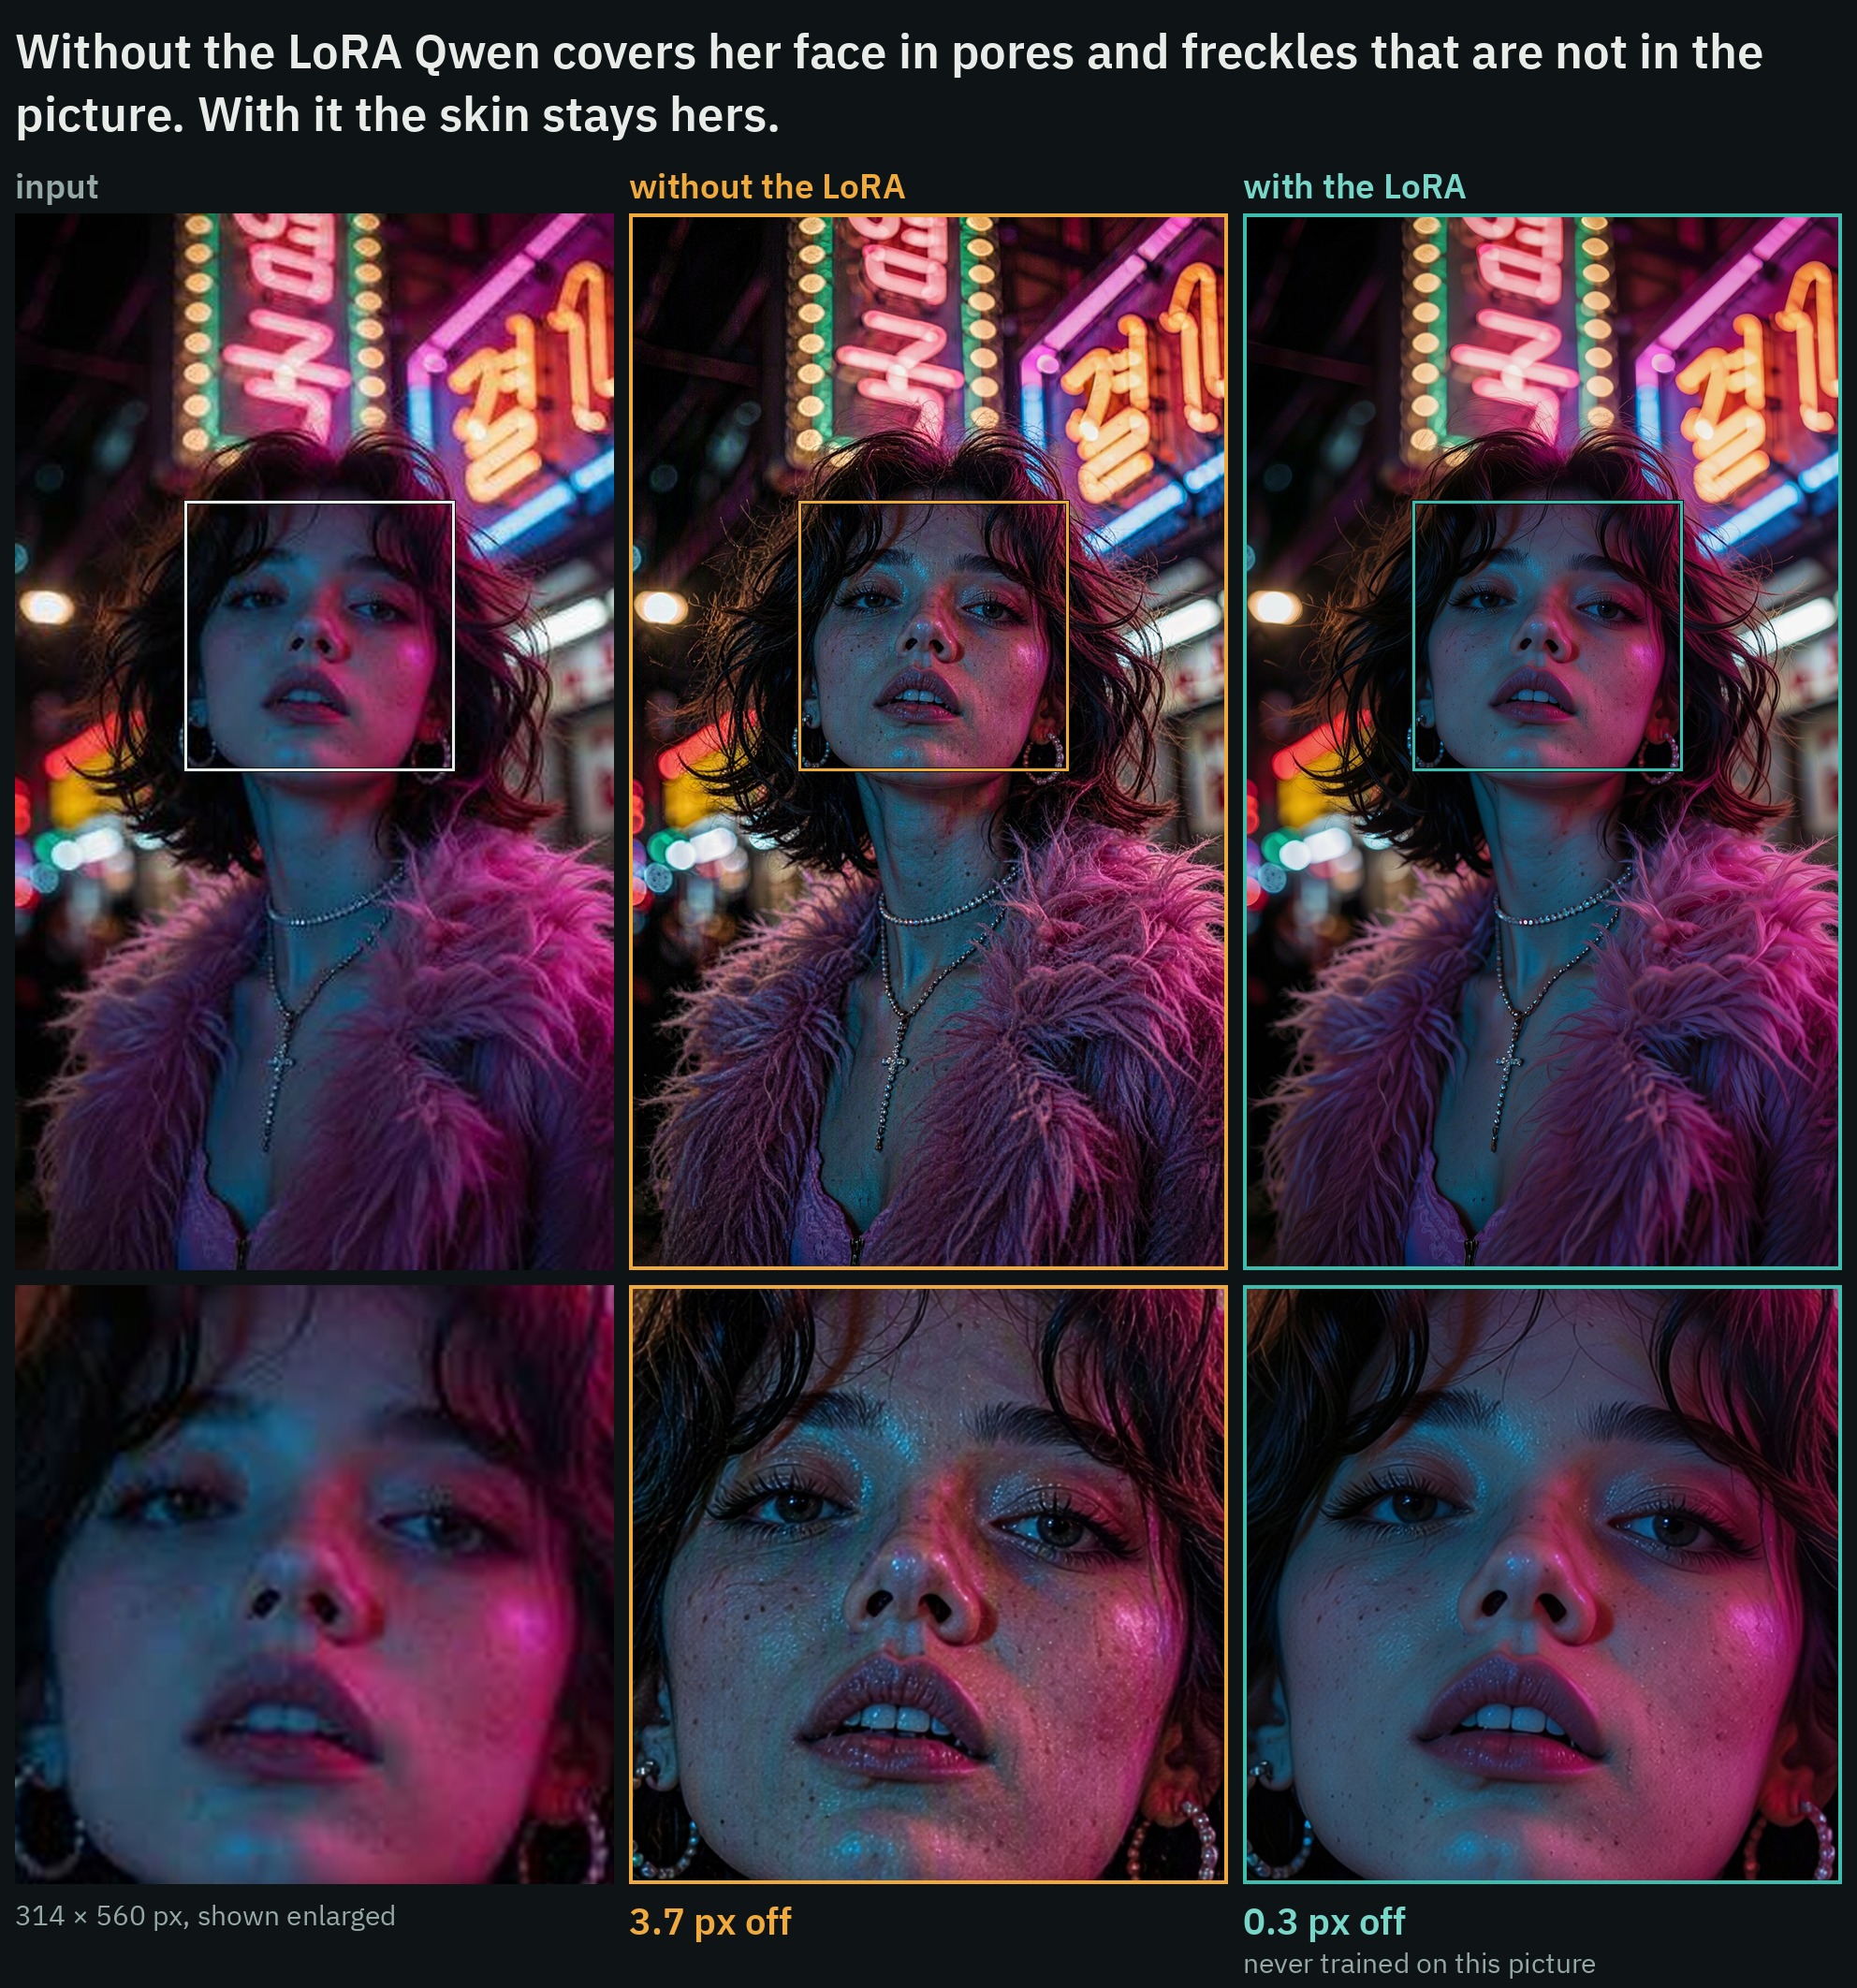
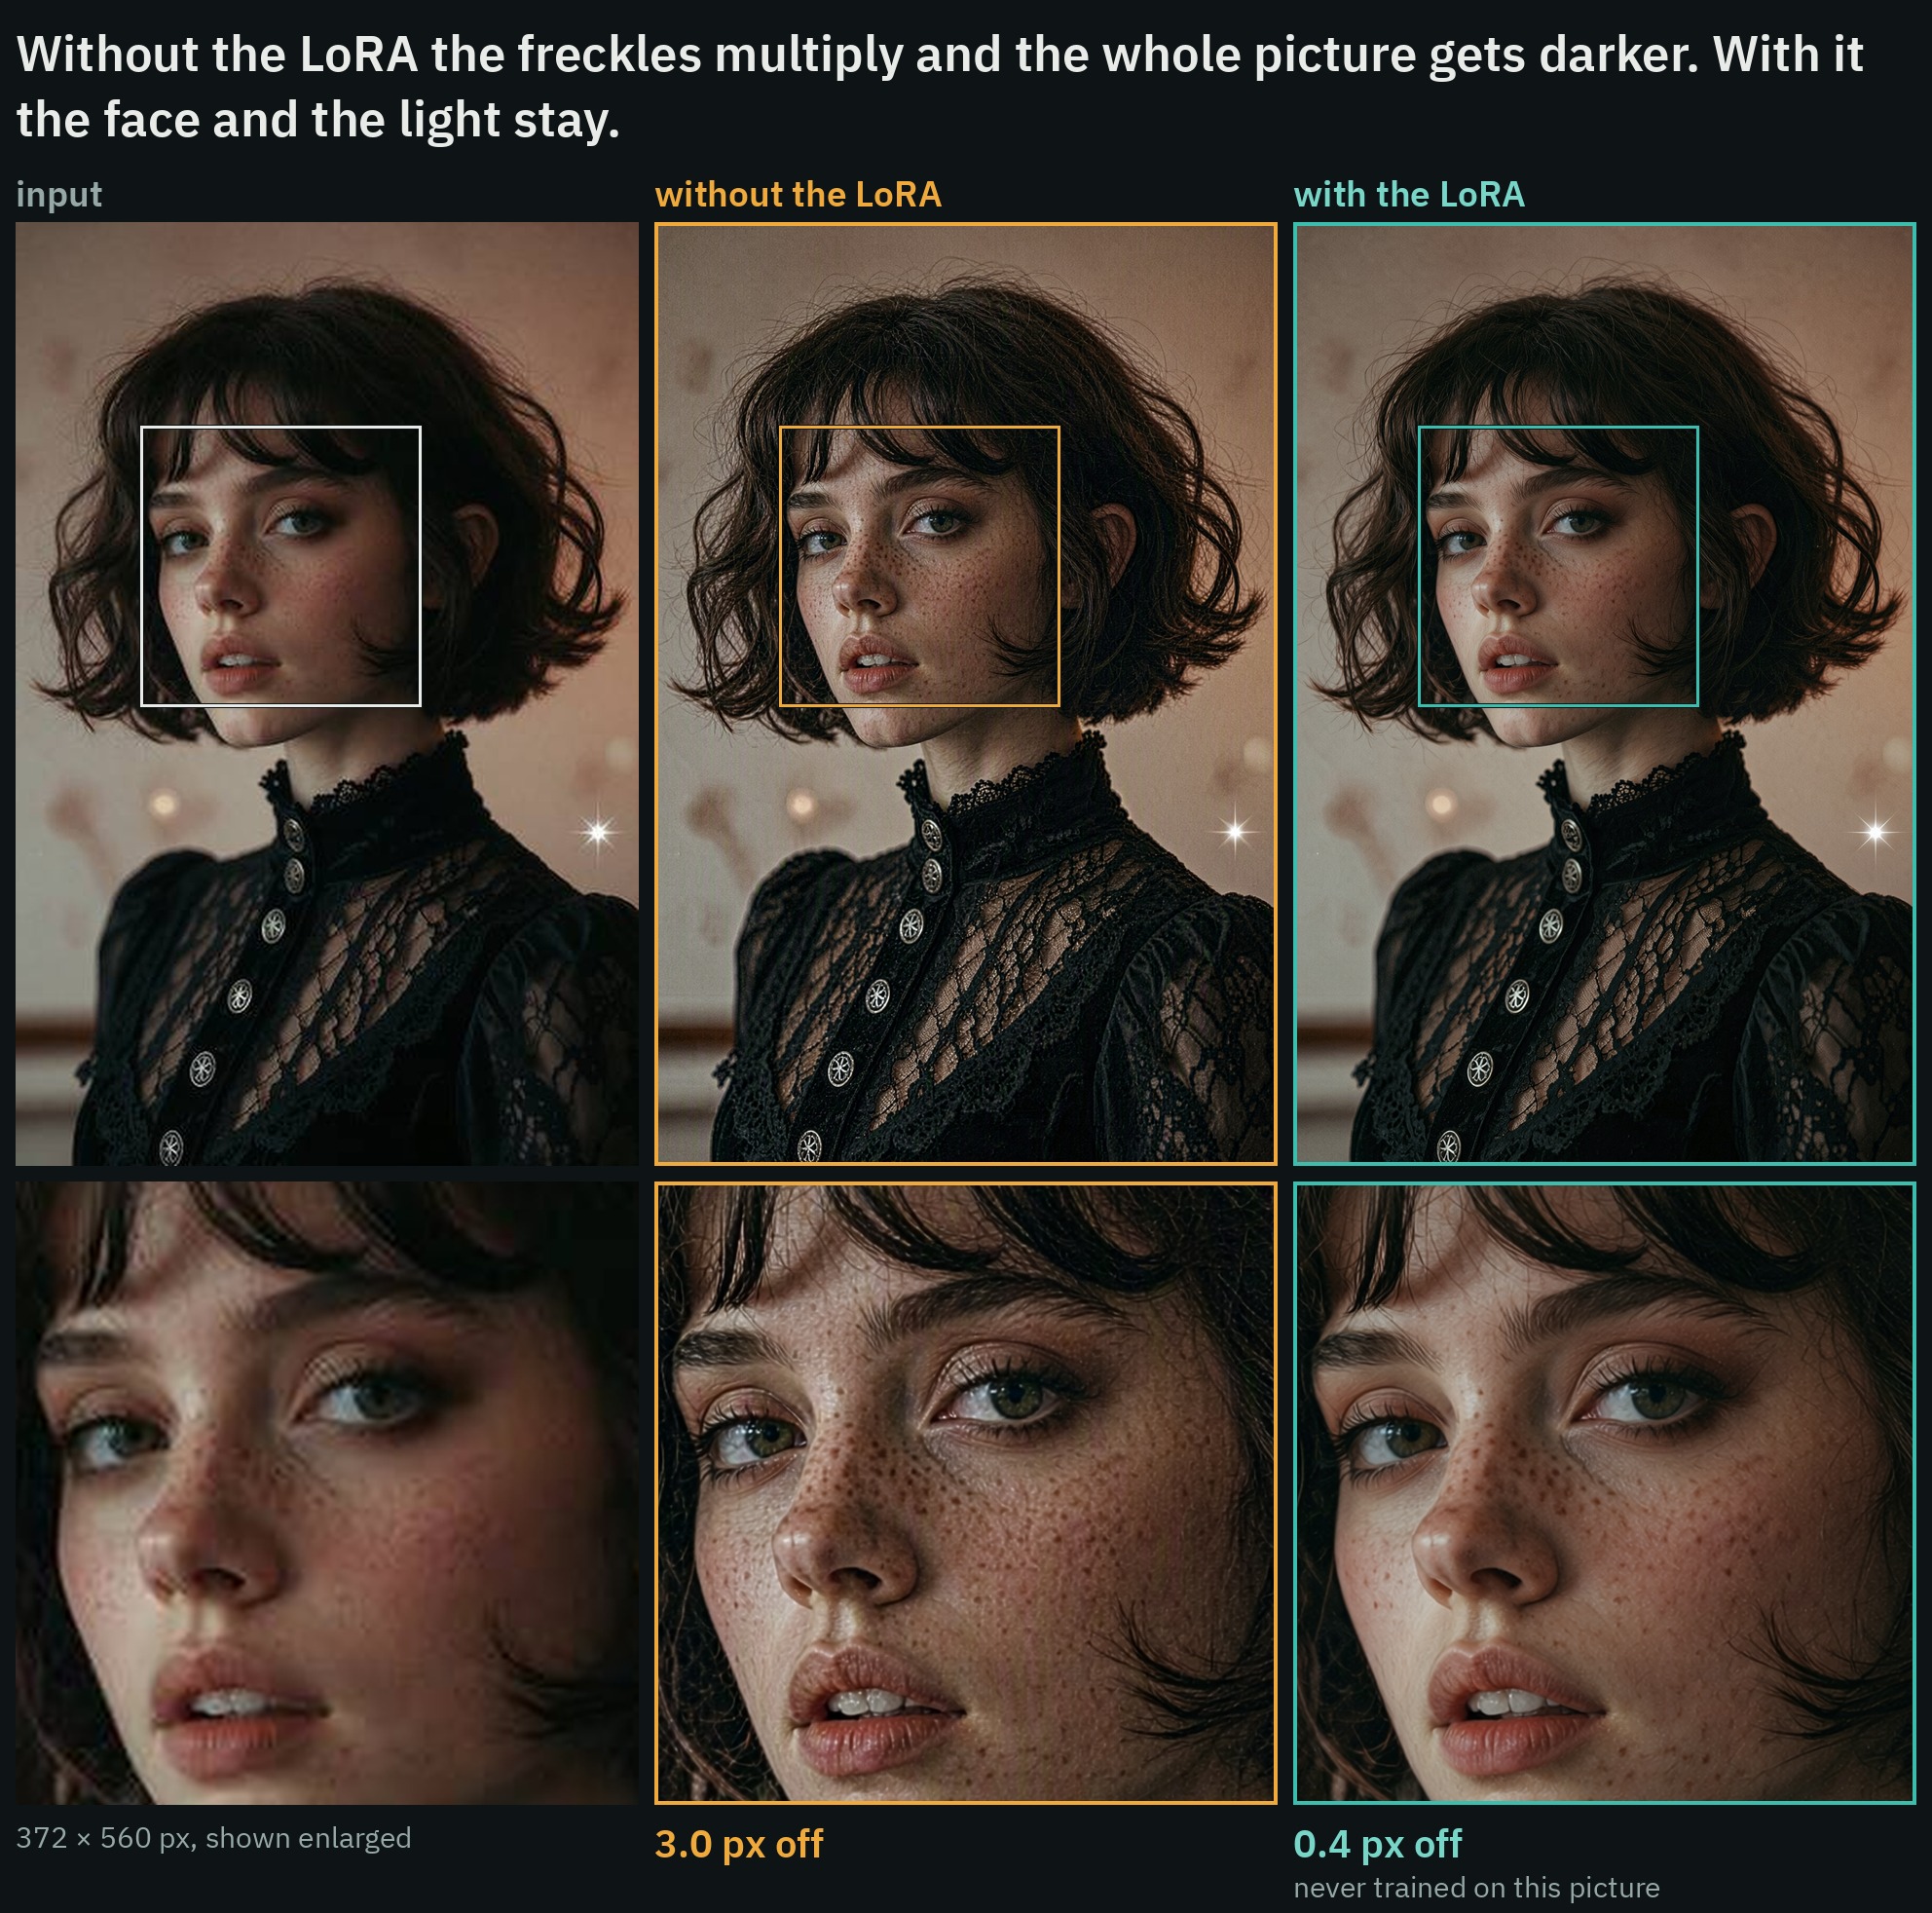
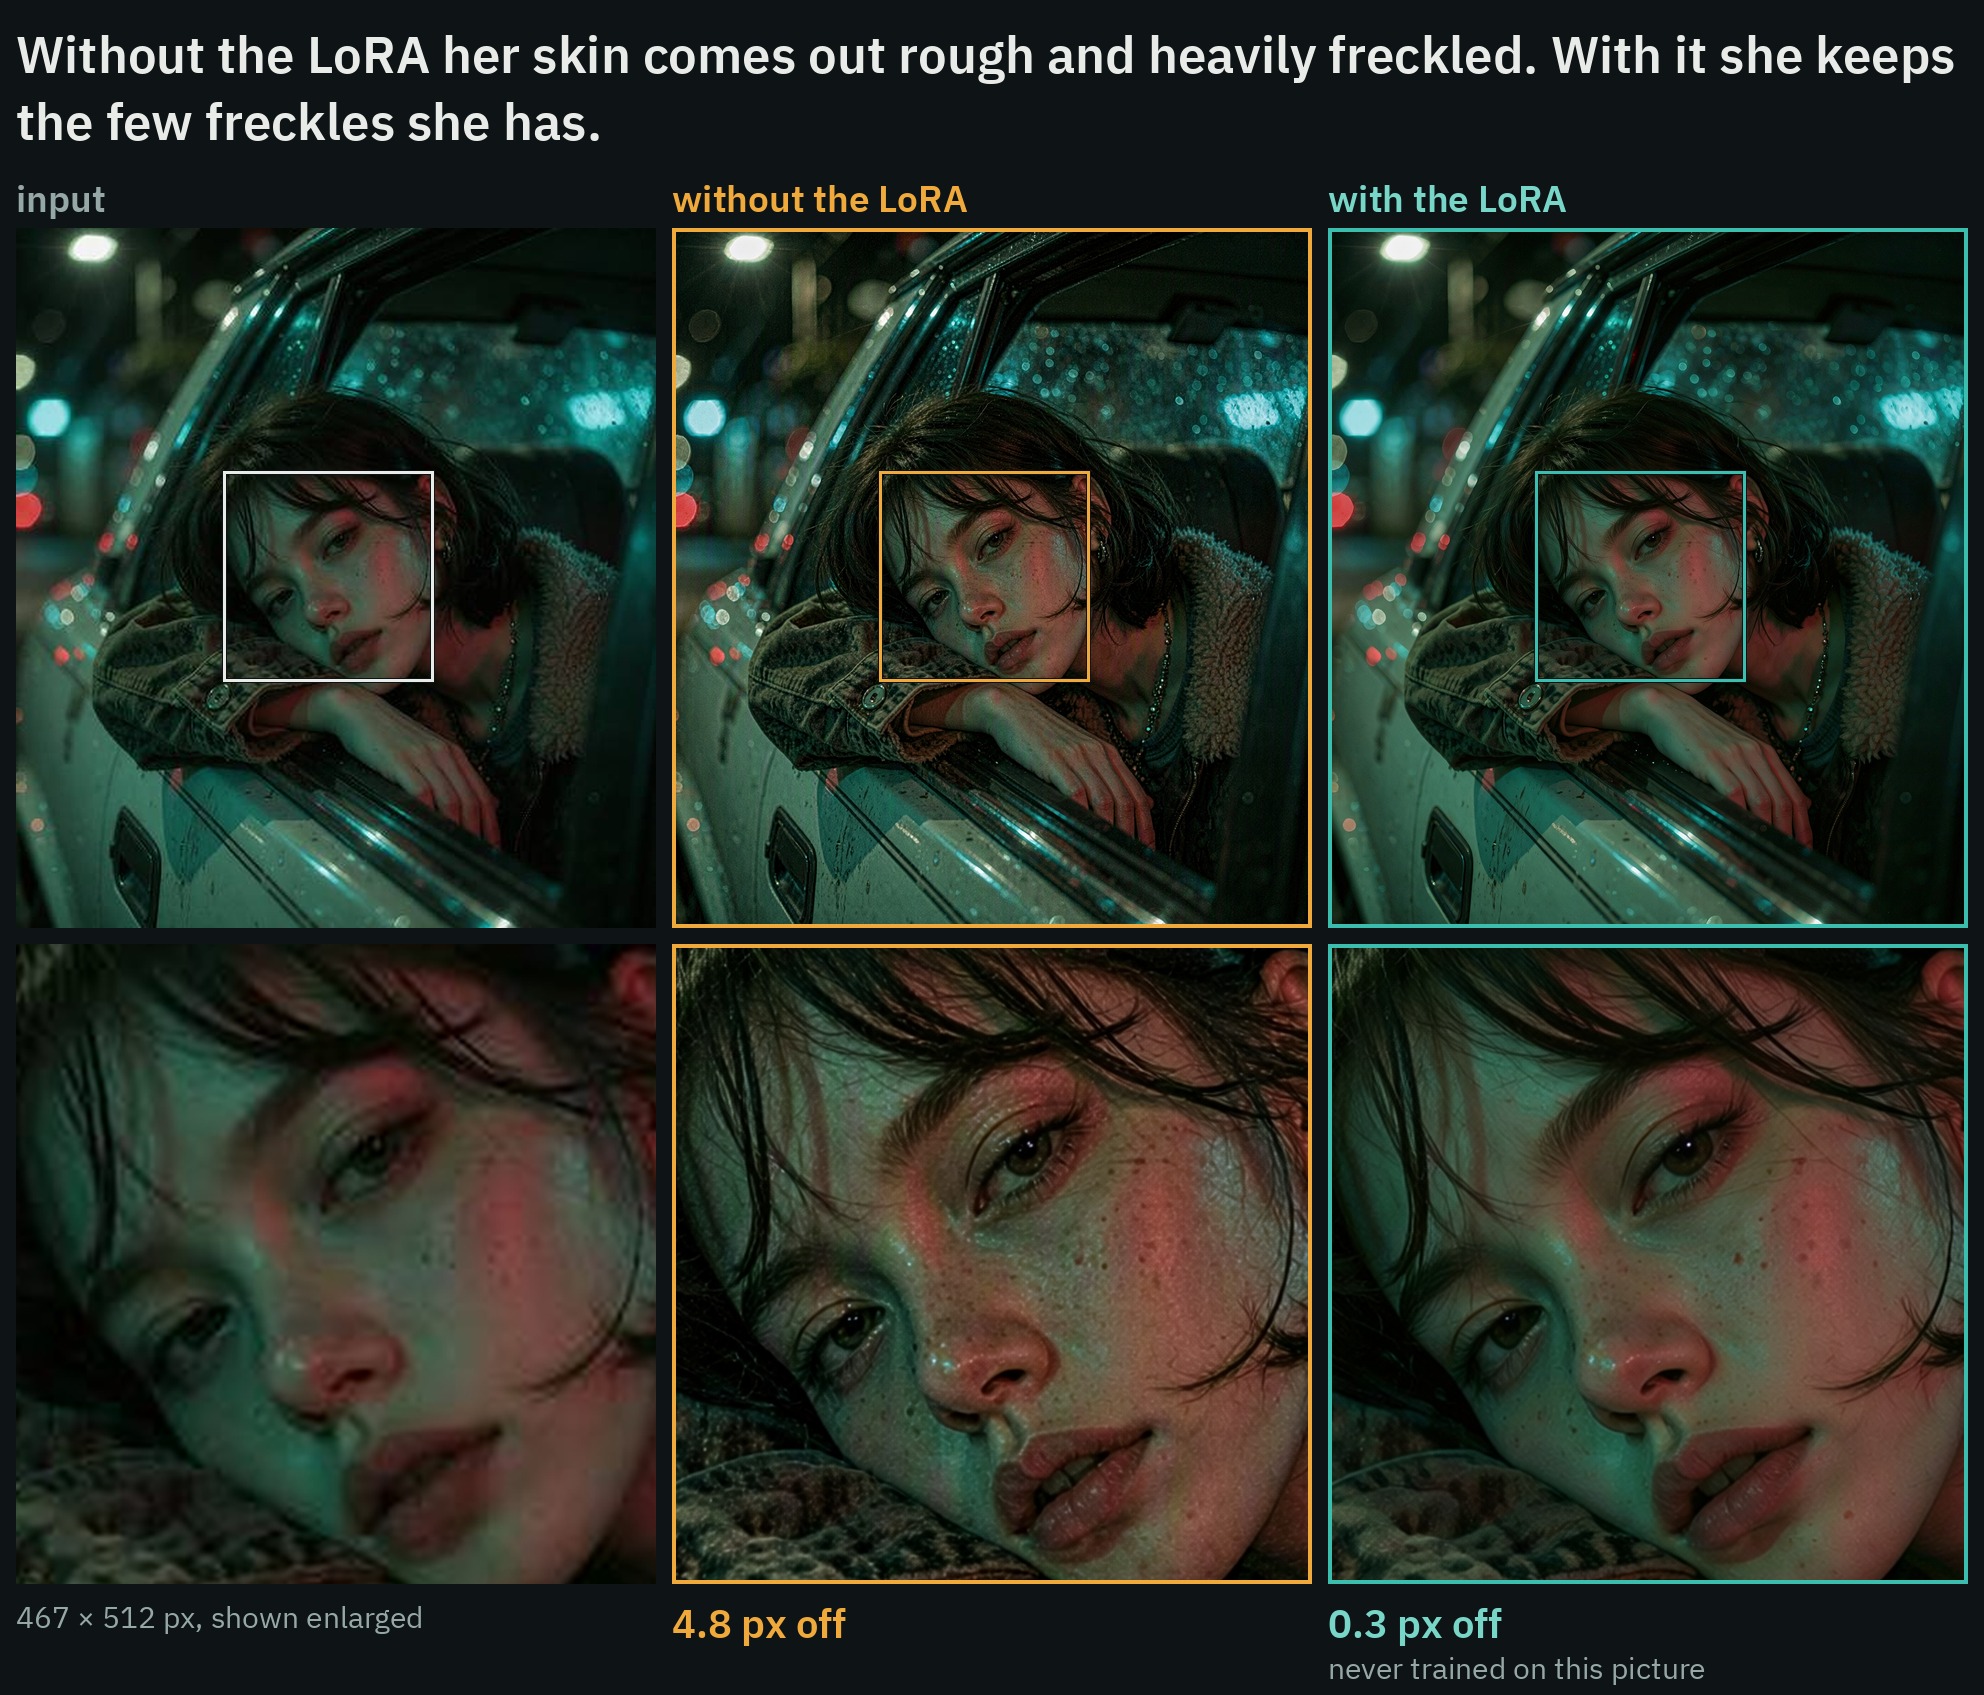
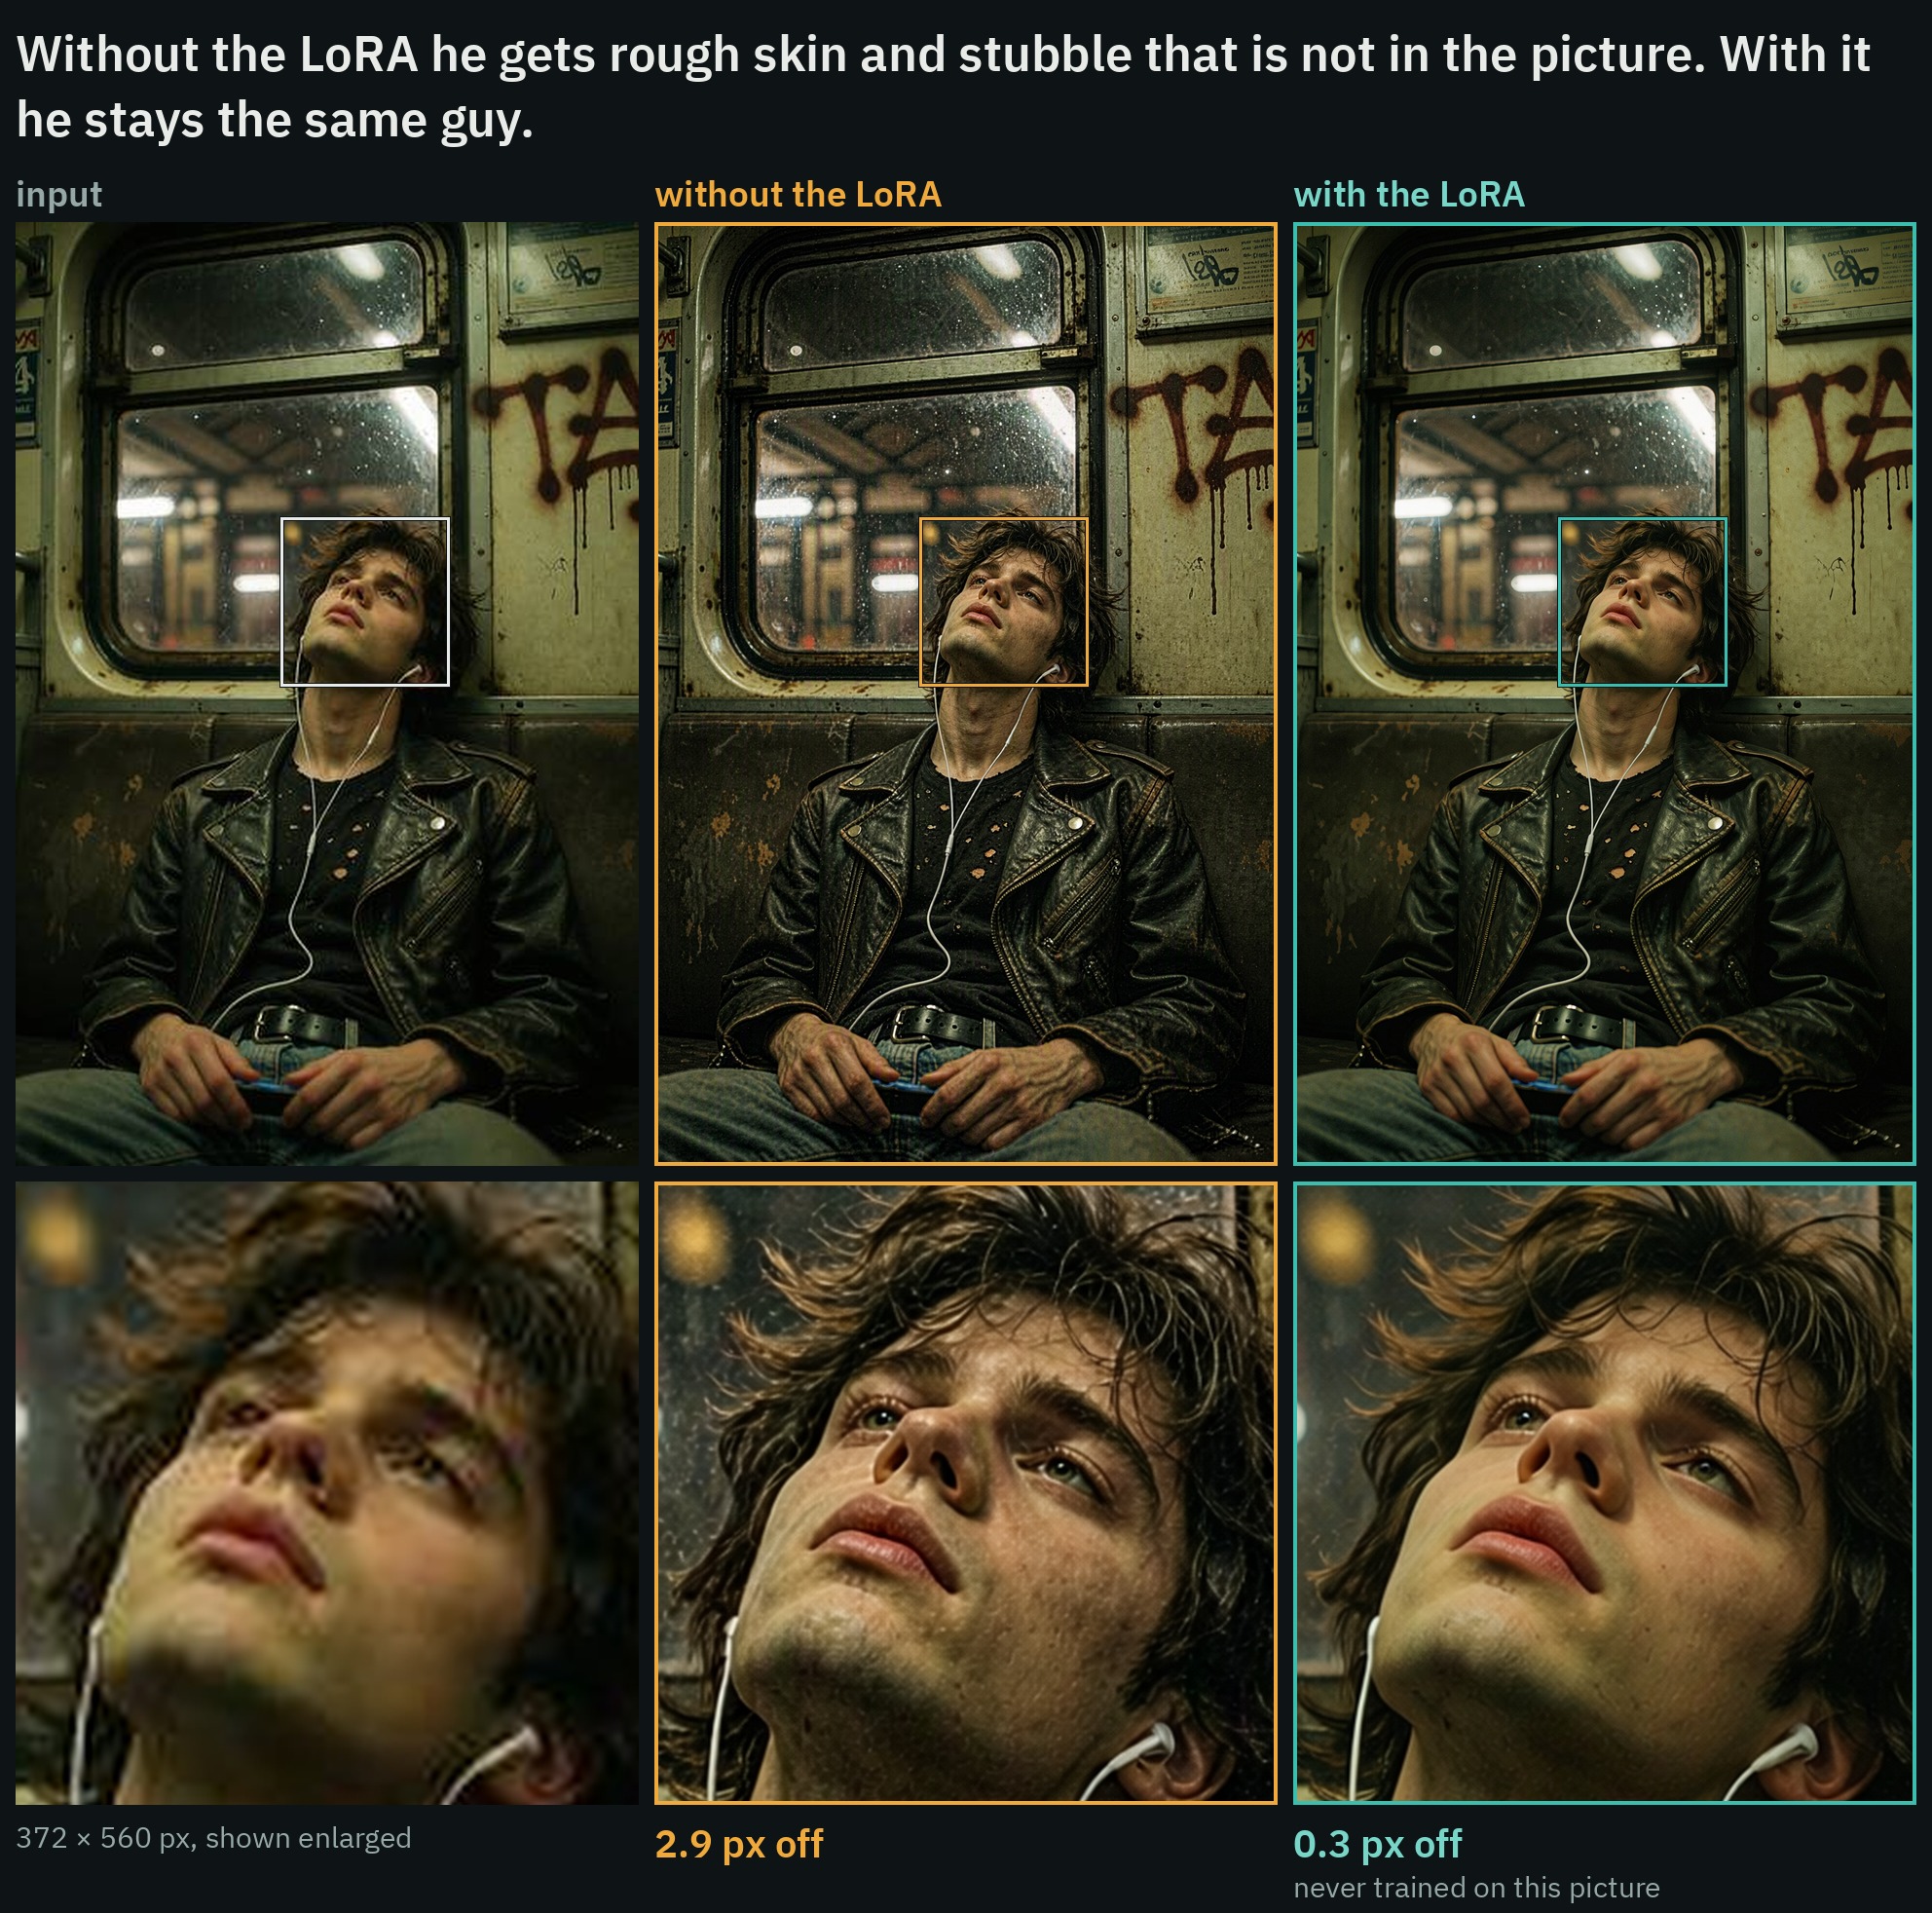
В каждом сравнении: маленький вход, результат без LoRA, результат с ней и выделенный участок, увеличенный ниже. Всё прогнано через собственный рабочий процесс репозитория с одинаковым промптом и seed, 8 шагов с Viggle Turbo, около 2 MP. «px off» показывает, насколько результат отстоит от полноразмерного изображения, из которого был уменьшен вход. Ни одного из этих изображений нет в обучающем наборе.
Что обычная Qwen-Image 2.1 делает с маленьким изображением
Qwen-Image 2.1 и сама по себе неплохо восстанавливает фотографии, а её типичная ошибка противоположна размытию. Получив задачу увеличить сжатое фото или фото низкого разрешения, она придумывает детали: поры, веснушки, щетину и зерно, которых в оригинале никогда не было, а лица перерисовывает на несколько лет старше, чем человек на снимке. Ещё она сдвигает объекты. По тестовому набору автора худший угол результата обычной Qwen-Image 2.1 отклонялся от полноразмерного оригинала на 2.35 px: на экране это мало, но достаточно, чтобы результат нельзя было наложить обратно на источник.
LoRA обучали жертвовать частью этой выдуманной текстуры ради того, чтобы оставаться в пределах изображения. Это перерисовка, а не восстановление: мелкие детали по-прежнему выдуманы, просто их меньше, и в карточке об этом сказано прямо.
- Без триггерного слова. Сначала увеличьте изображение примерно до 2 МП (обе стороны кратны 32), подайте его как изображение 1 и отправьте запрос.
- Strength 1.0 для маленького или сжатого изображения в фокусе.
- Strength 0.75, если нужно немного больше собственной текстуры Qwen.
- Strength 0.5 для размытого фото, смазанного снимка или кадра из видео.
Restore the photo: remove blur, noise and compression artifacts and recover sharp, natural detail, keeping the same composition, people and colors.Для поцарапанного или выцветшего отпечатка в карточке используется второй запрос, который также восстанавливает цвет:
Restore the old photo: remove scratches, dust, fading and grain and recover sharp, natural detail and color, keeping the same composition and people.Замер на отложенной выборке
Восемь собственных изображений автора, уменьшенных до 512 или 560 px по длинной стороне и сохранённых в JPEG с качеством 70, затем увеличены примерно до 2 MP и восстановлены с одним и тем же seed, LoRA на 1.0, CFG 1, euler / simple. Каждое число измеряется относительно оригинала в полном размере, который модель никогда не видит. В столбцах с 8 шагами используется Viggle Turbo; в столбцах с 25 шагами нет:
| восемь отложенных изображений | без LoRA, 8 шагов | с ней, 8 шагов | без LoRA, 25 шагов | с ней, 25 шагов |
|---|---|---|---|---|
| расстояние от оригинала, медиана по худшему углу | 2.35 px | 0.26 px | 1.59 px | 0.15 px |
| то же, худшее из восьми | 3.83 px | 0.38 px | 3.25 px | 0.26 px |
| близость к оригиналу (SSIM, 1 = идентично) | 0.578 | 0.766 | 0.743 | 0.812 |
| PSNR | 23.2 dB | 28.0 dB | 26.3 dB | 29.3 dB |
| сдвиг цвета и яркости | 2.05 % | 0.97 % | 1.72 % | 1.04 % |
| то же лицо (распознавание лиц, 1 = идентично) | 0.821 | 0.905 | 0.837 | 0.901 |
| мелкие детали, относительно оригинала | 121 % | 78 % | 58 % | 36 % |
Строка мелких деталей: весь компромисс в одном числе. Больше 100 % означает выдуманные детали: на 8 шагах обычная Qwen-Image 2.1 рисует больше зерна, чем есть в оригинале, а на 25 шагах примерно вдвое меньше, чем в оригинале. С LoRA оба показателя ниже, чем у оригинала, поэтому результат выглядит немного сглаженным. Автор также прогнал ещё 29 изображений через тот же 8-шаговый тест: отклонение 0.28 px с LoRA против 2.16 px без неё, совпадение лица 0.88 против 0.79, SSIM 0.777 против 0.611.
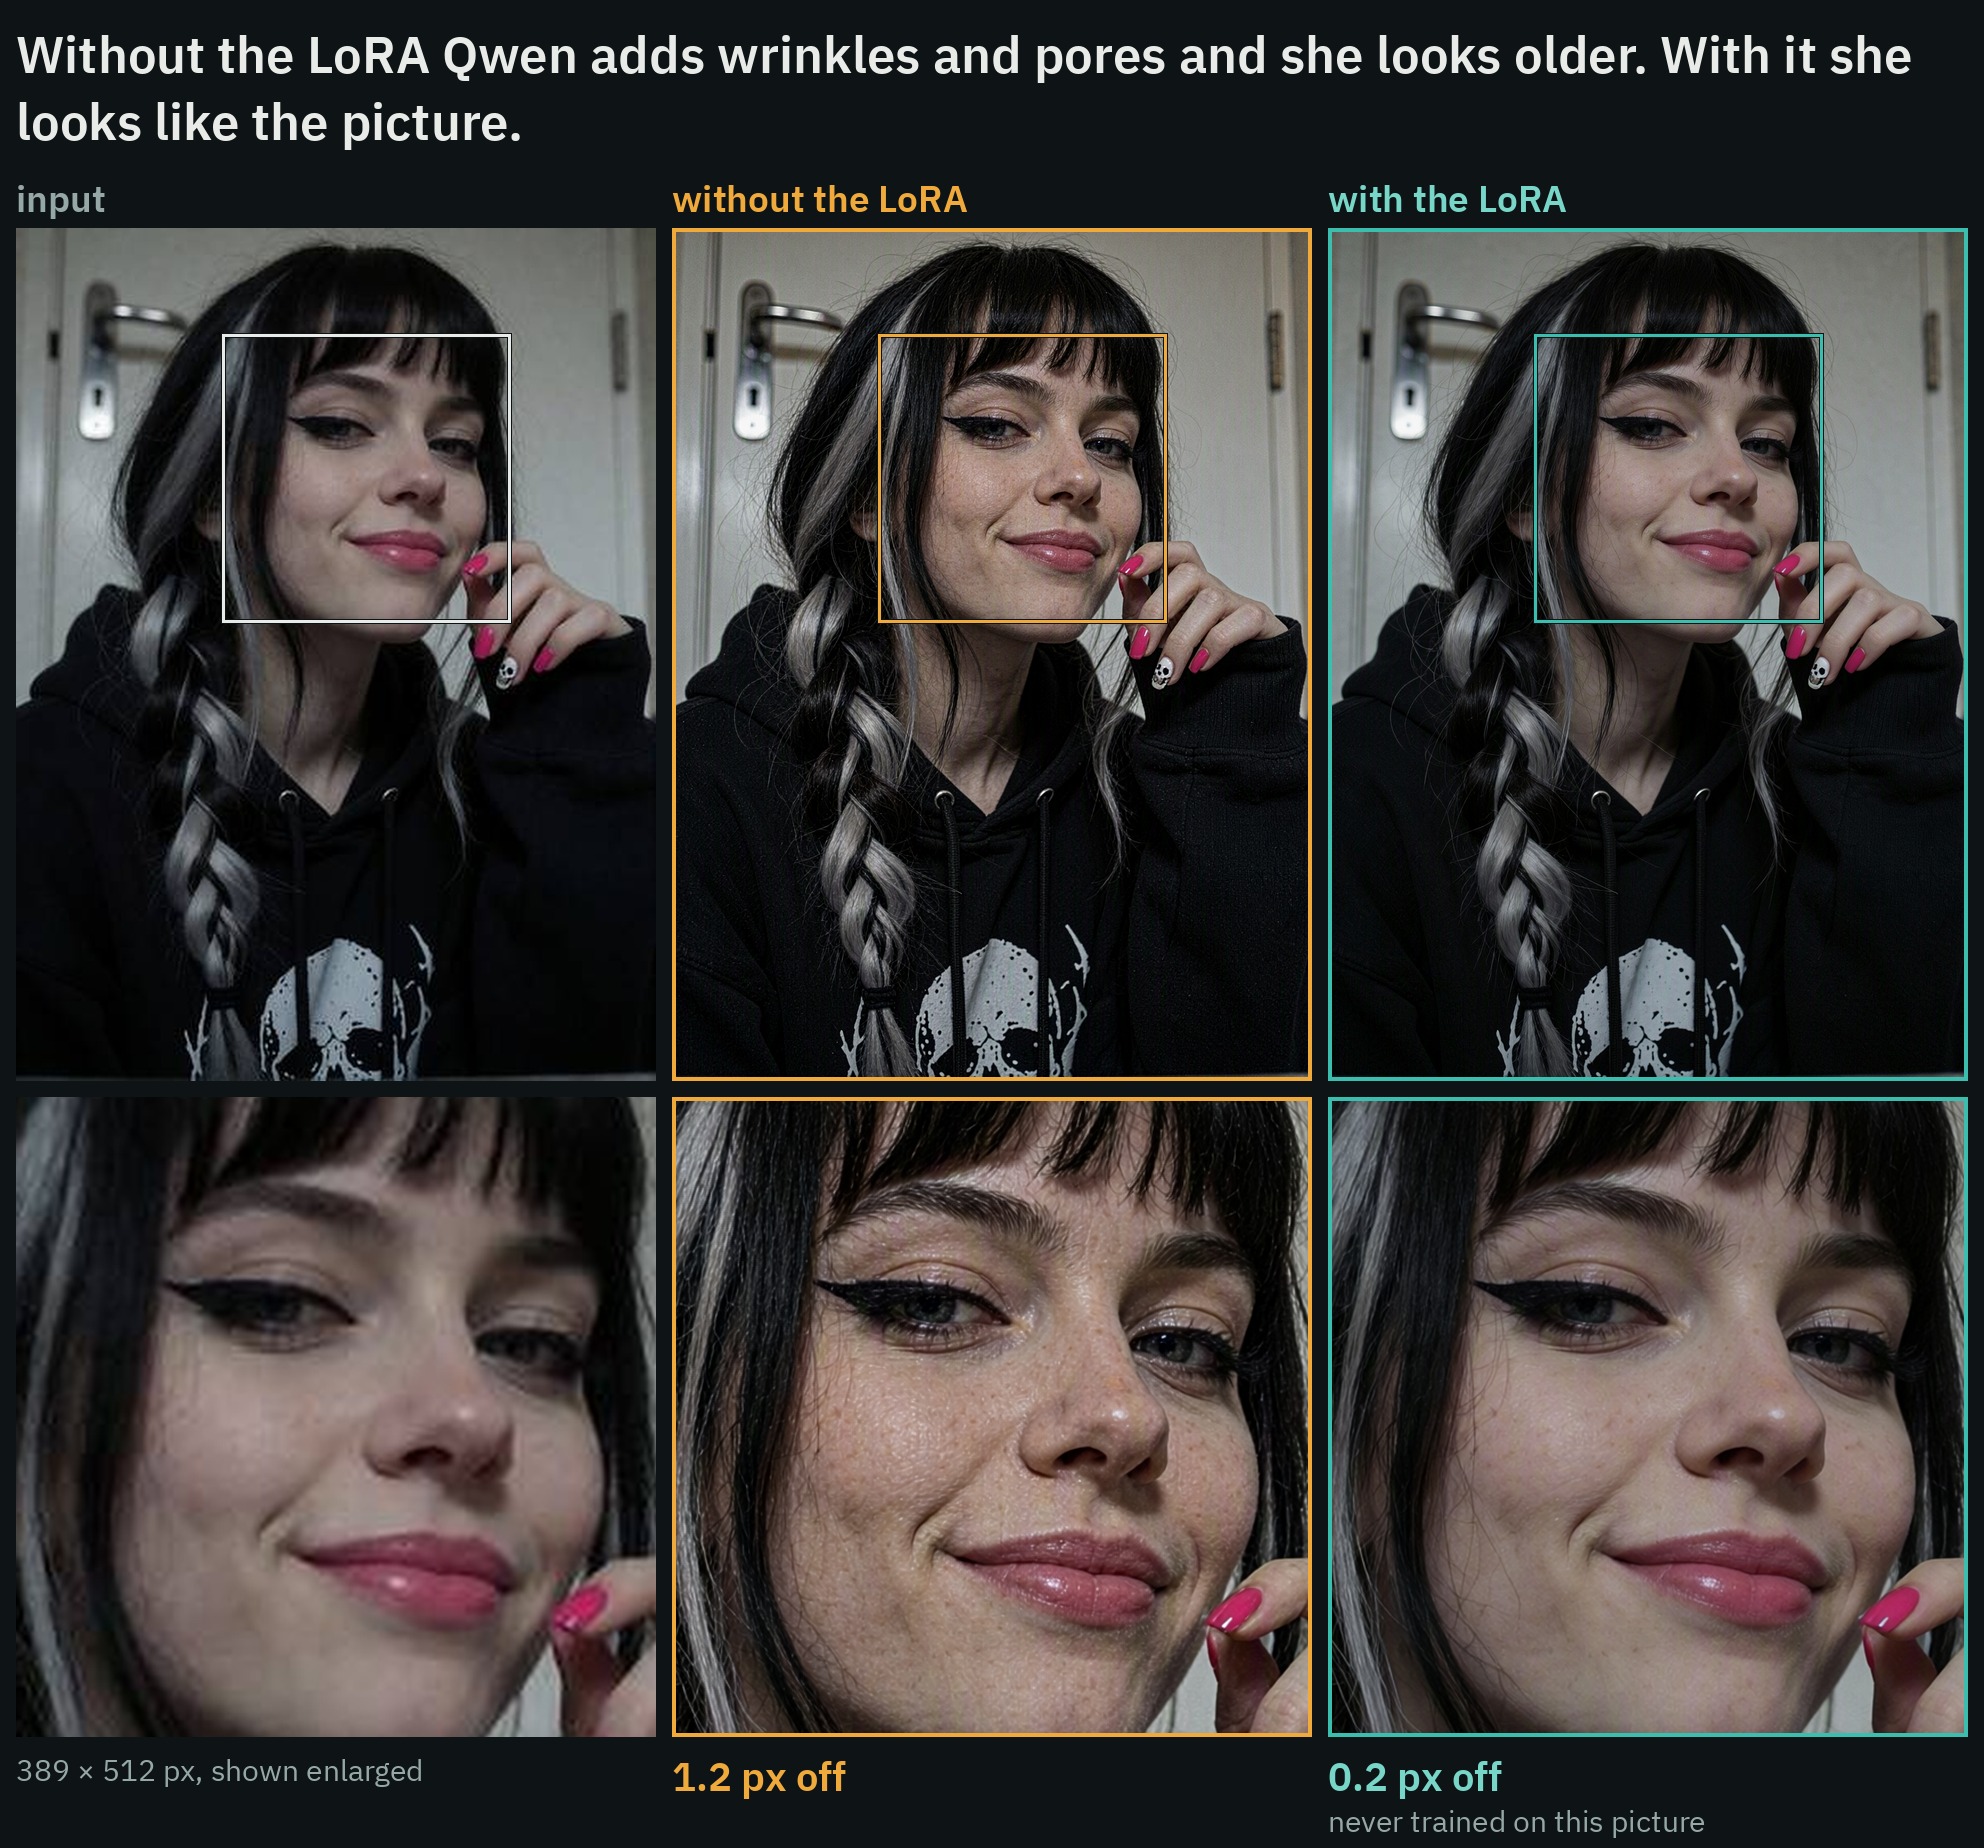
JPEG размером 389 px, увеличенный до 2 MP. Ни одного из этих изображений нет в обучающем наборе.
Все виды повреждений
В релизе также сообщается о 57 отложенных парах, повреждённых так же, как обучающие пары: один проход в 8 шагов при обычном запросе. SSIM измеряется относительно чистого изображения, а «отклонение в px» является медианой:
| вид повреждения | изображений | SSIM, повреждённый вход | SSIM, без LoRA | SSIM, с ним | отклонение в px, без LoRA | отклонение в px, с ним |
|---|---|---|---|---|---|---|
| маленькая веб-картинка | 15 | 0.772 | 0.524 | 0.716 | 2.53 | 0.31 |
| сглаживание камерой телефона | 5 | 0.836 | 0.565 | 0.857 | 2.65 | 0.17 |
| кадр видео | 5 | 0.771 | 0.578 | 0.745 | 2.77 | 0.50 |
| сохранено и пересохранено | 5 | 0.816 | 0.560 | 0.794 | 2.21 | 0.24 |
| размытие и шум | 5 | 0.496 | 0.521 | 0.678 | 2.48 | 0.24 |
| JPEG низкого разрешения | 5 | 0.777 | 0.531 | 0.763 | 3.16 | 0.23 |
| сильная смесь | 5 | 0.735 | 0.646 | 0.746 | 1.28 | 0.25 |
| старый отпечаток | 4 | 0.551 | 0.437 | 0.749 | 2.46 | 0.19 |
| бандинг | 4 | 0.915 | 0.463 | 0.843 | 2.34 | 0.17 |
| PNG низкого разрешения | 4 | 0.873 | 0.636 | 0.847 | 3.39 | 0.15 |
| все | 57 | 0.756 | 0.544 | 0.762 | 2.70 | 0.23 |
С LoRA результат оказался ближе к чистому изображению во всех 57 случаях, и отклонение было меньше во всех 57. Для нескольких видов повреждений само повреждённое изображение получает оценку выше, чем при любом восстановлении, потому что мягкое изображение в среднем ближе к чистому.
Старые отпечатки получили собственные показатели на четырёх отложенных примерах: цвет и яркость отличались от чистого изображения на 15 % ДО восстановления, на 7 % ПОСЛЕ него при обычном запросе и на 4 % при запросе для старых фото. Царапины, пыль и зерно уходили при любом из запросов. Разновидность выцветания, которую модель не видела, может остаться: во втором тесте с другим выцветанием царапины ушли, а выцветший цвет остался.
Сила как регулятор
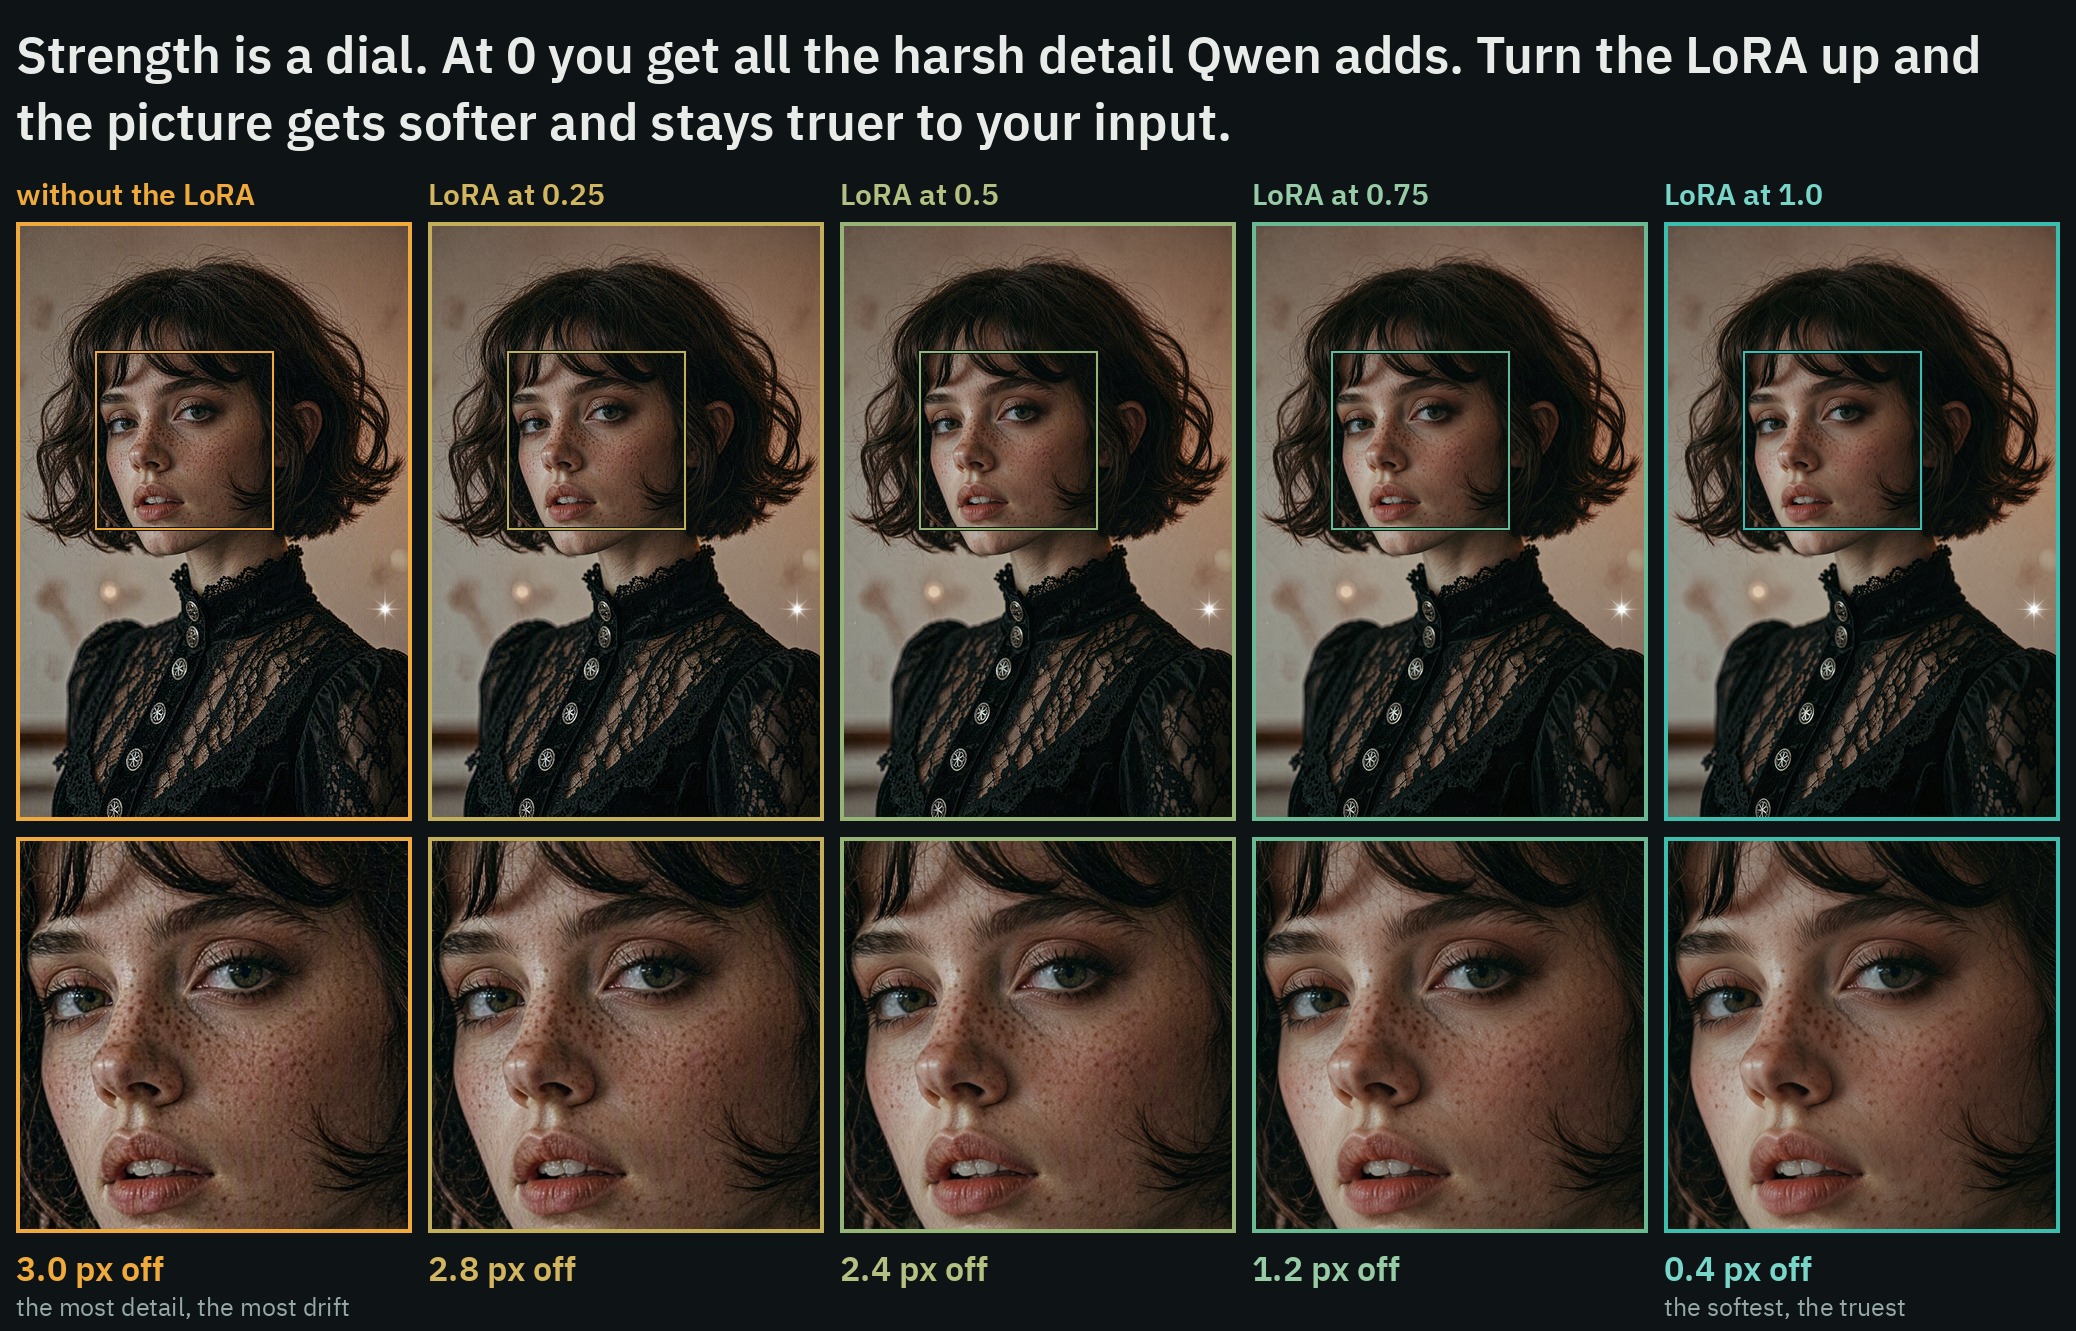
На наборе из 29 изображений вся шкала идёт от чистого Qwen при 0 до наиболее точного результата при 1.0:
| сила | выкл. / 0.5 / 0.75 / 1.0 |
|---|---|
| отклонение от оригинала | 2.16 px / 1.31 px / 0.37 px / 0.28 px |
| схожесть лица | 0.794 / 0.858 / 0.875 / 0.880 |
| сдвиг цвета и яркости | 1.88 % / 1.26 % / 1.05 % / 0.94 % |
| мелкие детали, относительно оригинала | 102 % / 81 % / 77 % / 72 % |
Именно на размытых фотографиях регулятор значит больше всего. Автор прогнал 26 реальных фотографий низкого разрешения (старые селфи и снимки с телефона) при 1.0, 0.75 и 0.5. На шести самых размытых результат при 1.0 получился мягким, 0.75 почти не помог, а 0.5 дал резкий результат; на остальных двадцати сработали все три настройки, а 1.0 дал самый гладкий результат. Увеличение мягкой фотографии тайлами до 8 МП тоже дало резкий результат при 1.0 на трёх изображениях, которые так пробовали.
LoRA обучалась на фотографиях и держится также на рисунках. На шести тестовых рисунках (аниме, постер с надписями, акварель, 3D-мультфильм, манга, картина маслом) она сохранила стиль и надписи: SSIM 0.714 против 0.491 без неё и отклонение 0.27 px против 2.65 px.
Сравнение с другими инструментами
В карточке релиз сравнивается с другими инструментами, которые удалось найти для той же задачи, на тех же 29 изображениях, с теми же измерениями, все запускались при 1.0. Они созданы не для одного и того же: некоторые предназначены добавлять детали, а эта LoRA создана, чтобы оставаться на изображении, поэтому таблица отвечает на один вопрос: насколько результат остаётся близким к оригиналу:
| 29 маленьких изображений | отклонение от оригинала | сходство лица | сдвиг цвета и яркости | SSIM |
|---|---|---|---|---|
| Только Qwen Image 2.1 | 2.16 px | 0.79 | 1.88 % | 0.611 |
| SeedVR2 (3B), собственные узлы ComfyUI | 0.42 px | 0.82 | 0.44 % | 0.771 |
| Deblur anything | 0.39 px | 0.85 | 1.42 % | 0.702 |
| Detail Enhancer, в том же графе | 2.07 px | 0.76 | 2.94 % | 0.673 |
| Detail Enhancer, собственный рабочий процесс, 25 шагов | 12.45 px | 0.71 | 4.16 % | 0.590 |
| эта LoRA | 0.28 px | 0.88 | 0.94 % | 0.777 |
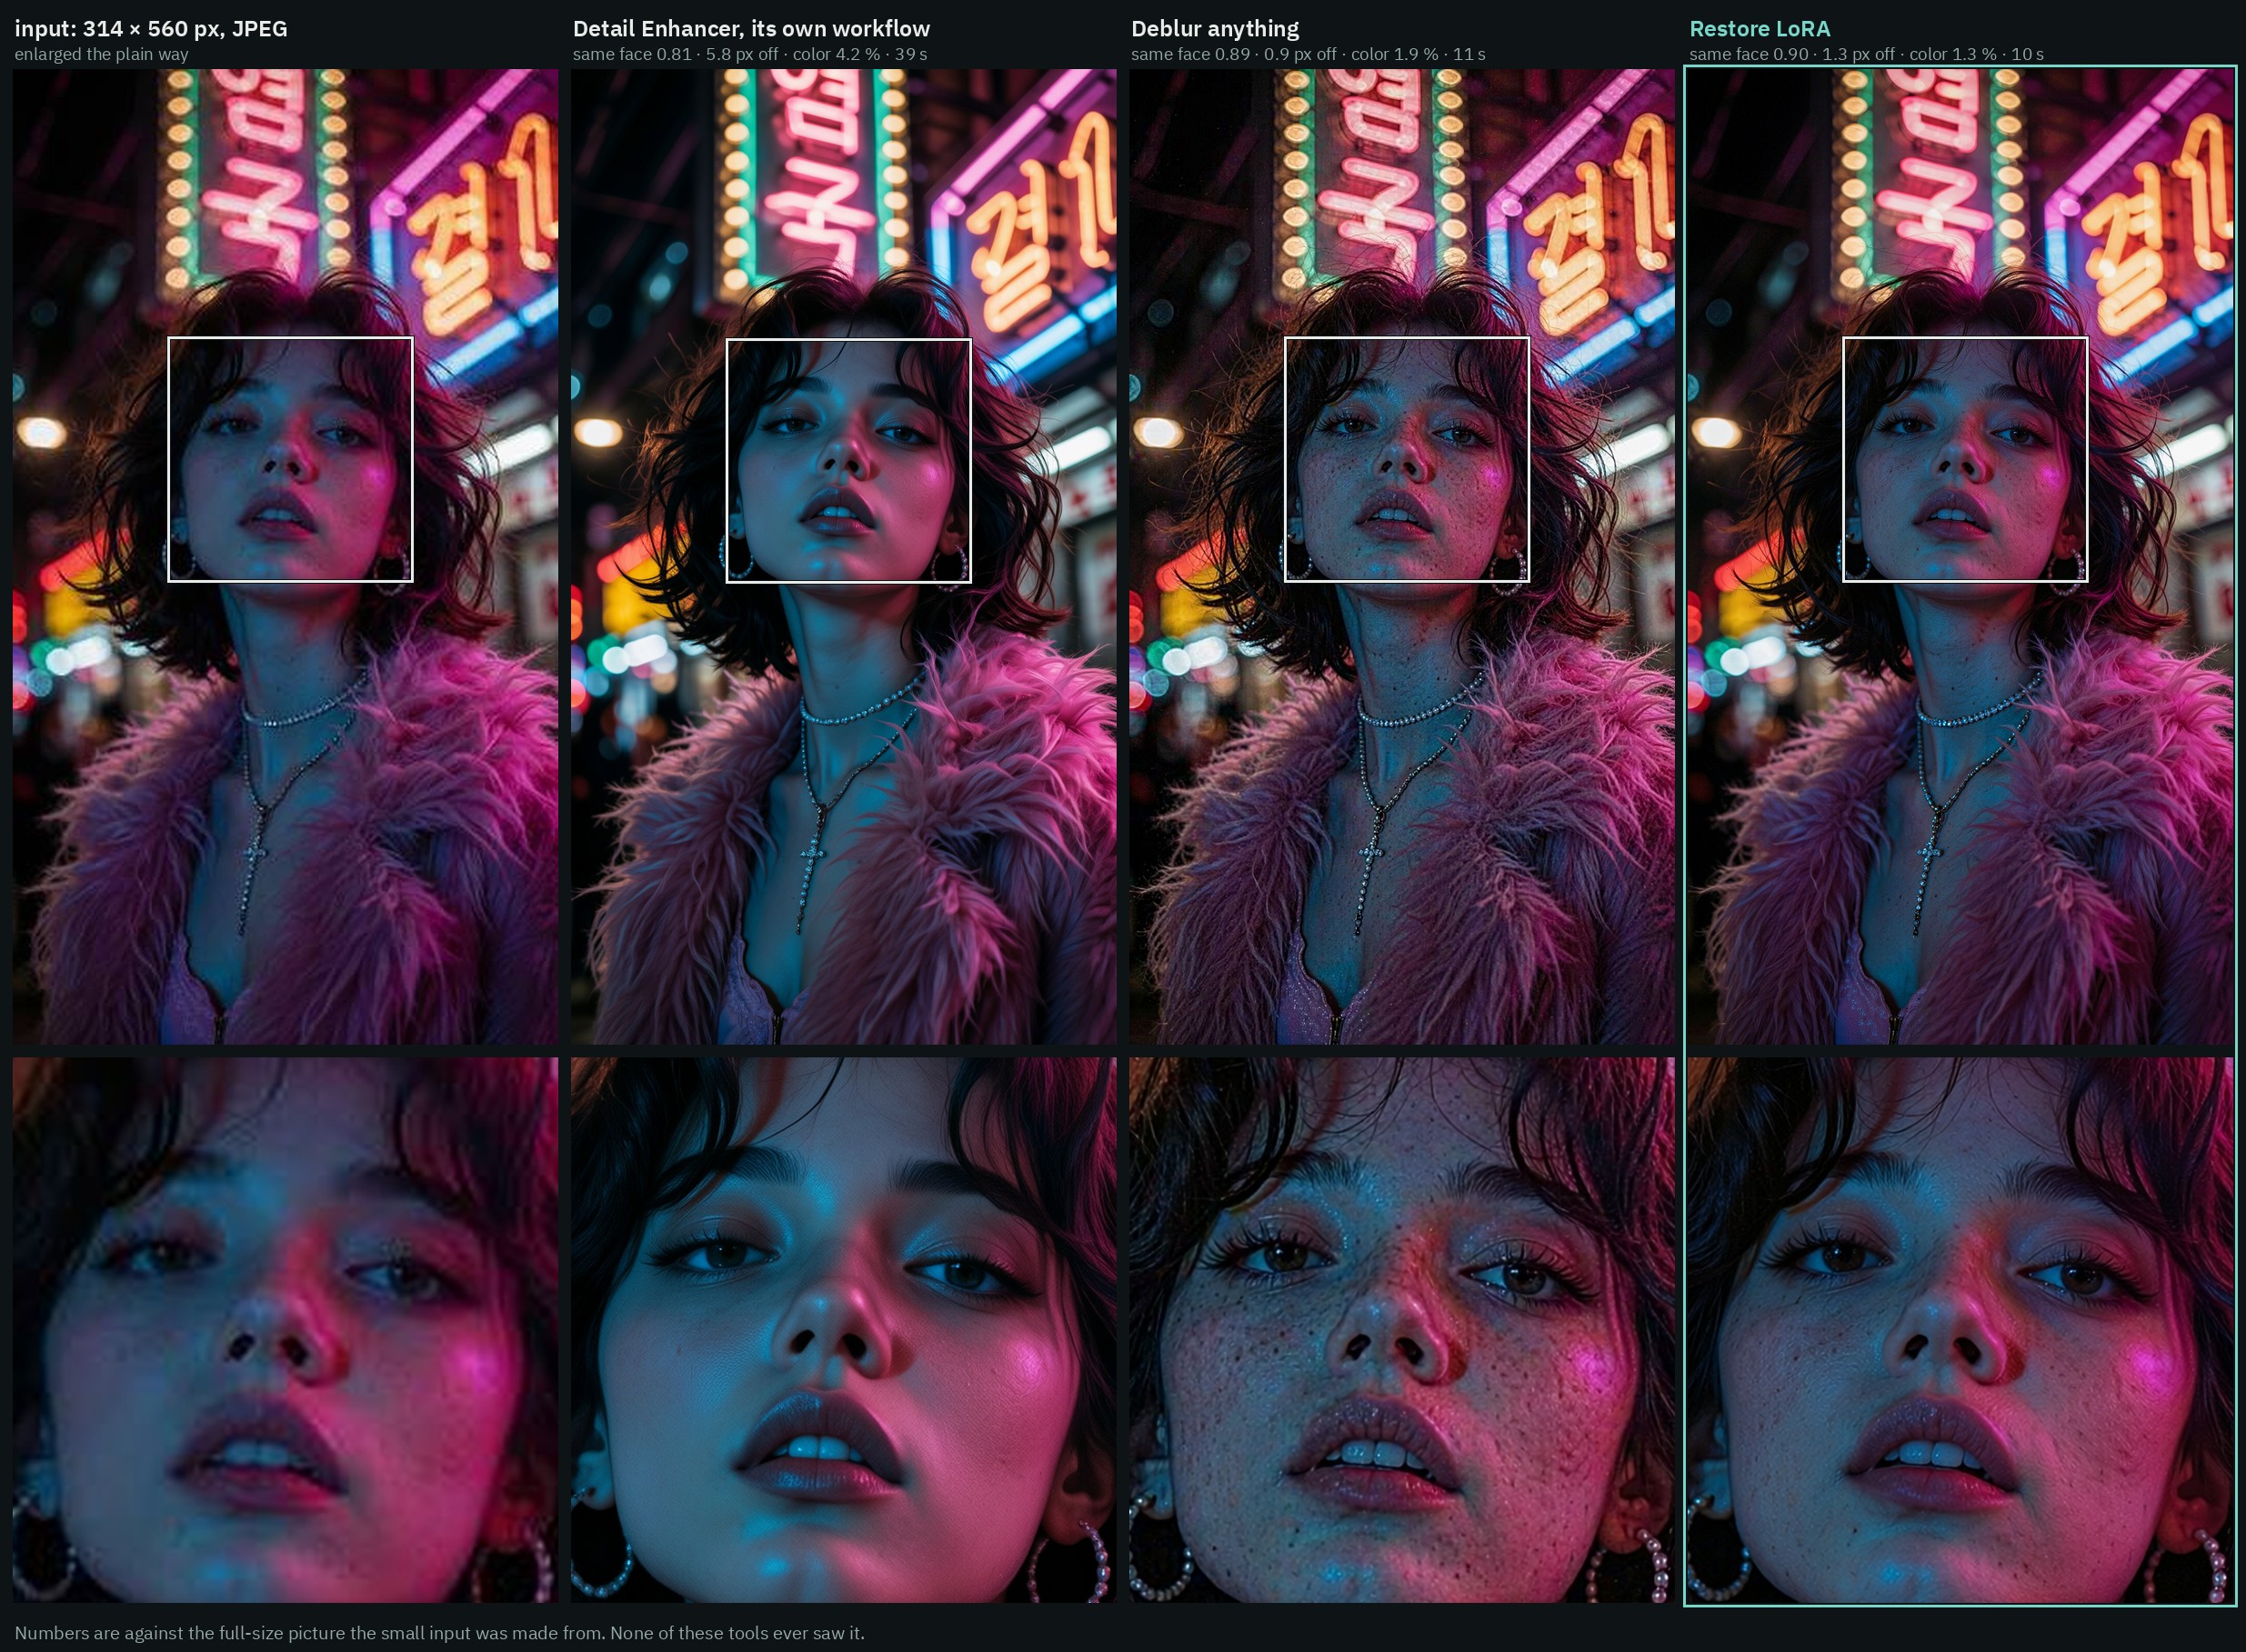
По SSIM LoRA оставалась ближе к оригиналу, чем Detail Enhancer, на всех 29 изображениях (28 из 29, когда Detail Enhancer запускает собственный рабочий процесс), чем Deblur anything, и чем SeedVR2 на 18 из 29. Лицо она сохраняла лучше, чем Detail Enhancer, в 28 из 28 случаев, чем Deblur anything в 26 из 28 и чем SeedVR2 в 27 из 28. SeedVR2 безусловно самый быстрый, около 3 секунд против 11, и лучше всех удерживает цвет.
Какой файл использовать
| файл | примечания |
|---|---|
qwen-image-2.1-restore.safetensors | шаг 1 500, начните с него. На тестовых снимках автора этот вариант даёт наиболее близкий результат. Кожа получается немного сглаженной. |
qwen-image-2.1-restore-1250.safetensors | шаг 1 250. Прорисовывает больше мелких деталей и лучше сохраняет текстуру кожи на шумных снимках с телефона. Чуть менее близкий результат. |
Оба варианта имеют rank 32 и используют ключи в формате ComfyUI, поэтому они загружаются на веса Comfy-Org Qwen-Image 2.1 без конвертации.
Запуск в ComfyUI
Адаптер представляет собой model-only LoRA, поэтому для самого восстановления пользовательские ноды не нужны. Поместите файл .safetensors в ComfyUI/models/loras/ и добавьте ноду LoraLoaderModelOnly ПОСЛЕ загрузчика модели со значением strength 1.0, затем подайте Qwen-Image 2.1 маленькое изображение как изображение 1, а запрос выше как промпт. В карточке автора указаны настройки: 8 шагов с Viggle Turbo при CFG 1 или 25 шагов без него.
Готовый рабочий процесс поставляется в папке workflows/ репозитория и собран на нодах ComfyUI-AusBoss автора: том же паке, который используется в его ранее выпущенных релизах.
Ограничения
- Это перерисовка, а не восстановление. Мелкие детали дорисовываются, чтобы вписаться, и обычный Qwen-Image 2.1 рисует их больше.
- Главное здесь: оставаться на исходной картинке, поэтому результат, которому нужно новое содержимое, его не получит.
- Размытый вход при полной силе возвращается мягким. Снизьте до 0.5 или увеличивайте плитками.
- Цифры взяты из собственных тестовых изображений автора и из 25 шагов без Turbo на части набора для сравнения.
- Для результатов свыше 2 МП автор сочетает его со своим рабочим процессом плиточного увеличения на Civitai.
Доступность
- Веса LoRA: ausboss/Qwen-Image-2.1-Restore-LoRA
- Показатели по каждому изображению: comparison_numbers.csv
- Перепаковка базовой модели: Comfy-Org/Qwen-Image-2.1
- Пакет нод автора: ausboss/ComfyUI-AusBoss
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.