Qwen-Image 2.1 Outfit Swap LoRA: смена одежды без сдвига кадра
LoRA от сообщества для Qwen-Image 2.1 меняет одежду прямо на исходном изображении: кадр, лицо и фон остаются, меняется только одежда, в комплекте рабочий процесс ComfyUI.
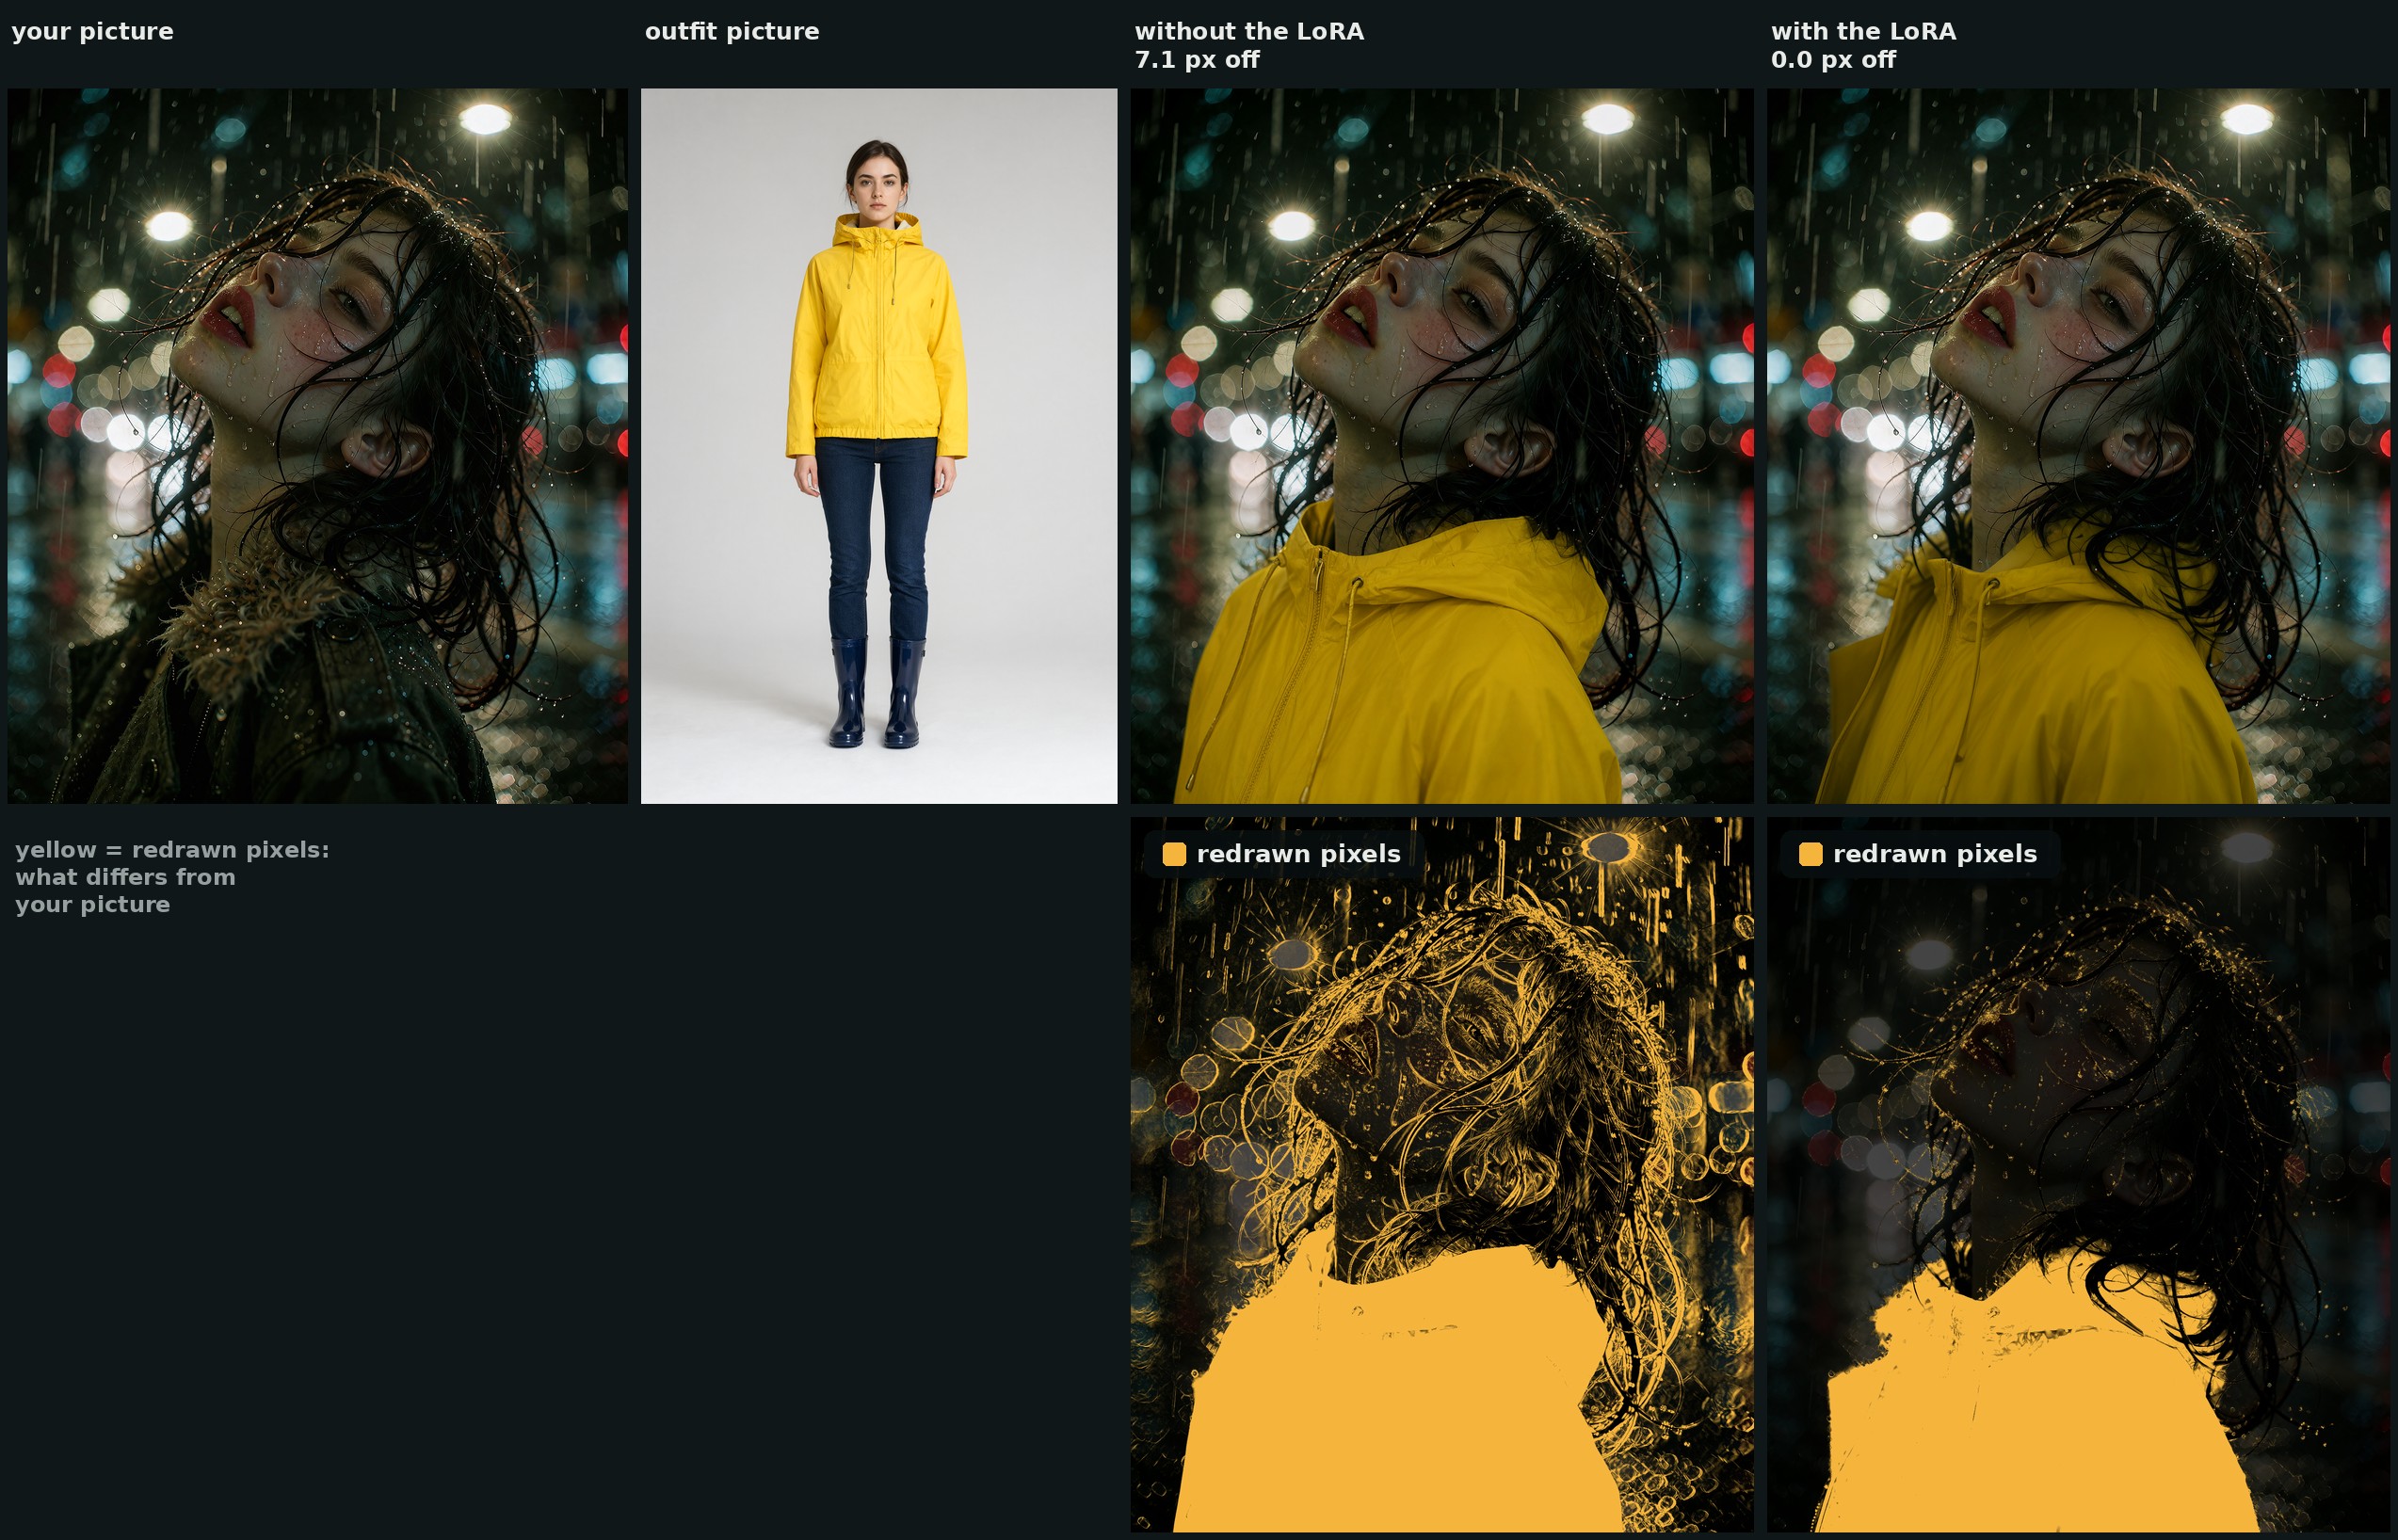
Верх: замена, тот же запрос и seed. Низ: перерисованные пиксели показаны жёлтым. Без LoRA подсвечиваются лицо, окно и стена; с ней отличаются только пальто. Ни этого человека, ни этого пальто нет в обучающем наборе.
Что не так с обычным Qwen-Image 2.1
Каждое редактирование в Qwen-Image 2.1 это новая генерация, поэтому смена одежды перекомпоновывает кадр сильнее, чем саму одежду. Автор выполнил 47 таких замен с обычным Qwen-Image 2.1 и вручную оценил каждую: 24 оказались пригодными, а в остальных 23 что-то было не так. Обычно проблема была не в самой одежде:
- камера отъезжала назад, чтобы вписать весь наряд в кадр,
- штаны добавлялись в кадр, где ног вообще не было,
- тело или позу перерисовывали, чтобы «надеть» новую одежду,
- или всё просто смещалось на несколько пикселей.
При сравнении с изображением человека обычный результат отклонялся примерно на 3,4 px в самом проблемном углу. Это немного, но означает, что результат нельзя наложить обратно на оригинал: лицо перерисовывается чуть мягче, а фон перекрашивается даже там, где об этом не просили. Удержание позы с помощью ControlNet сохраняло сцену на месте, но примерно в одной замене из пяти одежда так и не надевалась, поэтому от этого подхода отказались.
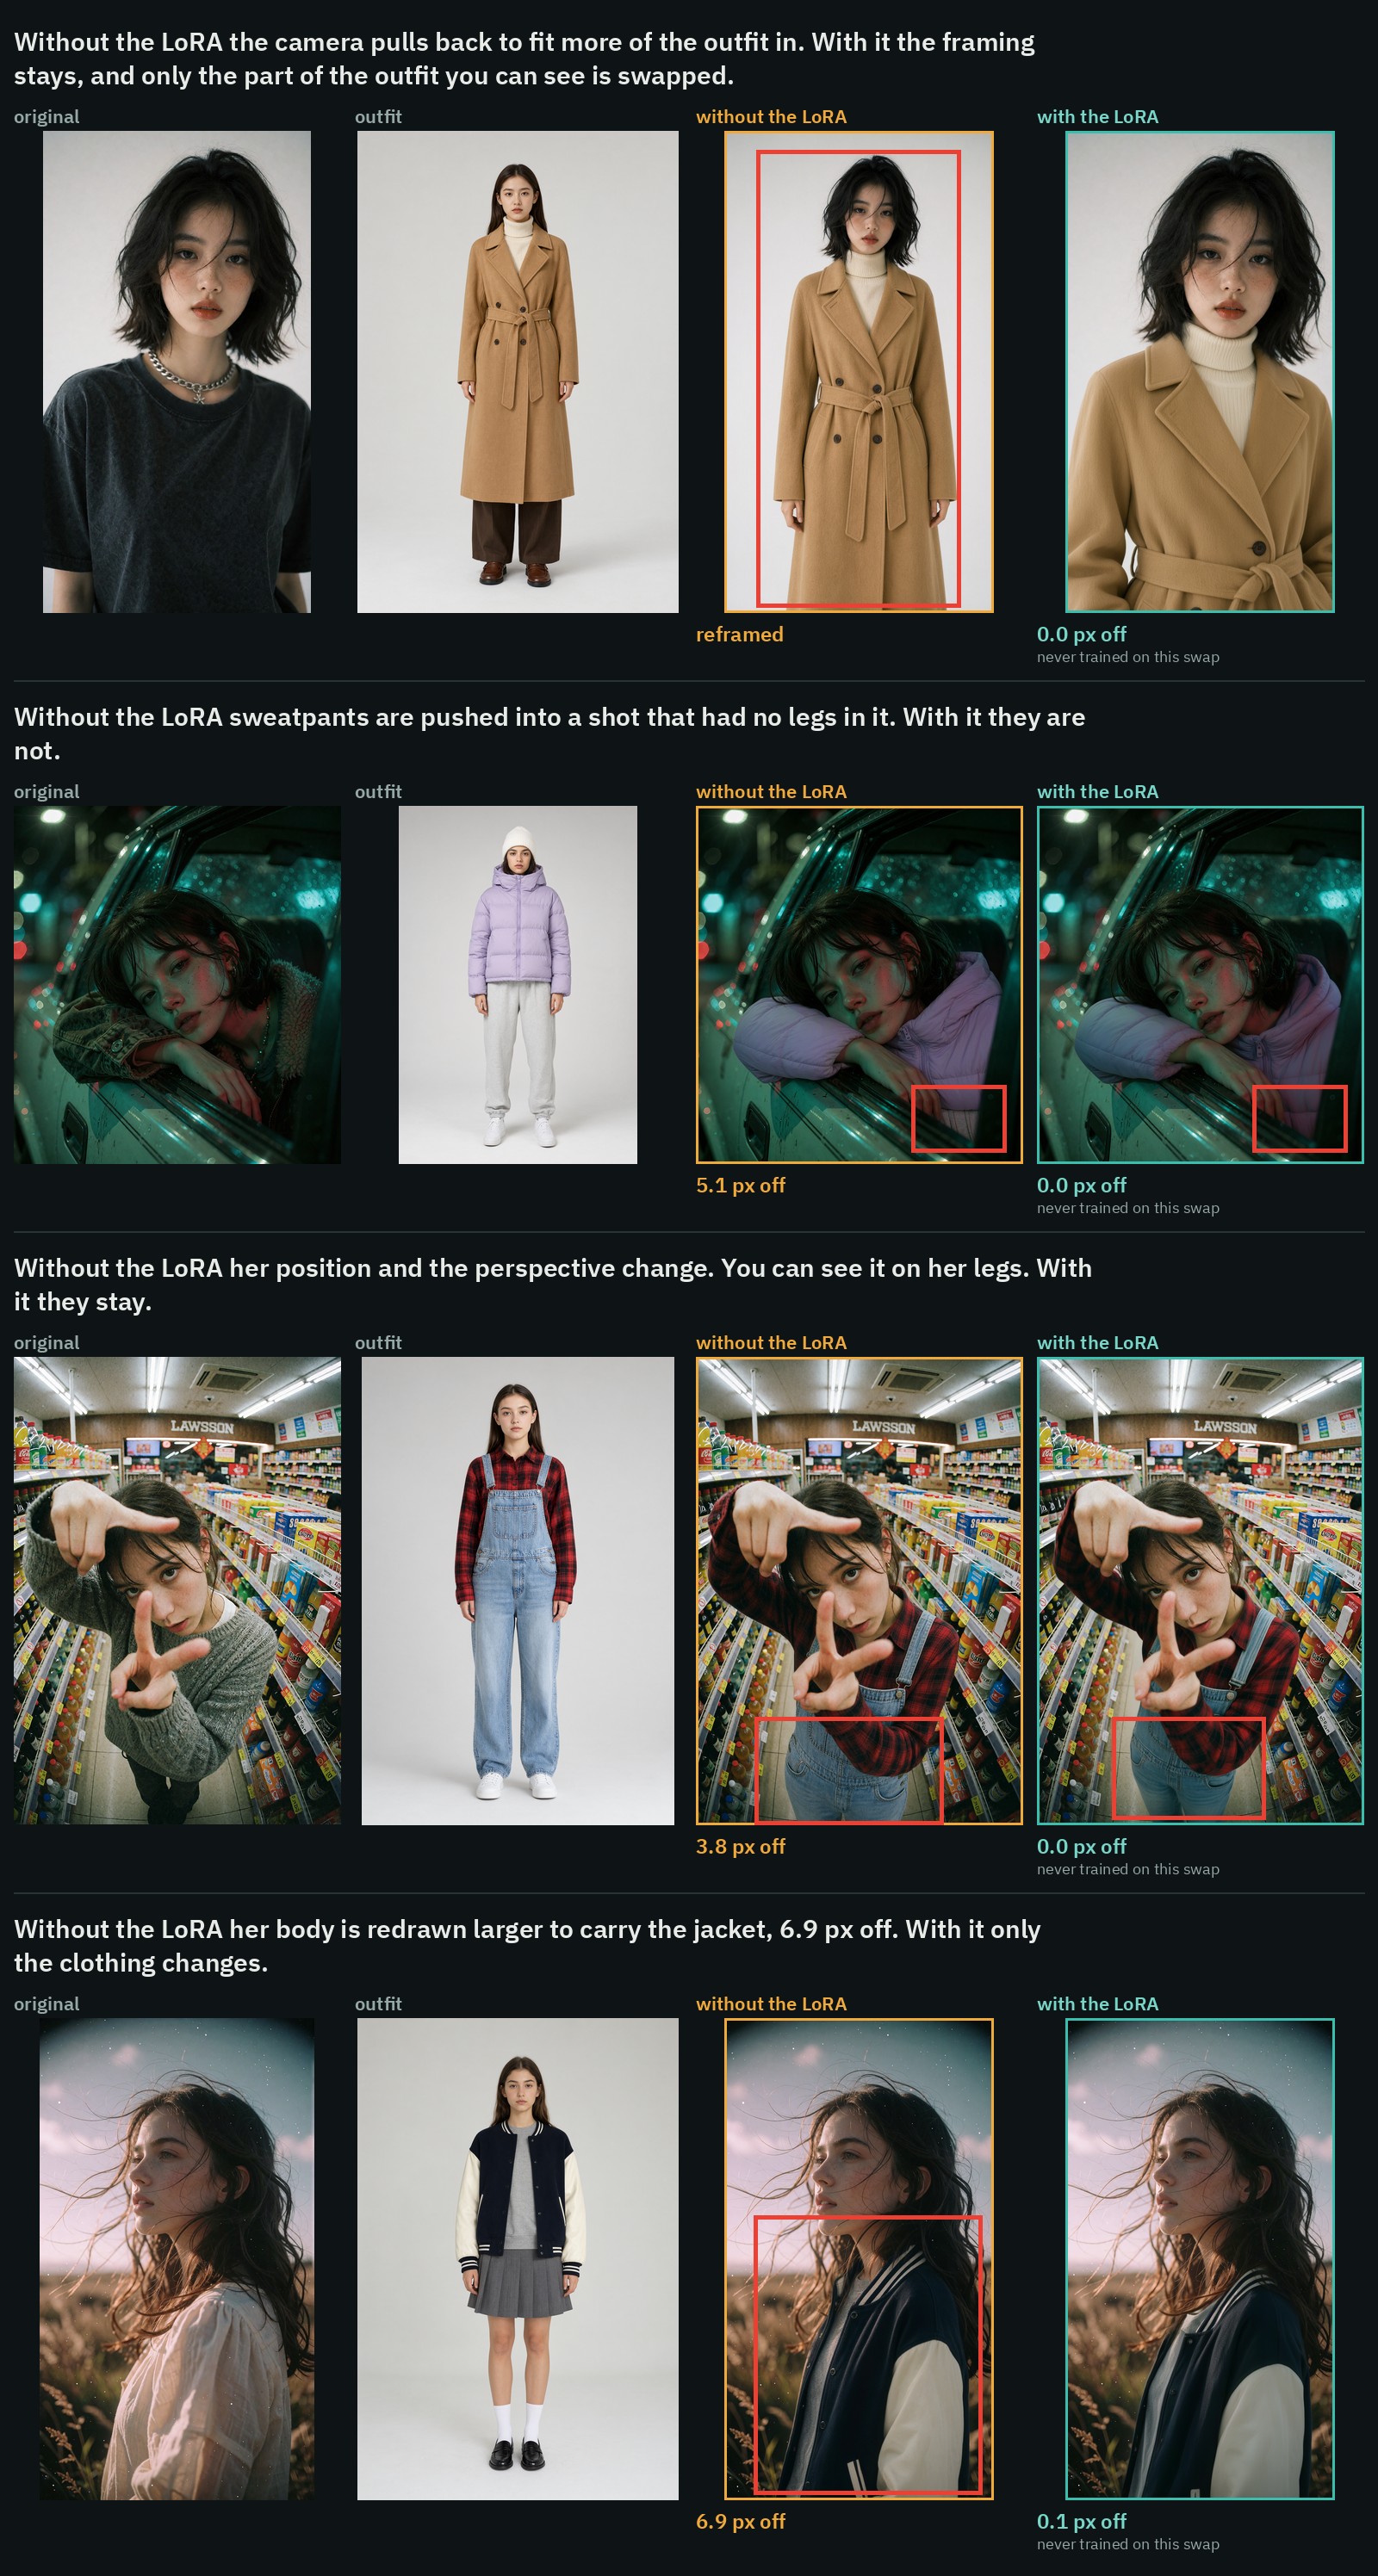
Четыре из тех 47 замен, с одним и тем же рабочим процессом и seed, без LoRA и с ней. Ни одной из них нет в наборе для обучения.
Измеренная устойчивость
Шестнадцать замен, на которых LoRA никогда не обучалась: все прогнаны через один и тот же рабочий процесс примерно при 2 MP, с одинаковым seed, 25 шагов, CFG 1, euler / simple, адаптер на 1.0. «Off» это то, насколько самый проблемный угол результата отстоит от фото человека. Показатели по лицу и фону снимаются после совмещения результата с фото человека, поэтому они учитывают перерисовку, а не смещение:
| шестнадцать отложенных замен | без LoRA | шаг 1,000 | шаг 1,250 | шаг 1,500 |
|---|---|---|---|---|
| смещение худшего угла, медиана | 3.6 px | 0.1 px | 0.1 px | 0.1 px |
| смещение худшего угла, худший из шестнадцати | 7.0 px | 0.2 px | 0.2 px | 0.2 px |
| пиксели лица с заметными изменениями | 14.1 % | 1.7 % | 1.8 % | 2.0 % |
| лицо, PSNR относительно фото человека | 29.8 dB | 37.8 dB | 37.7 dB | 37.1 dB |
| пиксели фона с заметными изменениями | 10.8 % | 0.9 % | 0.9 % | 1.2 % |
| фон, PSNR | 27.6 dB | 40.5 dB | 40.4 dB | 40.0 dB |
Сила имеет значение: шаг 500 при 0.5 дал смещение 1.8 px против 0.1 px при 1.0, то есть при половинной силе возвращается примерно половина смещения. Каждый шаг начиная с 500-го удерживает картинку одинаково, судя по цифрам. Различаются они тем, что происходит с одеждой, которую новый наряд не закрывает.
Для справки: четыре простых сравнения выше дали смещение 4.8, 7.1, 5.2 и 7.2 px без LoRA и 0.1, 0.0, 0.0 и 0.1 px с ней.
Что происходит со старой одеждой
Обычный Qwen-Image 2.1 часто оставляет на месте всё, что не закрывает новый наряд: сапоги под бикини, рваные джинсы под юбкой. Этот шаг определяет большую часть результата. Две замены, по три сида на каждую, обычный запрос:
| джинсы исчезли под новой юбкой | сапоги исчезли вместе с бикини | |
|---|---|---|
| без LoRA | 0 из 3 | 0 из 3 |
| шаг 500 | 0 из 3 | 0 из 3 |
| шаг 1 000 | 2 из 3 | 2 из 3 |
| шаг 1 250 | 0 из 3 | 0 из 3 |
Предложение в конце запроса управляет этим дальше на шаге 1 000. Replace everything they wear. снял колготки под купальником (обувь осталась), а Keep their own shoes and legwear. сохранил сапоги, которые обычный запрос убирал. Ни одного из этих предложений не было ни в одной обучающей подписи, так что это базовая модель слушается, пока LoRA удерживает остальную картинку неподвижной. На шагах 1 250 и 1 500 те же предложения почти ничего не изменили или не изменили вовсе, и это вторая причина, по которой релиз указывает на шаг 1 000. Поставляемый рабочий процесс по умолчанию добавляет Replace everything they wear. в поле, которое можно редактировать.
Какой файл использовать
| файл | примечания |
|---|---|
qwen-image-2.1-outfit-swap.safetensors | шаг 1 000, начните с него. Этот вариант чаще всего полностью убирает старую одежду, а не оставляет её фрагменты. |
qwen-image-2.1-outfit-swap-1250.safetensors | шаг 1 250. Так же хорошо удерживает изображение. Сохраняет больше того, что человек уже носит (ботинки, джинсы под юбкой). |
qwen-image-2.1-outfit-swap-1500.safetensors | шаг 1 500, конец обучения. Такое же удержание, с чуть большими изменениями лица и фона. |
Все три имеют rank 32 и используют имена ключей ComfyUI, поэтому они загружаются на веса Comfy-Org Qwen-Image 2.1 без конвертации.
Запуск в ComfyUI
Адаптер представляет собой LoRA, работающую только с моделью, поэтому для самой замены одежды пользовательские ноды не нужны. Запишите запрос одним предложением, указав человека как изображение 1, а одежду как изображение 2:
Dress the person in image 1 in the <outfit, in a few words> shown in image 2. Keep their face, hair, hands, pose and the background exactly the same.Чтобы добавить её в любой граф редактирования Qwen-Image 2.1 с двумя изображениями:
- Поместите файл
.safetensorsвComfyUI/models/loras/и добавьте ноду LoraLoaderModelOnly сразу после загрузчика модели со значением strength 1.0. - Используйте ноду Text Encode Qwen Image 2.1, указав человека как
image_1, одежду какimage_2,resolutionсо значением 0, а сам запрос в качестве промпта. - Выполните сэмплирование с выхода
latentэнкодера с помощью KSampler при 25 шагах, CFG 1,euler/simple, denoise 1. - Декодируйте с помощью Декодировать VAE, а затем Разделить изображение с альфа-каналом, поскольку VAE модели Qwen-Image 2.1 декодирует RGBA.
Готовый рабочий процесс поставляется вместе с репозиторием. Он собран на нодах ComfyUI-AusBoss автора (2.5.1 или новее) и требует ComfyUI 0.38 или новее; в карточке отмечено, что подойдут любые эквивалентные ноды.
Сравнение одних и тех же замен одежды без LoRA и с ней, из карточки модели.
Другие сравнения
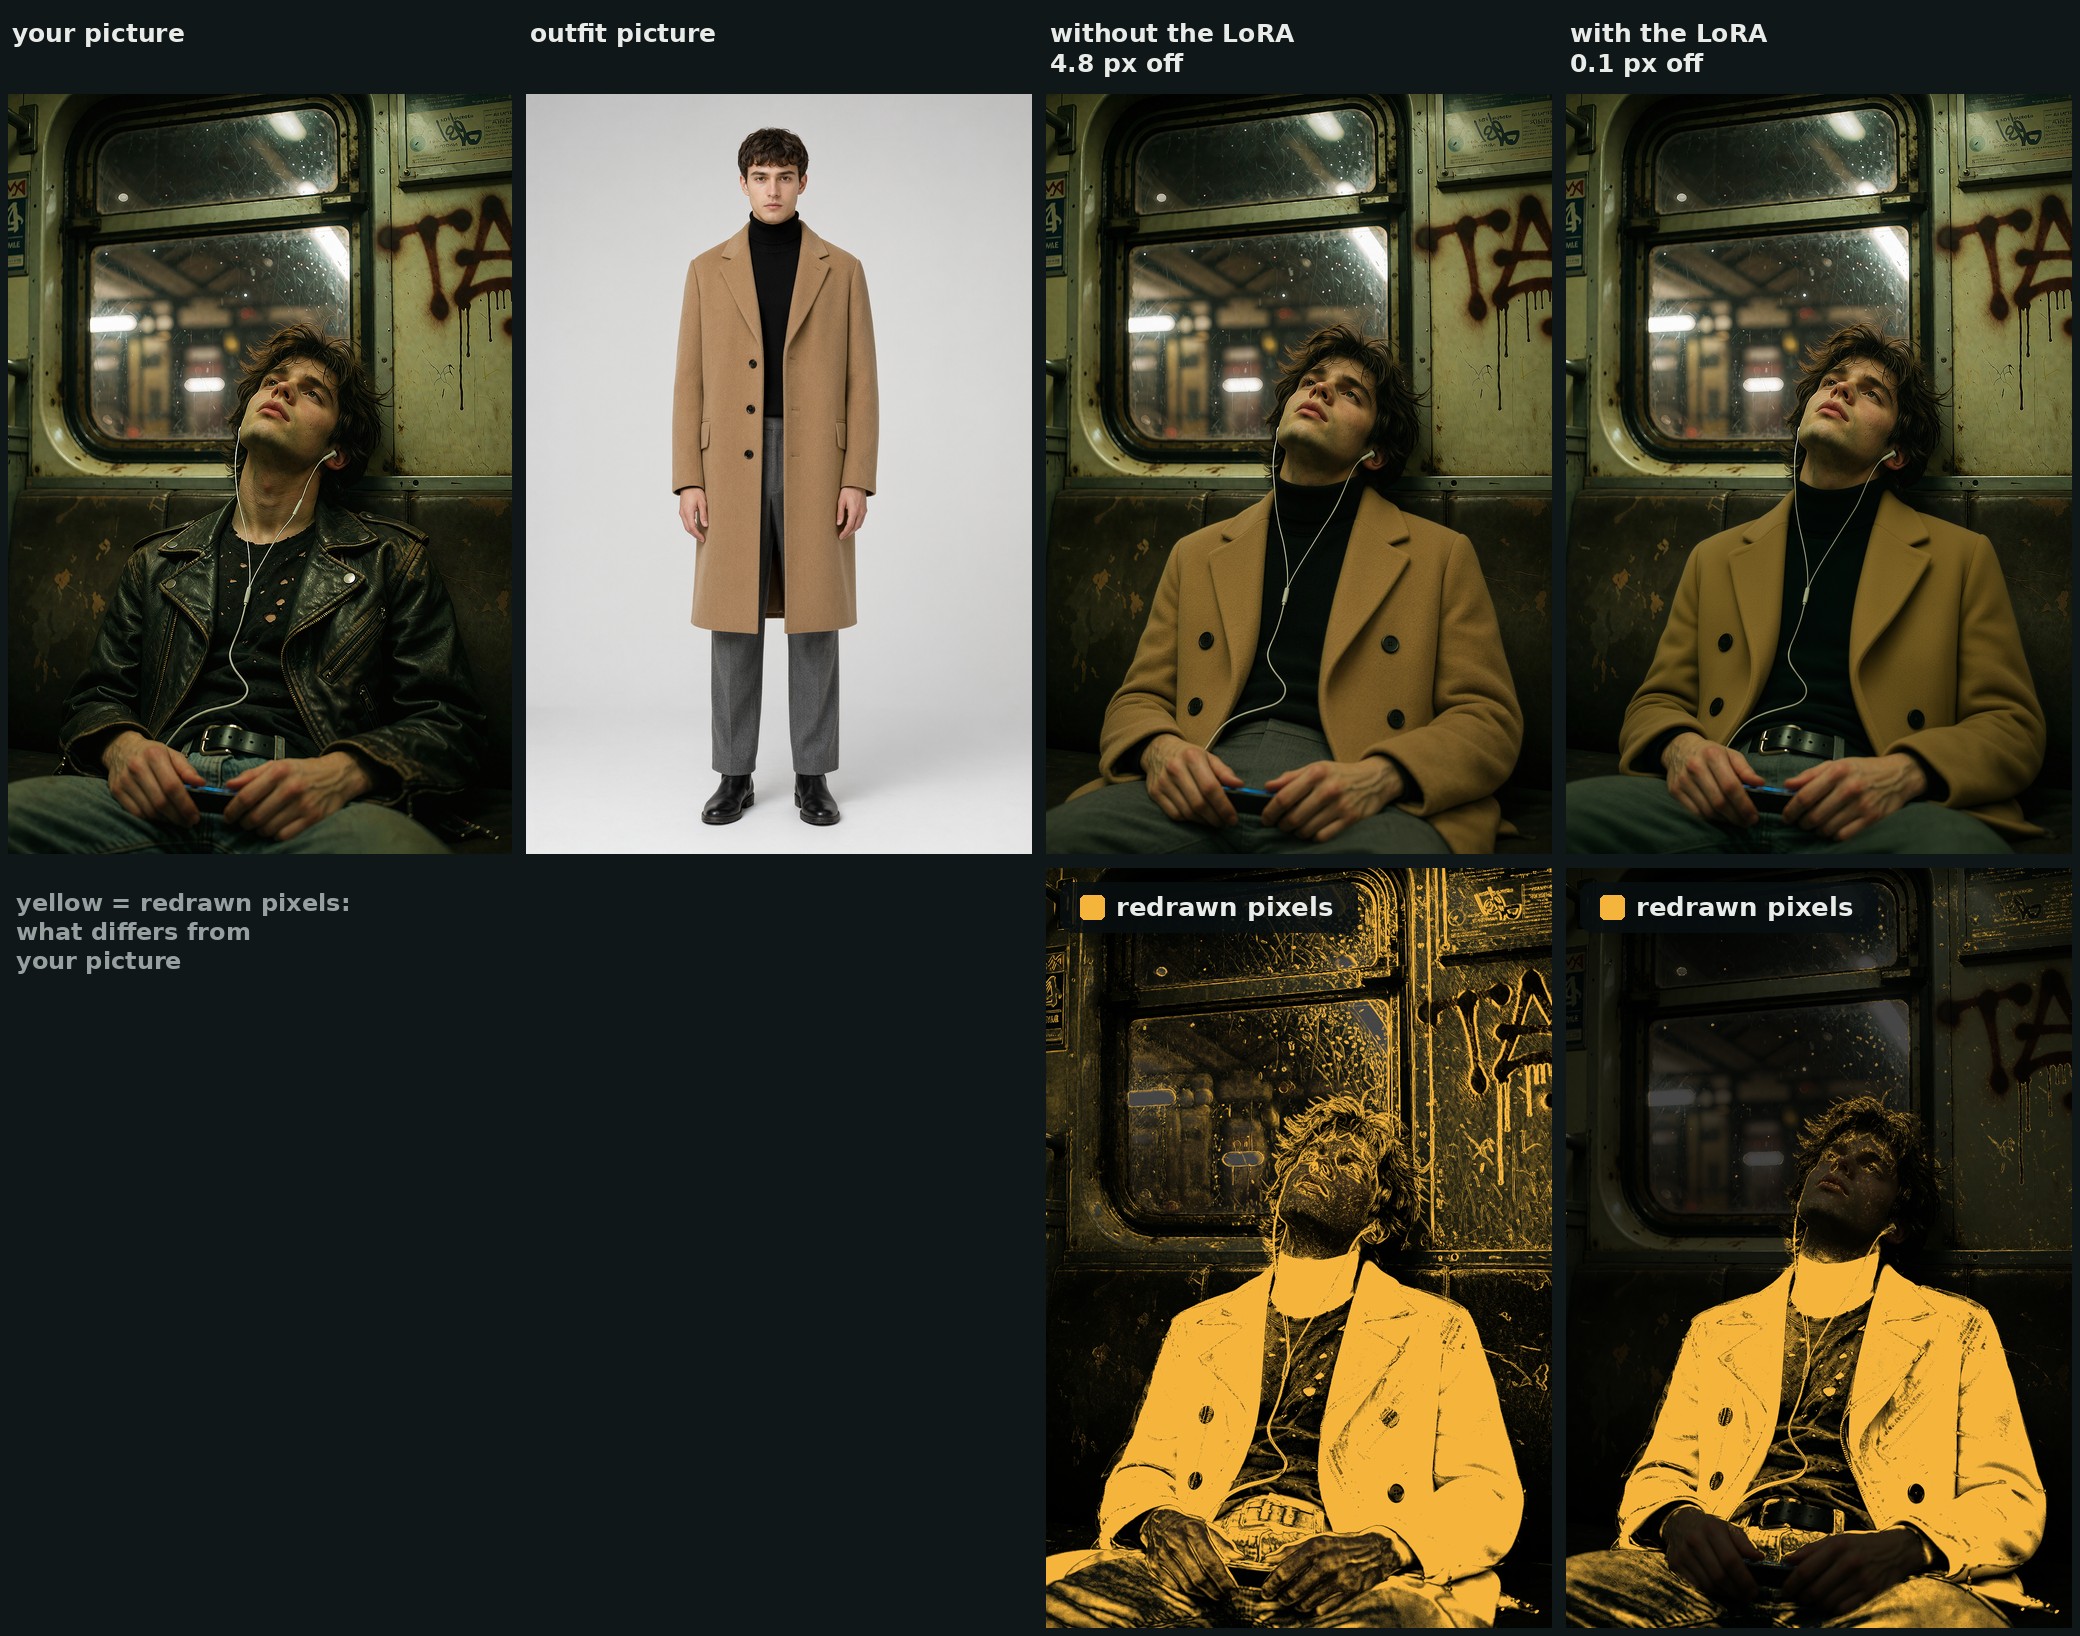
То же сравнение под дождём. Этот человек не входит в обучающий набор.
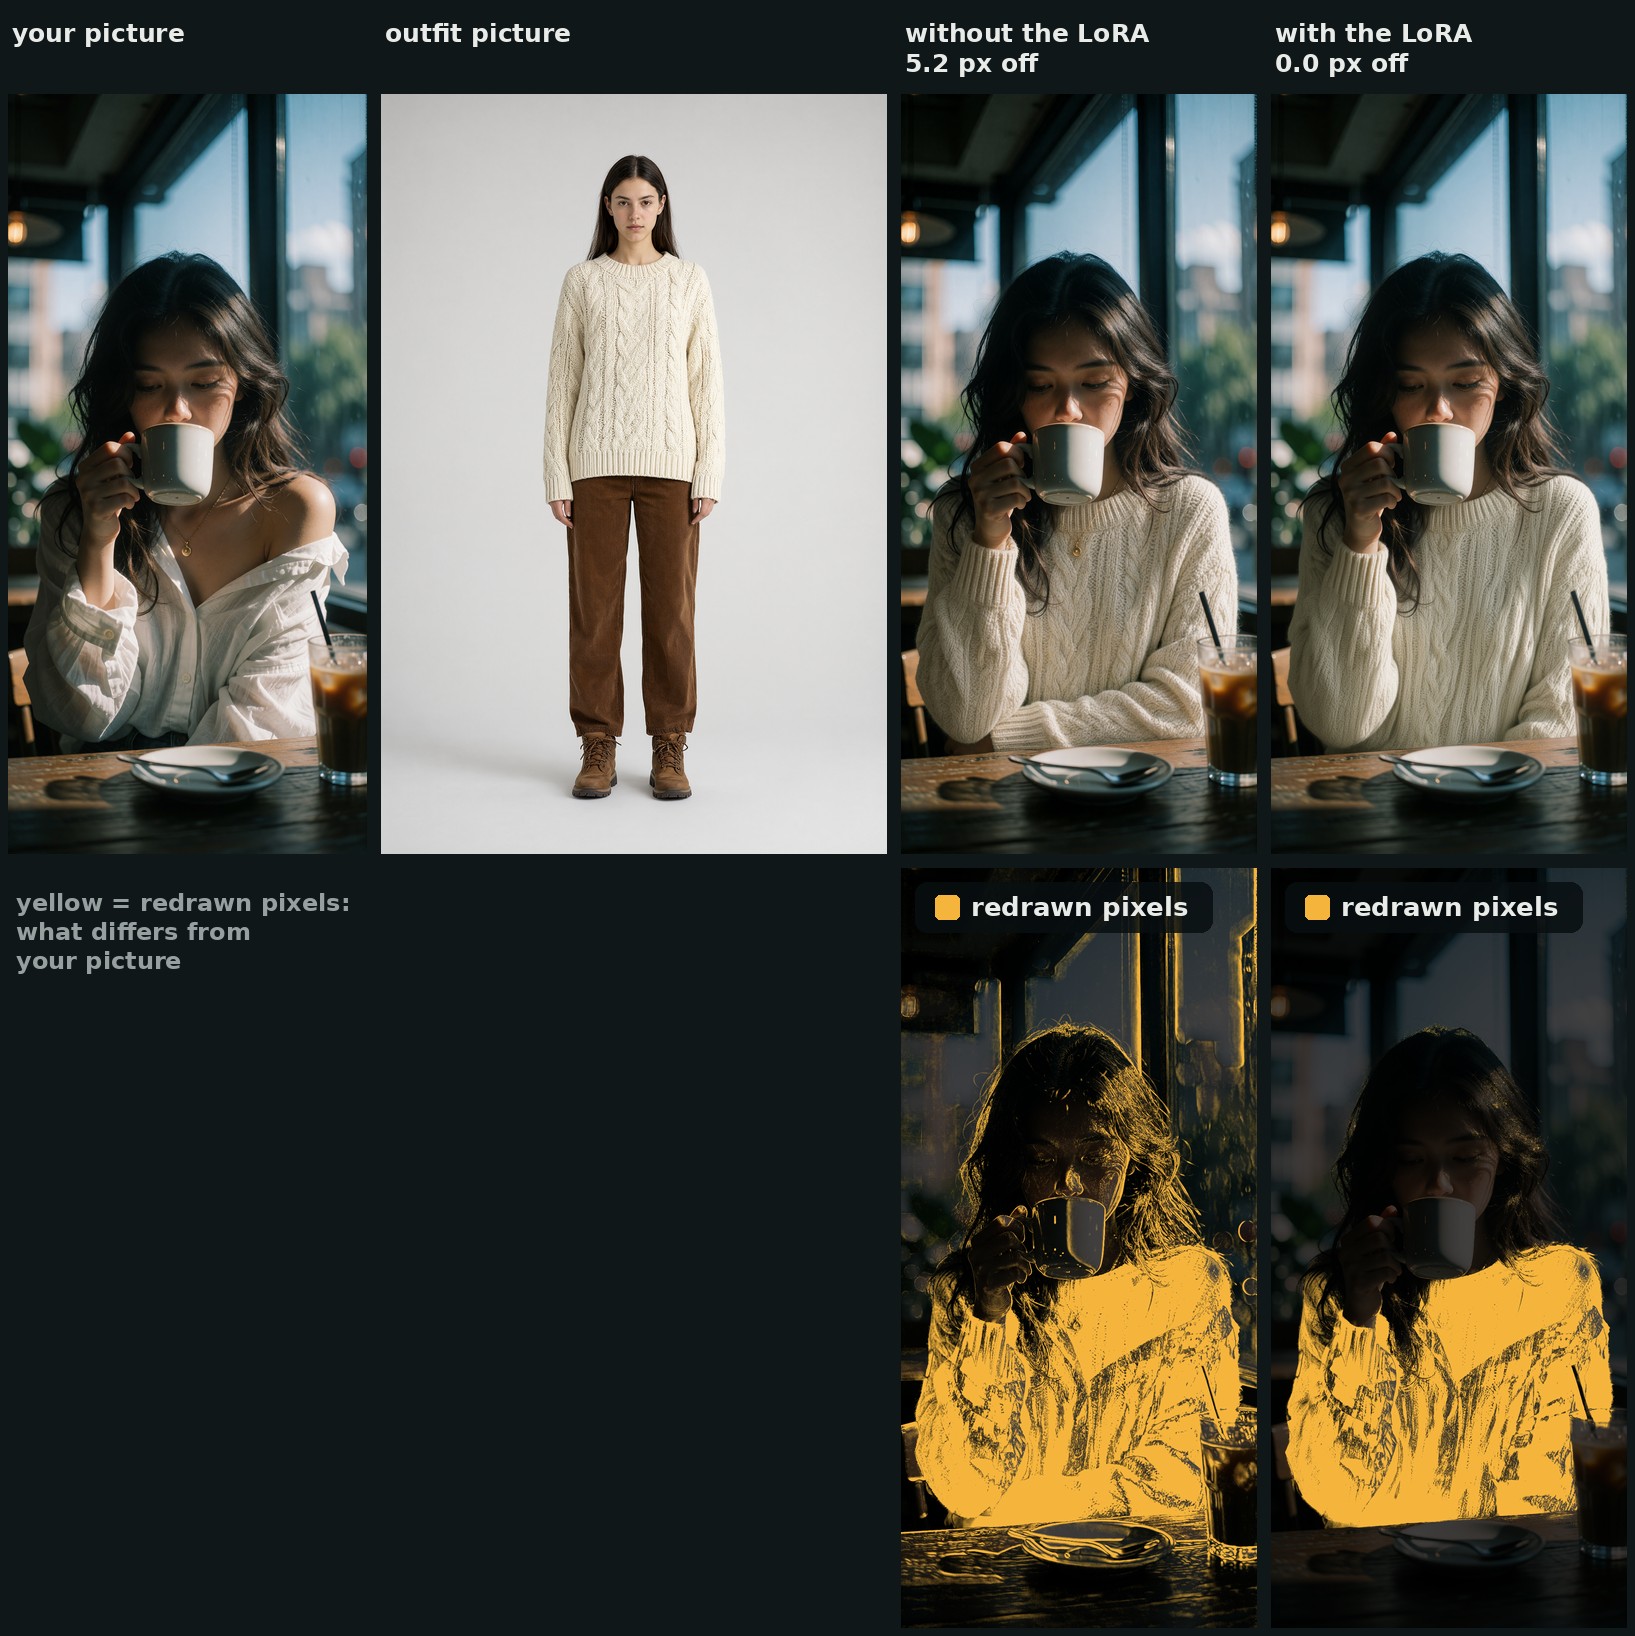
Этот человек тоже не входит в обучающий набор.
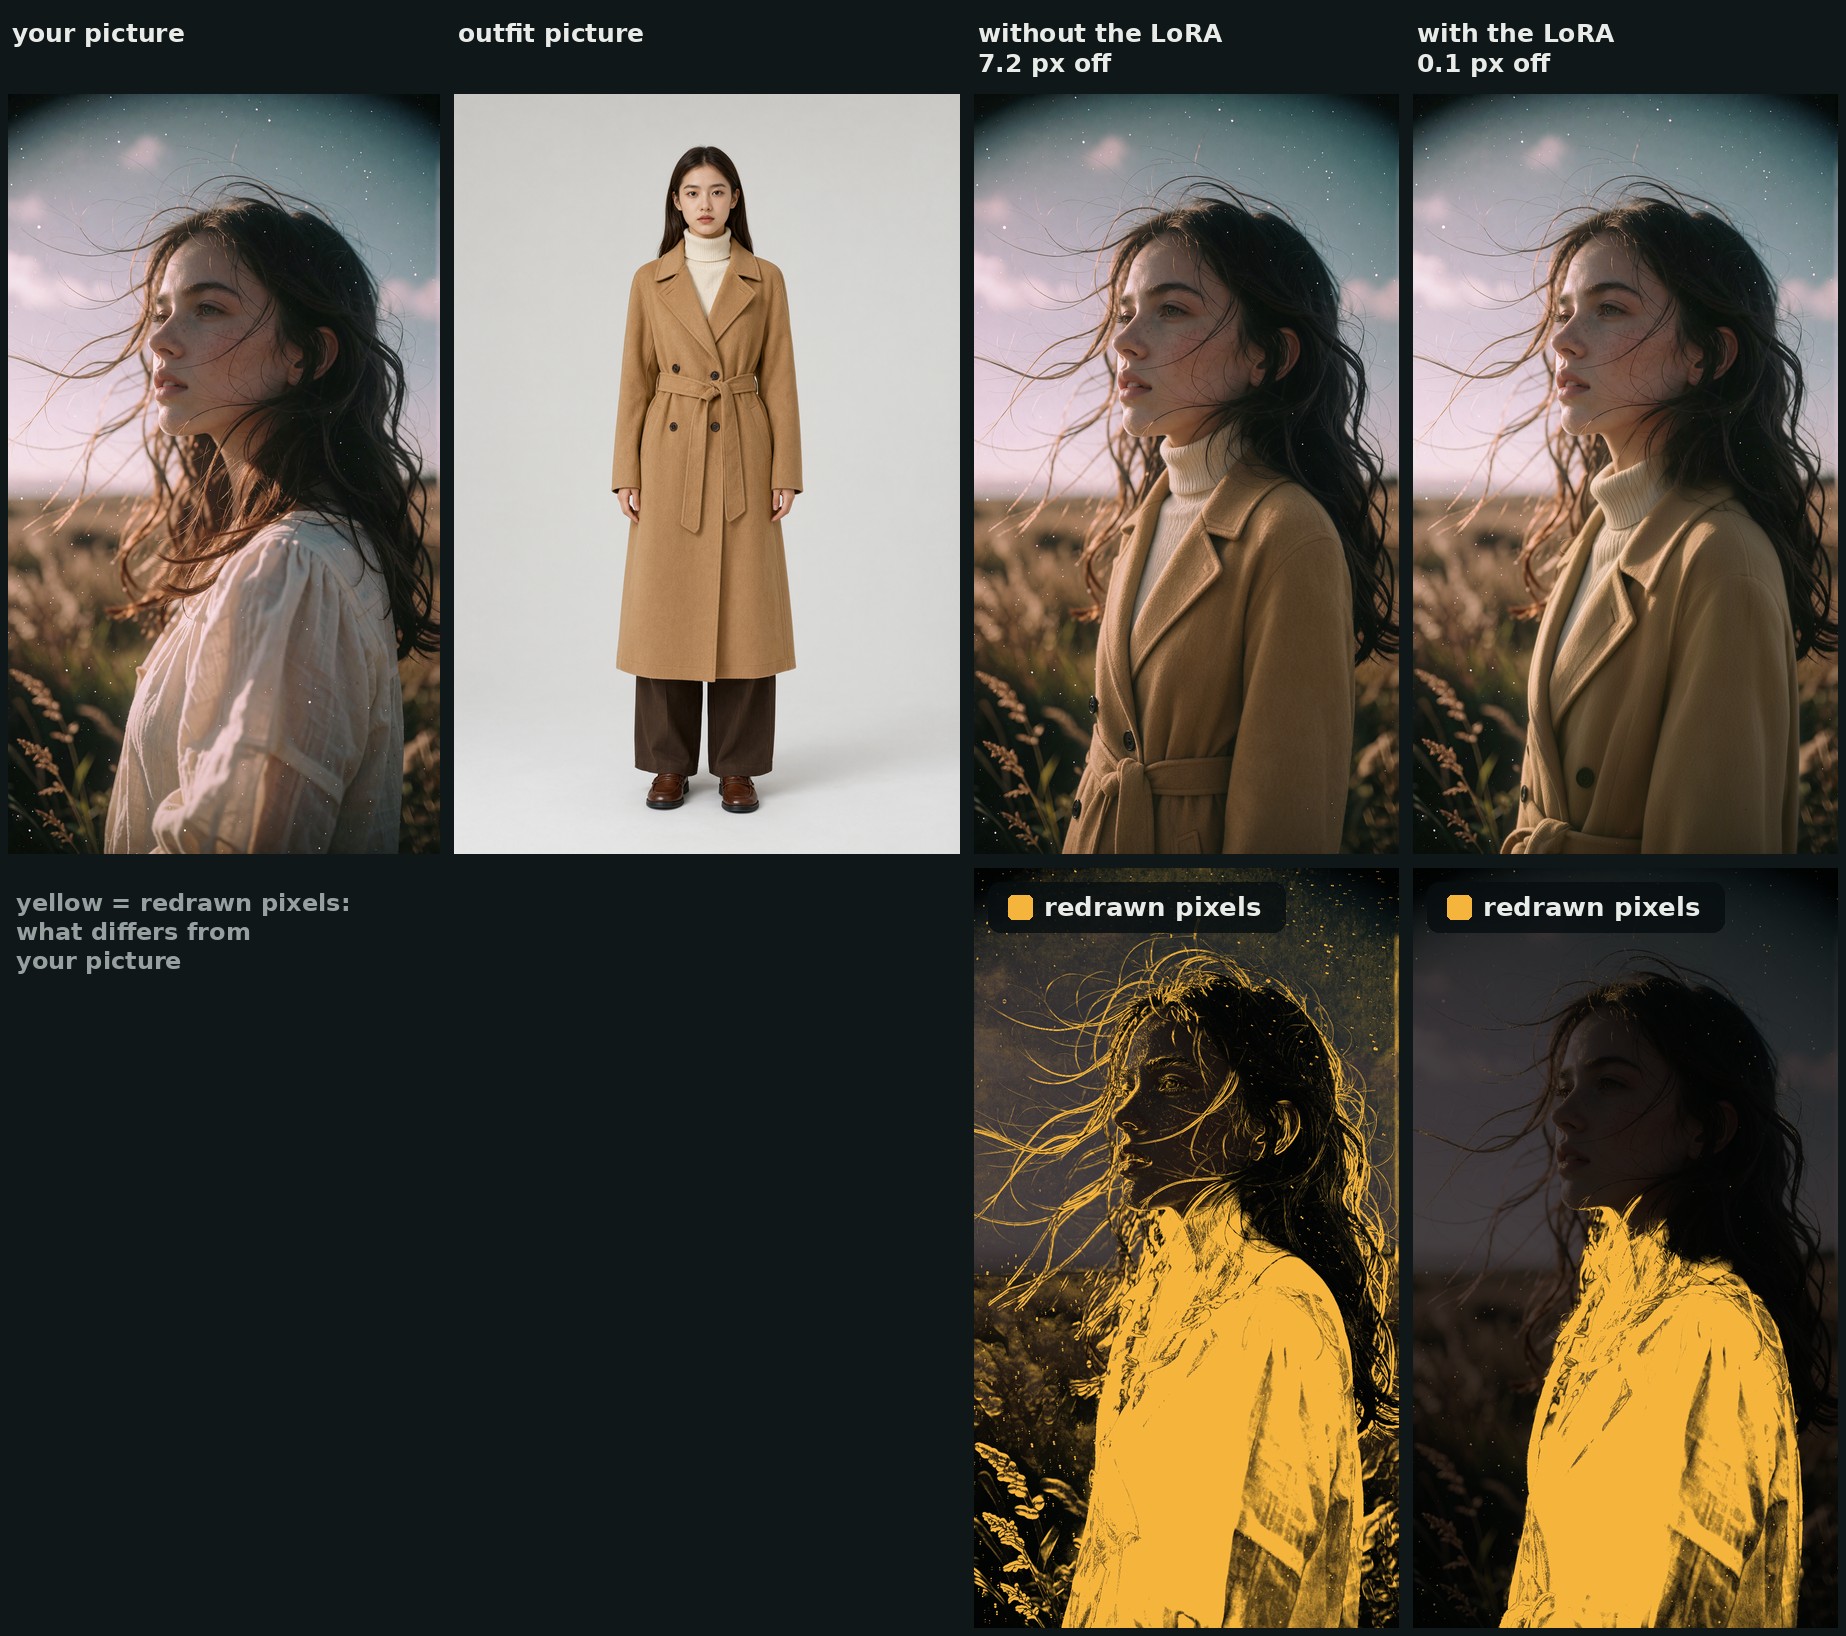
LoRA никогда не обучалась на замене одежды этого человека, и этого пальто нет в обучающем наборе.
Как это обучалось
Набор данных построен из реальных замен Qwen-Image 2.1, а затем скорректирован так, чтобы каждая цель обучения лежала в кадре своего источника. Необработанная замена: плохая цель, потому что она несёт в себе дрейф, размытое лицо и перерисованный фон, а LoRA, обученная на ней, всё это усваивает. Каждый результат возвращается на фотографию человека сдвигом на целые пиксели (без пересэмплирования), и только одежда берётся из замены. Лицо, волосы, руки и фон: снова собственные пиксели фотографии человека. Из 66 целей обучения 40 получены из замен, сделанных с включённой ранее Consistency LoRA автора, и 26 из обычных замен; 22 потребовали сдвига на целые пиксели, а медианная цель берёт 27 % своих пикселей из замены.
- 66 обучающих пар с использованием 45 разных людей и 31 разного наряда (на человеке, раскладка, предметная съёмка), четыре пары отложены для тестирования.
- Обучение: ostris/ai-toolkit с
arch: qwen_image_2на базе Comfy-Org INT8 ConvRot, два референса на пример (человек и наряд), подписи при dropout 0. Ранг 32, альфа 32, AdamW8bit при lr 1e-4, размер пакета 1, таймстепыshift, 1 500 шагов с чекпойнтами каждые 250, на одной RTX PRO 6000 примерно 4,5 с на шаг.
Одна деталь тренера стоила одного запуска и описана в RESEARCH.md в репозитории. AI-Toolkit вписывает цель обучения в бакет размера, масштабируя и обрезая её, но референсное изображение загружает целиком и сжимает его под сетку 32 px. Когда форма изображения не совпадает с формой бакета, эти два процесса перестают совпадать: при resolution: 1024 пары 1056 x 1888 попадают на 768 x 1344, так что цель теряет 2 % высоты, а референс вместо этого сжимается на 2 %. Первый запуск обучался нормально по своей функции потерь и дал LoRA, которая делала каждое изображение на 1,6 % выше. Исправление находится в экспорте, а не в тренере: записать цель и референс, которые должны совпадать, в одном размере, обе стороны кратны 32.
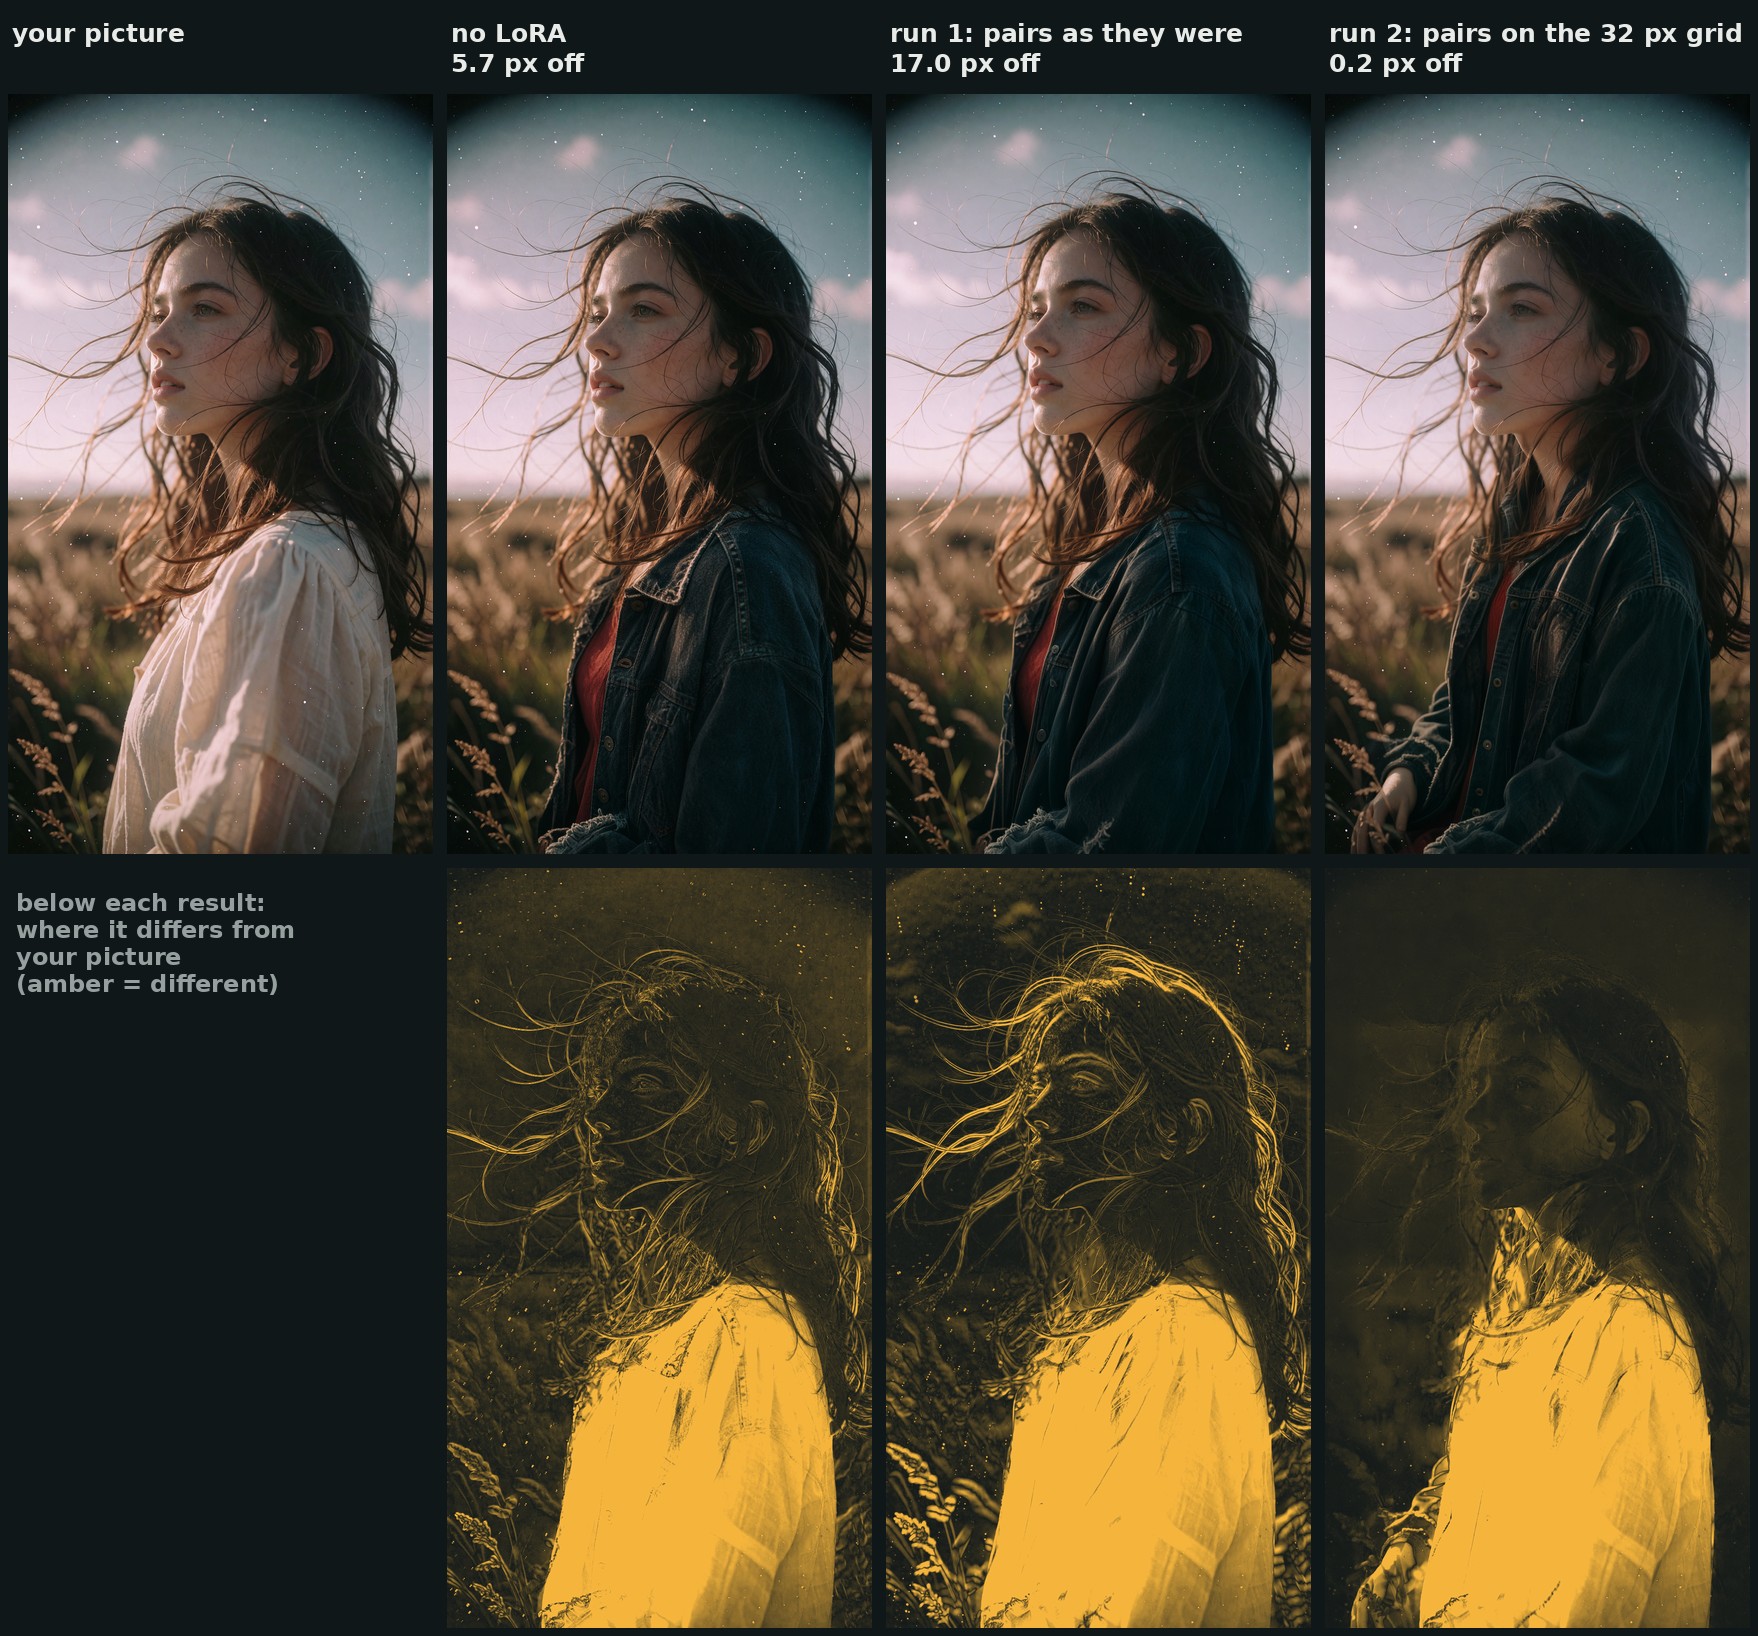
На шаге 250 первый запуск растягивает изображение, поэтому всё отличается от оригинала. Исправленный запуск этого не делает.
Ограничения
Карточка прямо говорит о том, насколько узким получился релиз:
- Она не рисует одежду лучше, чем обычный Qwen-Image 2.1. Пуговицы, ремни и узоры получаются такими, какими были бы и так, а обычный Qwen иногда копирует больше одежды: в первом сравнении выше он заменил и штаны, тогда как LoRA сохранила старые джинсы и ремень.
- Она сохраняет то, что было, а значит, сохраняет и позу. Одежда, для которой нужна другая поза, её не получит.
- Сложнее всего обстоит дело с обувью. Даже с
Replace everything they wear.пара обуви осталась на месте в одном из трёх тестовых подмен. - Ранний checkpoint (шаг 250) нарисовал руку, которой не было на изображении, при одной подмене. Шаги с 500 по 1 500 не сделали этого ни на одном из шестнадцати, но проверено было только шестнадцать.
- Обучена примерно на 1 MP и протестирована примерно на 2 MP, 25 шагов, CFG 1.
- С LoRA Viggle Turbo при 8 шагах она всё ещё удерживает картинку (от 0,05 до 0,24 px на пяти подменах), хотя однотонная ткань может получиться слегка зернистой.
- Предметы поверх одежды могут уйти вместе со старым нарядом или странно лечь на новый: кабель от наушников поверх куртки был удалён, а ремешок сумки выглядел неправильно поверх новой куртки.
Доступность
- Веса LoRA: ausboss/Qwen-Image-2.1-Outfit-Swap-Consistency-LoRA
- Перепаковка базовой модели: Comfy-Org/Qwen-Image-2.1
- Пакет нод автора: ausboss/ComfyUI-AusBoss
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.