Zen Image Edit: Qwen-Image 2.1 на кодировщике 0.8B в ComfyUI
Zen Image Edit запускает Qwen-Image 2.1 на текстовом кодировщике Qwen3.5-0.8B и адаптере слияния на 158M, сокращая кодировщик с 17,5 ГБ до 1,7 ГБ, с двумя маршрутами в ComfyUI.
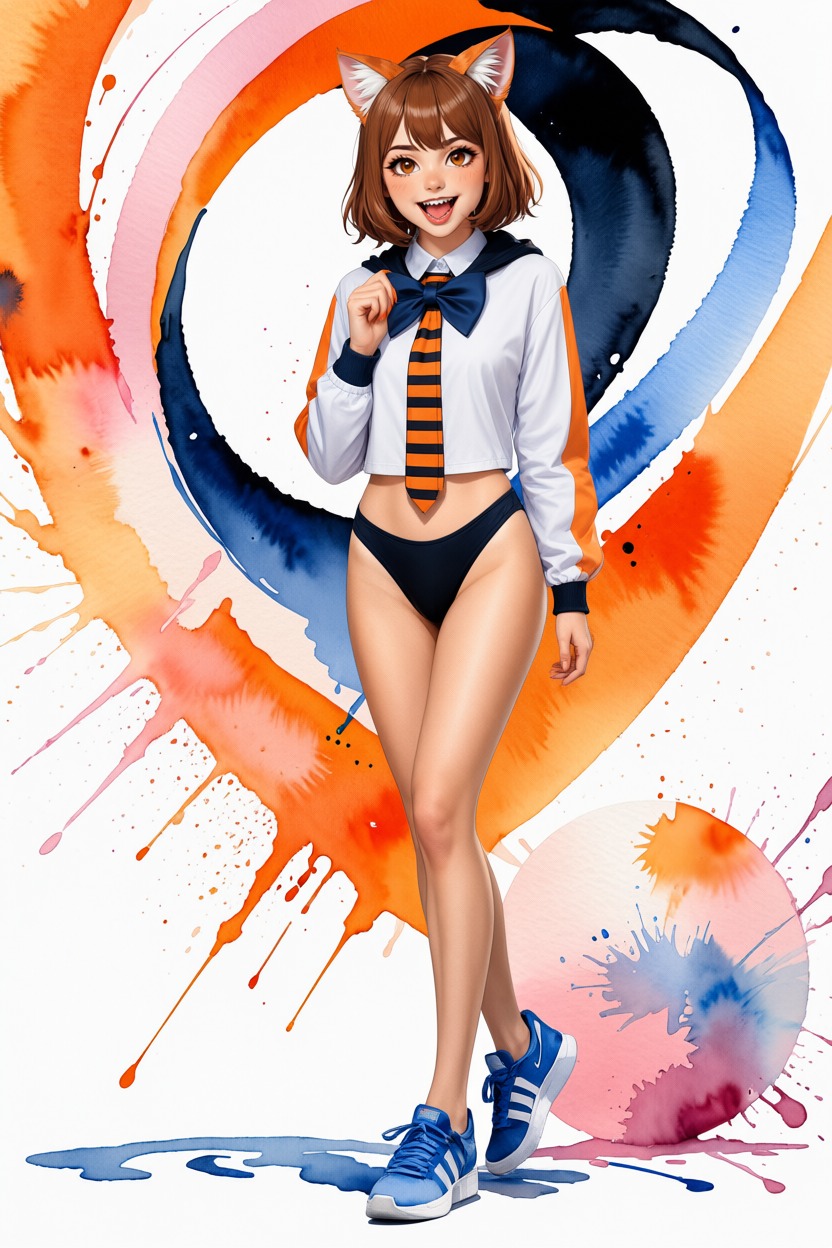
Text-to-image при 1024 px, 30 шагов, сгенерировано пайплайном. Источник: AiArtLab/zen-image-edit.
Что меняет Zen Image Edit
Именно стек условий Qwen-Image 2.1 делает модель дорогой по памяти: текстовый кодировщик базовой модели это Qwen3-VL-8B примерно на 17,5 ГБ в fp16, и он должен располагаться рядом с DiT на 14,5 ГБ. Zen Image Edit заменяет его небольшим мультимодальным кодировщиком и адаптером, который имитирует то, что выдавал большой кодировщик, как по обычному тексту, так и по тексту вместе с референсными изображениями.
| Компонент | Zen Image Edit |
|---|---|
| Трансформер | DiT Qwen-Image 2.1, 32 слоя, 14,5 ГБ fp16, со встроенным адаптером слияния текста на 158M |
| Текстовый кодировщик | Qwen3.5-0.8B, 1,7 ГБ fp16, tokenizer и processor без изменений |
| Точность условий | косинус 0,95 по тексту, 0,97 по визуальным позициям промптов редактирования, в сравнении с нативным кодировщиком Qwen3-VL-8B |
| VAE | дообученный декодер Qwen-Image 2.1, 16x пространственное сжатие, fp32 |
| Scheduler | FlowMatchEulerDiscreteScheduler, простой статический сдвиг 5.0 |
| Пиковая VRAM | около 17,5 ГБ в резидентной памяти, меньше с enable_model_cpu_offload() |
Адаптер живёт внутри DiT как его блок слияния текста, поэтому вся модель это одна самодостаточная папка Diffusers, и отдельный кодировщик на 17,5 ГБ нигде не нужен. Сэмплер использует простой статический сдвиг 5.0 вместо динамического сдвига базовой модели.
Поставляемый в комплекте адаптер имеет ревизию v12. Таблица позиций его ветви внимания покрывает 2 304 слота, и он дообучался на реальной геометрии редактирования 1024 px, поэтому длинные референсные последовательности сохраняют свои позиции, а не попадают в хвост с нулевым заполнением. Это подняло визуальный косинус относительно нативного кодировщика с 0,93 до 0,97, тогда как текст остался на 0,95.
Дообученный VAE
Поставляемый декодер не является стандартным для Qwen-Image 2.1. Это дообученный только декодер на основе madebyollin/texture-fix-vae-for-qwen-image-2.1, обученный убирать решётку в 2 px, которую апсемплинг nearest-exact фиксирует в выходном шаге. Обучался только декодер, 5 300 шагов, с одним дополнительным членом лосса: разницей peak-to-peak между средними значениями подрешёток 2x2 у реконструкции и у цели. Верно воспроизведённое содержимое даёт в этот член ноль, поэтому штрафуется только добавленная решётка. Кодировщик побитово идентичен оригиналу, что оставляет латентное пространство неизменным.
| Декодер | PSNR | LPIPS | Решётка (/255) |
|---|---|---|---|
| оригинальный Qwen-Image 2.1 | 33.073 | 0.05316 | 2.631 |
| texture-fix | 32.840 | 0.05388 | 0.125 |
| этот VAE | 33.397 | 0.05291 | 0.000 |
Реконструкция на 32 отложенных изображениях при 512 px. В карточке модели отмечено, что решётка не видна при 100% увеличении, поэтому её измеряют, а не оценивают на глаз.
Примеры
Редактирование с одним условием-изображением: фон меняется, субъект сохраняется.
 |  |
|---|---|
Два условия-изображения: <image1> сохраняет позу, одежду и сцену | Личность копируется из <image2> |
Редактирование следует конвенции базовой модели: редактируется первое изображение (<image1>), а все последующие служат референсами. В карточке модели отмечено, что именно подача референса первым чаще всего становится причиной того, что замена «не происходит»: тогда модель редактирует сам референс.
Три условия-изображения: цель и композиция из <image1>, человек из <image2>, цвет и освещение из <image3>.
Генерация с прозрачностью (RGBA) идёт через тот же пайплайн.
Запуск в ComfyUI
Существует два независимых маршрута для ComfyUI, и ни одному из них не нужен кодировщик на 17,5 ГБ.
Пакет узлов: recoilme/zen-image-edit-comfyui. DiT, VAE, сэмплер и кэш префиксного KV остаются штатными в ComfyUI (требуется сборка с поддержкой Qwen-Image 2.1), а узел лишь поставляет маленький кодировщик и адаптер:
- Скачайте
adapter_v12.safetensors(0.64 GB) вComfyUI/models/. - Поместите
qwen_image_2.1_bf16.safetensorsвmodels/diffusion_models/, аqwen_image_2.1_vae_bf16.safetensorsвmodels/vae/, оба из Comfy-Org/Qwen-Image-2.1. - Загрузите текстовый кодировщик:
hf download Qwen/Qwen3.5-0.8B --local-dir ComfyUI/models/text_encoders/qwen3.5_0.8b. - Перезапустите ComfyUI. Требуется
transformers >= 5.17.
Автор сообщает о косинусе 1.0000 относительно сборки Diffusers из той же папки, и оба примера графов проверены от начала до конца.
Однофайловый чекпоинт: T8mars/comfyui-Zen-Image-Edit-T8. Устанавливаемый через ComfyUI Manager, этот маршрут упаковывает DiT, VAE, кодировщик Zen, адаптер слияния и ассеты tokenizer в один чекпоинт zen_image_edit_qwen21_single.safetensors, опубликованный как t8star/Zen-Image-Edit-Comfy. Его загрузчик возвращает MODEL, CLIP и VAE, поэтому отдельные загрузки не нужны, а загрузчик только для CLIP работает со штатными загрузчиками diffusion и VAE. Конверсия проверена на ComfyUI 0.37.0 с RTX 5090 Laptop на 24 ГБ, как на графе text-to-image, так и на графе редактирования изображений. Тот же репозиторий также переопубликовывает турбо-адаптеры Viggle в виде LoRA, которые загружаются во встроенных узлах ComfyUI, вместе с рабочими процессами.
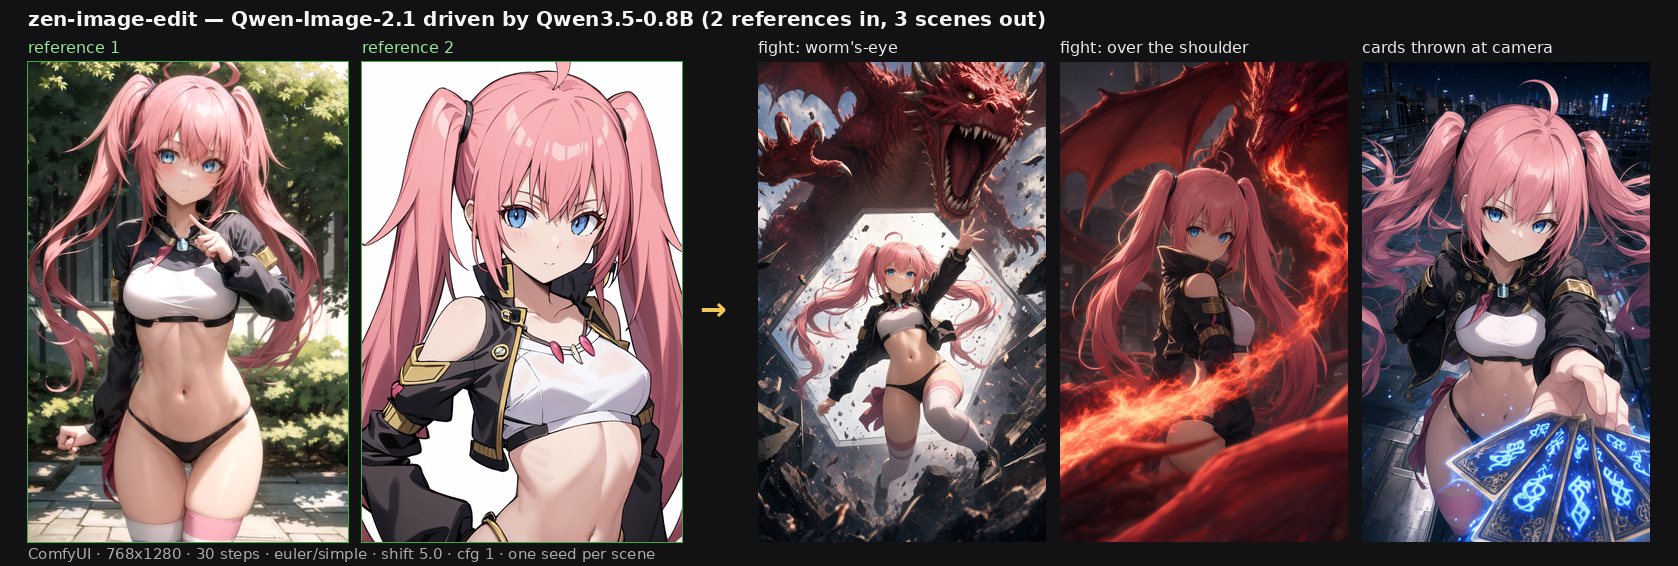
Два референса персонажей на входе, три сцены на выходе, через узел ComfyUI при 768x1280. Источник: recoilme/zen-image-edit-comfyui.
Задокументированные ограничения
В карточке модели пробелы перечислены, а не оставлены на самостоятельный поиск:
- Только английский. Именно на нём обучался и тестировался адаптер, а другие языки дают отклонения.
- Цифры на вывесках. «OPEN 24 HOURS» отрисовывается как «OPEN 26 HOURS» на всех проверенных seed. Слова передаются нормально.
- Нефотографические референсы переносятся менее точно, чем фотографические, поскольку адаптер имитирует нативный кодировщик и наследует его потолок.
- Размер пакета больше 1 при 1024 px даёт пик около 28 ГБ, поэтому один промпт за вызов является безопасным режимом.
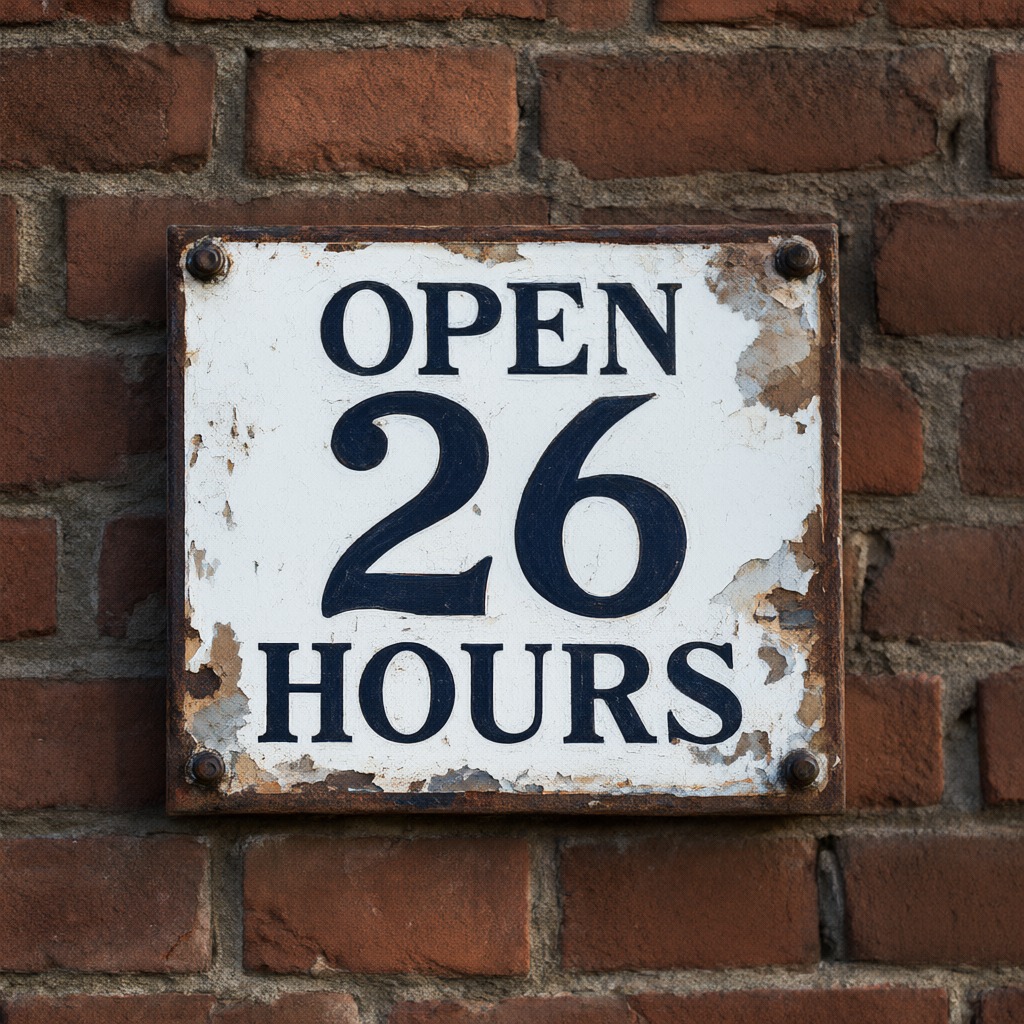
Слова отрисовываются правильно, цифры на вывесках нет. Источник: AiArtLab/zen-image-edit.
Доступность
Веса опубликованы как AiArtLab/zen-image-edit. Для карт на 16 ГБ есть сборка GGUF Q5_K в recoilme/zen-image-edit-gguf, которая во время запуска снижает трансформер с 13.55 GiB до 4.52 GiB. Для запуска пайплайна Diffusers нужен diffusers, собранный с поддержкой Qwen-Image-2.1, и trust_remote_code=True.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.