Prism: совместные видео и аудио в 2K, обучение в 2,5 раза быстрее
Prism от Fudan, Tencent Hunyuan и ZJU обучает совместные видео-аудио модели в 2K с динамическим разреженным вниманием, в 2,5 раза быстрее полного.
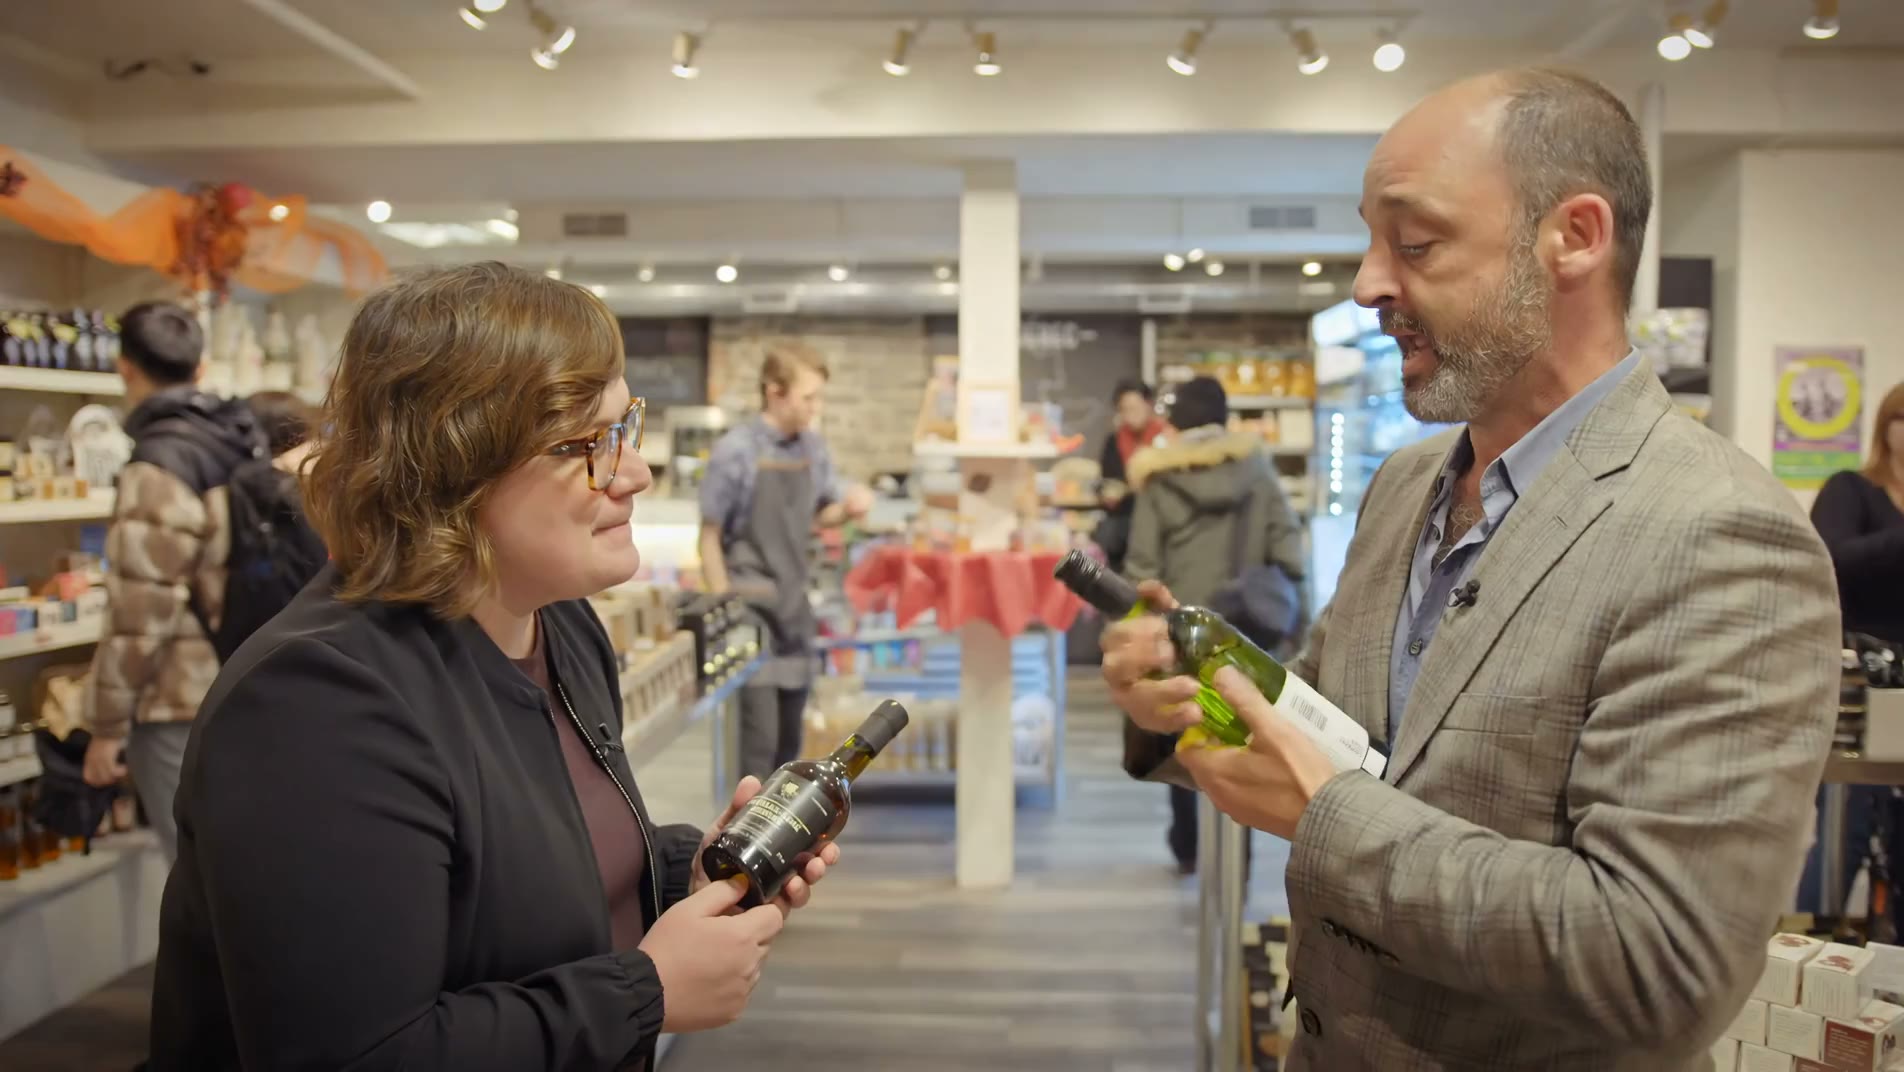
Пример генерации из выпущенного предварительного чекпойнта.
Что делает Prism
Нативное обучение в высоком разрешении — это то, как совместные видео-аудио модели усваивают более тонкие визуальные детали и более чёткое движение, но полное внимание растёт квадратично с длиной последовательности, а на 2K оно распределяется по массе избыточных токенов. Prism сохраняет разрешение и вместо этого меняет внимание.
Метод организует последовательность токенов в пространственно-временные макрозоны. Для каждой зоны он оценивает локальную информационную структуру по двум сигналам:
- Дисперсия признаков видео вдоль размерности канала, которая показывает, насколько быстро визуальное содержимое меняется в каждом направлении.
- Нормы признаков из кросс-внимания аудио-к-видео, которые показывают, насколько сильно аудио влияет на каждую визуальную область.
Эти сигналы определяют форму блока для каждой зоны: более тонкое разбиение вдоль осей, где визуальное содержимое меняется быстро или связь аудио и видео сильна, и более грубое разбиение в остальных местах. Замысел в том, чтобы токены внутри блока оставались семантически согласованными, поэтому признаки уровня блока несут и визуальное содержимое, и совместное взаимодействие аудио и видео. Гибридная стратегия выбора блоков (top-k в сочетании с порогом top-p по CDF) затем задаёт разреженность для каждого запроса.
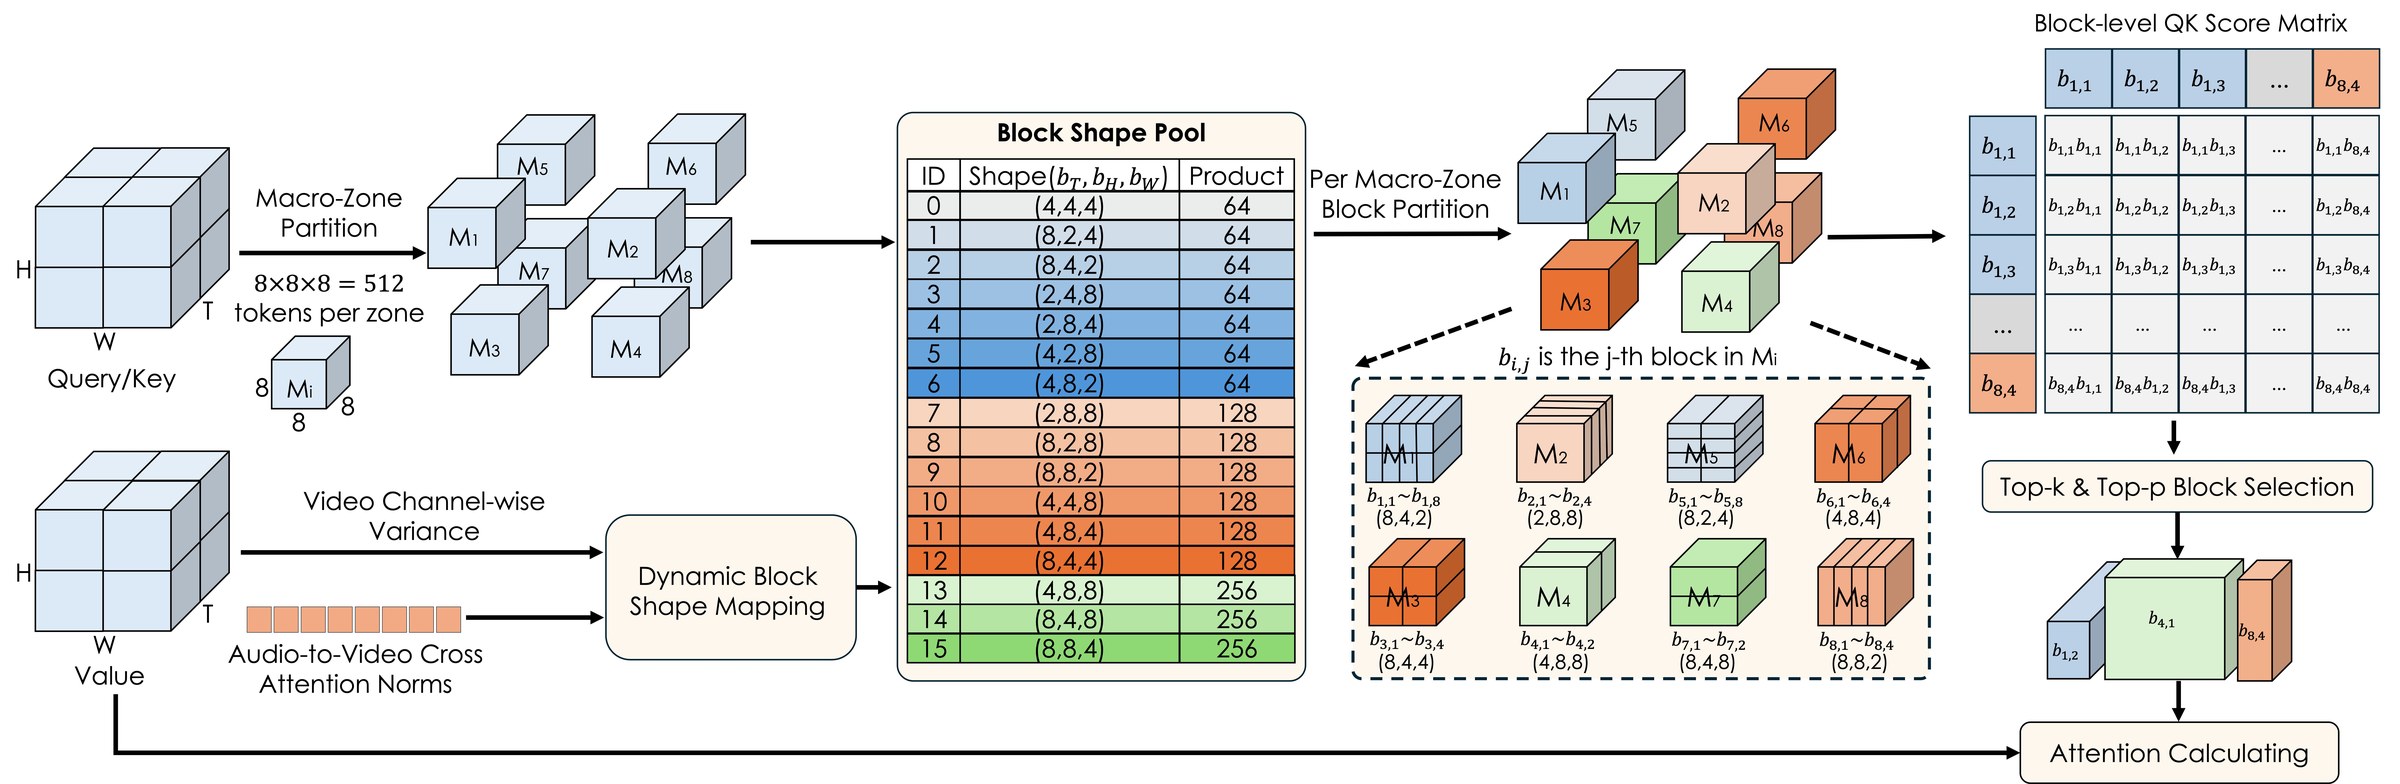
Фреймворк Prism, из официальной карточки модели.
Что было выпущено
Проект поставляется как полный стек обучения и вывода, а не как отдельный чекпойнт:
- Предварительные чекпойнты.
Prism-preview-alpha(стабильный) иPrism-preview-beta(движение), построенные на архитектуре MOVA, с нативной совместной генерацией видео и аудио в 720p, 1080p и 2K. - Код. Предобработка данных с извлечением и декодированием латентов, обучение, полное дообучение и вывод, а также скрипты распределённого запуска для многоузловых прогонов.
- Отчёт. Технический отчёт доступен на arXiv, ссылки на него есть в карточке модели и в репозитории.
Генерации из выпущенного предварительного чекпойнта.
Выпущенные чекпойнты также принимают референсное изображение в качестве условия для генерации аудио и видео из изображения:
 |  |
|---|---|
| Официальный пример входного изображения для генерации аудио и видео | Официальный пример входного изображения для генерации аудио и видео |
Чекпойнт Prism-pro указан как оставшийся пункт в планах проекта и пока не выпущен.
Доступность
Предварительные веса опубликованы на Hugging Face, код и скрипты — в Tencent-Hunyuan/Prism, а отчёт — на arXiv. Вывод сейчас выполняется через собственные скрипты PyTorch проекта; ноды ComfyUI или упакованного чекпойнта ComfyUI пока нет, поэтому для локального запуска нужно напрямую использовать официальный репозиторий.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.