Kandinsky 6.0: генерация видео и аудио в ComfyUI
Открытые веса Kandinsky 6.0 для ComfyUI: 29B Pro и 3B Lite генерируют 5-секундное видео с синхронизированным аудио 44 кГц, а также суперразрешение вплоть до Full HD.
Официальный промо Kandinsky 6.0.
Что нового в Kandinsky 6.0
Kandinsky 6.0 Video: семейство базовых диффузионных моделей, которые генерируют видео и аудио вместе, а не озвучивают дорожку постфактум. Линейка делится на два размера:
- Kandinsky 6.0 Video Pro: 29B параметров, флагманская линейка.
- Kandinsky 6.0 Video Lite: 3B параметров, компактная линейка.
Каждая поставляется в трёх вариантах: базовый checkpoint, дистиллированный 10-шаговый checkpoint для быстрых итераций и предобученный checkpoint. Все они генерируют 5-секундные клипы с частотой 24 fps и синхронизированным аудио 44 кГц, охватывающим диалоги, фоновые шумы и музыку, в двух режимах:
- Text-to-audio-video (T2AV): один текстовый промпт создаёт клип и его звуковую дорожку.
- Image-to-audio-video (TI2AV): референсное изображение задаёт первый кадр, а промпт описывает, что происходит дальше.
Архитектура представляет собой мультимодальный диффузионный трансформер для видео и аудио (Kandinsky6Transformer3DModel) с текстовым энкодером Qwen2.5-VL для текстовых эмбеддингов на уровне токенов и pooled-эмбеддингом CLIP, в паре с Hunyuan Video VAE для визуальной части и MMAudio VAE плюс вокодером в стиле BigVGAN для аудио. Планирование выполняется методом flow matching с shift = 5.0.
Стоит знать о двух переключателях вывода. sample_audio=False генерирует только видео, а expand_prompts=True позволяет текстовому энкодеру Qwen2.5-VL переписать короткий запрос в подробный перед кодированием, что добавляет задержку, но не требует дополнительных весов.
Официальная демонстрация Kandinsky 6.0.
Суперразрешение до Full HD
В примерах выше генерация идёт в разрешении 480x864. Второй пайплайн, Kandinsky6SRPipeline, берёт эти кадры и увеличивает их в x2, x2.25 или x4 с помощью плиточной диффузии в латентном пространстве K-VAE, вновь склеивая перекрывающиеся плитки с помощью окон Ханна. Checkpoint на flow matching выполняет 4 шага на плитку, а дистиллированный VSR checkpoint сокращает это до 2.
Один из официальных примеров клипов.
Kandinsky 6.0 в ComfyUI
Kandinsky Lab публикует официальное расширение ComfyUI вместе с весами. Оно устанавливается из ComfyUI Registry как два пакета, kandinsky6 и kandinsky6-sr, и требует ComfyUI 0.38.0 или новее с Python 3.10+. Загрузка и выгрузка моделей выполняются самим ComfyUI, поэтому патчи ядра не нужны.
Расширение включает два готовых к запуску шаблона, которые по умолчанию используют Pro distilled PiFlow (10 шагов, CFG=1) с референсным портретом для I2VA:
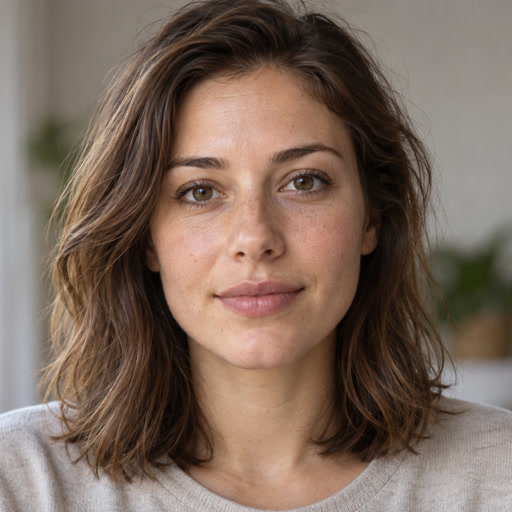
Два встроенных шаблона: текст в видео+аудио и изображение в видео+аудио.
Недистиллированный Pro и MagCache остаются поддерживаемыми, при этом MagCache автоматически обходится для дистиллированных моделей. Произносимые реплики записываются прямо в подпись видео между маркерами <S> и <E>, а голос и другие звуки описываются в отдельной аудиоподписи. Оба шаблона включают нативное улучшение промптов с помощью Qwen3.5-9B, которое можно отключить в ноде, а расширение SR необязательно, но необходимо для встроенных рабочих процессов.
Файлы моделей
Официальные рабочие процессы ComfyUI берут большинство файлов из репозиториев Kandinsky Lab, а общие текстовые энкодеры и видео VAE переиспользуются из существующих пакетов Comfy-Org:
📂 ComfyUI/
└── 📂 models/
    ├── 📂 diffusion_models/
    │   ├── Kandinsky-6.0-Pro-distill-5s-Diffusers/transformer/diffusion_pytorch_model.safetensors
    │   └── Kandinsky-6.0-VSR-distilled2steps-5s-Diffusers/
    ├── 📂 text_encoders/
    │   ├── qwen3.5_9b_bf16.safetensors
    │   └── qwen_2.5_vl_7b.safetensors
    └── 📂 audio_vae/
        ├── v1-44.pth
        └── bigvgan_vocoder/bigvgan_generator.pt
Кнопка Download models в расширении автоматически размещает всё это, а также сопутствующие JSON-конфиги, необходимые каждой папке Diffusers, в нужных каталогах ComfyUI.
Доступность
Веса опубликованы на Hugging Face в организации kandinskylab, а код, расширение ComfyUI и технический отчёт находятся в репозитории kandinskylab/kandinsky-6. Kandinsky 6.0 также доступен через Diffusers (Kandinsky6TI2VAPipeline и Kandinsky6SRPipeline), vLLM-Omni и демо-пространство Hugging Face, работающее на дистиллированном checkpoint Pro.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.