AcademiaSD LoRAlab: девять тренеров LoRA в одном лаунчере
AcademiaSD LoRAlab Trainer Studio объединяет тренеры LoRA для Qwen-Image 2.1, FLUX.2 Klein, Krea 2, Z-Image, MiniMax-H3 и других моделей в одном лаунчере, от 4 ГБ видеопамяти.
models/loras в один клик.
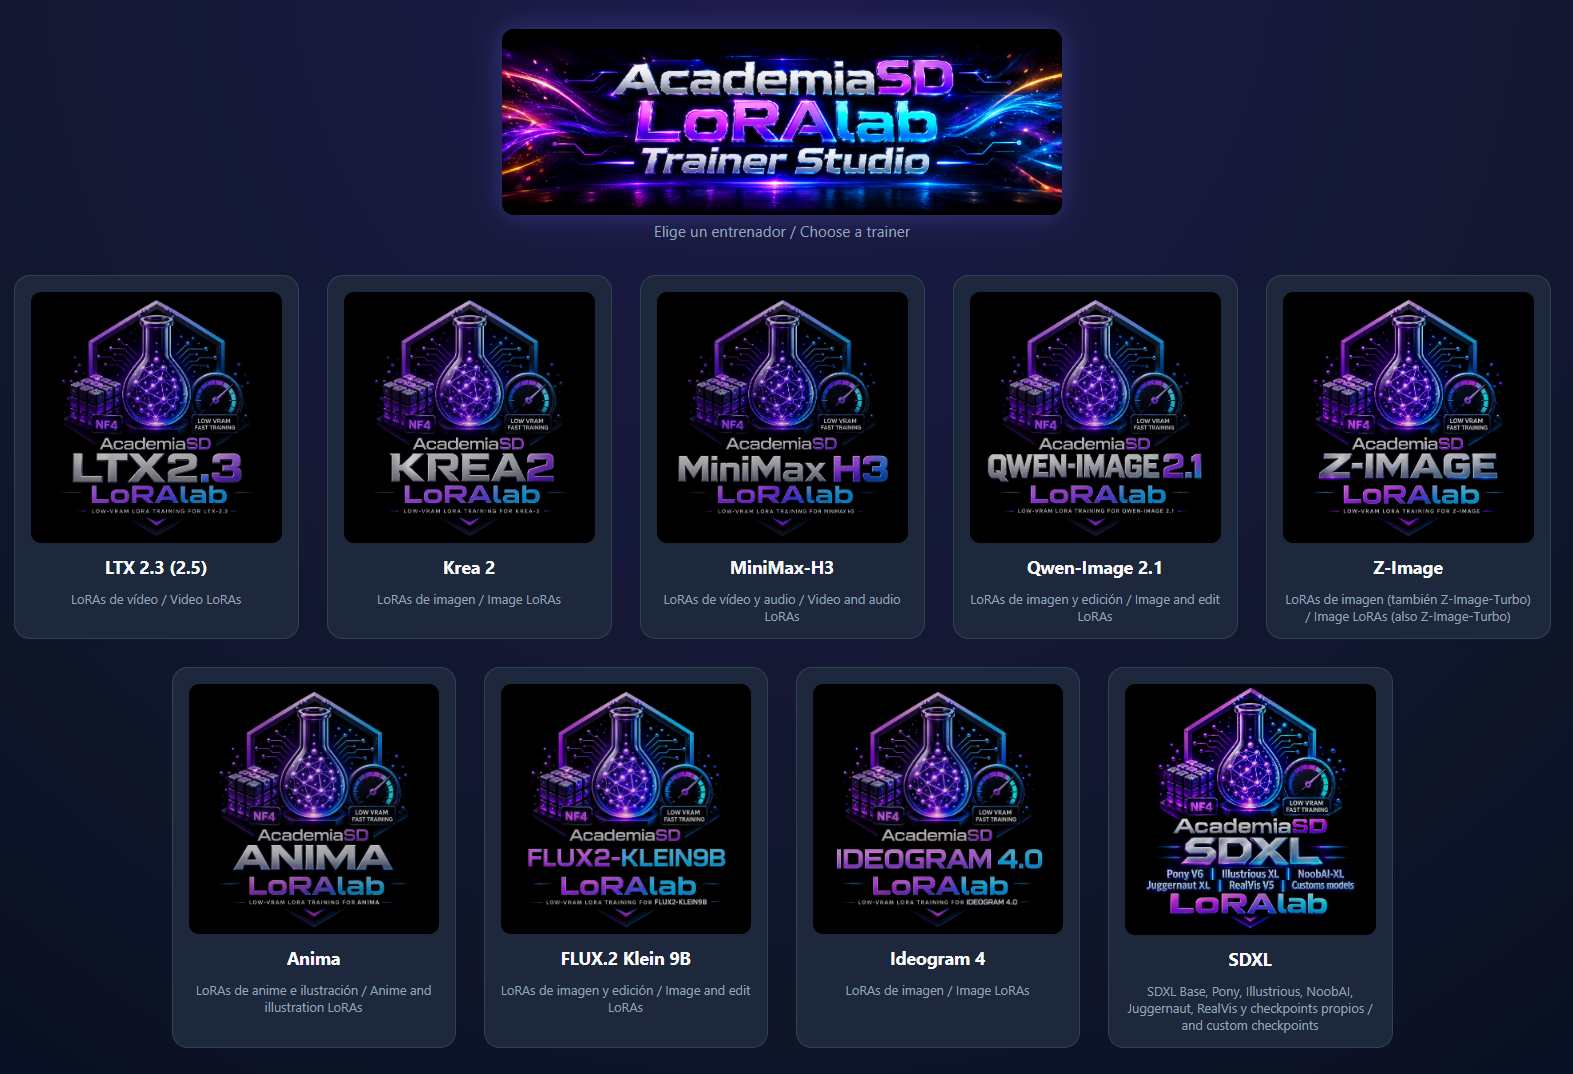
Лаунчер: выбираете тренер, и он открывается в браузере, а модели, проекты и настройки остаются общими.
Что он обучает и сколько нужно видеопамяти
| Тренер | Обучает | Минимальная видеопамять |
|---|---|---|
| Qwen-Image 2.1 | LoRA персонажей, объектов и стилей, а также edit-LoRA (ДО → ПОСЛЕ) | 8 ГБ |
| Krea 2 | LoRA персонажей, объектов и стилей для Krea 2 Raw и Turbo | 8 ГБ |
| Z-Image | LoRA персонажей, объектов и стилей для Z-Image и Z-Image-Turbo | 8 ГБ |
| Anima | LoRA персонажей и стилей для аниме и иллюстраций | 4 ГБ (NF4) / 6 ГБ (BF16) |
| FLUX.2 Klein 9B | LoRA персонажей, объектов и стилей, а также edit-LoRA | 12 ГБ |
| Ideogram 4 | LoRA персонажей, объектов и стилей с JSON-подписями | 12 ГБ |
| SDXL | LoRA для SDXL Base, Pony, Illustrious, NoobAI и других чекпойнтов SDXL | 4 ГБ (NF4) / 12 ГБ (BF16) |
| LTX-2.3 (и LTX-2.5) | LoRA персонажей и стилей для видео-модели LTX, обучение по изображениям | 12 ГБ |
| MiniMax-H3 | Видео-LoRA по изображениям, клипам и аудио, а также RefMod без обучения | 8 ГБ |
Минимальные требования: GPU NVIDIA с вычислительной способностью 7.5 или выше (RTX 20xx / GTX 16xx и новее), драйвер серии 580 или новее для CUDA 13 и 16 ГБ системной памяти. Для видеоклипов MiniMax-H3 дополнительно нужен ffmpeg в PATH. Карты GTX 10xx не подходят: PyTorch для CUDA 13 начинается с поколения RTX 20xx.
Один интерфейс на каждый тренер
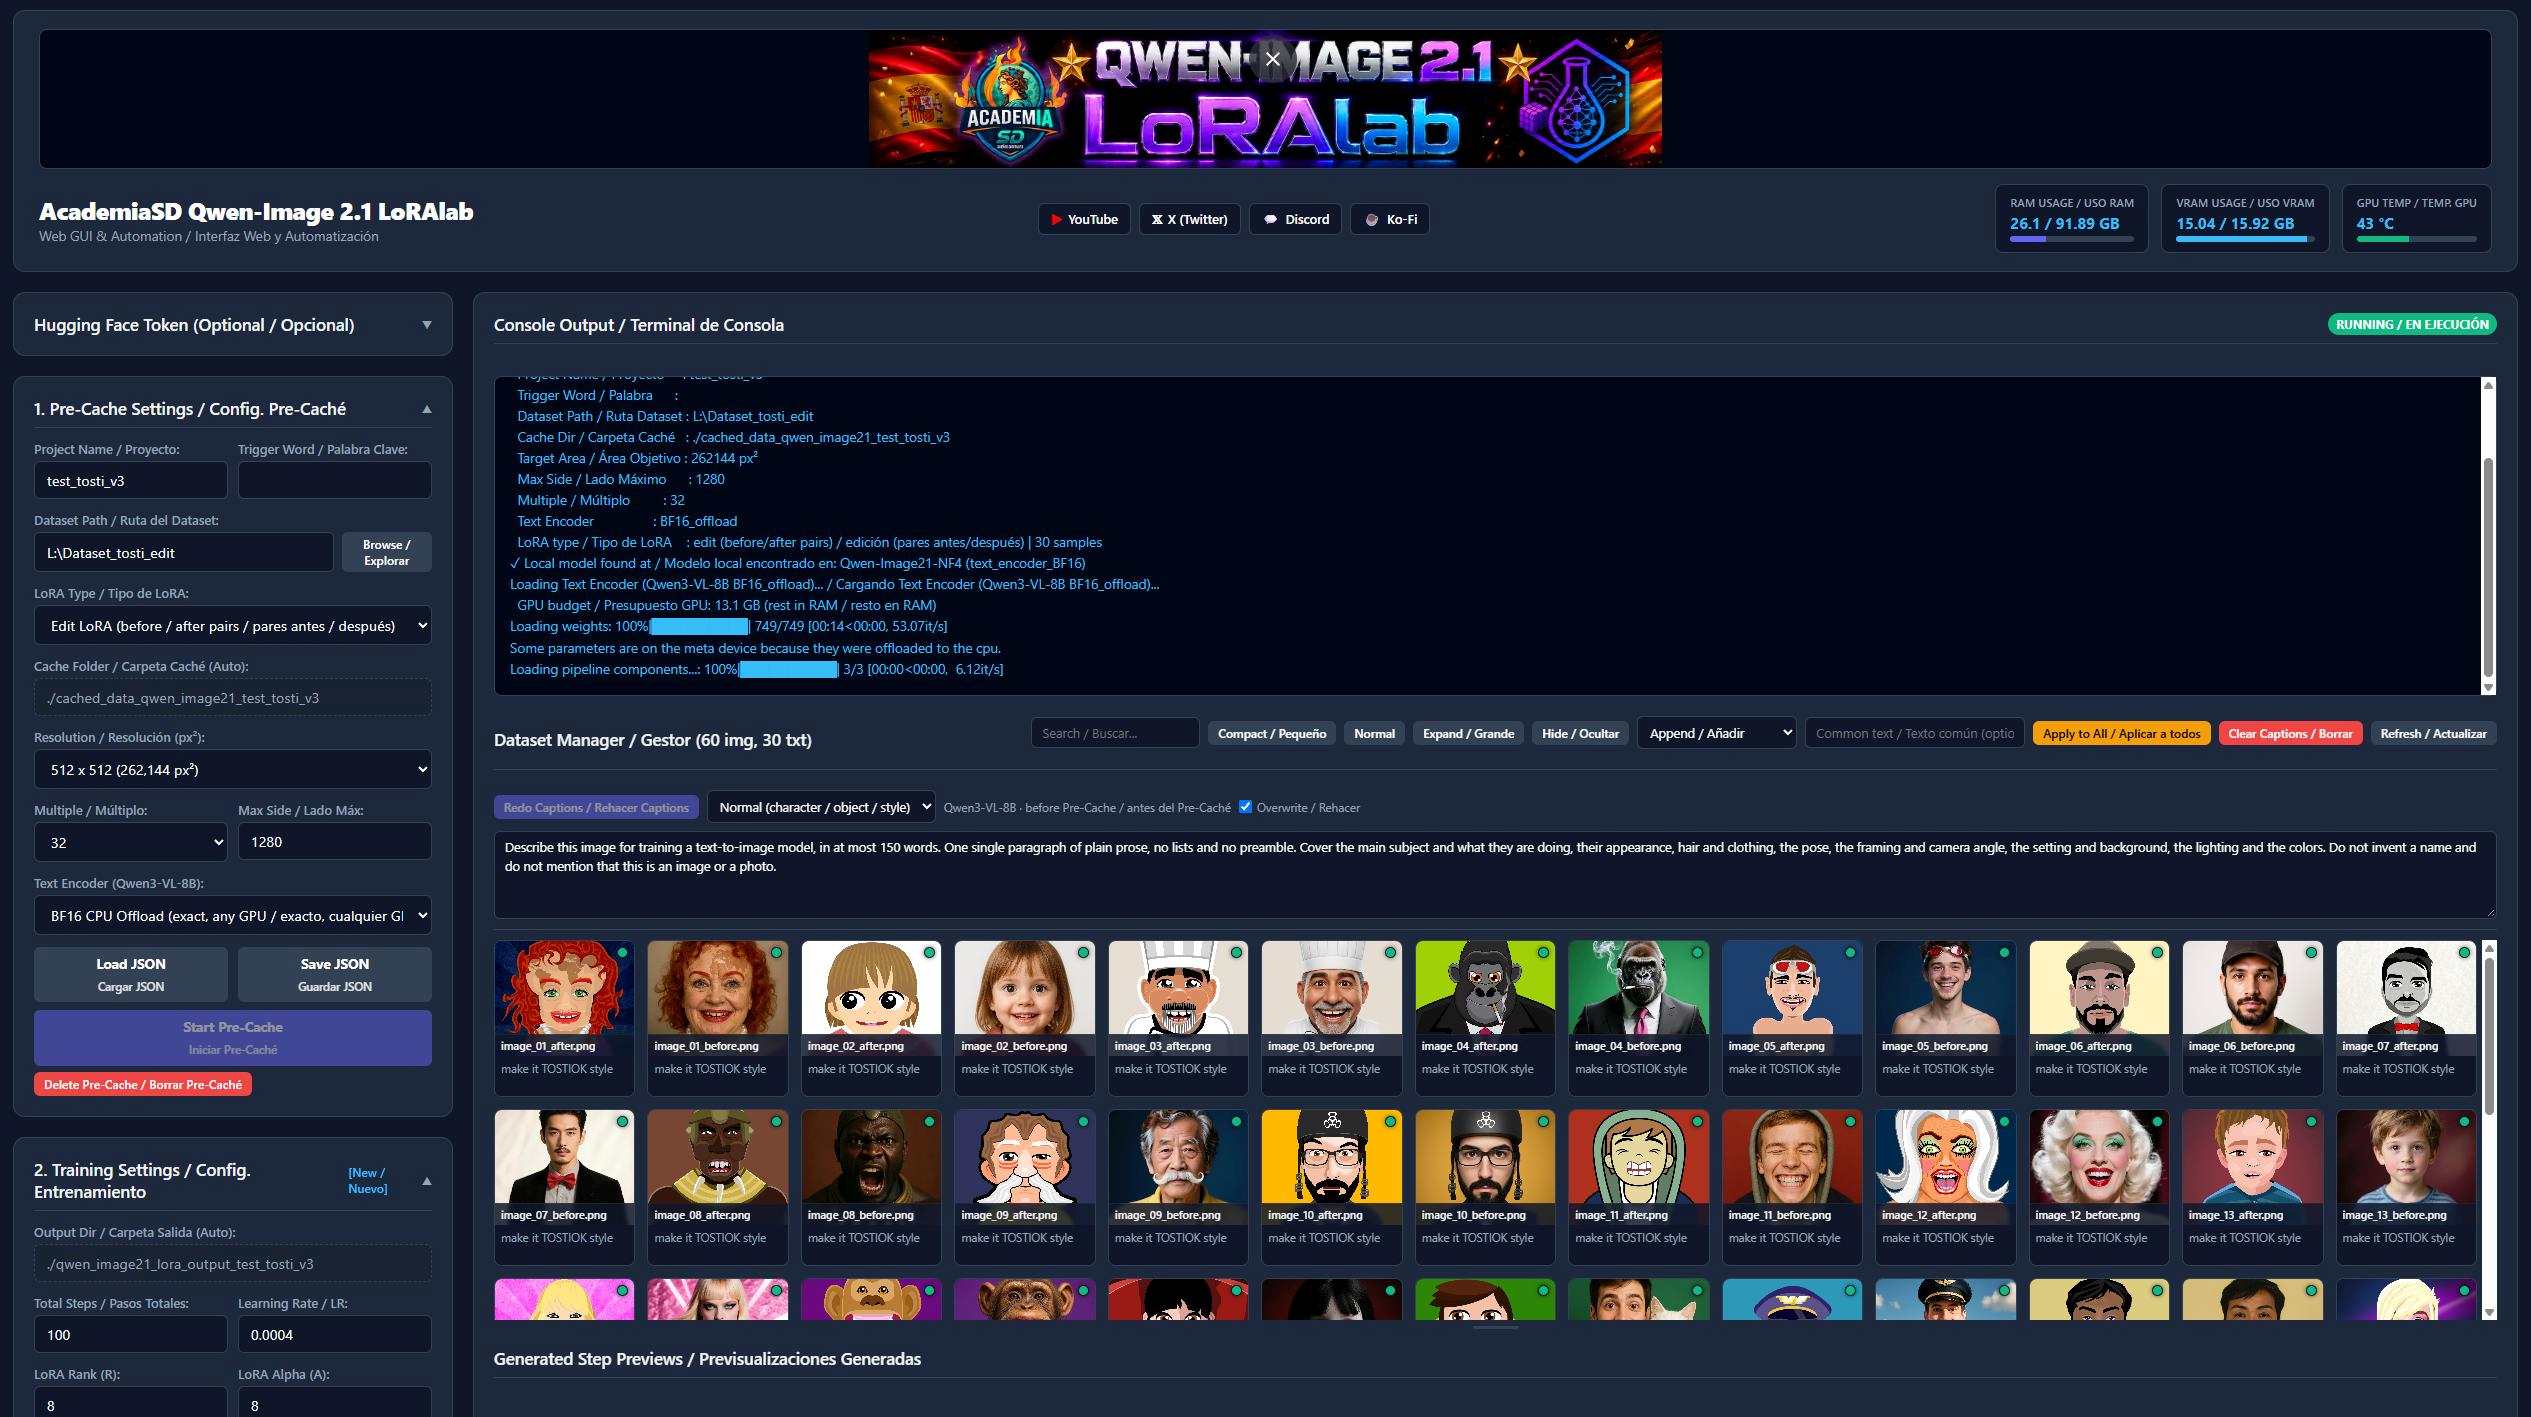
Тренер Qwen-Image 2.1. Все девять тренеров используют одни и те же панели.
Каждый тренер проходит одни и те же пять шагов:
- Проект и датасет. Назовите проект, добавьте необязательное триггерное слово, укажите папку с датасетом. Каждому изображению нужна подпись в файле
.txtс тем же именем; изображения можно перетащить папкой или архивом.zip. - Подписи (необязательно). Модель vision-language пишет подпись для каждого изображения, начиная с триггерного слова; промпт можно редактировать, а существующие подписи сохраняются, если вы их не перезапишете.
- Предварительный кэш. Текстовый энкодер и VAE запускаются один раз с выбранным вами разрешением, а их выходы сохраняются на диск. При повторном запуске изображения, которые не изменились, пропускаются, и после этого 100% GPU уходит на обучение.
- Обучение. Задайте количество шагов, скорость обучения, ранг и альфу, затем запустите. Настройки можно менять прямо во время выполнения, и они применяются на следующем шаге, а Stop Training сохраняет точный шаг, так что запуск можно возобновить через несколько дней, не потеряв ни шага.
- Экспорт.
Send to Modelsкопирует LoRA в папкуmodels/lorasComfyUI (или Forge / A1111), которую студия запоминает для всех тренеров. Промежуточные чекпойнты также можно скачать из браузера, а экспортированные LoRA несут метаданные в стиле kohya, которые читают Civitai и менеджеры LoRA.
Студия работает и с другой машины в той же сети: у лаунчера есть режим удалённого доступа с именем пользователя и паролем, так что датасет можно загрузить с ноутбука и скачать обученную LoRA обратно, не трогая компьютер для обучения.
Чёткий предпросмотр во время обучения
Некоторые из этих моделей работают достаточно медленно, так что за выборкой приходится следить, а стандартный предпросмотр Latent2RGB в ComfyUI для Qwen-Image 2.1, Krea 2 и FLUX.2 даёт блочный цвет. Рекомендуемая в README пара: KJNodes от kijai плюс крошечные автоэнкодеры AcademiaSD в ComfyUI/models/vae_approx/: TAE-Qwen-Image-2.1, TAE-Krea-2 и TAE_Flux2_AcademiaSD, помещённые в узел Model Preview Override между моделью и сэмплером.
Установка
Один установщик для каждой платформы и один общий venv для всех тренеров (PyTorch 2.14 на CUDA 13.0, Diffusers из GitHub, Transformers, PEFT, bitsandbytes и Flask):
git clone https://github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio.gitВ Windows дважды щёлкните Install_LoRAlab-TrainerStudio.bat; в Linux у каждого .bat есть эквивалент .sh, и лаунчер выбирает нужный. Install_Triton&SageAtten220.bat добавляет Triton и SageAttention 2.2, если они нужны. Обновление выполняется одним Update_LoRAlab-TrainerStudio.bat, который сохраняет модели, датасеты, проекты и настройки. Проект также поставляется с шаблоном RunPod и Docker-образом для облачного обучения.
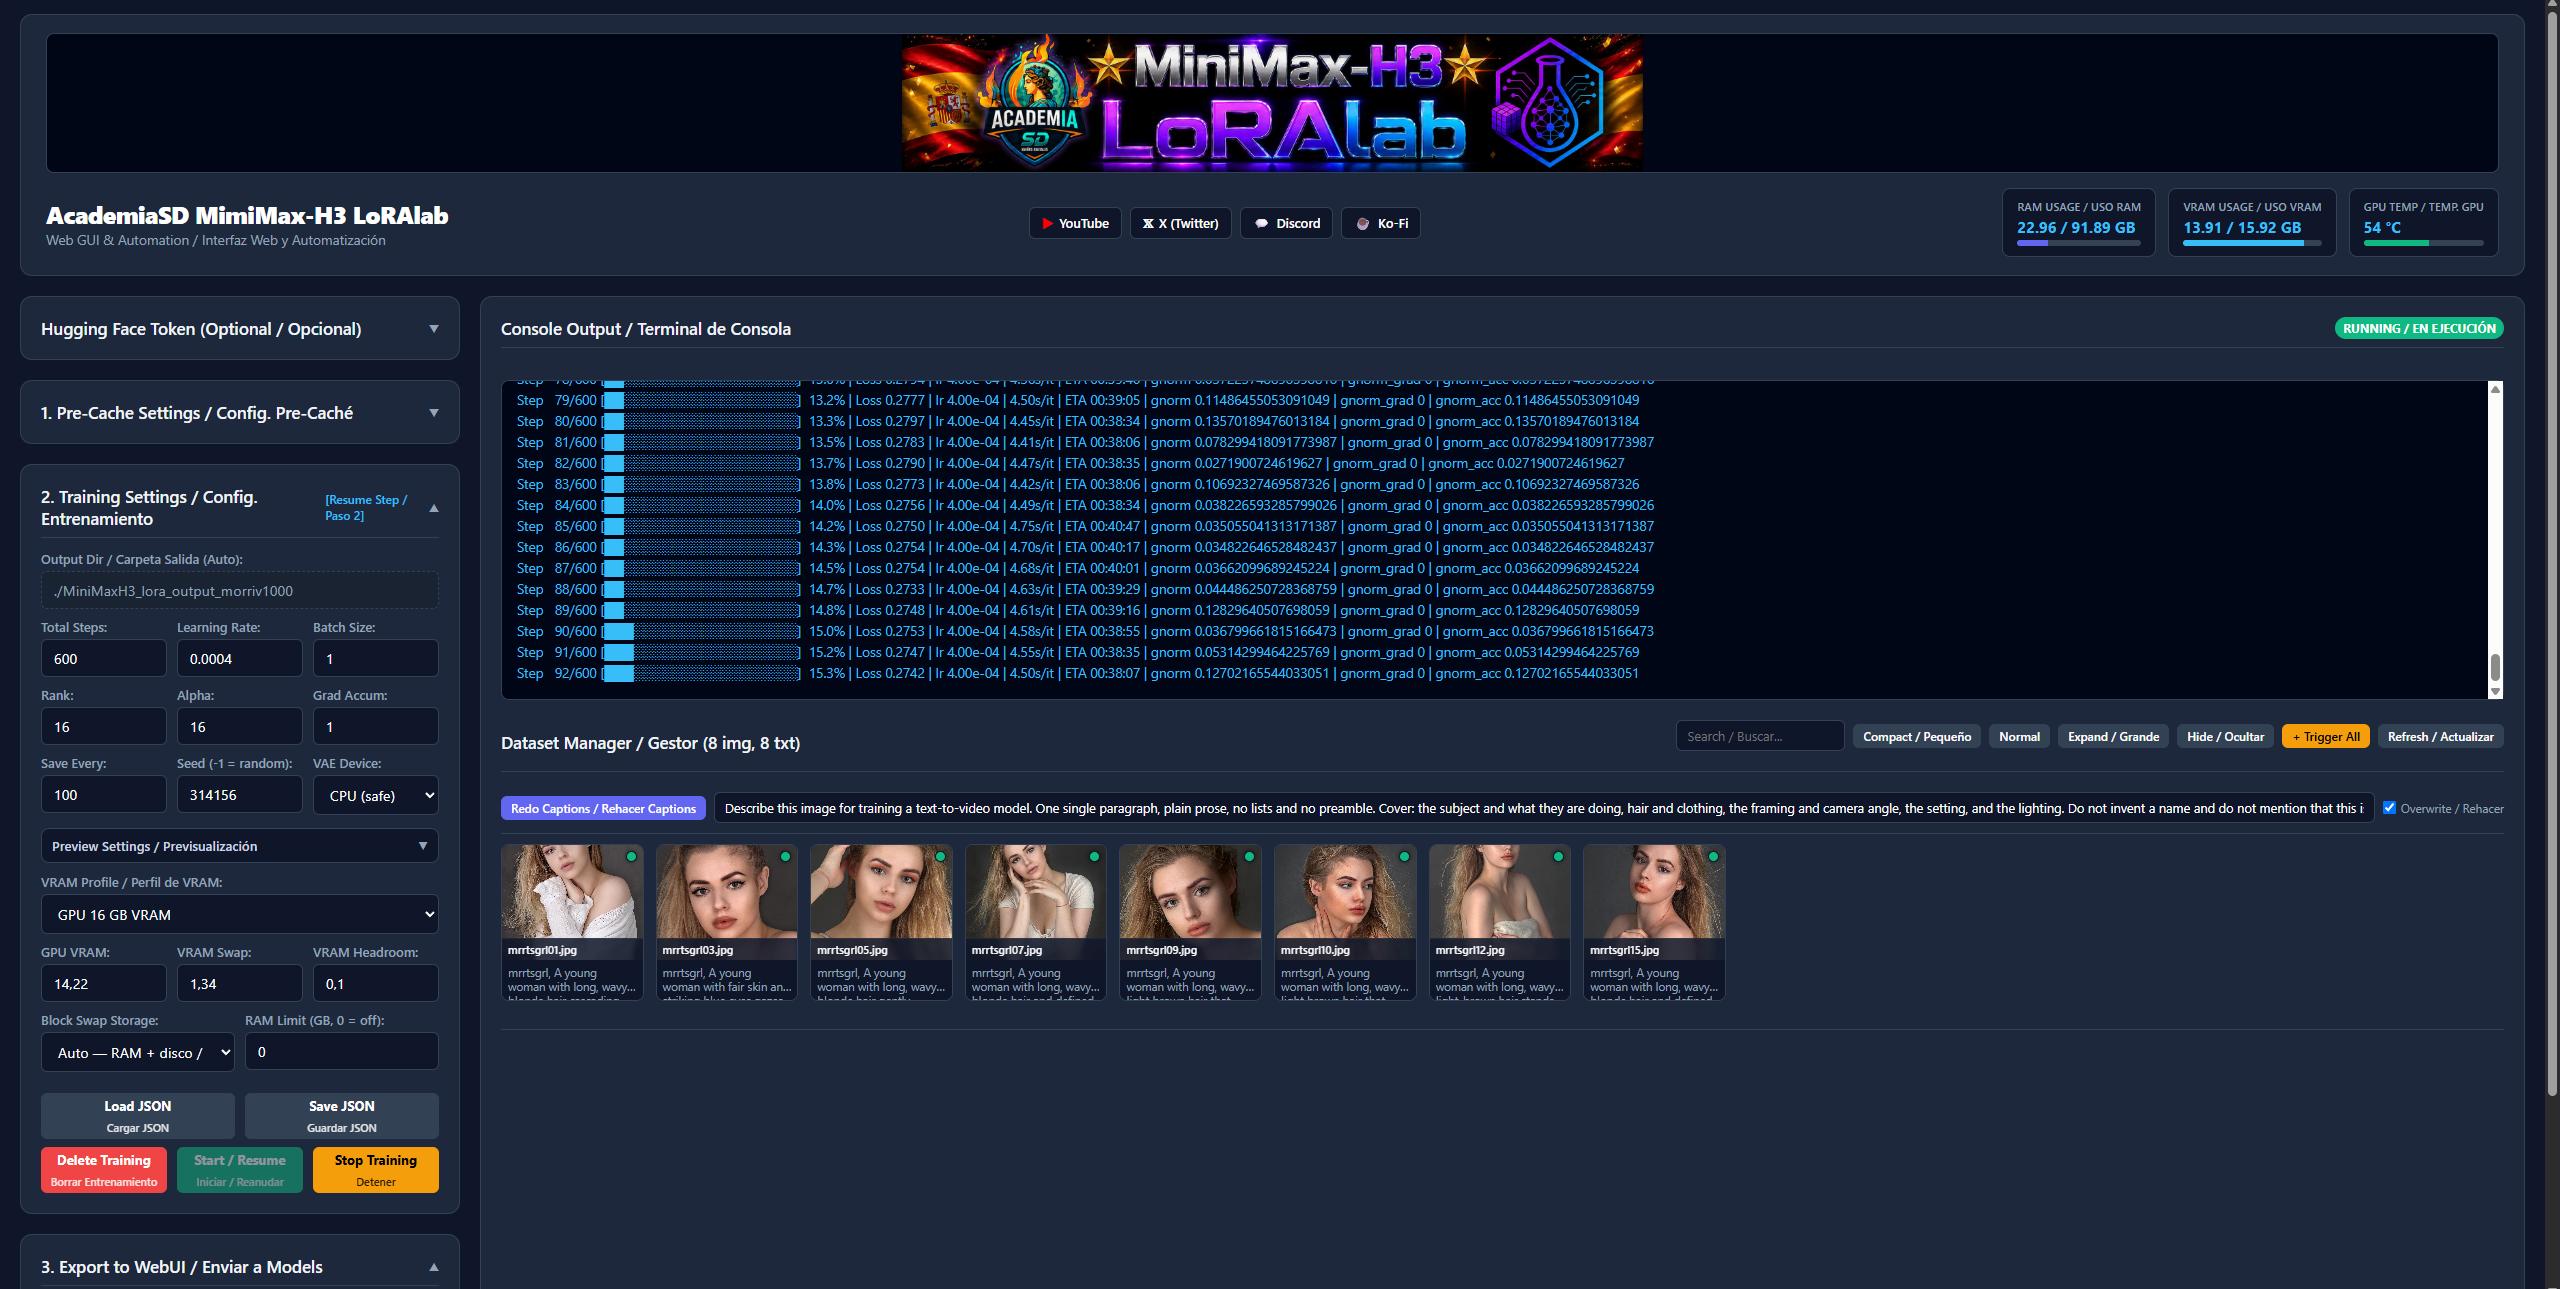
Тренер MiniMax-H3, один из двух видео-тренеров в студии.
Автор отмечает, что студия находится на ранней стадии: тренеры добавлялись один за другим, поэтому настройки обучения и предпросмотра по умолчанию могут подходить не для каждой модели, а сообщать о том, что не работает, предполагается через issues.
Доступность
AcademiaSD LoRAlab Trainer Studio доступна по адресу github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio, а на Hugging Face есть предварительно квантованные пакеты для обучения, например AcademiaSD/Qwen-Image-2.1-NF4-for-LoRA-Training.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.