DMAD: 4-шаговая аудио-видео LoRA MiniMax H3 для ComfyUI
ByteDance и Texas A&M выпускают DMAD: LoRA ранга 128, которая сокращает MiniMax H3 до четырёх шагов для совместной генерации аудио и видео, плюс конвертация для ComfyUI от Kijai.
 |  |
|---|---|
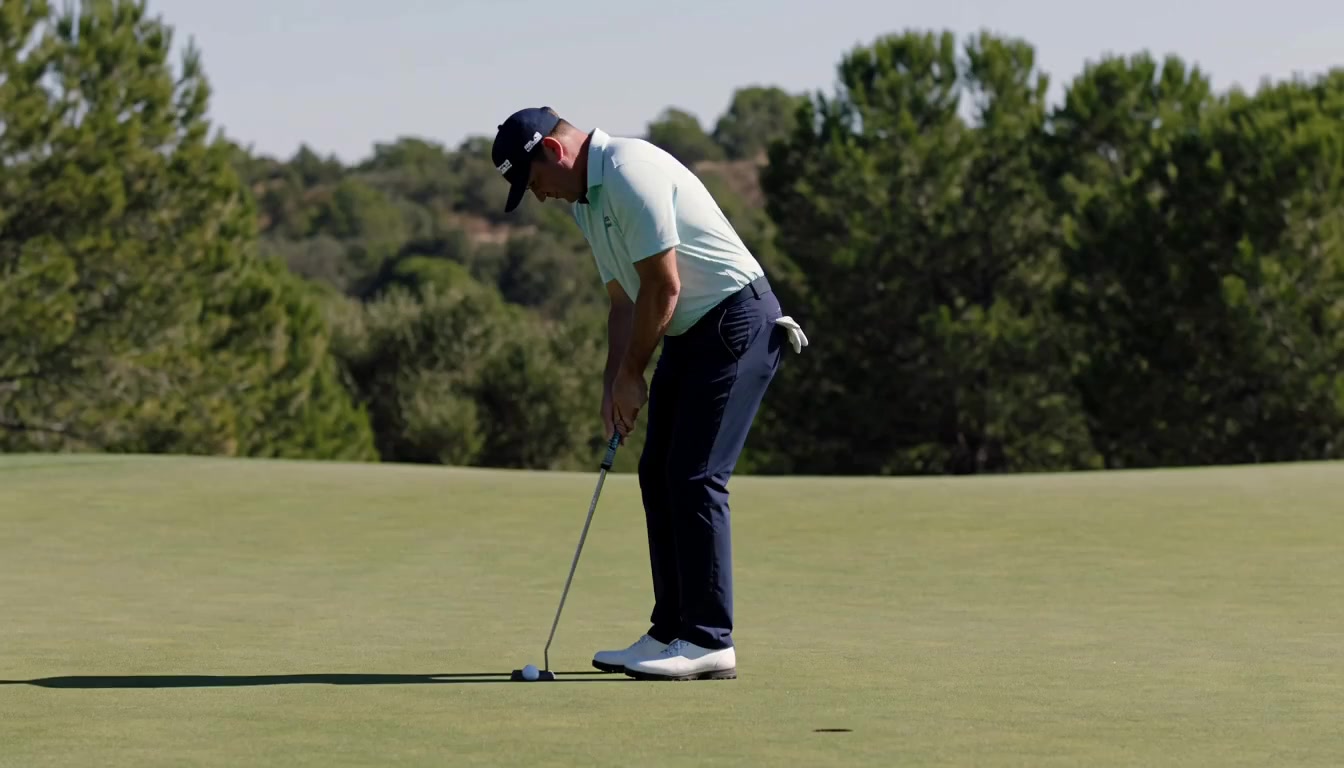
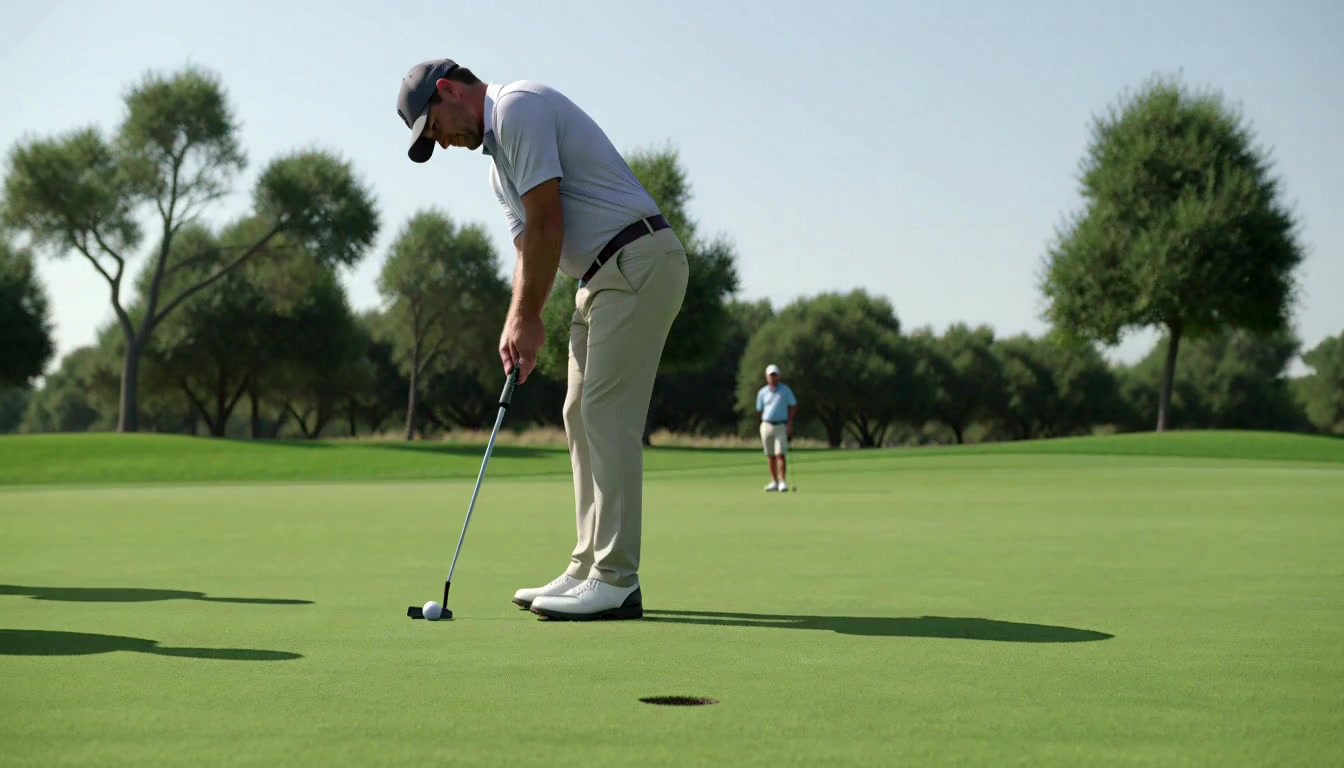
| 50-шаговый учитель MiniMax H3 | Тот же промпт у 4-шагового студента DMAD |
Сопоставленные кадры из сетки сравнения MiniMax H3 на странице проекта. Студент сохраняет композицию и объект, выполняясь за четыре прохода модели вместо пятидесяти.
Что меняет DMAD
Малошаговая дистилляция для диффузии обычно следует DMD: студент обучается на разнице между score-оценками учителя и студента, а значит приходится держать вторую диффузионную модель, подстроенную под эволюционирующее распределение студента, и платить за это памятью и вычислениями. DMAD убирает эту вспомогательную модель.
Метод переформулирует согласование распределений как классификацию. Две головы-дискриминатора используют общий backbone и обучаются отличать реальные и учительские образцы от студенческих. Линейные потери на логитах дискриминатора затем напрямую обучают студента, без подгонки score. В статье показано, что в точке оптимума дискриминатора эти потери восстанавливают градиент согласования распределений, на который опирается DMD, за счёт тождества, связывающего логиты дискриминатора с отношениями логарифмических плотностей.
Второй компонент, перевзвешивание на основе разрыва (gap-based reweighting), задаёт, насколько сильно учитель управляет каждым уровнем шума. Он считывает эмпирический разрыв логитов головы реальных данных между реальными и учительскими образцами и на его основе адаптирует вес вместо фиксированного расписания.
Что было выпущено
Релиз охватывает сторону метода, связанную с MiniMax H3. Две LoRA ранга 128 устанавливаются на трансформер H3 текст-в-аудио-видео, каждая весит около 1,4 ГБ.
| Файл | Описание |
|---|---|
minimax_h3/dmad_minimax_h3_4step_lora_critic.safetensors | Чекпойнт из статьи: EMA студента на итерации 800 основного запуска |
minimax_h3/dmad_minimax_h3_4step_full_critic.safetensors | Вариант, в котором backbone критика обучается полностью, а не замораживается под LoRA; карточка сообщает о более высоком результате AVGen-Bench |
Оба адаптера имеют ранг 128 и альфу 128 для проекций внимания и двух feed-forward слоёв всех 50 блоков трансформера и 2 блоков token-refiner, всего 312 модулей, в раскладке ключей Diffusers (<module>.lora.down.weight, <module>.lora.up.weight). Метаданные safetensors содержат ранг, альфу и правило объединения.
Вывод выполняется в режиме текст-в-аудио-видео за четыре шага, time shift 12 для видео и 2 для аудио, без classifier-free guidance, поскольку MiniMax H3 уже дистиллирован с guidance. Выход по умолчанию: 1344x768, 124 кадра (около 5,2 с при 24 fps) со стереозвуком 32 кГц, именно на таких настройках обучались студенты.
Результаты
В статье метод показан на трёх бэкбонах. С этим релизом опубликованы только студенты для MiniMax H3; цифры для SDXL, EDM и Wan2.1 взяты из собственных запусков статьи.
| Бэкбон | Настройка | Результат |
|---|---|---|
| SDXL | 4 шага, COCO-10K | 14,47 FID |
| Wan2.1-T2V-14B | 4 шага | 85,15 всего по VBench |
| MiniMax-H3-33B | 4 шага, совместное аудио и видео | 79,1% общего человеческого предпочтения против DMD2, 84,6% против rCM (ничьи исключены) |
В аннотации также сообщается о FID 1,04 для одношаговой генерации на ImageNet-64x64 с использованием проекционного дискриминатора, и утверждается, что малошаговые студенты превосходят сравниваемые малошаговые методы и многошаговых учителей по этим метрикам.
Запуск в ComfyUI
Официальный релиз ориентирован на Diffusers, а не на ноды: inference.py выполняет выборку по правилу шага re-noise, на котором обучались студенты, а run_diffusers_pipeline.py встраивает их в официальный MiniMaxH3ModularPipeline. Базовая модель это трансформер H3 на 33B плюс его текстовый энкодер Qwen3-VL-32B, около 170 ГБ компонентов, а в рекомендациях указана одна GPU на 80 ГБ с выгрузкой на CPU в простое.
Для ComfyUI эти адаптеры после конвертации представляют собой обычные LoRA. Kijai опубликовал конвертацию с пониженным рангом, minimax_h3_DMAD_4step_full_lora_avg_rank_39_bf16.safetensors в репозитории Kijai/MiniMax-H3-experimental, поэтому она загружается через стандартный путь LoRA для H3 без пользовательской ноды. Также циркулируют конвертации сообщества оригинального файла diffusers, с обычной оговоркой, что оба чекпойнта и настройки сэмплера должны соответствовать карточке.
Выдра на сёрфборде, сгенерированная 4-шаговым студентом MiniMax H3. Видео и аудио получены за один и тот же четырёхшаговый проход. Полная демонстрация на YouTube.
 |  |
|---|---|
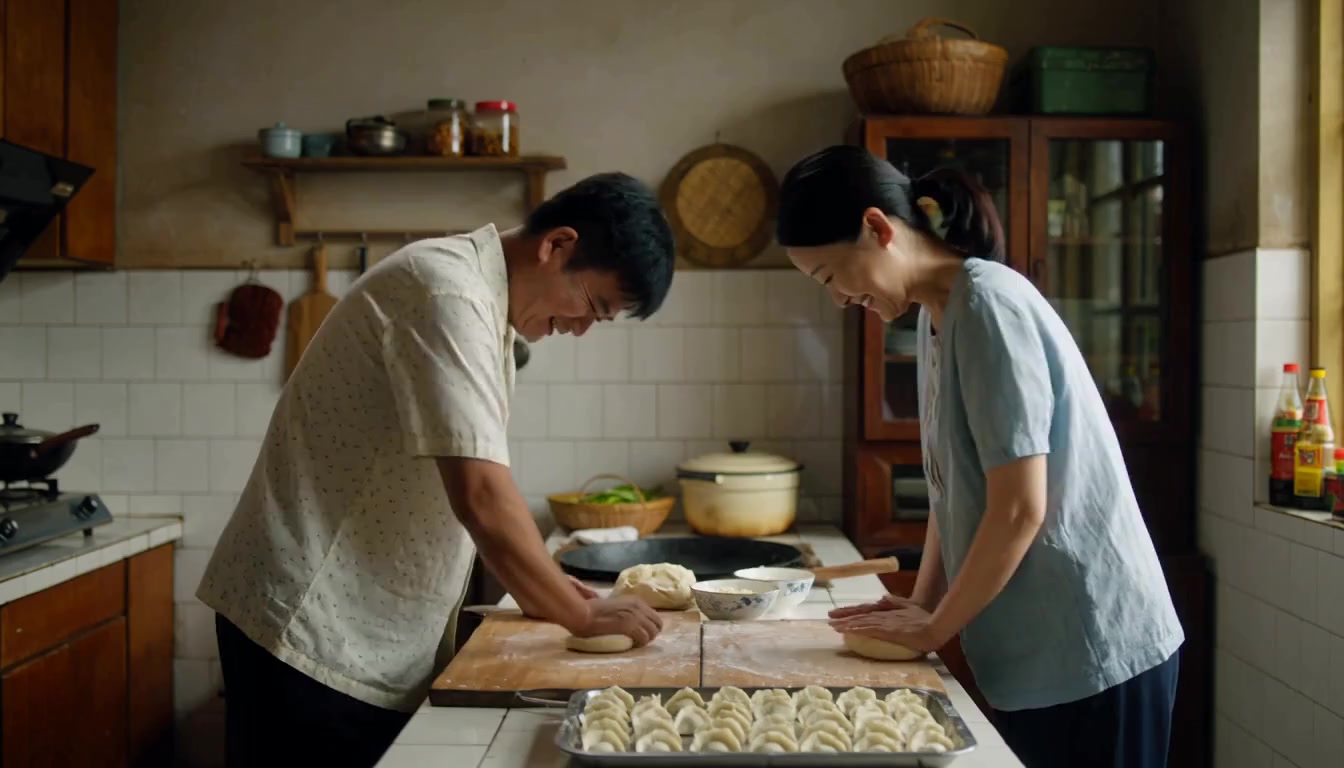
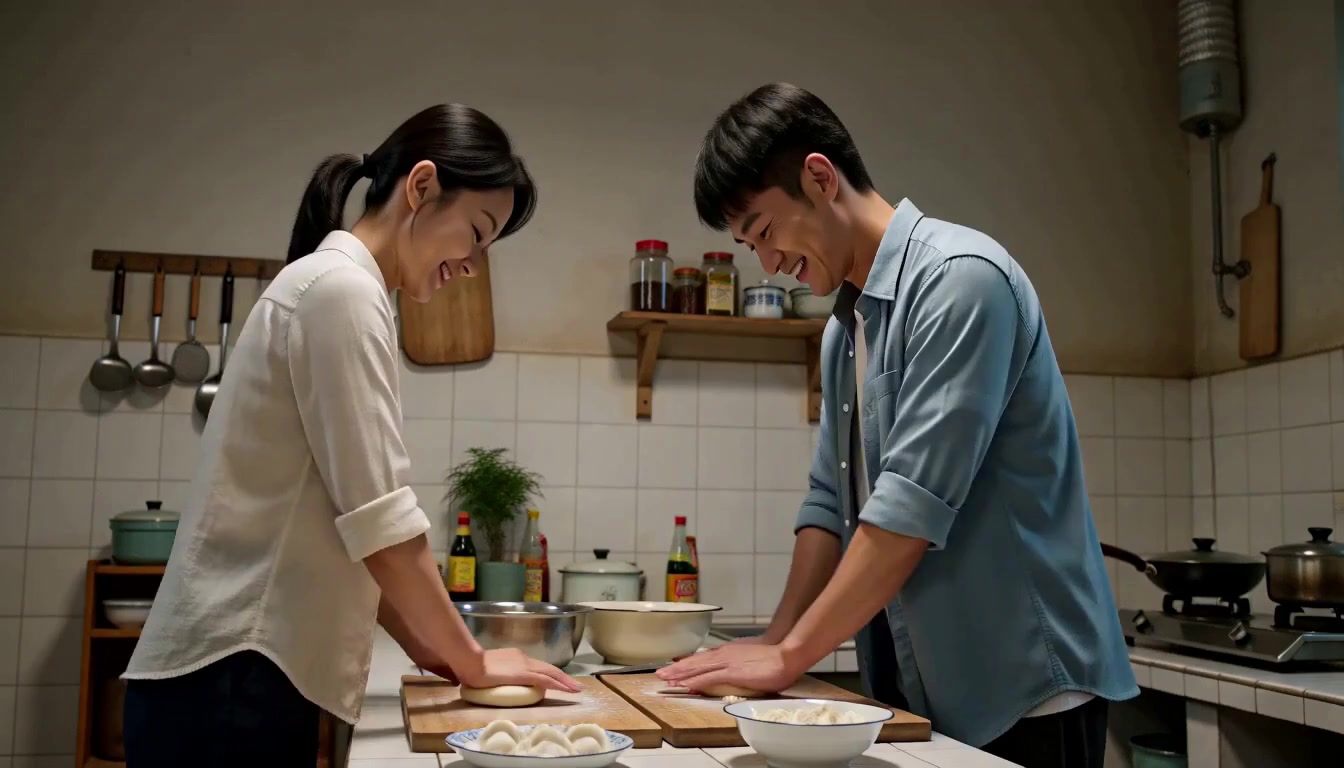
| Учитель, 50 шагов | Студент DMAD, 4 шага |
Вторая сопоставленная пара из сетки MiniMax H3 на странице проекта.
Ограничения
- Опубликованные студенты обучены на 1344x768, 124 кадра, стереозвук 32 кГц, и карточка подаёт это как рабочую точку, а не как одну из многих настроек.
- Показатели предпочтения для H3 исключают ничьи, а сравнения смешивают методы, которых нет в релизе, поэтому прямые сравнения для SDXL и Wan2.1 взяты из запусков статьи, а не из публичных файлов.
- Поскольку в релизе нет официальных нод или JSON рабочего процесса, поддержка в ComfyUI зависит от конвертаций сообщества, а их понижение ранга и раскладка ключей отличаются от тех, что оценивались в статье.
- Полный стек H3 велик (трансформер 33B плюс текстовый энкодер 32B), поэтому четыре шага сокращают стоимость выборки, а не память, необходимую для размещения модели.
Доступность
Страница проекта: yzmblog.github.io/projects/DMAD
Статья: arXiv 2610.02188
Код: Yzmblog/DMAD
Веса: ZhengmingYu/DMAD
Демо-видео: YouTube
Конвертация для ComfyUI: Kijai/MiniMax-H3-experimental
Базовая модель: MiniMaxAI/MiniMax-H3
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.