Viggle Turbo v0.3: Qwen-Image 2.1 за 6 и 9 шагов в ComfyUI
Дистилляция Qwen-Image 2.1 от Viggle v0.3 добавляет 9-шаговый режим и официальные ноды ComfyUI, workflow и объединённые веса для генерации и правок за 6 шагов.
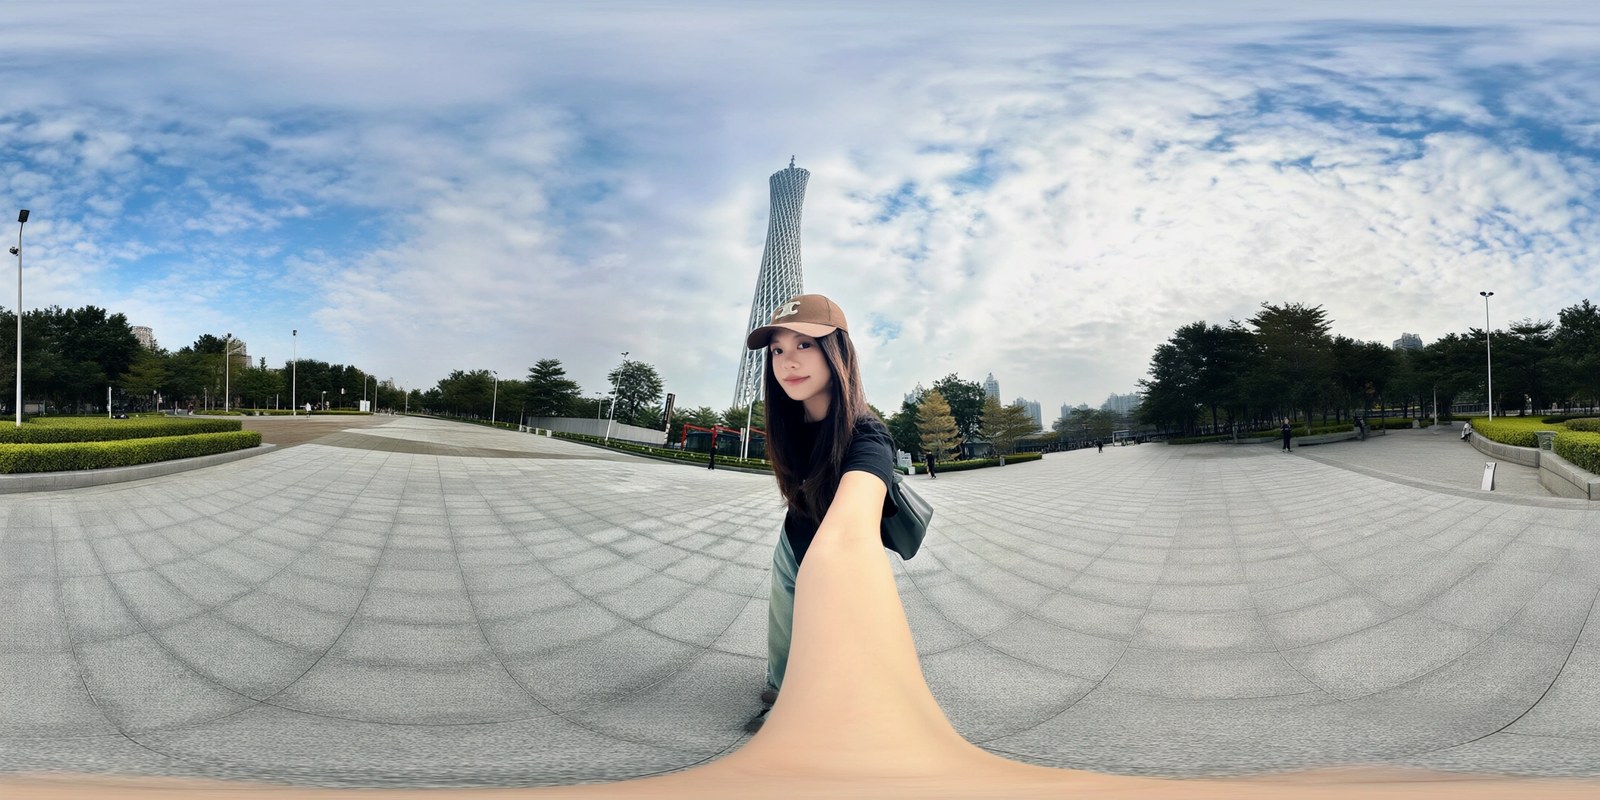
Панорама 360 градусов в равноугольной проекции, собранная из одной перспективной фотографии: сгенерирована в v0.3 за 9 шагов при 2176x1088. Источник: вкладка сравнения demo Space от Viggle.
Что меняет v0.3
Сама дистилляция не изменилась: это LoRA ранга 256 на базовом трансформере Qwen-Image 2.1, сэмплируемая по фиксированному расписанию сигм с true_cfg_scale=1.0 и без негативного промпта. v0.3 смещает баланс, а не метод.
- 6 шагов, перенастроено. По сравнению с v0.2.1 результаты менее зернистые и чище на плоских поверхностях, а мелкая текстура чуть мягче. Viggle прямо указывает, что это не строгое обновление: если вам больше нравился более чёткий вид v0.2.1, этот адаптер остаётся в репозитории.
- Новый 9-шаговый режим. Семь turbo-шагов, затем LoRA отключается, и последние два шага завершает неизменённая базовая модель. Детализация тоньше, а мелкий отрисованный текст чаще получается правильным. Это занимает примерно в 1,4–1,5 раза больше времени, чем 6 шагов, что всё ещё примерно в 3,5 раза быстрее базовой модели на 40 шагов.
- Заявленный потолок. Viggle пишет, что 6 шагов близки к пределу возможностей этого «ученика»: каждый найденный с v0.2.1 выигрыш чем-то платил, более высокая резкость шла с большей зернистостью, а меньшая зернистость с более мягким видом. За этой точкой за качество приходится платить шагами, что и делает 9-шаговый режим.
Режим на 9 шагов
Путь на 9 шагов это не просто более длинное расписание. Пайплайн вычисляет текстовые и референсные K/V один раз и переиспользует их; 7 turbo-шагов заполняют этот кэш, поэтому первому шагу базовой модели приходится пересчитать его до того, как LoRA отключается и управление берёт на себя база. В diffusers это означает step callback и обёртку вокруг forward трансформера, и то и другое показано в карточке модели:
SIGMAS_9 = [1.0, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25, 1 / 6, 1 / 12]6-шаговое расписание сохраняет низкошумовые узлы 0.875, 0.75, 0.5, 0.25 и добавляет шаги только на высокошумовом конце: 5 шагов это [1, 0.875, 0.75, 0.5, 0.25], 7 шагов это [1, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25]. Если вместо этого сдвигать низкошумовые узлы, результаты становятся мягче, а передача простого числа шагов без списка сигм не работает.
9 шагов сейчас работают только в diffusers и demo Space. Рабочие процессы ComfyUI реализуют 6-шаговое расписание.
Официальная поддержка ComfyUI
Это та часть, которой не было в v0.2. В релиз теперь входит порт для ComfyUI в папке comfyui/ репозитория модели, протестированный на ComfyUI 0.37.0 с нативной поддержкой Qwen-Image 2.1:
viggle_turbo.pyдобавляет два узла. Скопируйте его вComfyUI/custom_nodes/и перезапустите ComfyUI.Viggle Turbo Sigmasпредоставляет 6-шаговое расписание с зависящим от разрешения сдвигом пайплайна; используется с euler иBasicGuiderвместо scheduler KSampler, без CFG и без негативного промпта.Viggle Turbo LoRA (unmerged)применяет адаптер во время выполнения так же, как diffusers. Штатные загрузчики LoRA объединяют его с весами, и по измерениям Viggle это отбрасывает около 30 процентов обновления этого адаптера в bf16 и добавляет шум на int8. Необъединённый нод стоит на 10–25 процентов больше времени на шаг.- Рабочие процессы для text-to-image и редактирования, а также варианты для объединённых однофайловых весов и для GGUF.
С настройками int8 по умолчанию, включёнными r128 LoRA и усилителем промпта рабочие процессы достигают пика примерно в 26 ГБ VRAM при 1248x832. В карточке модели также отмечено, что порт для ComfyUI в основном написан с помощью ИИ-ассистента по коду, поэтому шероховатости ожидаемы, а исправления приветствуются.
Объединённые однофайловые трансформеры
Если вы предпочитаете вообще не загружать LoRA, v0.3 также поставляет базовый трансформер, в который адаптер ранга 256 уже объединён в fp32 и один раз квантован. Файлы помещаются в models/diffusion_models/; версии GGUF требуют ComfyUI-GGUF, а при любом варианте всё ещё нужен Viggle Turbo Sigmas из пользовательского нода. Таким способом доступен только 6-шаговый режим.
| Формат | Размер | Загрузчик ComfyUI | LPIPS v0.3 | LPIPS v0.2.1 |
|---|---|---|---|---|
| GGUF Q8_0 | 7.7 ГБ | Unet Loader (GGUF) | 0.051 | 0.054 |
| int8, рецепт convrot от Comfy-Org | 7.3 ГБ | Загрузить модель диффузии | 0.057 | 0.060 |
| GGUF Q6_K | 6.0 ГБ | Unet Loader (GGUF) | 0.055 | 0.067 |
| fp8 e4m3fn, только веса | 7.3 ГБ | Загрузить модель диффузии | 0.068 | 0.070 |
| GGUF Q5_K_M | 5.1 ГБ | Unet Loader (GGUF) | 0.076 | 0.083 |
| GGUF Q4_K_M | 4.3 ГБ | Unet Loader (GGUF) | 0.100 | 0.118 |
| int8 плюс r128 LoRA (рабочие процессы с LoRA) | 8.0 ГБ | Загрузить модель диффузии | 0.041 | 0.044 |
LPIPS это среднее расстояние VGG от Viggle до diffusers, работающего с LoRA ранга 256, по 96 отложенным запросам с одинаковыми промптом, входами, seed и шумом; меньше значит ближе. Для масштаба: ComfyUI и diffusers различаются примерно на 0.03–0.04 без загруженной LoRA.
Объединённые веса близки к пути с LoRA, но не идентичны ему. Примерно в 8 из этих 96 запросов сборки int8 или Q8_0 дают другую композицию или одежду, против 3–5 в рабочем процессе с LoRA. Q4_K_M заметно сильнее отклоняется: 23–29 из 96, и Viggle рекомендует его только тогда, когда ничего большего не помещается в память.
Базовая модель на 40 шагов против 6 и 9 шагов
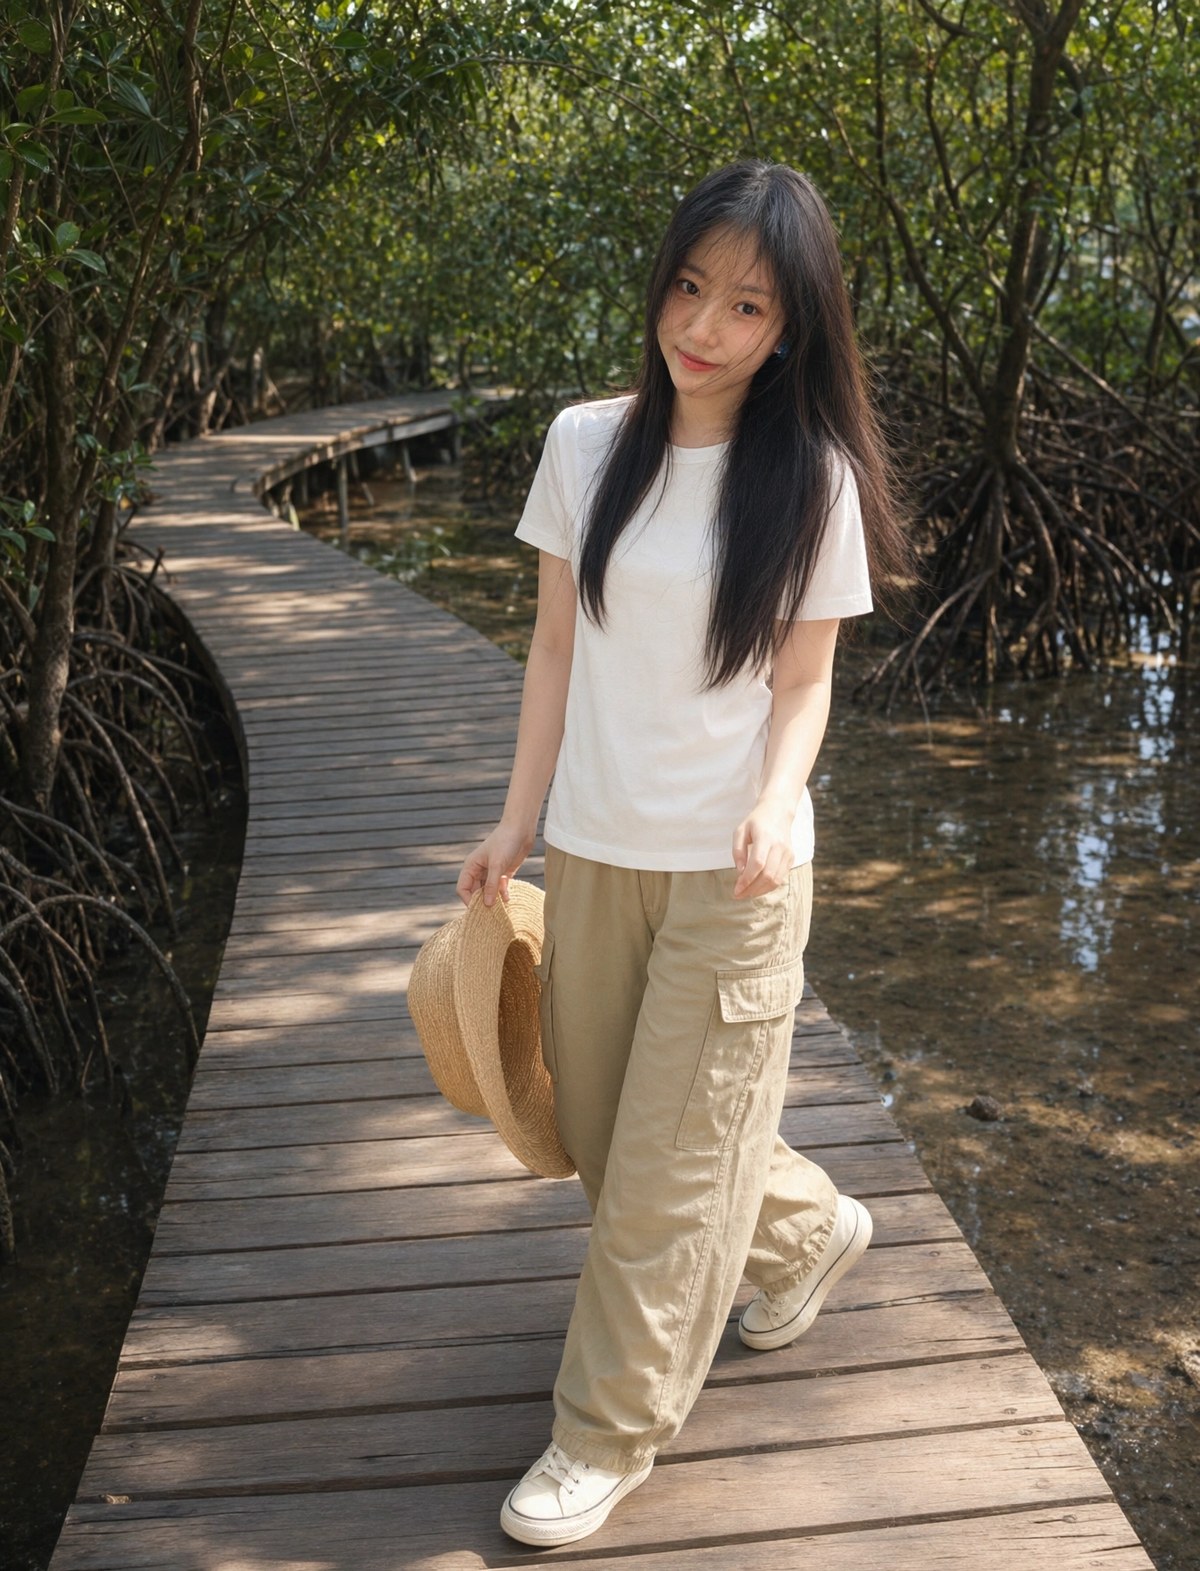
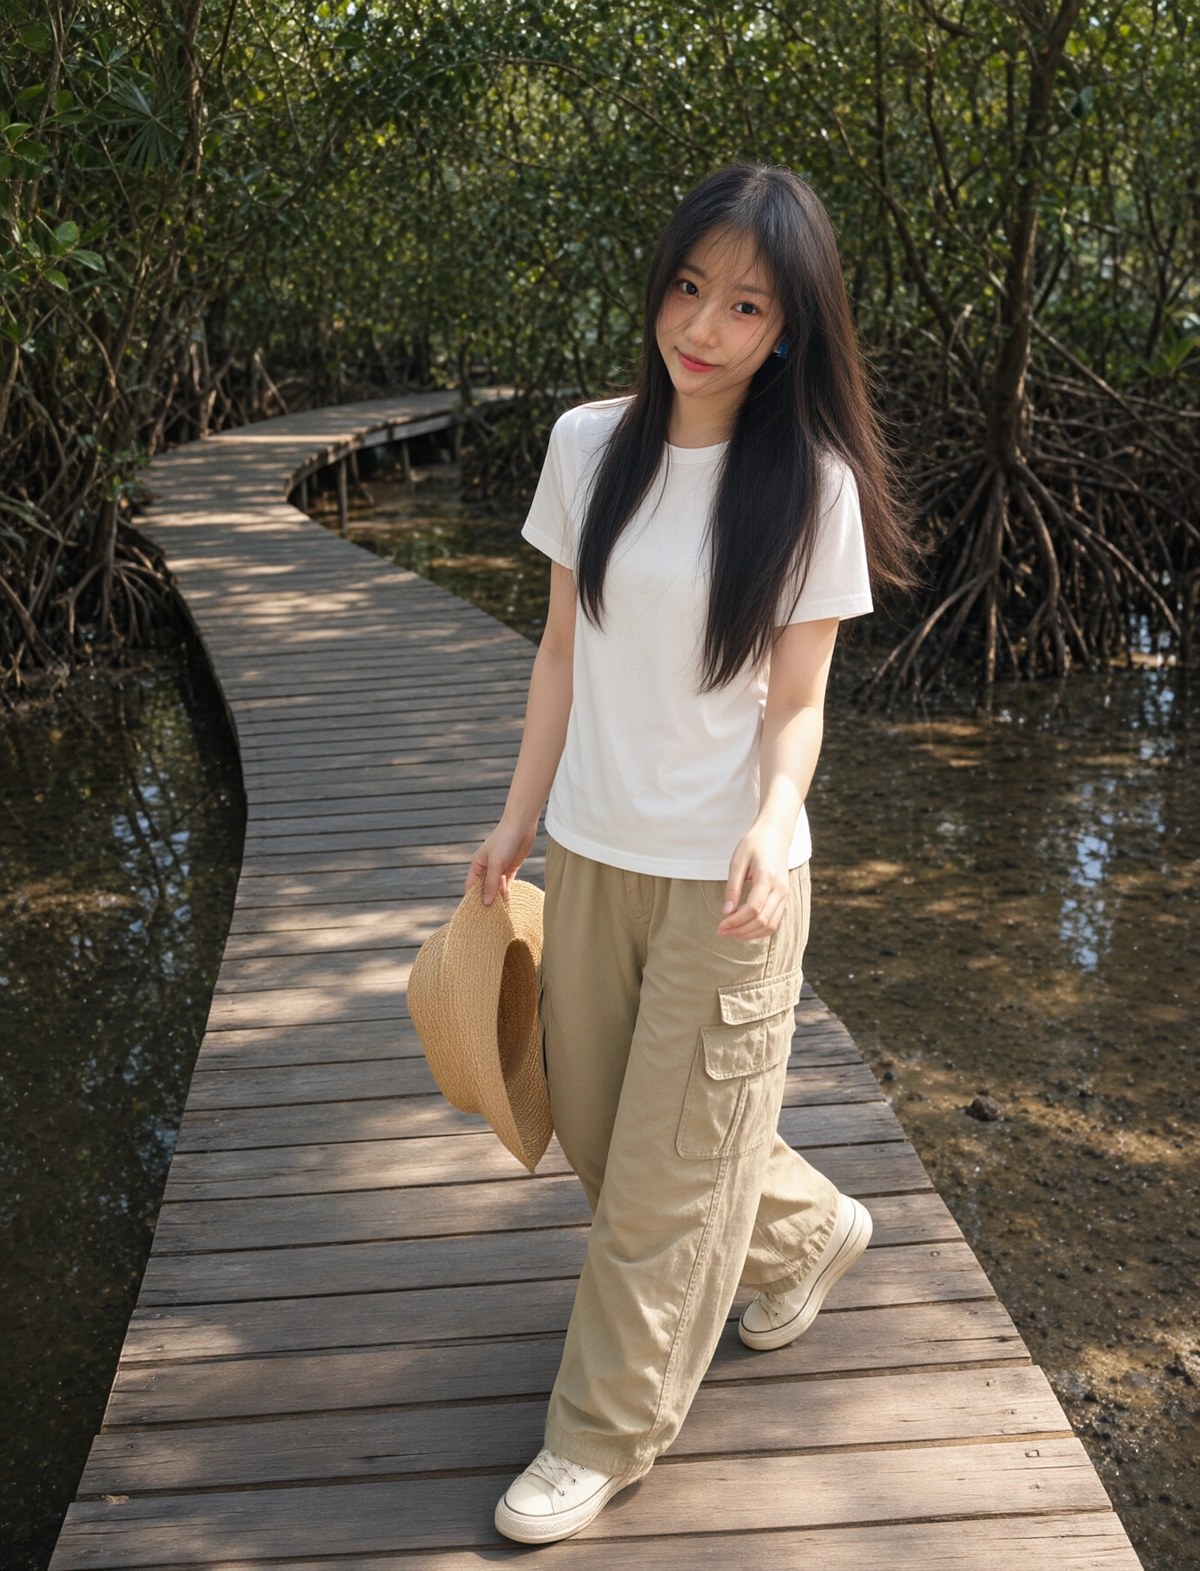
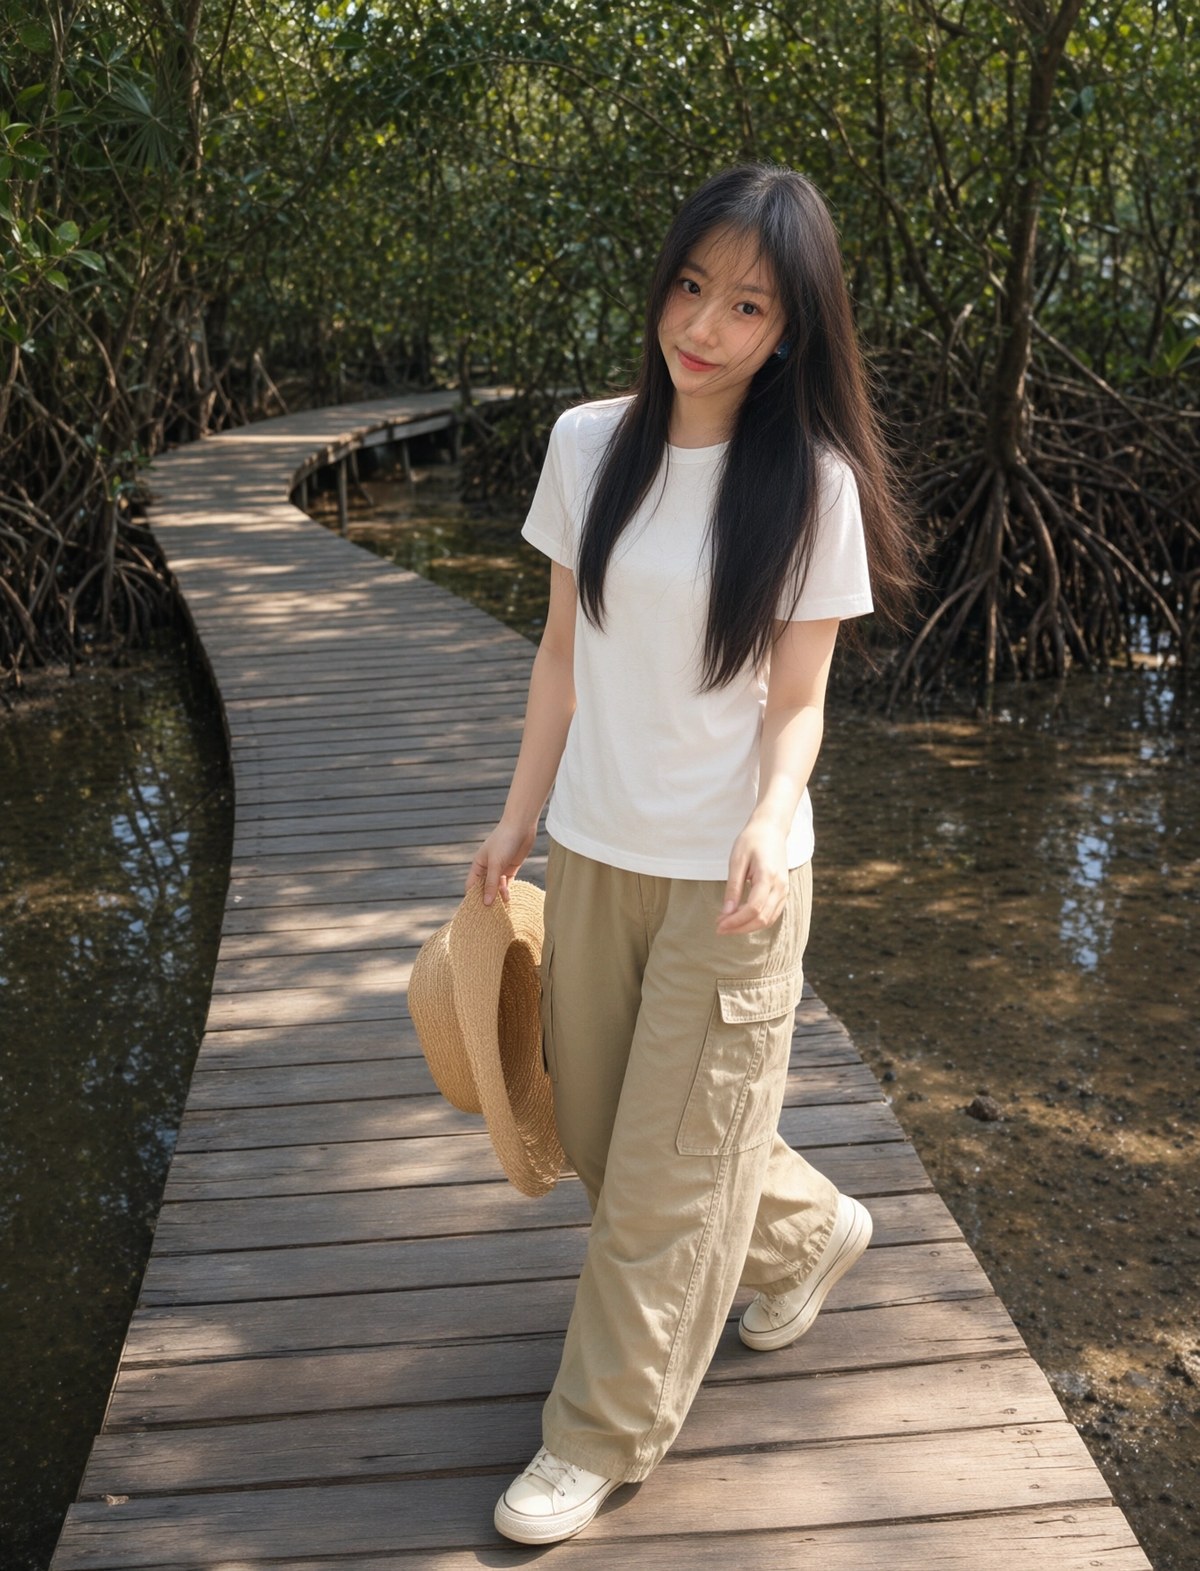
Примеры ниже взяты из вкладки Comparison в собственном demo Space от Viggle. Во всех столбцах используются одинаковые промпт, входы, seed и шум.
 |  |  |
|---|---|---|
| Базовая модель, 40 шагов | v0.3, 6 шагов | v0.3, 9 шагов |
Референс персонажа, перенесённый в сцену с настилом в мангровом лесу, 1344x1760. Результат за 6 шагов самый чистый из двух turbo-столбцов; 9 шагов возвращают часть мелкой текстуры.
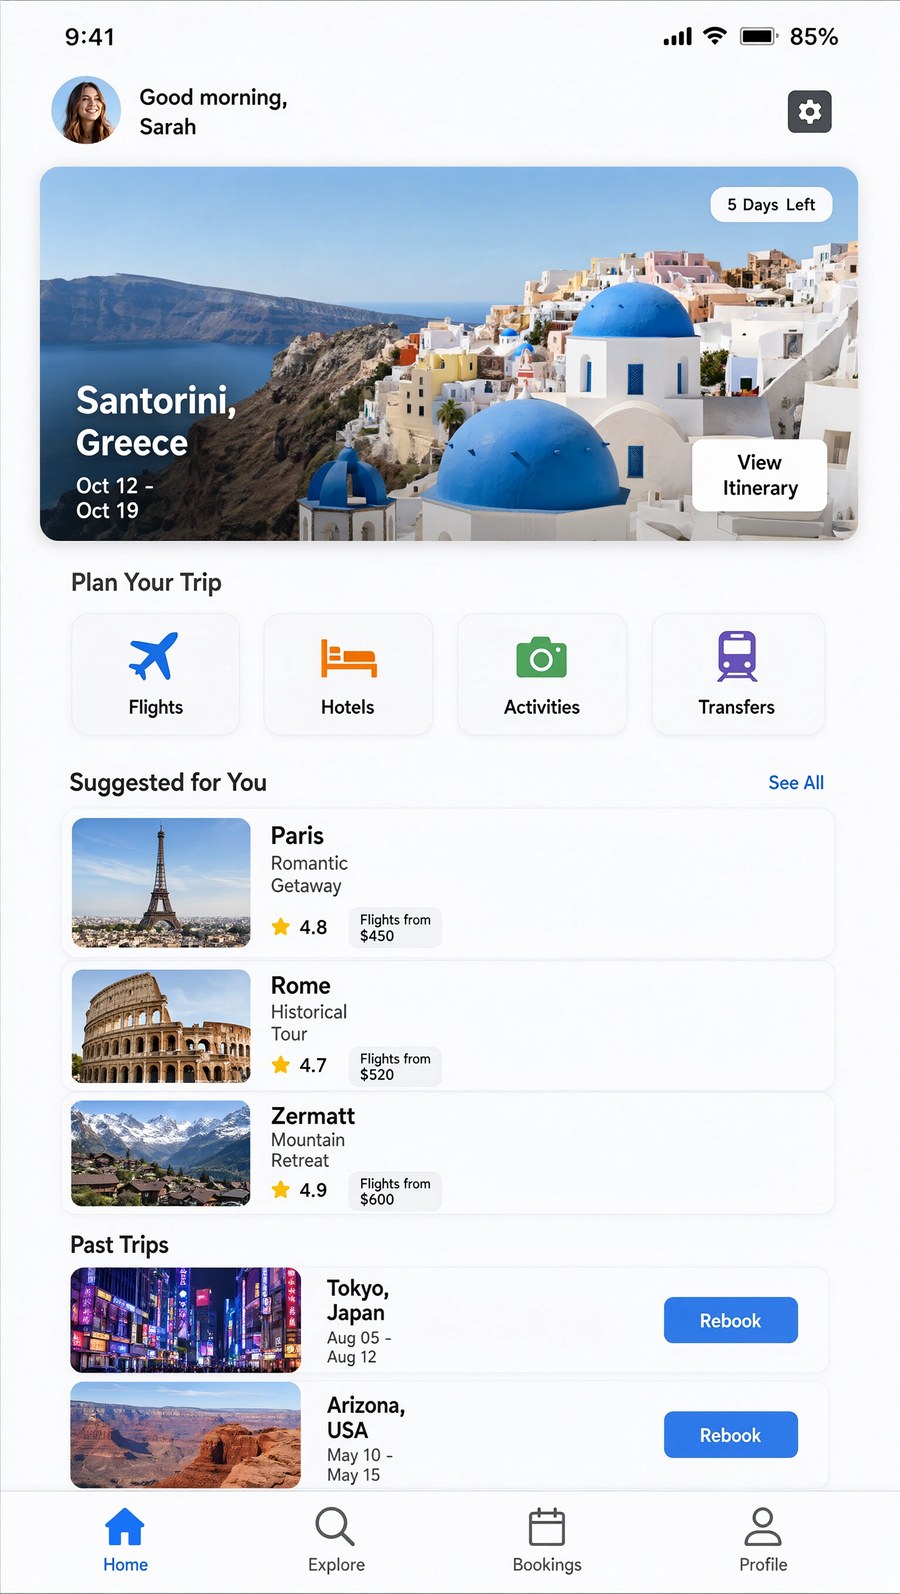
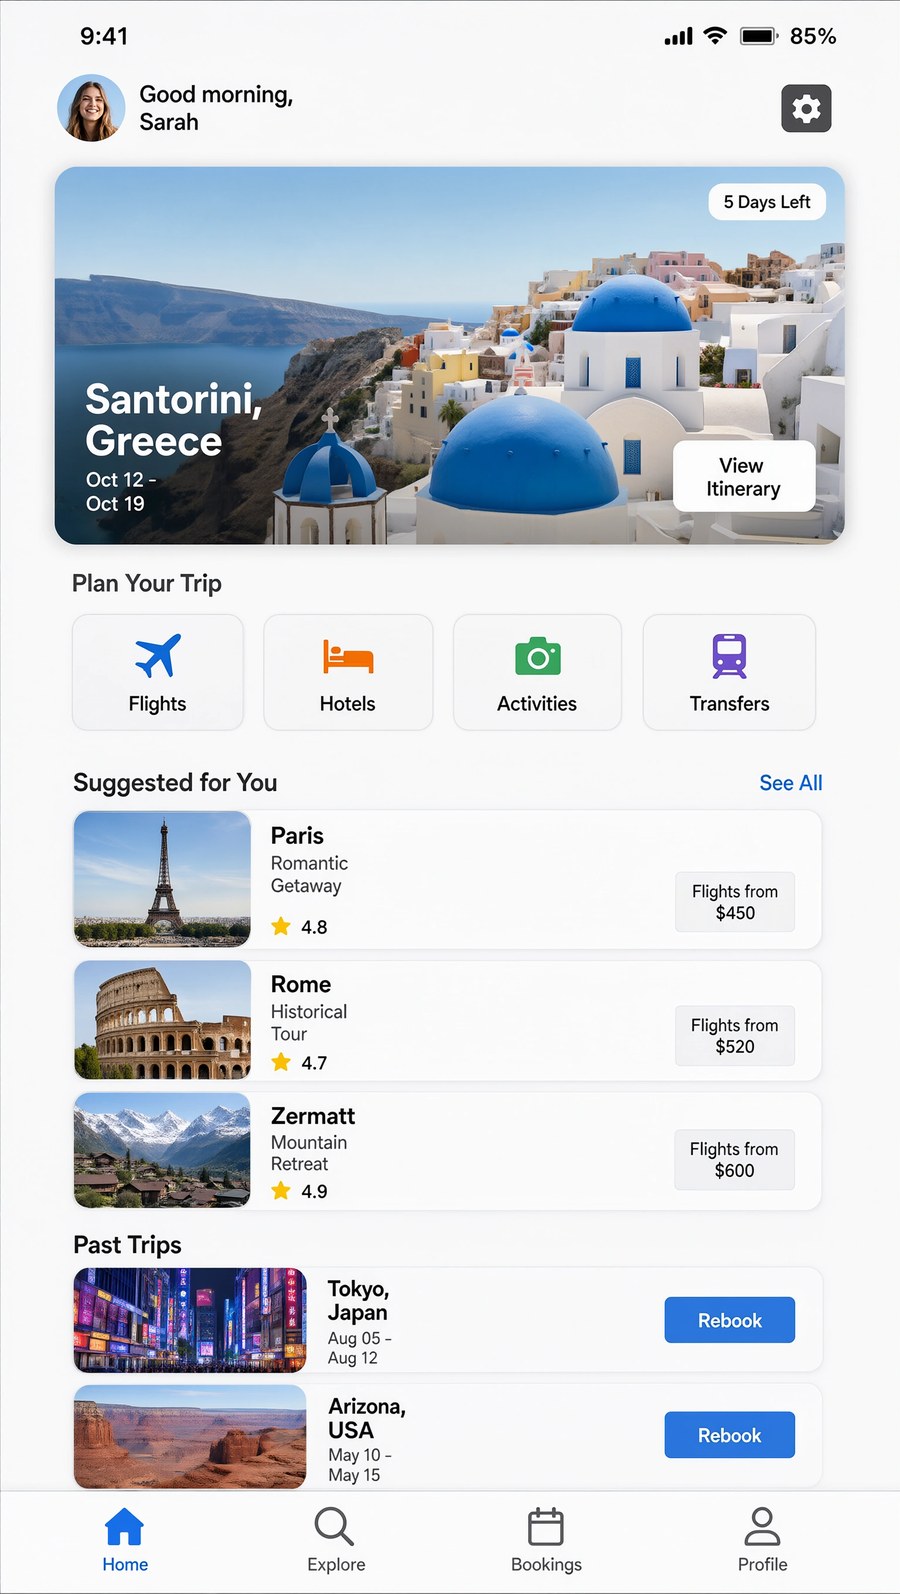
9-шаговый режим нацелен на два места, где 6-шаговый «ученик» всё ещё уступает базовой модели: плотный отрисованный текст и мелкие детали. Вертикальный скриншот приложения с большим количеством мелкого текста интерфейса при 1536x2720 это разумный стресс-тест, и вкладка сравнения запускает один из таких.
 |  |
|---|---|
| Базовая модель, 40 шагов | v0.3, 9 шагов |
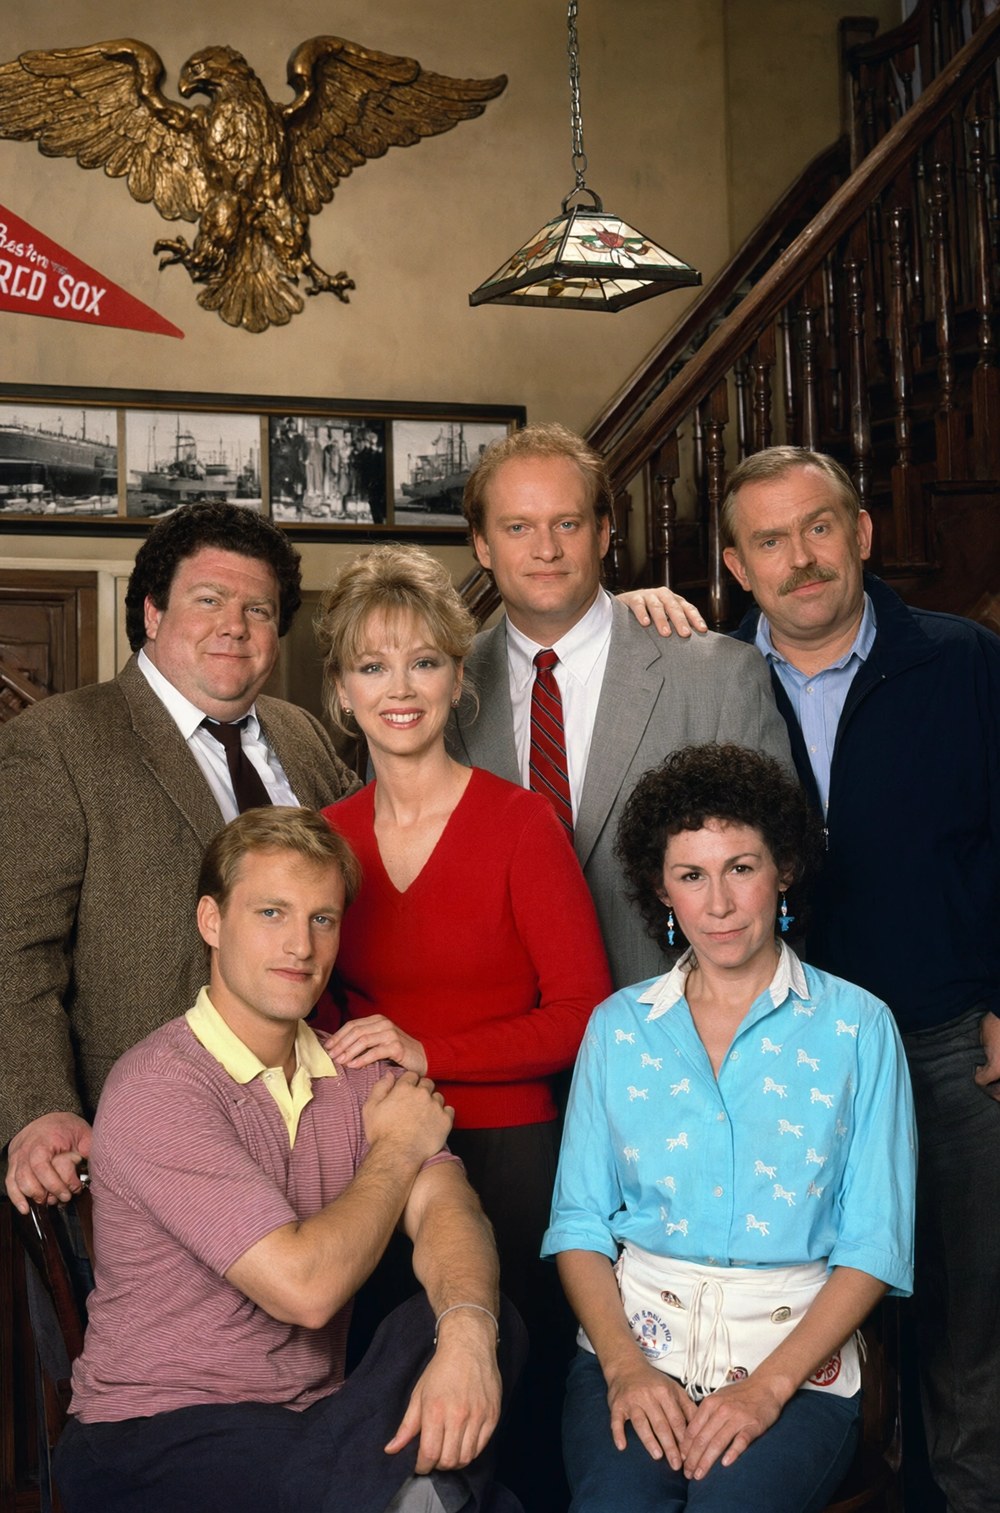
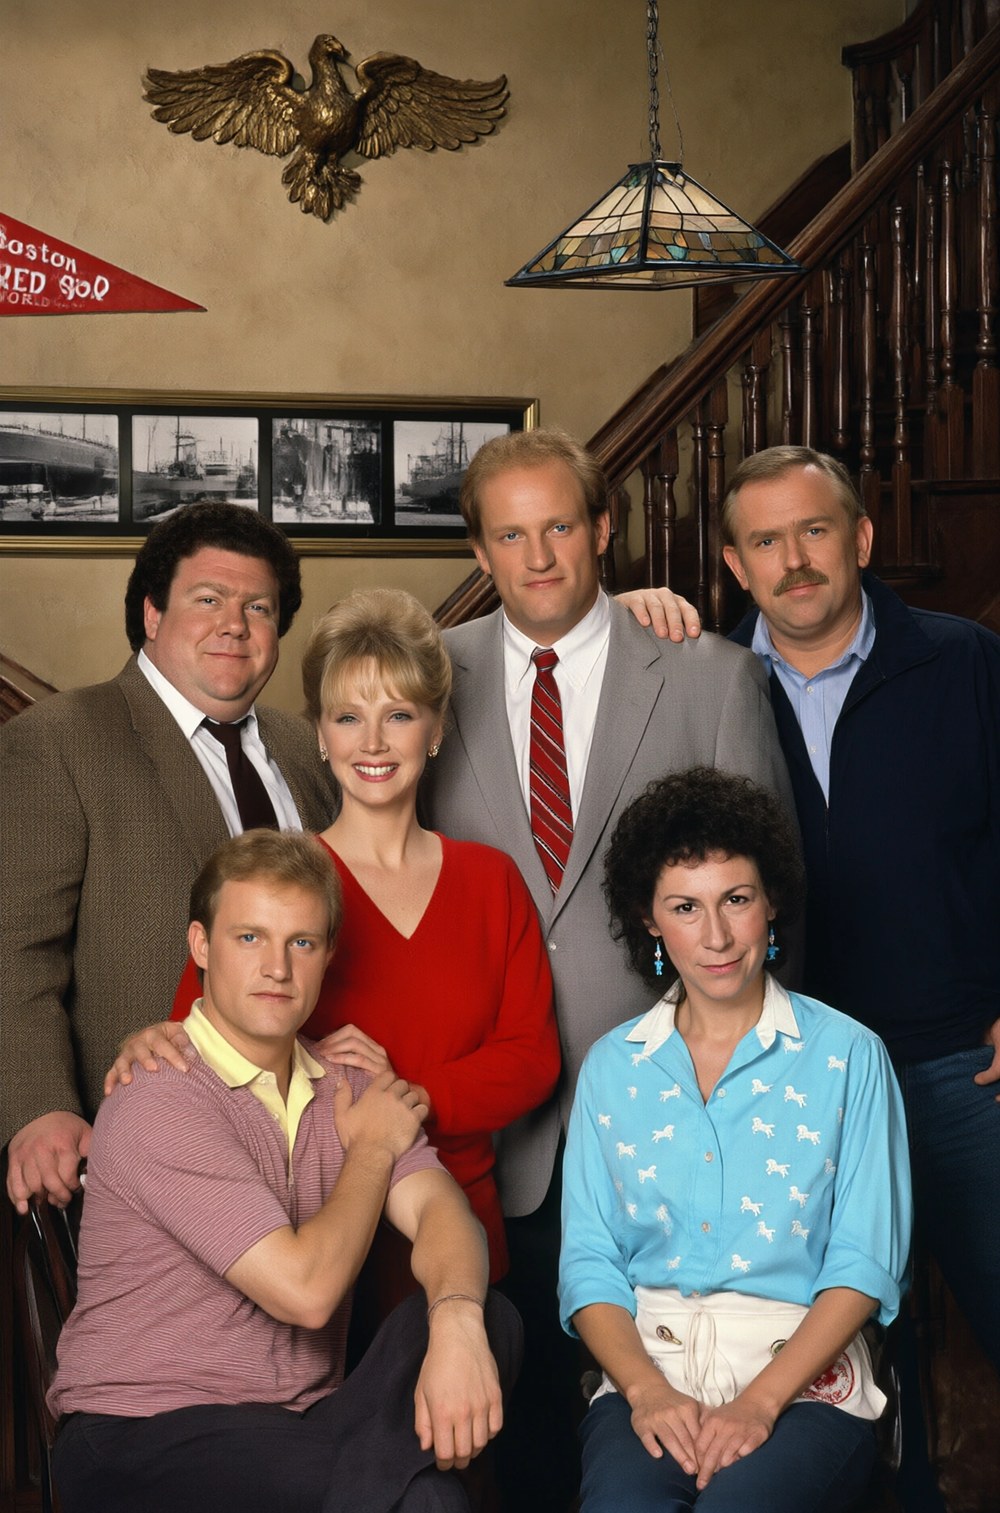
Дистилляция также работает с максимум 3 референсными изображениями в diffusers, и групповой портрет из шести изображений ниже проверяет этот путь: шесть личностей, один промпт, один интерьер бара.
 |  |
|---|---|
| Базовая модель, 40 шагов | v0.3, 6 шагов |
Скорость
Те же сравнения, секунды на изображение, как указано в demo Space:
| Случай | Разрешение | База, 40 шагов | v0.3, 6 шагов | v0.3, 9 шагов |
|---|---|---|---|---|
| Портрет по референсу | 1344x1760 | 14.0 с | 2.9 с | 4.0 с |
| Групповой портрет из шести референсов | 1248x1888 | 25.8 с | 5.9 с | 8.8 с |
| Плотный скриншот приложения | 1536x2720 | 26.9 с | 4.9 с | 6.8 с |
| Панорама 360 градусов | 2176x1088 | 14.3 с | 2.9 с | 4.1 с |
Чего он по-прежнему не умеет
Карточка модели необычно прямо говорит об оставшемся разрыве. Сложное редактирование это по-прежнему то место, где «ученик» отстаёт: композиция по нескольким референсам, замена лиц и инструкции с сохранением личности могут давать дублированных или «призрачных» персонажей и дрейф личности. Мелкий или длинный отрисованный текст искажается чаще, чем у базовой модели, и 9 шагов помогают, но не исправляют это. Цвета получаются на несколько процентов менее насыщенными. Вывод в 2K, вывод RGBA, редактирование по маске и редактирование с более чем 3 референсами проверяются только на глаз во вкладке сравнения, без заявленных бенчмарков.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.