Looped-DiT: модель на 260M обходит модель в 6,5 раза крупнее
Looped-DiT от OpenSenseNova (SenseTime) повторно прогоняет общие блоки transformer внутри каждого шага денойзинга, позволяя небольшой модели обойти значительно более крупную.
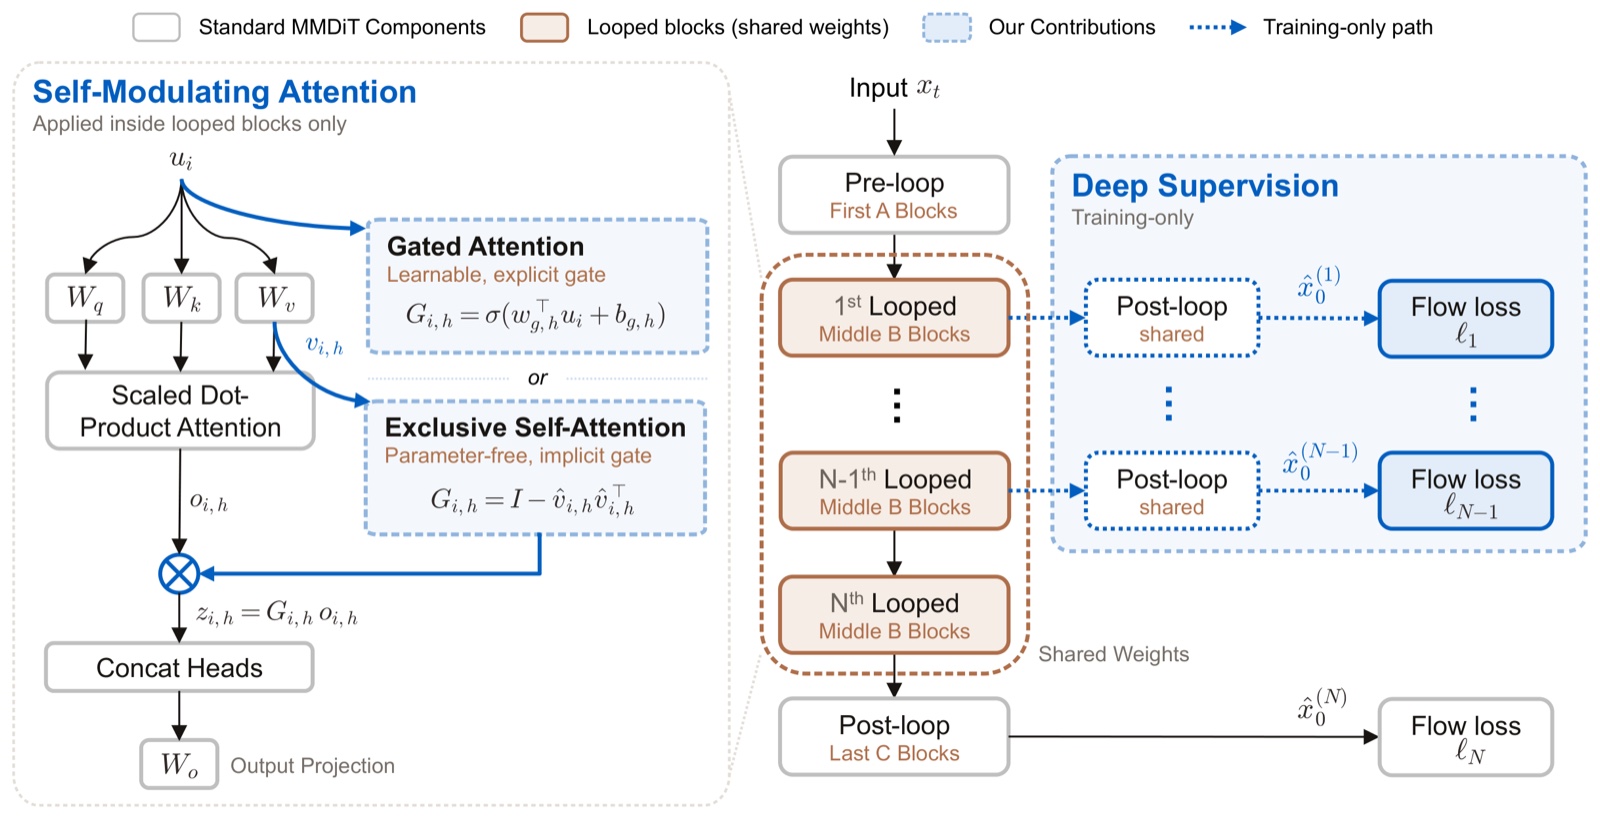
Метод: общая группа блоков зацикливается N раз на каждом шаге денойзинга, при этом самомодулирующее внимание регулирует цикл, а глубокая супервизия обучает состояние после каждого прохода.
Почему наивное зацикливание не работает
Двукратный прогон одних и тех же блоков не даёт надёжного улучшения diffusion transformer. В статье это связывают с двумя проблемами: слабая супервизия на промежуточных циклах и обновления внимания, которые постепенно разрушают локальную информацию по мере роста числа циклов. Looped-DiT добавляет два компонента, чтобы это исправить:
- Глубокая супервизия (Deep Supervision) декодирует состояние после каждого цикла через постцикловые блоки и обучает каждое из этих предсказаний на одну и ту же цель: чистое изображение.
- Самомодулирующее внимание (Self-Modulating Attention) регулирует обновления внимания внутри цикла, используя эксклюзивное самовнимание (XSA) или гейт внимания по головам.
В основе лежит MMDiT в пиксельном пространстве из MiniT2I с обусловливанием на замороженной модели FLAN-T5-Large. Репозиторий охватывает обучение для B/32, B/16 и L/16, вывод на любой глубине циклов, оценку на шести бенчмарках и скрипты подготовки датасетов для каждого обучающего набора.
Результаты
Оценки получены с EMA-весами, 100 шагами Euler, guidance 6.0 и глубиной циклов 4:
| Модель | Патч | GenEval | DPG | PRISM | CoRe | Spatial | TIIF | Сред. |
|---|---|---|---|---|---|---|---|---|
| Looped-DiT B/32 | 32 | 85.1 | 85.3 | 54.4 | 44.5 | 52.3 | 76.1 | 66.3 |
| Looped-DiT B/16 | 16 | 87.4 | 87.0 | 67.0 | 53.5 | 54.6 | 79.7 | 71.5 |
Главное утверждение содержится в аннотации статьи: при сопоставимом числе параметров и сопоставимых вычислительных затратах зацикленная архитектура стабильно превосходит незацикленные базовые варианты, а более глубокая зацикленность даёт больше, чем дополнительные шаги денойзинга при фиксированном бюджете вывода. Авторы также сообщают, что более глубокие циклы постепенно исправляют ошибки, допущенные на более ранних циклах, и описывают такое поведение как признак латентного рассуждения.
Запуск
Оба чекпойнта опубликованы как файлы PyTorch, sensenova/Looped-DiT-B16 и sensenova/Looped-DiT-B32, а вывод выполняется одним вызовом модуля. --loops задаёт глубину циклов, а передача нескольких значений даёт по одной строке на каждое, так что глубину можно сравнить на одном промпте:
hf download sensenova/Looped-DiT-B16 looped-dit-b16.pt --local-dir checkpoints

python -m looped_dit.sample --checkpoint checkpoints/looped-dit-b16.pt \
    --prompt "a red cube on top of a blue sphere" --loops 1 2 3 4 --out loops.png
Основные результаты статьи получены с Euler, 100 шагов, guidance 6.0, глубина циклов 4 при 512x512 на EMA-весах в bfloat16. Глубина 4 является обученной глубиной, но авторы отмечают, что другие глубины работают без дообучения, поэтому число циклов представляет собой настраиваемый параметр на этапе вывода, а не фиксированное свойство чекпойнта.
Доступность
Это исследовательский релиз, а не интеграция с ComfyUI. На данный момент нет ни ноды ComfyUI, ни перепаковки от Comfy-Org, ни pipeline diffusers, поэтому для запуска потребуется собственное окружение Python из репозитория: сборка PyTorch 2.1 или новее с CUDA, requirements.txt и стеки для оценки (mmdet, vLLM, modelscope), устанавливаемые отдельно, поскольку данные бенчмарков и веса Mask2Former не включены в поставку. Учитывая дату релиза и 51 звезду на GitHub, собранную на данный момент, появление порта от сообщества не стало бы сюрпризом, но на момент написания ничего подобного не существует.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.