Turbo8: дистилляционная LoRA на 8 шагов для Qwen-Image 2.1
Turbo8 дистиллирует Qwen-Image 2.1 до 8 шагов без CFG: text-to-image, редактирование, вывод RGBA и извлечение объекта, плюс два готовых рабочих процесса ComfyUI.
С момента выпуска 20 сентября 2026 года Qwen-Image 2.1 обзавёлся несколькими маршрутами с малым числом шагов: LoRA Pruna на 5 и 8 шагов, turbo LoRA от Viggle и официальная 4-шаговая дистилляция Fun Acc от Alibaba PAI. Turbo8: вклад сообщества в этой же гонке, и его отличительная черта: широта охвата. Вместо ускорения только text-to-image он обучен сохранять поведение всей базовой модели, включая пути редактирования с RGBA и несколькими референсами, с которыми более ранние адаптеры справлялись хуже.
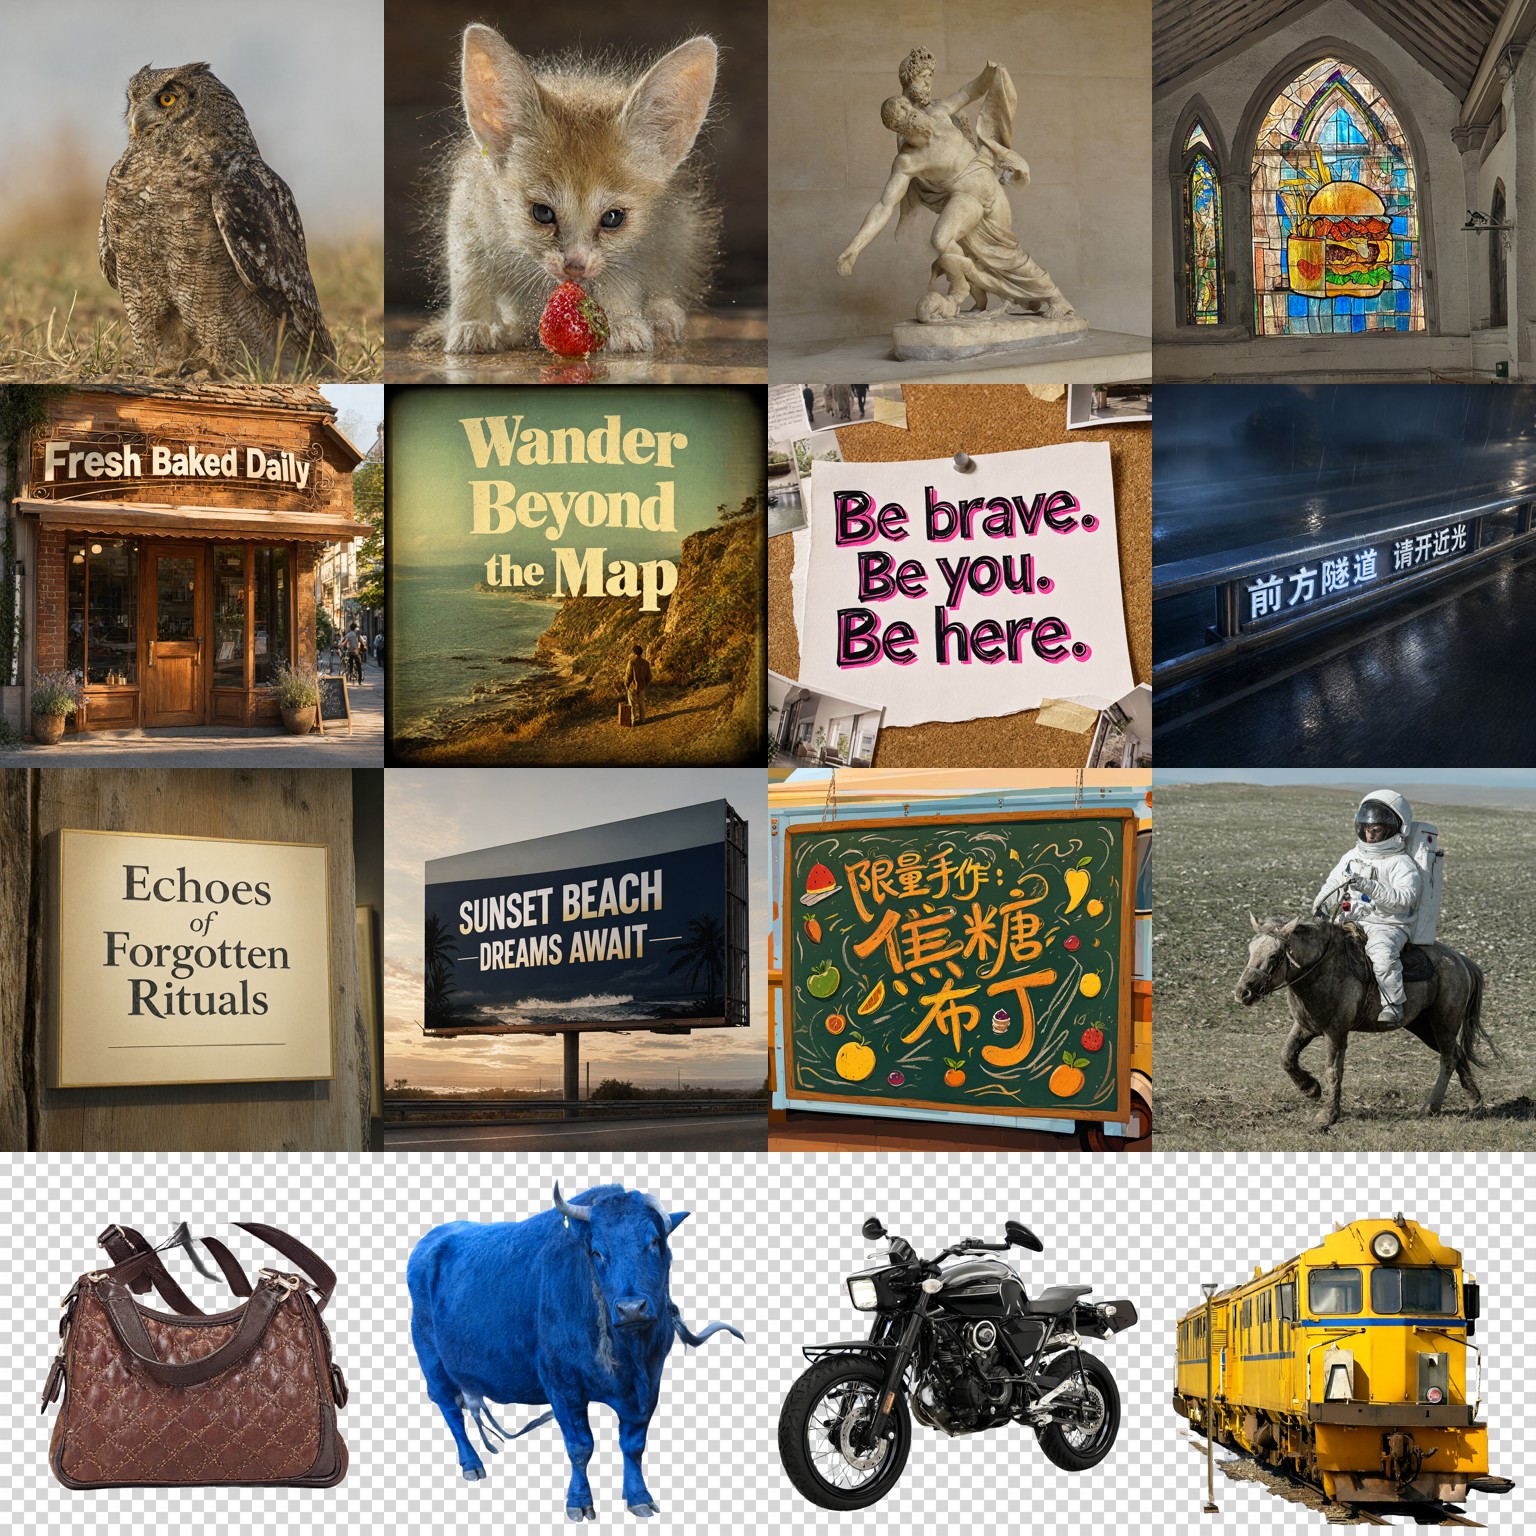
Все примеры используют Turbo8 с 8 шагами и CFG 1 при 1024², первый seed, без отбора лучших результатов внутри промпта. Промпты для показа выбраны из отложенного оценочного набора. Источник: Turbo8-LoRA-Qwen-Image-2.1.
Что он делает
Адаптер представляет собой LoRA ранга 128 на слоях внимания, MLP, модуляции и timestep-embedding модели Qwen-Image 2.1, дистиллированную так, что базовые веса остаются нетронутыми. При выводе он работает с 8 шагами, CFG 1, сэмплером euler, scheduler simple, и автор отмечает, что превышение 8 шагов или CFG 1 не улучшает результаты.
Заявленное преимущество: не одна задача, а широта охвата: text-to-image вплоть до нативного разрешения модели 2K, рендеринг английского и китайского текста, редактирование по инструкции с использованием до 10 референсных изображений, генерация с прозрачностью и извлечение объекта (передаёте фото и запрашиваете RGBA-вырезку). Карточка модели также документирует путь обучения: это трёхэтапный рецепт: 3 100 рендеров учителя за 40 шагов с фиксированным шумом, записанных на 8 уровнях шума ученика, 3 000 шагов регрессии траектории, затем 2 500 шагов сопоставления распределений DMD2 с критиком на основе fake-score и GAN-головой. Критик представляет собой вторую LoRA на том же замороженном transformer.
Запуск в ComfyUI
Turbo8 рассчитан непосредственно на нативную поддержку Qwen-Image 2.1 в ComfyUI:
- Поместите
turbo8_lora_step2500.safetensorsвComfyUI/models/loras/. - Загрузите
comfyui/turbo8_t2i.json(text-to-image и RGBA) илиcomfyui/turbo8_edit.json(редактирование и извлечение). - Оставьте 8 шагов, CFG 1, сэмплер
euler, schedulersimple.
Граф T2I включает ноду ModelSamplingFlux (max_shift 0.6935, base_shift 0.5), подключённую к ширине и высоте, что воспроизводит зависящее от разрешения расписание шума, с которым дистиллировалась LoRA, в том числе при 2K. Согласно карточке модели, все 227 слоёв LoRA корректно отображаются в ComfyUI, а изображение 1024² занимает около 4 секунд на RTX PRO 6000.
Сравнение с учителем
В карточке модели Turbo8 сравнивается со своим учителем, базовой моделью на 40 шагах, на 192 отложенных промптах: DrawBench плюс дополнительные seed, промпты на рендеринг текста, RGBA-объекты, правки и извлечения OmniEdit.
| Метрика | Учитель (40 шагов) | Turbo8 (8 шагов) |
|---|---|---|
| PickScore, T2I | 22.15 | 21.94 |
| CLIPScore, T2I | 26.89 | 26.89 |
| PickScore, RGBA | 20.51 | 20.07 |
| Точное совпадение текста (OCR) | 95.0% | 75.0% |
| Посимвольная точность текста | 99.6% | 95.3% |
| Доля прозрачности (RGBA + извлечение) | 0.875 | 0.925 |
| Разнообразие seed (меньше значит разнообразнее) | 0.705 | 0.670 |
| Сходство правок с учителем (DINOv2) | н/д | 0.967 |
| IoU альфы извлечения относительно учителя | н/д | 0.85 |
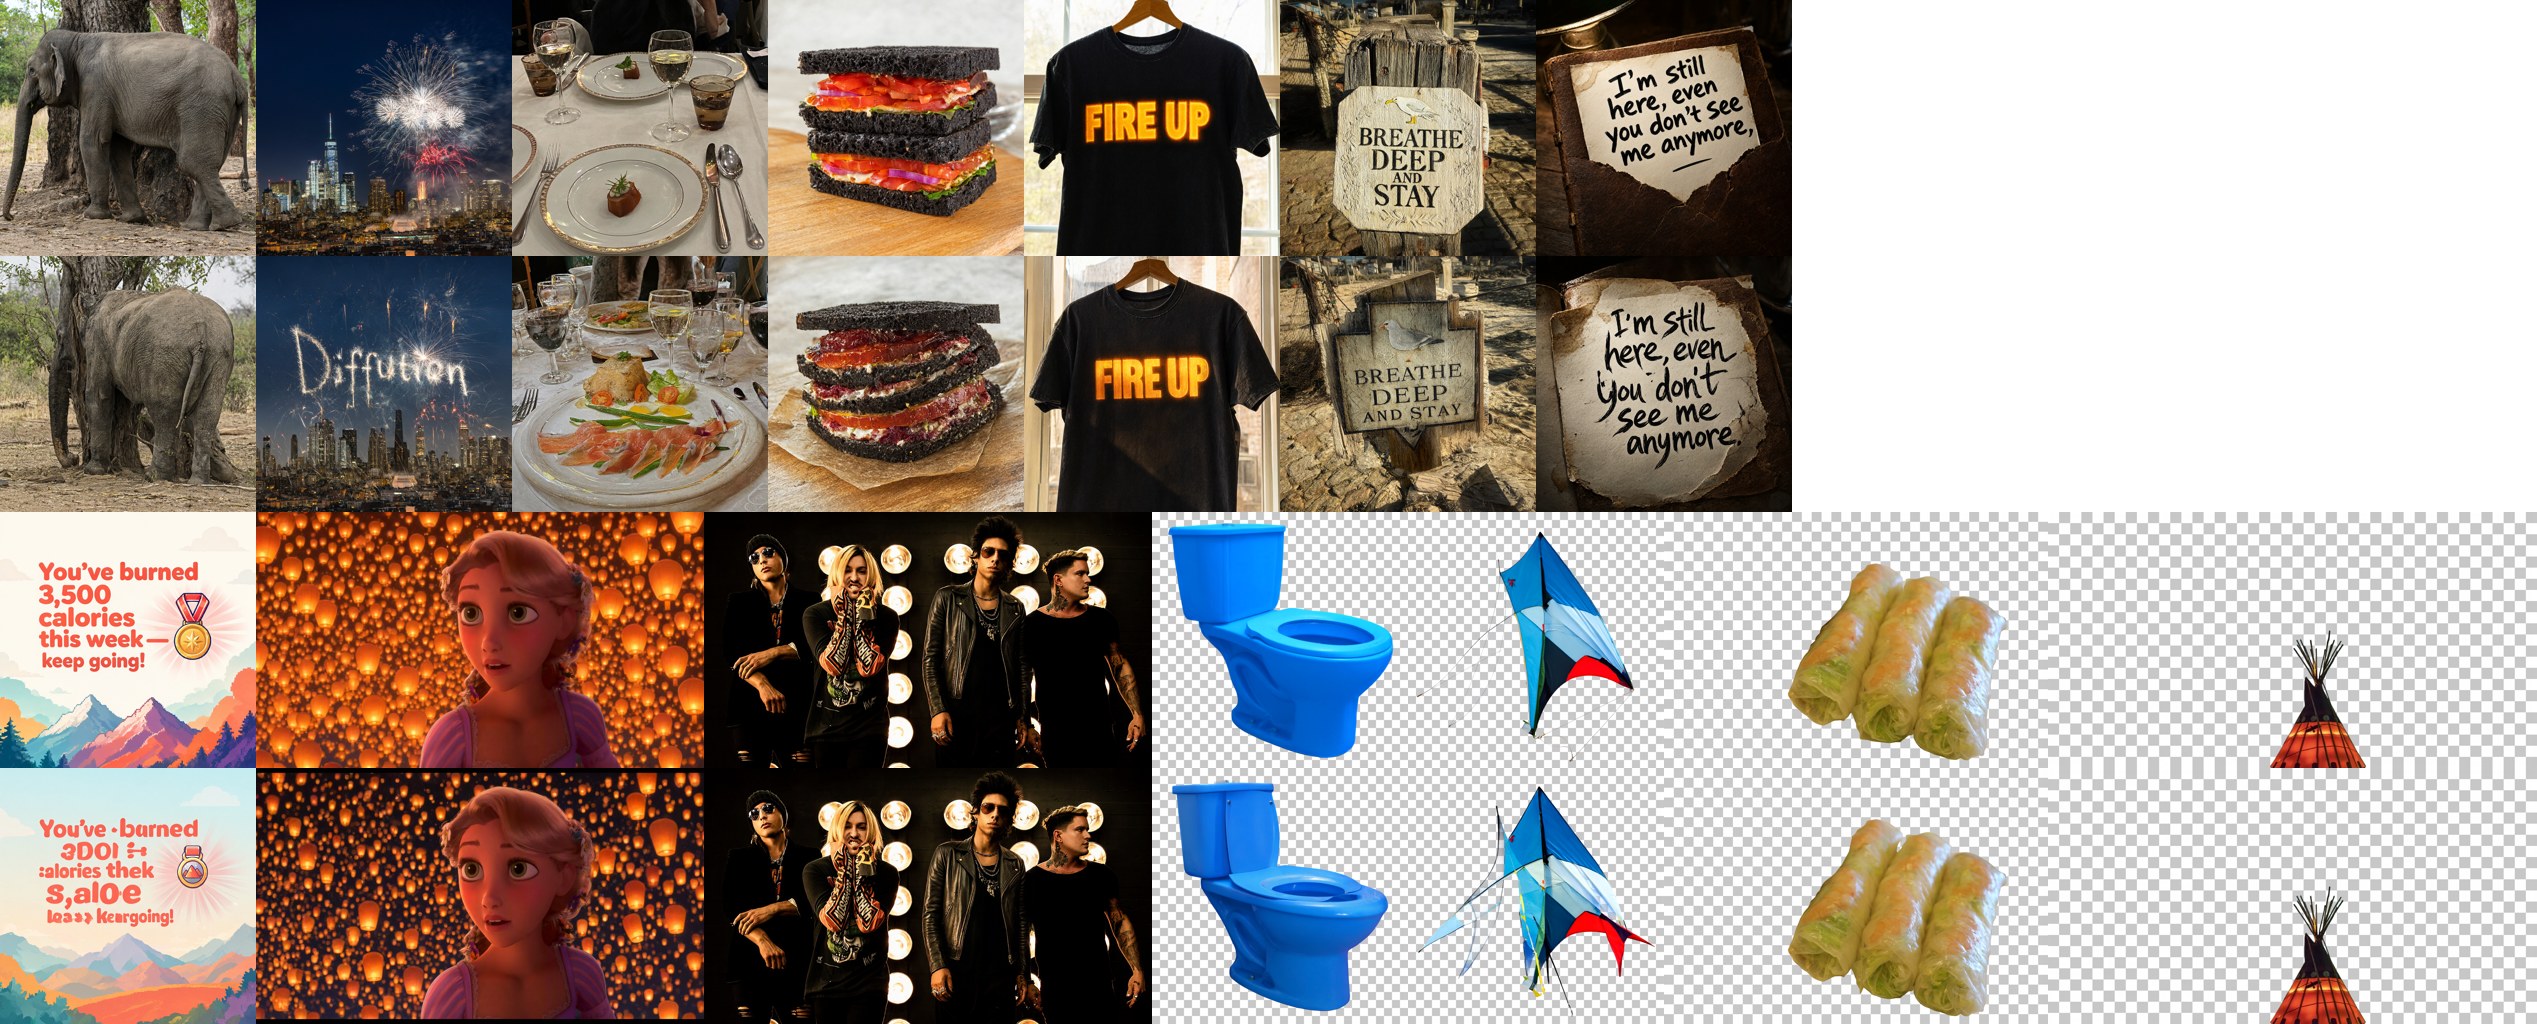
Учитель на 40 шагах (верхний ряд в каждой паре) против Turbo8 на 8 шагах (нижний ряд), одинаковый seed. Примеры охватывают text-to-image, рендеринг текста, правки, RGBA и извлечение.
Задокументированные ограничения
В карточке модели перечислены слабые места, а не оставлены на самостоятельный поиск:
- Плотный или длинный текст (абзацы, мелкий шрифт) деградирует гораздо сильнее, чем при 40 шагах, тогда как короткие заголовки, вывески и подписи остаются надёжными.
- На некоторых насыщенных сценах композиция может отличаться от той, что даёт учитель при том же seed.
- Извлечение наследует неудачные случаи базовой модели: в оценке 3 из 16 извлечений оказались пустыми как у учителя, так и у Turbo8, а Turbo8 иногда сохраняет больше окружающего контекста в вырезке.
В сообществе
В канале #qwen-image сообщества Banodoco пользователи в последующие дни тестировали Turbo8 против более ранних маршрутов с малым числом шагов. Общий вывод: для устойчивой работы при редактировании ему нужны сниженная strength и более 8 шагов: в сообщениях сходились на strength 0.65 и примерно 16 шагах до появления артефактов на теле, и несколько пользователей поставили его выше 6-шагового turbo от Viggle для правок, продолжая при этом предпочитать 8-шаговое расписание Pruna для части задач.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.