Texture-Fix-VAE: более чистый декодер VAE для Qwen-Image 2.1
Texture-Fix-VAE от madebyollin дообучает декодер VAE Qwen-Image 2.1, чтобы убрать шахматные артефакты текстуры. Поместите файл в ComfyUI/models/vae и загружайте его как обычно.
ComfyUI/models/vae/ и выберите в ноде Load VAE.
Qwen-Image 2.1 выполняет денойзинг в сжатом латентном пространстве, а декодер VAE это последний шаг, который превращает латент обратно в пиксели. Всё, что декодер не может восстановить чисто, закрепляется в готовом изображении, независимо от того, насколько хорошей была выборка. Пользователи описывали этот симптом с момента релиза: слабая сетка размером в два пикселя и слегка дизеренный вид на насыщенных участках, таких как листва, волосы и ткань.
Texture-Fix-VAE воздействует именно на этот шаг. Энкодер не тронут, поэтому латентный формат, расписание выборки и любая LoRA или квантованный checkpoint продолжают работать без изменений.
До и после
Автор сгенерировал латенты для приведённого ниже сравнения с помощью Qwen-Image 2.1 по промпту в фотостиле, насыщенному мелкими текстурами:
Пейзажная фотография субальпийского луга с дикими цветами на Тихоокеанском Северо-Западе в разгар лета: прозрачный горный ручей, вьющийся по замшелым валунам среди фиолетового люпина и красной кастиллеи, позади густой лес из старовозрастной дугласовой пихты и западного красного кедра, вдали заснеженный вулкан, золотой свет позднего дня, высокая детализация
Обе колонки декодируют одни и те же латенты, поэтому любое различие обусловлено только декодером.
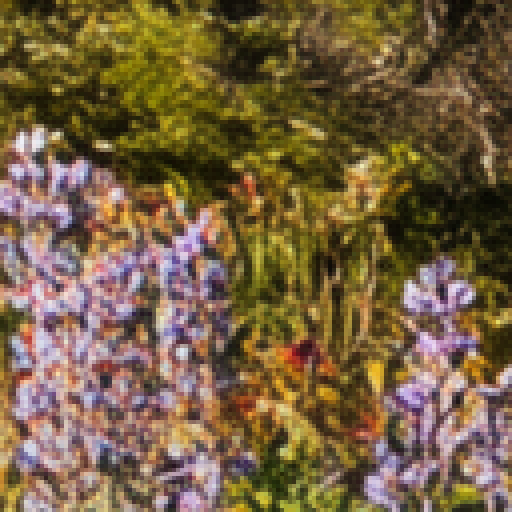 | 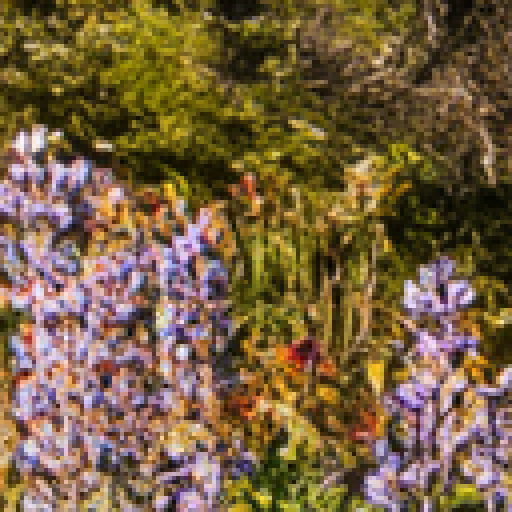 |
|---|---|
| Оригинальный VAE, увеличенный фрагмент | Texture-Fix-VAE, тот же фрагмент |
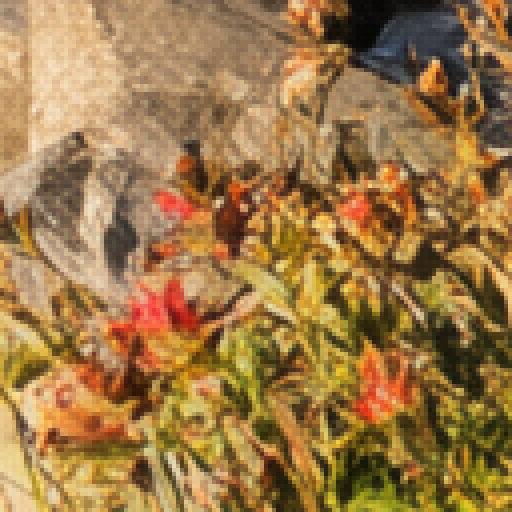 | 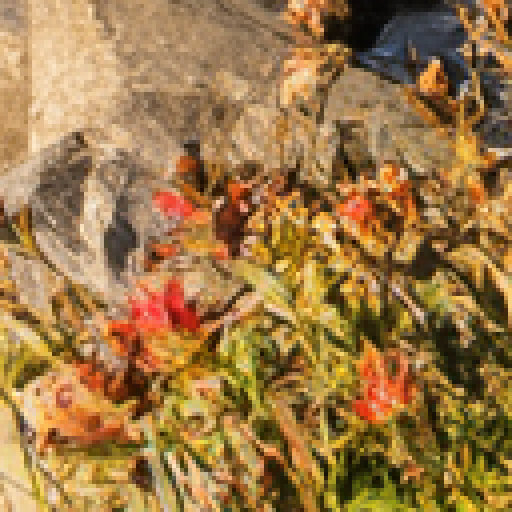 |
|---|---|
| Оригинальный VAE, второй увеличенный фрагмент | Texture-Fix-VAE, тот же фрагмент |
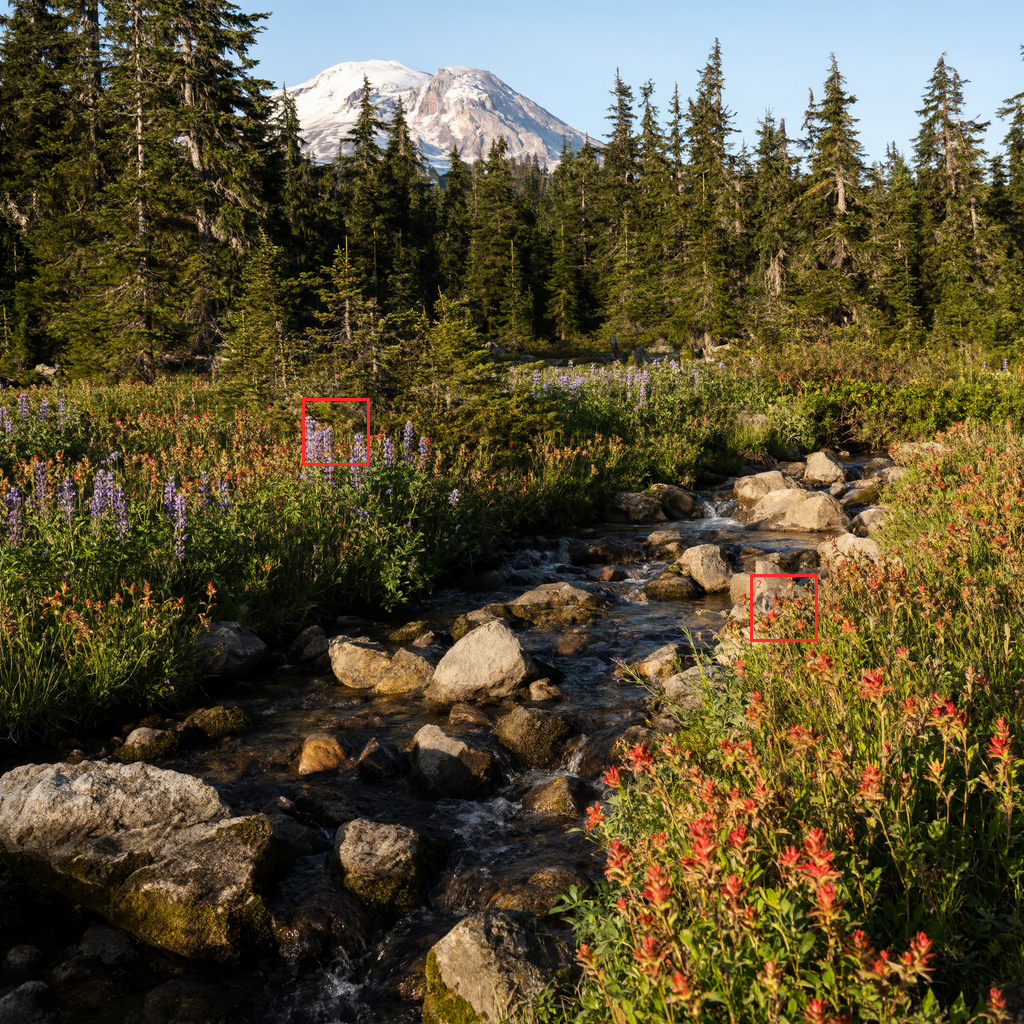 | 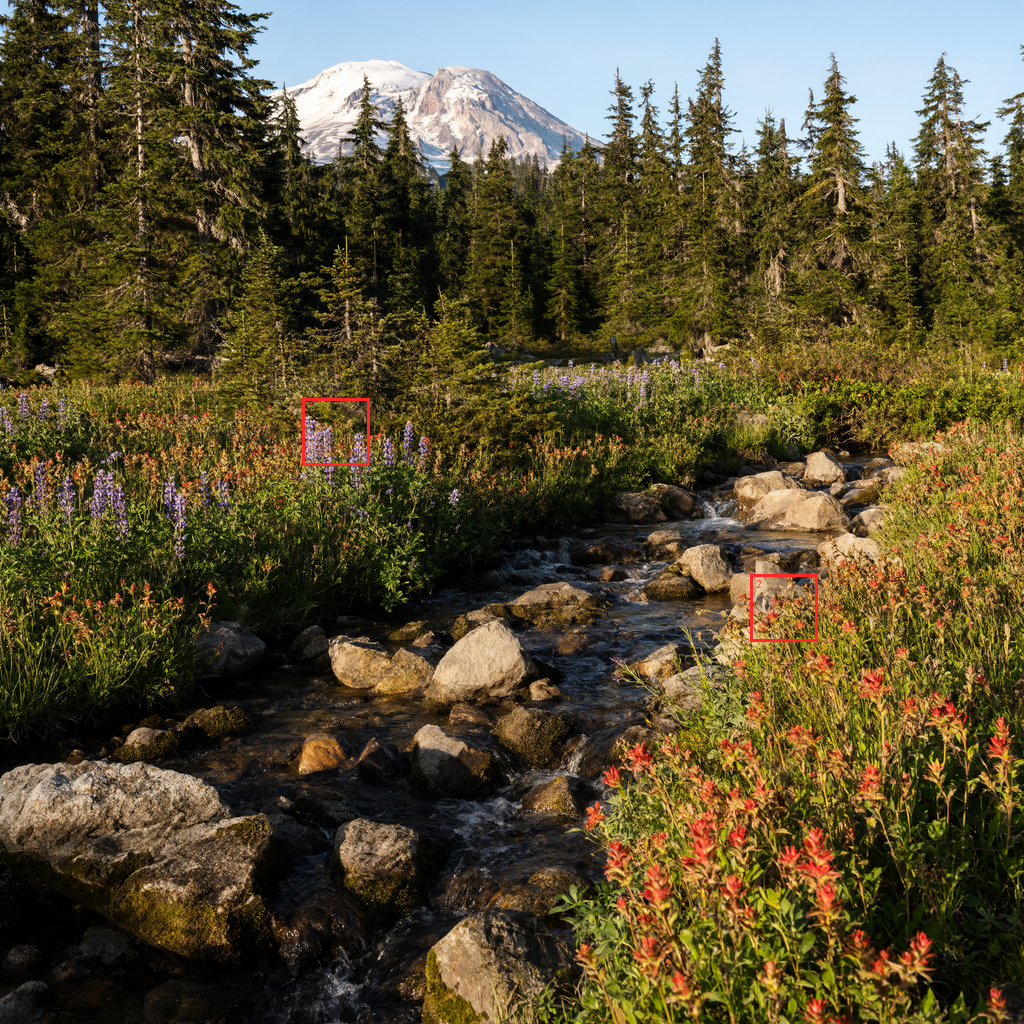 |
|---|---|
| Оригинальный VAE, полное декодирование 1024 x 1024 | Texture-Fix-VAE, полное декодирование |
Что изменилось внутри
Дообучался только декодер, примерно 5 000 шагов со скоростью обучения 3e-5. Две стадии декодера с наивысшим разрешением и выходная голова были оставлены размороженными, что составляет около 7,5 млн обучаемых параметров, а для обучения использовался рецепт, который автор разработал для TAESD.
Этот рецепт объединяет три семейства функций потерь, и каждое подталкивает реконструкцию в своём направлении:
| Функция потерь | Что она поощряет |
|---|---|
| MSE / MAE (с акцентом на PSNR) | Безопасное усреднение, которое размывает детали, которые невозможно разместить |
| LPIPS | Перцептивную правдоподобность, которая для мелкой текстуры проявляется как размытие плюс шахматный узор |
| Состязательная (GAN) | Резкие, правдоподобные детали, которые выглядят реально, а не явно синтетически |
Именно состязательный член и даёт здесь разницу. По мнению автора, оригинальный VAE Qwen-Image 2.1 обучался без работающего состязательного члена потерь, и это объясняло бы сетку: перцептивный член мог свободно смещаться в сторону шахматного узора, поскольку ничто не штрафовало явно фальшивую структуру.
Метрики
| Метрика | VAE Qwen-Image 2.1 | Texture-Fix-VAE |
|---|---|---|
| rFID, меньше лучше (COCO val2017, 5000 изображений при 256²) | 3.37 | 2.08 |
| PSNR, больше лучше (COCO val2017 при 256²) | 33.30 | 32.86 |
| LPIPS, меньше лучше (COCO val2017 при 256²) | 0.0357 | 0.0373 |
| PSNR, больше лучше (DIV2K valid, нативные кропы 1024²) | 32.86 | 32.46 |
| LPIPS, меньше лучше (DIV2K valid, нативные кропы 1024²) | 0.0460 | 0.0480 |
Это обычный компромисс для декодера в стиле GAN: перцептивное качество (rFID) улучшается примерно на треть, тогда как точность реконструкции (PSNR и LPIPS) снижается совсем незначительно. Автор отмечает, что улучшение наиболее заметно на детализированных изображениях в фотостиле, а не на плоских иллюстрациях.
Использование в ComfyUI
Скачайте texture_fix_vae_for_qwen_image_2.1_bf16.safetensors в ComfyUI/models/vae/, затем выберите его в ноде Load VAE вместо qwen_image_2.1_vae_bf16.safetensors. Никаких изменений в нодах, рабочем процессе или сэмплере не требуется, и файл можно в любой момент вернуть обратно.
Вне ComfyUI те же веса загружаются как обычный VAE diffusers:
import torch
from diffusers import QwenImage21Pipeline, AutoencoderKLQwenImage21

vae = AutoencoderKLQwenImage21.from_pretrained(
    "madebyollin/texture-fix-vae-for-qwen-image-2.1", torch_dtype=torch.bfloat16
)
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", vae=vae, torch_dtype=torch.bfloat16
).to("cuda")
Доступность
Веса: madebyollin/texture-fix-vae-for-qwen-image-2.1
Файл ComfyUI: texture_fix_vae_for_qwen_image_2.1_bf16.safetensors
Базовая модель: Qwen/Qwen-Image-2.1
Ранее у автора: TAESD, sdxl-vae-fp16-fix
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.