Qwen-Image 2.1 Fun Acc LoRA: официальная 4-шаговая дистилляция
Alibaba PAI дистиллирует Qwen-Image 2.1 до 4 шагов с помощью LoRA PDD размером 346 МБ, охватывающей text-to-image и редактирование по инструкции, с собственным расписанием сигм.
Адаптер следует тому же рецепту, который Alibaba PAI использовала для MiniMax H3 PDD Acc LoRAs в августе: взять сильную базовую модель, дистиллировать её с помощью Parallel Decoding Distillation (PDD, arXiv 2607.26004) и выпустить извлечённую LoRA вместе с кодом вывода, необходимым для воспроизведения эталонных результатов. Сама Qwen-Image 2.1 вышла 20 сентября 2026 года и уже поддерживается в ComfyUI, так что это вариант ускорения модели, которой всего несколько дней.
Что входит в репозиторий
| Адаптер | models/Qwen-Image-2.1-Fun-Acc-4Step.safetensors, 346 МБ, ранг 64 и network_alpha 64 в BF16 |
| Базовая модель | Qwen-Image 2.1 (Qwen/Qwen-Image-2.1), веса без изменений |
| Шаги | 4 NFE (pdd_num_steps: 4, pdd_block_size: 1) |
| Задачи | Text-to-image и редактирование изображений по инструкции |
| Обученные цели | img_in, modulation.1, norm_out.linear, эмбеддеры временных шагов, attn.to_q/to_k/to_v/to_out.0 и img_mlp всех 32 блоков трансформера, а также txt_in.in_layer / txt_in.out_layer |
| Дополнительно только для вывода | Внимание norm_q / norm_k и txt_in.text_norm хранятся как полные параметры, а не как LoRA-пары |
| Размер образца по умолчанию | 2048 x 2048 (pdd_sample_size) |
| Точность выборки | native_time_fp32_state |
Расписание сигм является частью релиза, а не деталью реализации: pdd_config.json фиксирует четырёхшаговое расписание как 1.0, 0.9169867, 0.7861579, 0.549491, 0.0, а экспортируемый формат: qwenimage21_extracted_prefused_v1. Именно из-за этих чисел это не обычная LoRA, которую можно просто подставить. Обычный 4-шаговый сэмплер с сигмами по умолчанию не воспроизводит дистиллированное поведение.
Как это сравнивается
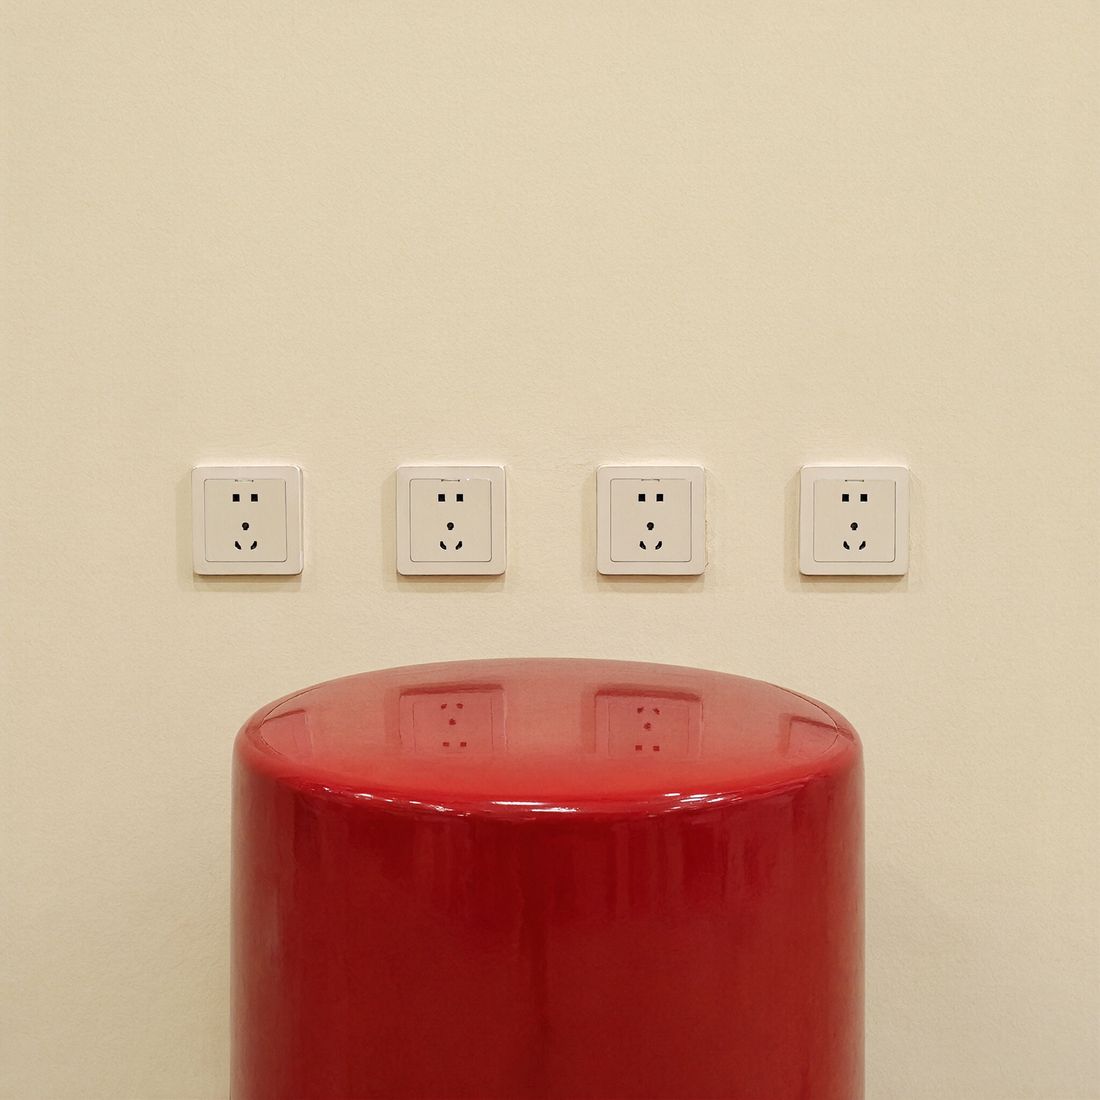
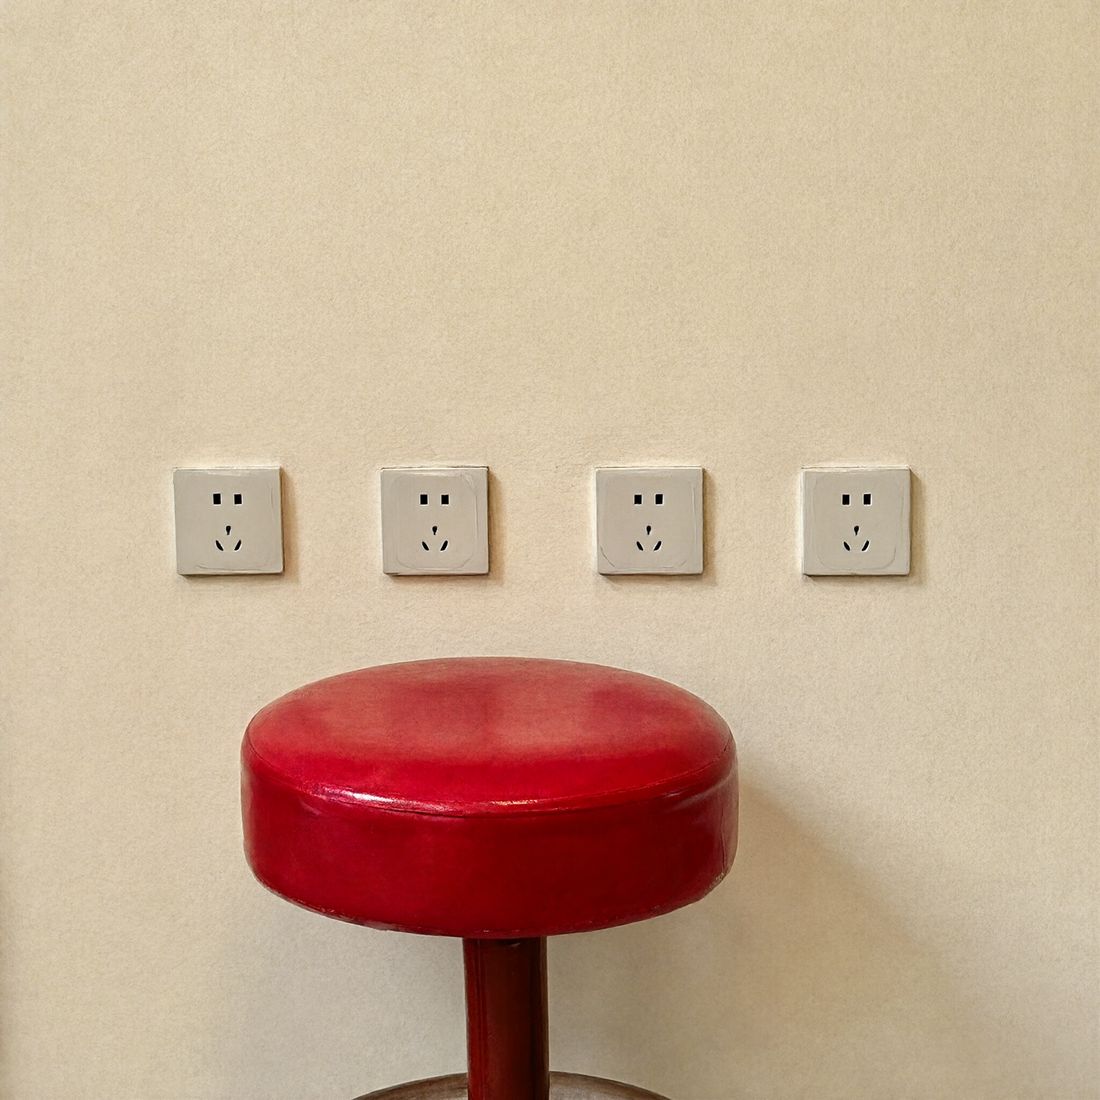
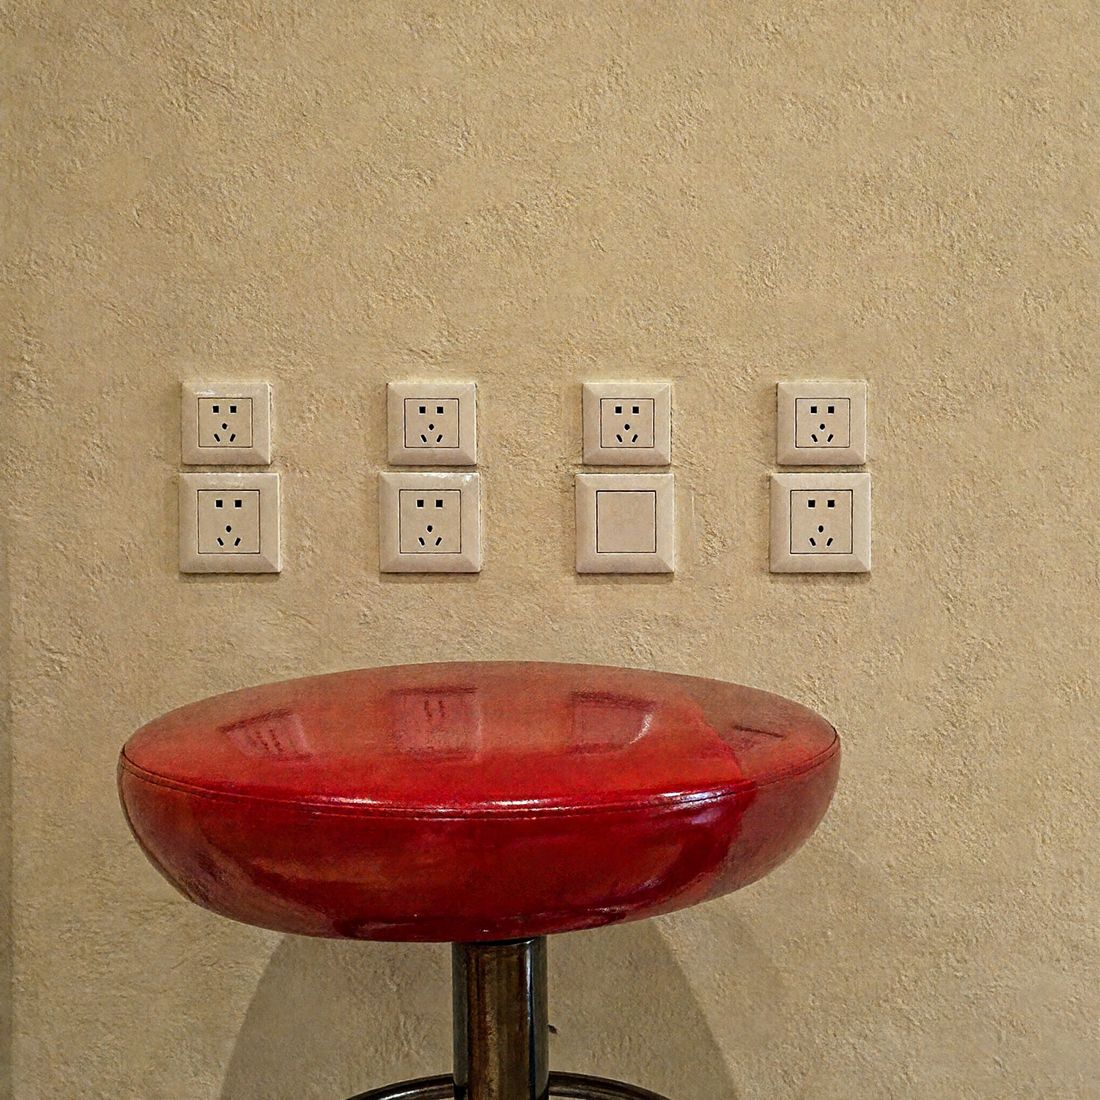
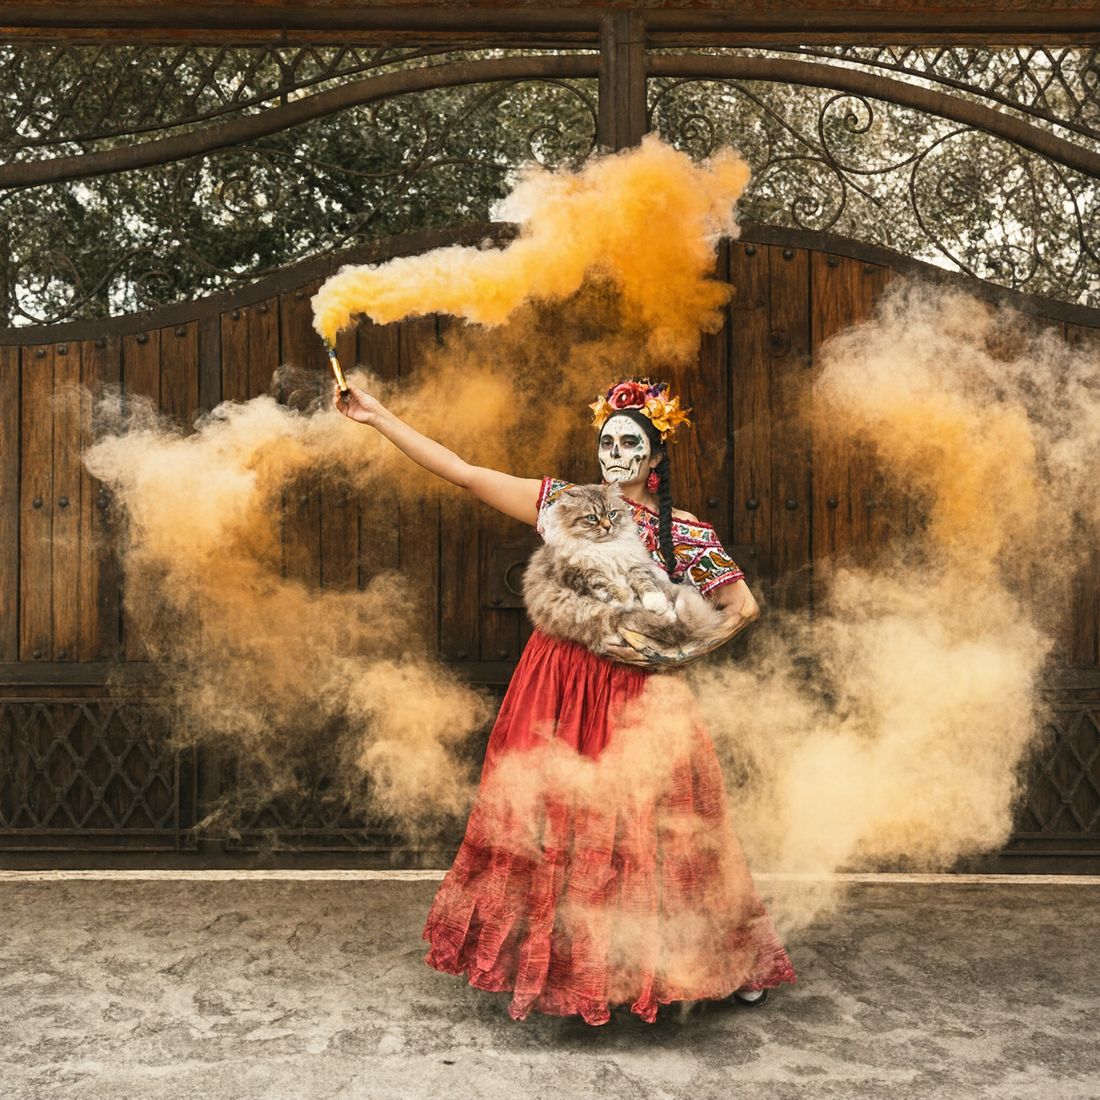
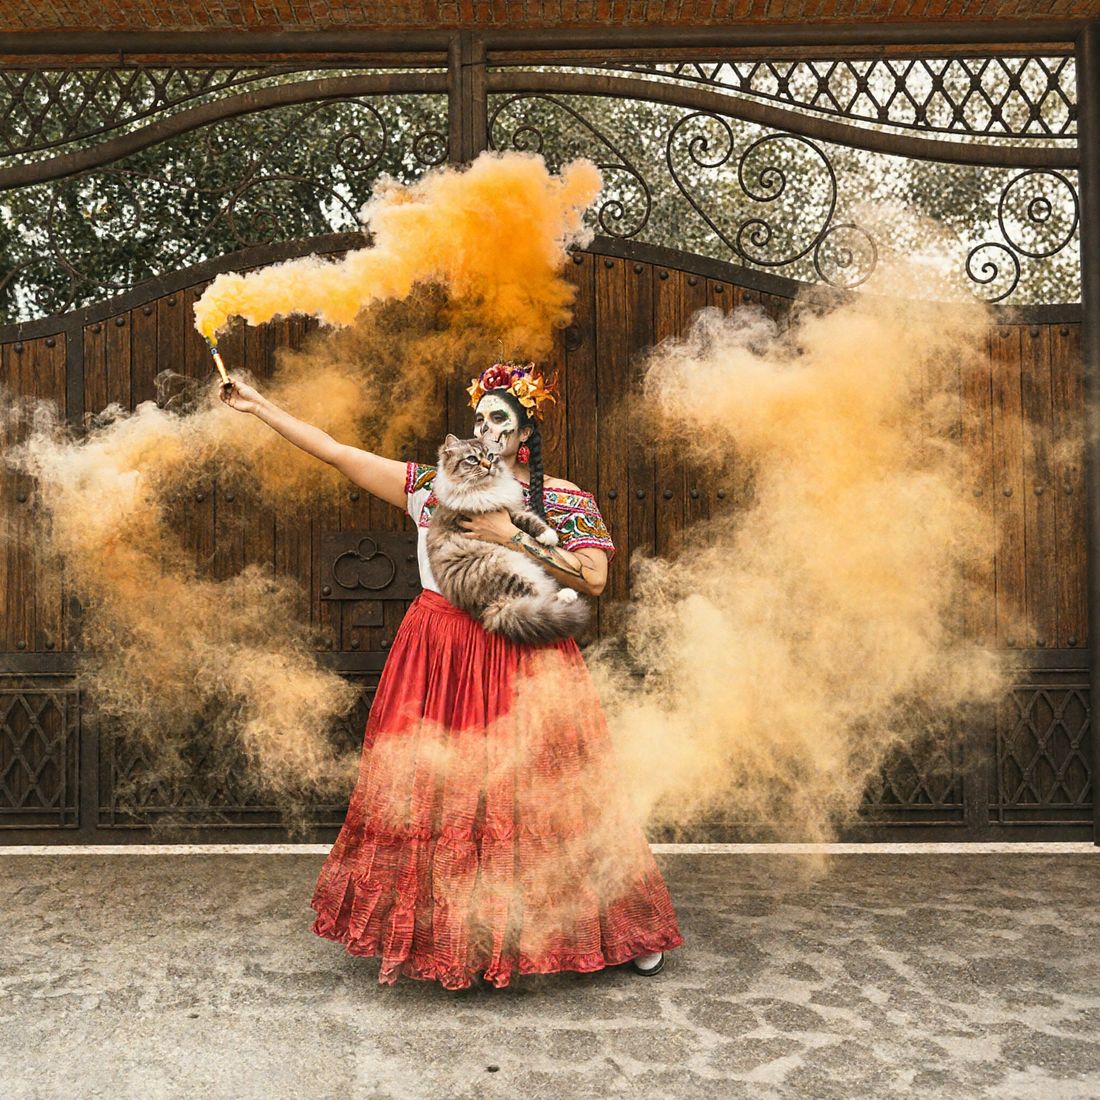
В карточке модели опубликованы трёхсторонние сравнения для каждого примера: учитель при 40 NFE, PDD LoRA при 4 NFE и Viggle v0.1 full при 4 NFE. PDD сравнивается не только со своим учителем, но и с другим 4-шаговым путём для этой модели: turbo LoRA Viggle, выпущенной ранее в сентябре.
 |  |  |
|---|---|---|
| Учитель: 40 NFE | PDD LoRA: 4 NFE | Viggle v0.1 full: 4 NFE |
Пример text-to-image, промпт взят из статьи о PDD. Во всех трёх панелях используется seed 42.
Редактирование охватывается тем же адаптером, включая правки с несколькими референсами. В примере ниже флаг на референсном изображении перерисовывается, а третий столбец показывает тот же 4-шаговый путь, обслуживаемый turbo LoRA Viggle.
 | 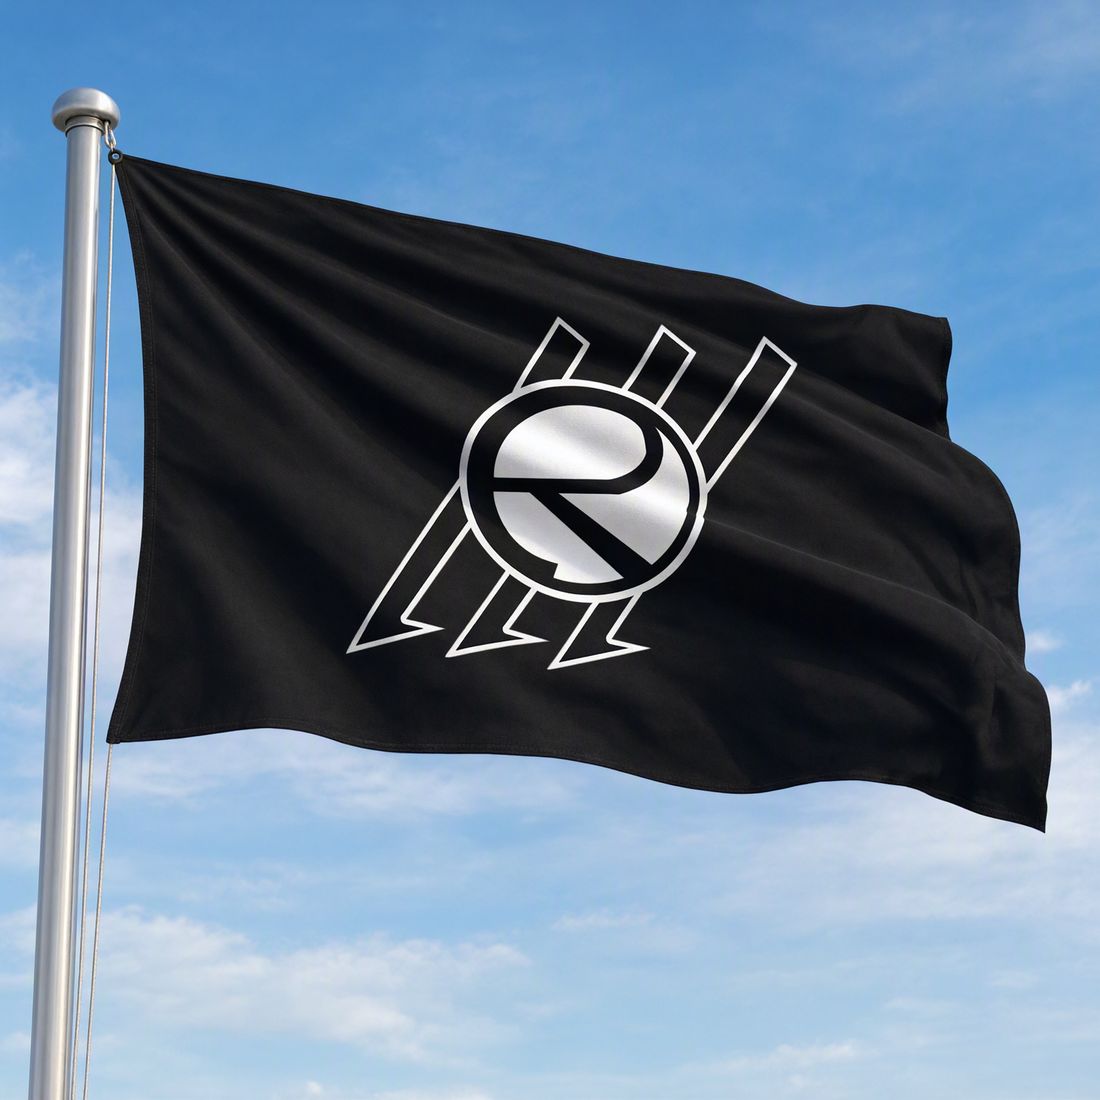 | 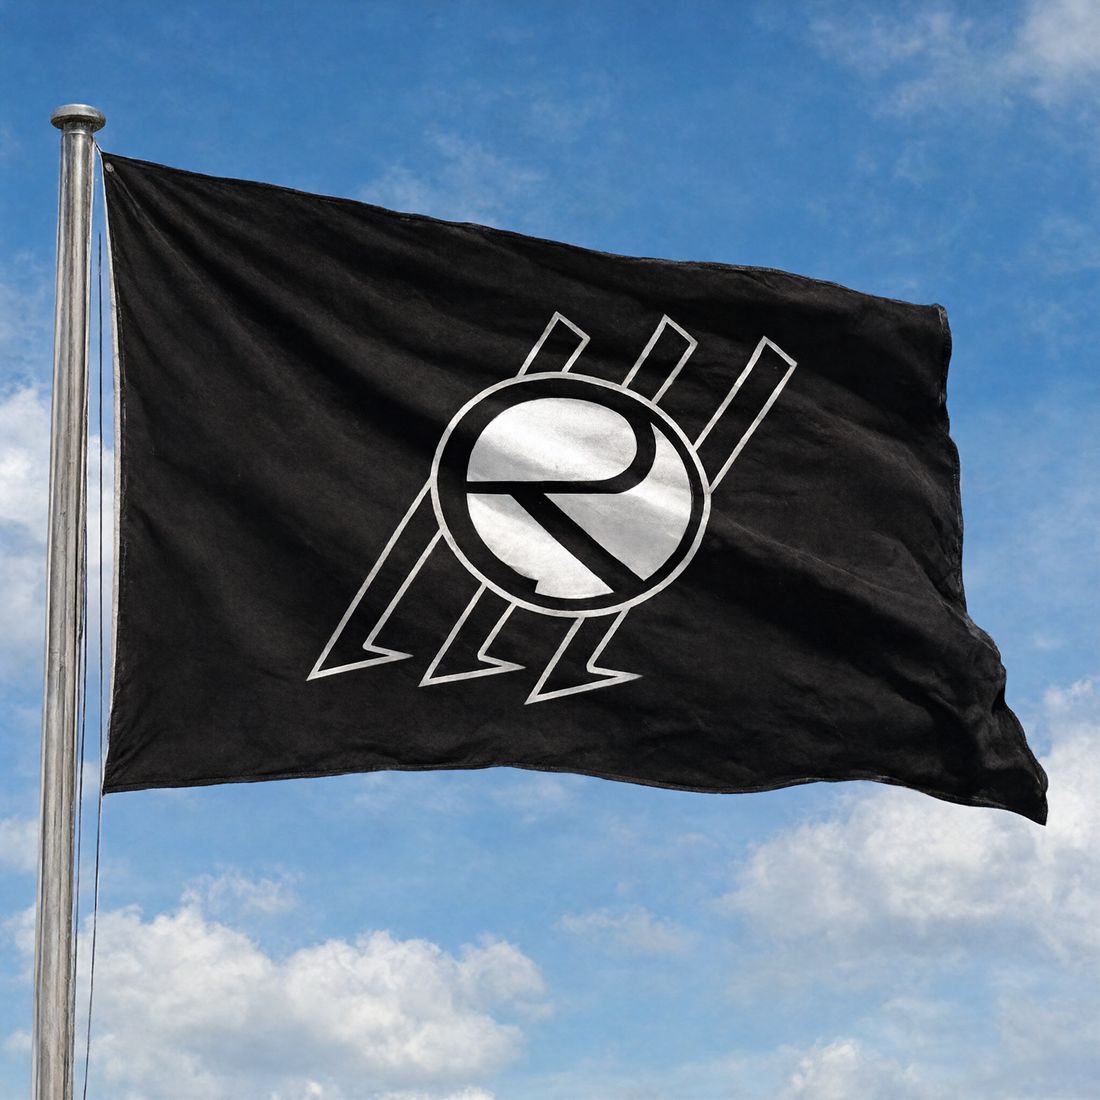 | 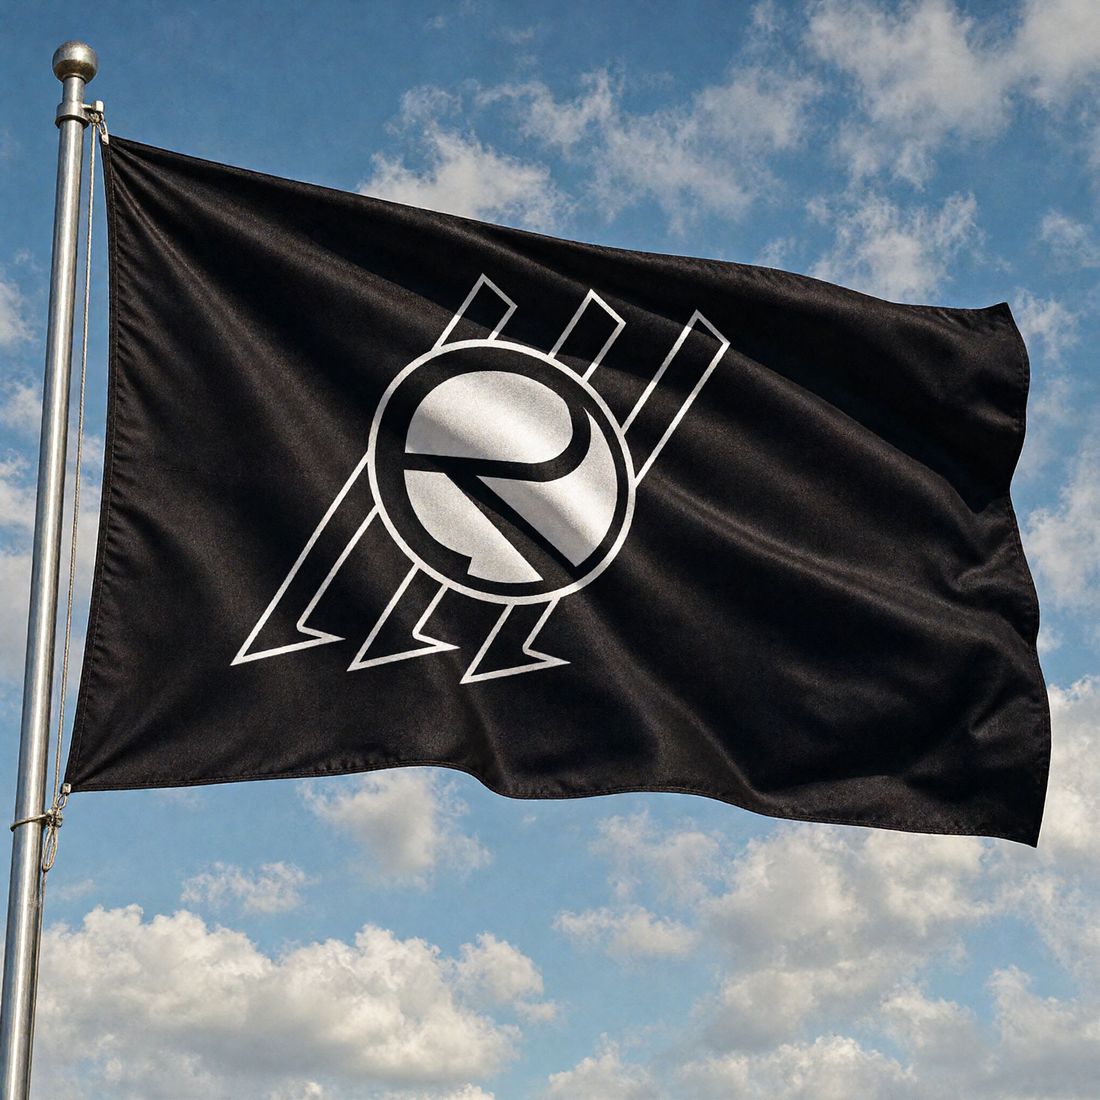 |
|---|---|---|---|
| Референсное изображение | Учитель: 40 NFE | PDD LoRA: 4 NFE | Viggle v0.1 full: 4 NFE |
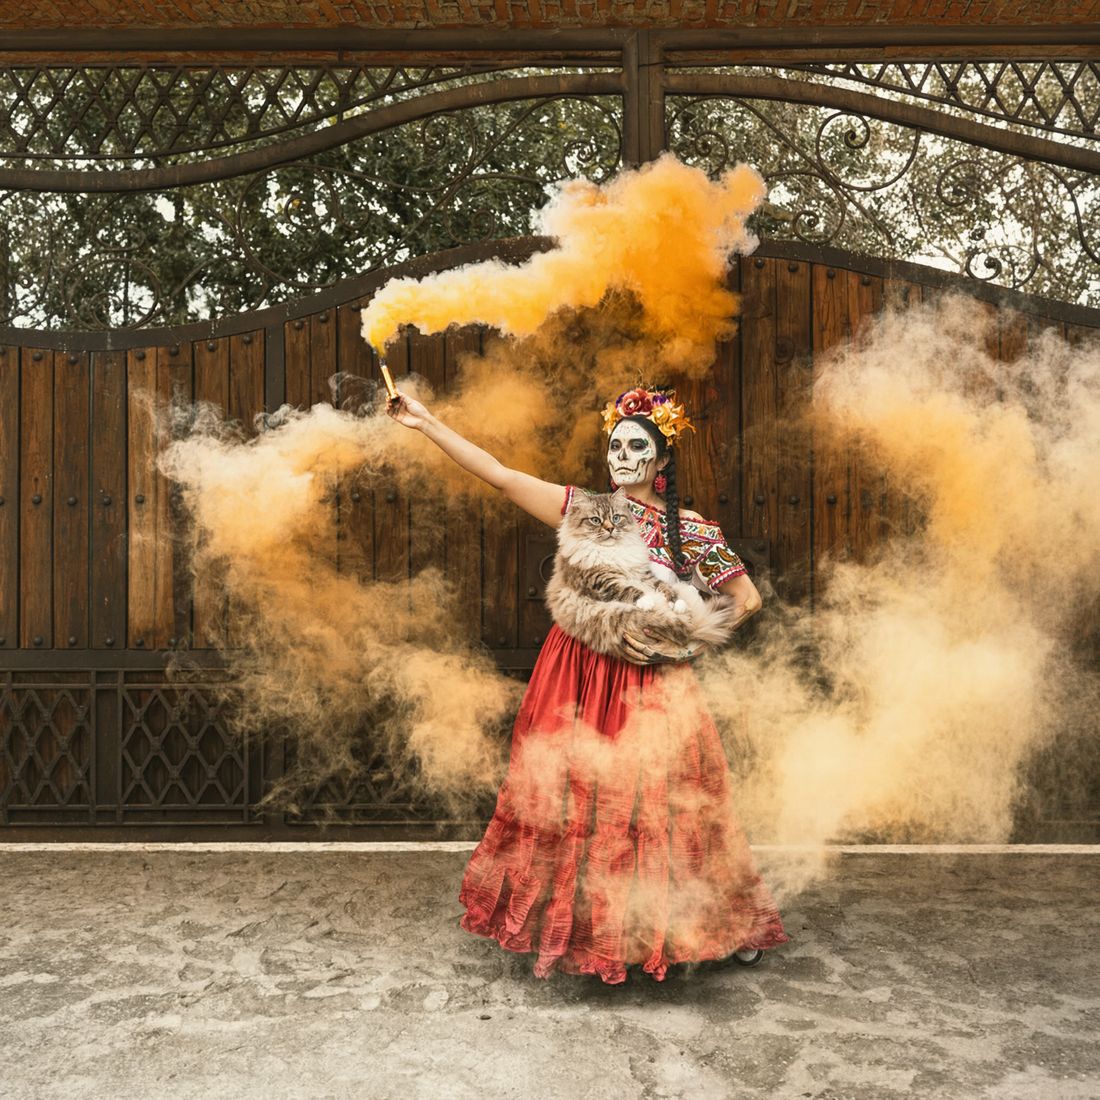 |  |  |
|---|---|---|
| Учитель: 40 NFE | PDD LoRA: 4 NFE | Viggle v0.1 full: 4 NFE |
Пример правки с двумя референсами (человек и кот), seed 43.
Задокументированные ограничения
В карточке модели перечислены два известных отставания от учителя, а не оставлены на самостоятельное обнаружение:
- Плотный мелкий текст может заметно деградировать: искажаются штрихи символов и снижается разборчивость.
- Некоторые результаты редактирования выглядят немного более размытыми и тёмными, чем у учителя, со сниженной чёткостью мелких деталей.
Доступность
Официальной поддержки ComfyUI нет, и релиз написан для официального pipeline:
- Только Diffusers: держите поставляемые
qwenimage21_pdd.pyиlora_utils_pdd.pyрядом со скриптами и запускайтеpython predict_t2i.py(генерация) илиpython predict_t2i_edit.py(редактирование). - VideoX-Fun: используйте checkout, в котором
QwenImage21Pipelineдоступен изvideox_fun.pipeline, и запускайтеpredict_t2i_videox_fun.pyилиpredict_t2i_edit_videox_fun.py.
Для ComfyUI пока есть только экспериментальный путь: Kijai опубликовал ветку Qwen-Image 2.1 PDD репозитория ComfyUI, и LoRA нуждается в конвертации, прежде чем загрузчик ComfyUI сможет её использовать. Поскольку расписание и не-LoRA параметры norm_q / norm_k / text_norm являются частью дистилляции, относитесь к конвертациям этого адаптера для ComfyUI как к работе сообщества, а не как к поддерживаемому пути.
Более ранние адаптеры ускорения той же команды для MiniMax H3 служат ближайшей точкой отсчёта для того, как работает это семейство релизов: там тоже дистиллированная LoRA поставлялась с собственным рецептом вывода, а не как обычная LoRA для базовой модели.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.