Viggle Turbo v0.2: 5-шаговая дистилляция Qwen-Image 2.1 в ComfyUI
DMD-дистилляция Qwen-Image 2.1 от Viggle в версии v0.2 сокращает генерацию до 5 шагов без CFG и поставляется как LoRA ранга 256 с конверсиями для ComfyUI от сообщества.
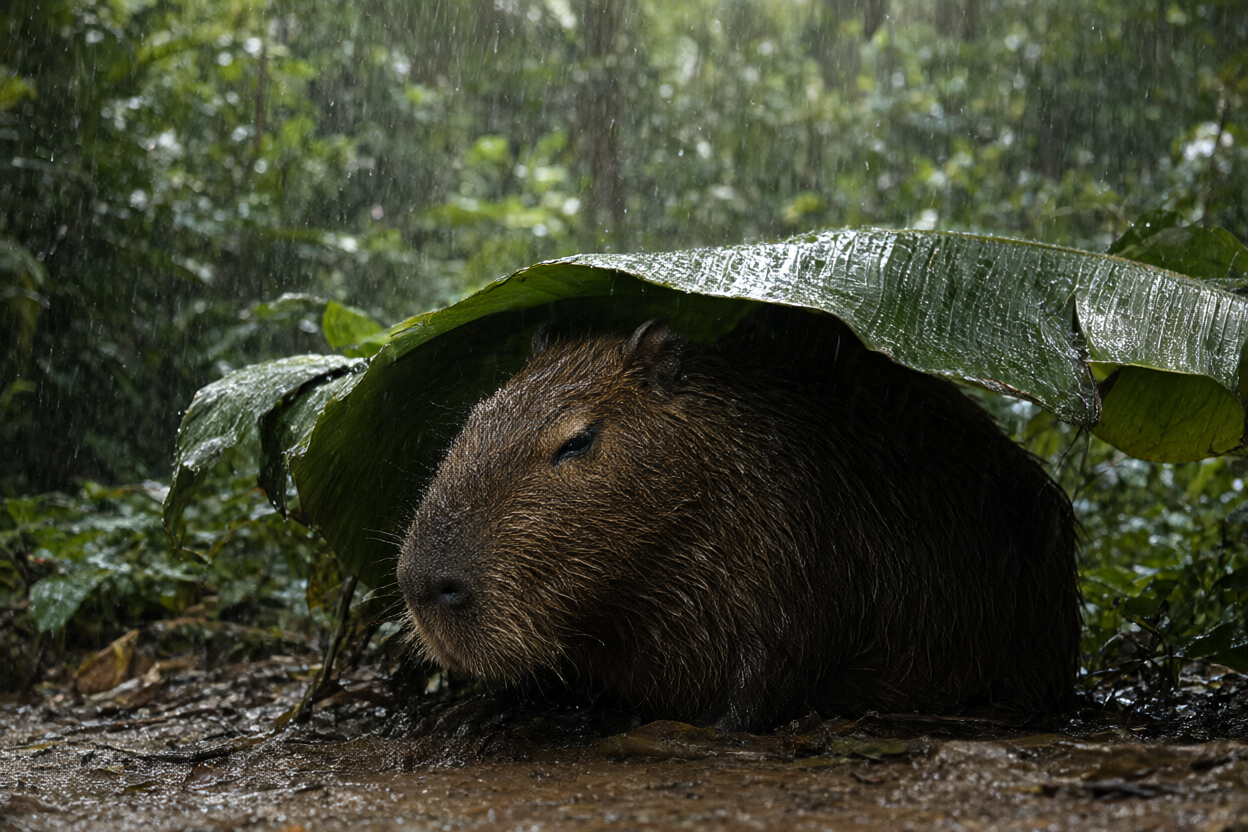
Пример генерации текста в изображение за 5 шагов из собственного демо-пространства Viggle.
Что изменилось в v0.2
Первая публичная версия, v0.1, была предварительным просмотром: она снижала разнообразие выходных данных и отклонялась от базовой модели по композиции. v0.2 представляет собой более крупного студента, и Viggle сравнила его с базовой моделью на 40 шагах вместе с её официальным улучшением промпта на отложенном наборе из 96 пользовательских запросов:
| Метрика | v0.1 LoRA r64 | v0.1 полный fine-tune | v0.2 LoRA r256, 5 шагов |
|---|---|---|---|
| Разнообразие выборки относительно базовой модели | 0.75 | 0.72 | 0.93 |
| Дрейф композиции относительно базовой модели | -0.019 | -0.033 | +0.000 |
Под разнообразием понимается среднее расстояние между патчами DINOv2 внутри одного промпта по 8 сидам, выраженное как соотношение к базовой модели, а дрейф показывает, насколько смещается центроид изображения относительно выхода базовой модели для того же промпта и сида. На практике это означает, что v0.2 сохраняет разброс базовой модели по сидам и размещает объекты там, где это сделала бы базовая модель, тогда как v0.1 сводила все сиды к похожим композициям. Артефакты v0.1 остаются в репозитории для воспроизводимости, но Viggle заявляет, что нет причин отдавать им предпочтение.
Как это работает
Дистиллированный студент сэмплируется по фиксированному расписанию, а не по количеству шагов: 5 шагов с узлами сигмы [1.0, 0.875, 0.75, 0.5, 0.25], true_cfg_scale=1.0 и без негативного промпта. Это те же узлы, что и при обучении на четырёх шагах, но сегмент с наибольшим шумом разделён на два: по наблюдениям Viggle, это устраняет большую часть потери деталей и двоения, свойственных обычному четырёхшаговому прогону. Другие количества шагов и значения CFG не помогают.
Ещё две детали важны для тех, кто будет это подключать:
- Используйте прилагаемый конфиг scheduler или задайте
shift_terminal=None. Значениеshift_terminal: 0.02из базовой модели испортит последний шаг. - Оставляйте масштаб LoRA равным 1.0, так как в прилагаемом адаптере alpha равна рангу.
Генерация текста в изображение обучалась на площадях 1024 и 2048, редактирование на площадях 1024 и 1536, и редактирование принимает до 3 референсных изображений, порядок которых определяет, на что ссылаются <image1>, <image2> и <image3> внутри промпта.
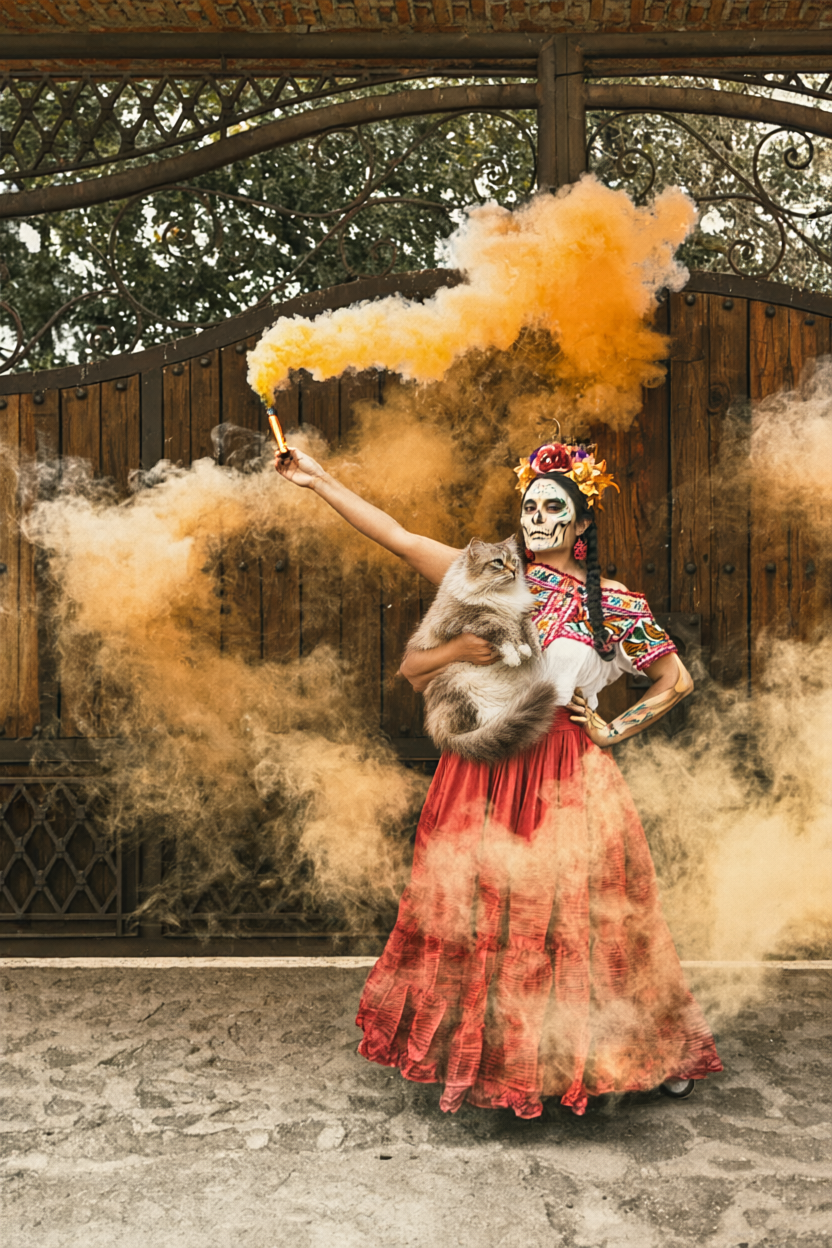
Редактирование по двум референсам при 832x1248 за 5 шагов. Промпт: «Женщина с изображения 1 держит на руках кота с изображения 2, сохраните фон изображения 1».
Доступность в ComfyUI
Официальный релиз поставляется в формате ключей diffusers плюс параллельный адаптер peft_v0.2, а не в однофайловом формате kohya, который ComfyUI загружает напрямую, поэтому официального рабочего процесса для ComfyUI пока нет. Сообщество закрыло этот пробел в течение дня после выхода v0.1:
t8star/Qwen-Image-2.1-viggle-turbo-4step-r64-comfyконвертирует адаптер v0.1 r64 в LoRA, загружаемую в ComfyUI.- Квантованные сборки 4-шаговой линейки также существуют как GGUF-репозитории (Abiray, realrebelai), ориентированные на те же конфигурации с малым объёмом VRAM, что и другие квантования Qwen-Image 2.1.
Базовые трансформер, текстовый энкодер, VAE и процессор Qwen-Image-2.1 не распространяются вместе с дистилляцией, поэтому их по-прежнему нужно брать из базовой модели, которая уже поддерживается в ComfyUI нативно.
Что он всё ещё не умеет
Viggle прямо заявляет, что v0.2 остаётся предварительной версией. Генерация текста в изображение близка к базовой модели, но сложное редактирование всё ещё отстаёт: композиция по нескольким референсам, замены лиц и правки документов, удостоверяющих личность, могут давать дублирующиеся или «призрачные» фигуры, запросы «оставь всё как есть» могут приводить к дрейфу идентичности, а мелкий или длинный отрисованный текст искажается чаще, чем при 40 шагах. Вывод в 2K не проверялся относительно учителя, а вывод RGBA, более 3 референсов и локальное редактирование по маске не тестировались.
Модель уже подхватили в сообществе ComfyUI: релиз обсуждают в канале #qwen-image Banodoco и на r/StableDiffusion.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.