Ming-Image 0.1 Design: модель 6B для UI и постеров в ComfyUI
Ming-Image 0.1 Design: открытая text-to-image модель 6B от inclusionAI для UI, инфографики и постеров с текстом, с RGBA-прозрачностью и официальной поддержкой ComfyUI.
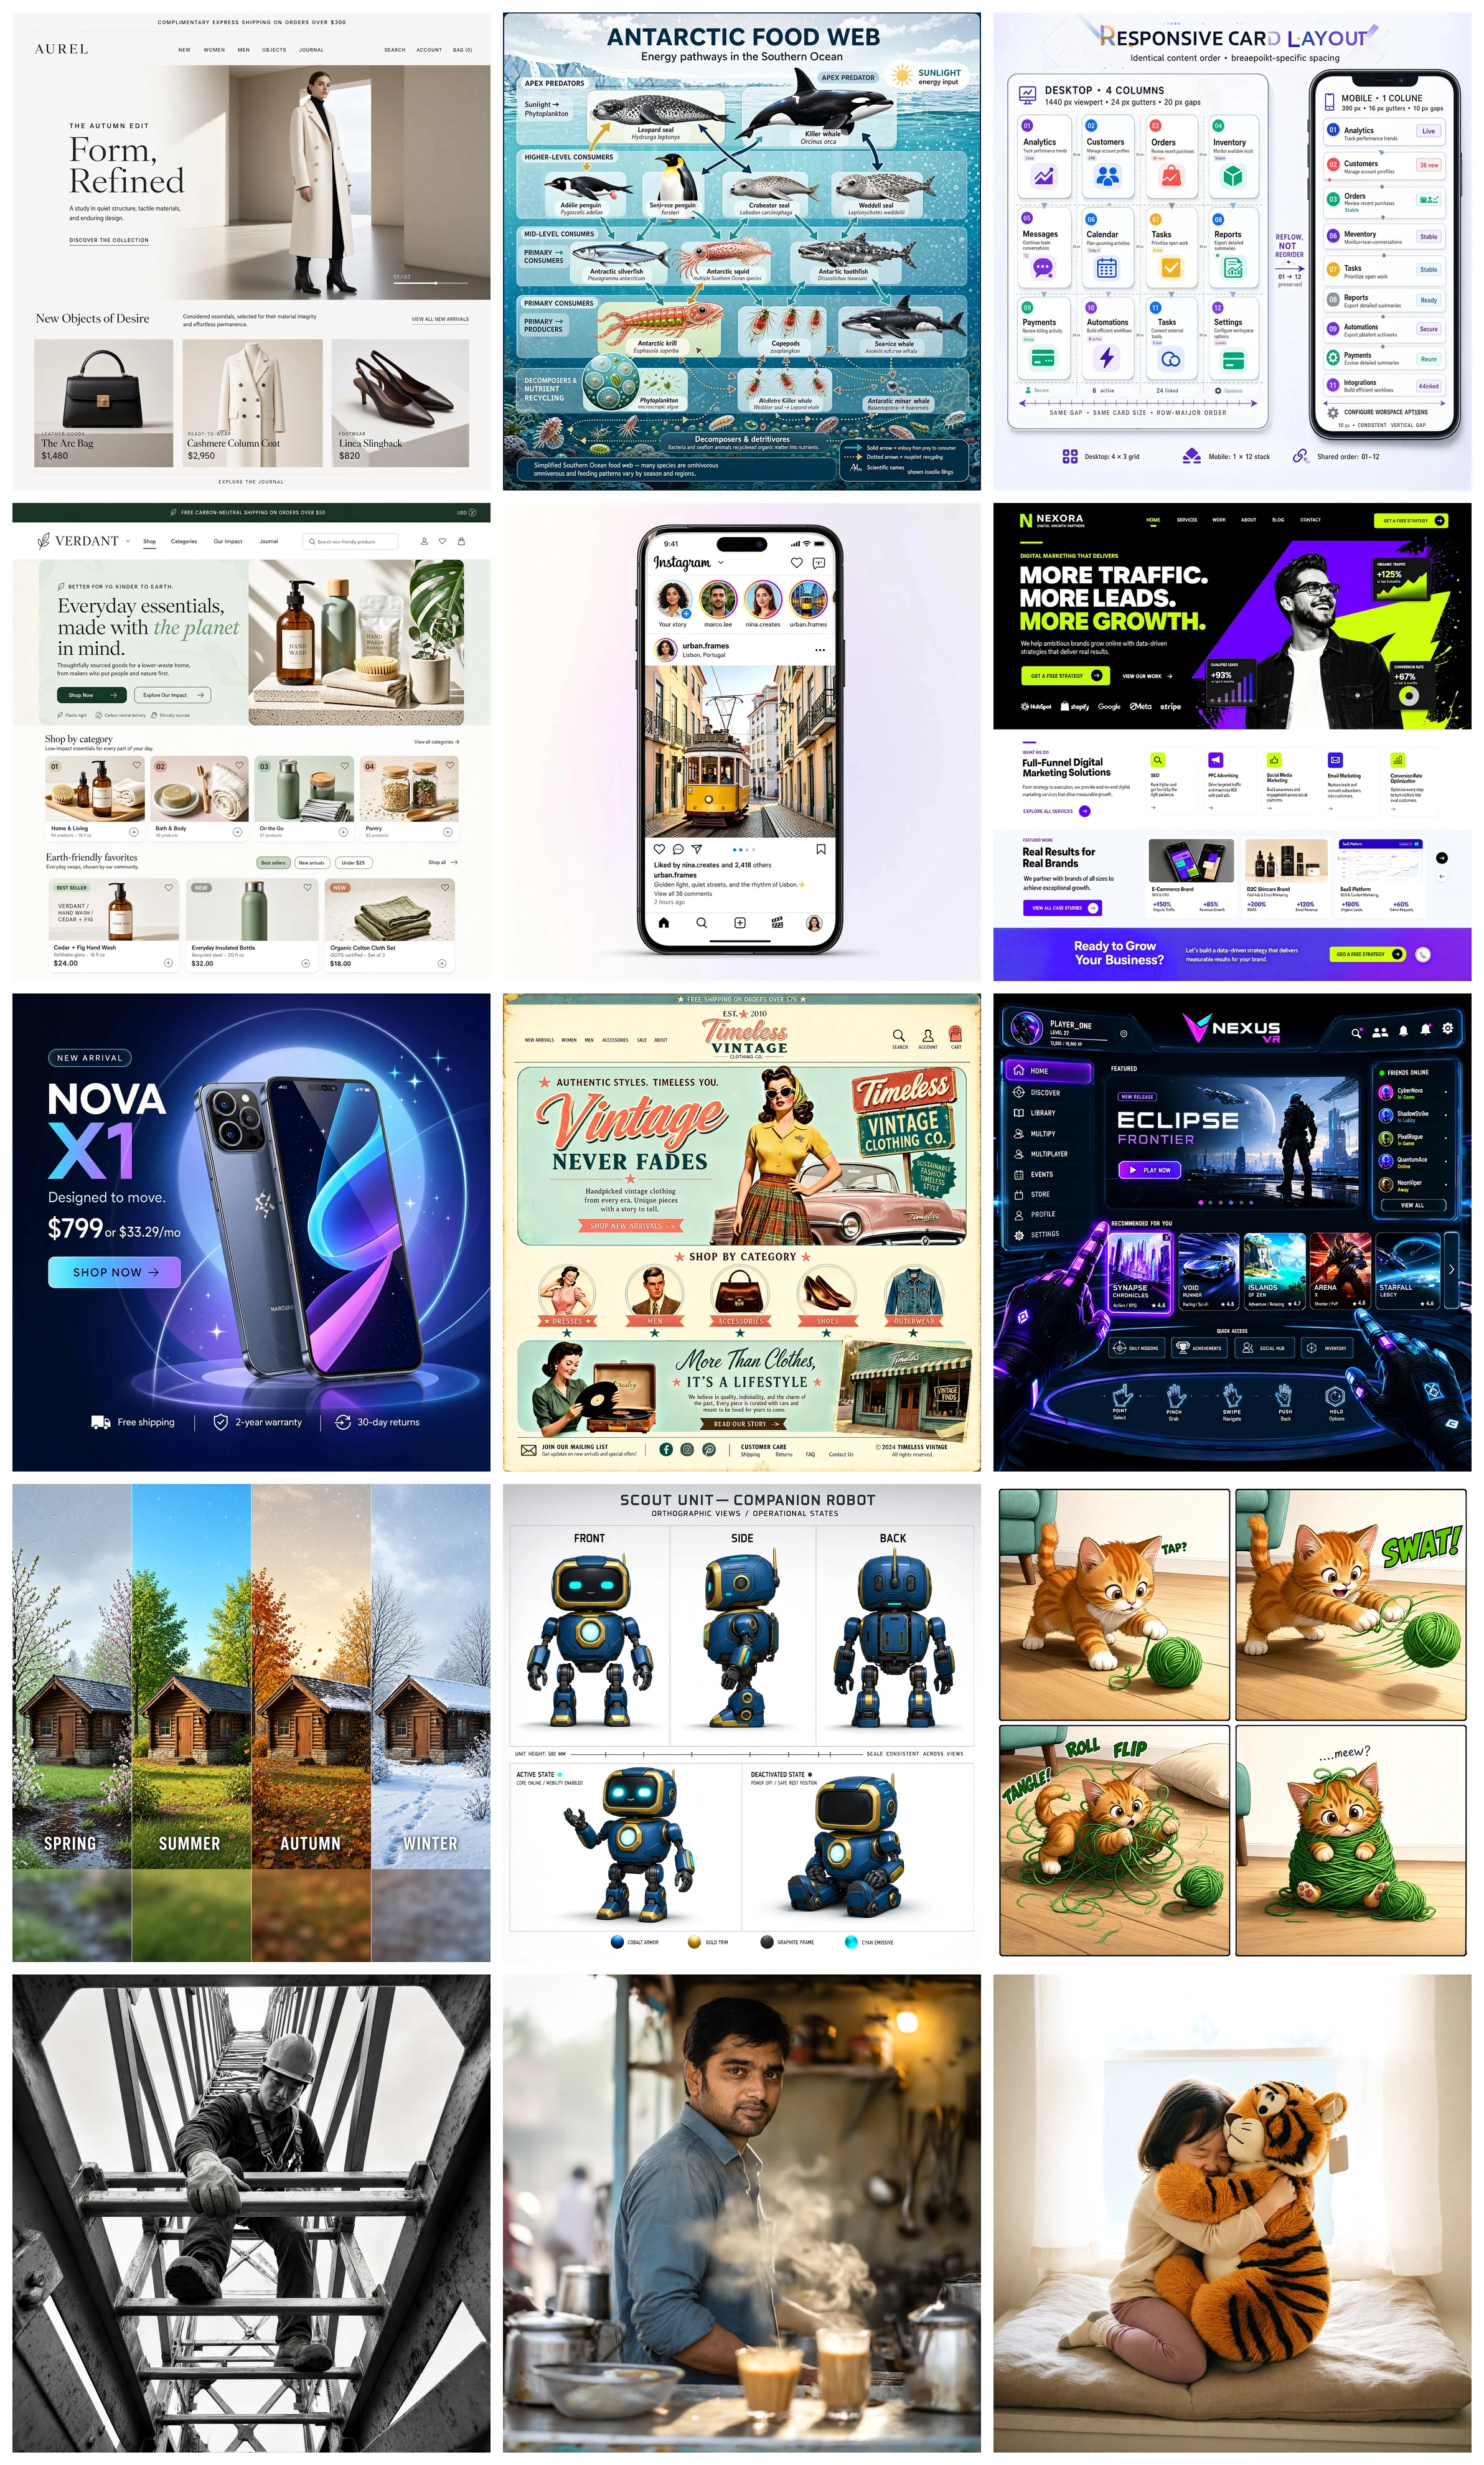
Примеры дизайнов из официальной карточки модели.
Что такое Ming-Image 0.1 Design
Ming-Image 0.1 Design создан командой inclusionAI, стоящей за семействами моделей Ling и Bailing, и нацелен на задачу, с которой общие модели изображений справляются плохо: создание чистого, читаемого дизайна, а не фотографии. Целевое содержимое: экраны, дашборды, адаптивные раскладки карточек, панели инфографики, продуктовые постеры и подборки логотипов. В официальных примерах основной упор сделан на читаемость и типографическую корректность отрисованного текста.
- 6B diffusion transformer. DiT представляет собой 30-слойную архитектуру размерностью 3840 с 16 входными каналами и патчингом 2x2, в паре с отдельным vision-language энкодером и собственным коннектором. Kijai описывает базу как производную от Z-Image с новым текстовым энкодером.
- Данные для обучения ориентированы в первую очередь на дизайн, а не на общий корпус фотографий, поэтому выходы выглядят как скомпонованные макеты с настоящими текстовыми блоками.
- Два нативных разрешения выхода: 1024 и 2048, причём 2048 РЕКОМЕНДУЕТСЯ для полноценных макетов.
- Настройки выборки по умолчанию короткие: 12 шагов при CFG 1.0, поэтому дизайн получается за небольшое число проходов.
- Улучшение промпта является частью предполагаемого процесса. Официальный pipeline рекомендует переписывать промпт с помощью
Ling-3.0-flash-VLилиqwen3.8-27BДО генерации; это особенно важно для плотных макетов с большим количеством текста, который нужно разместить.
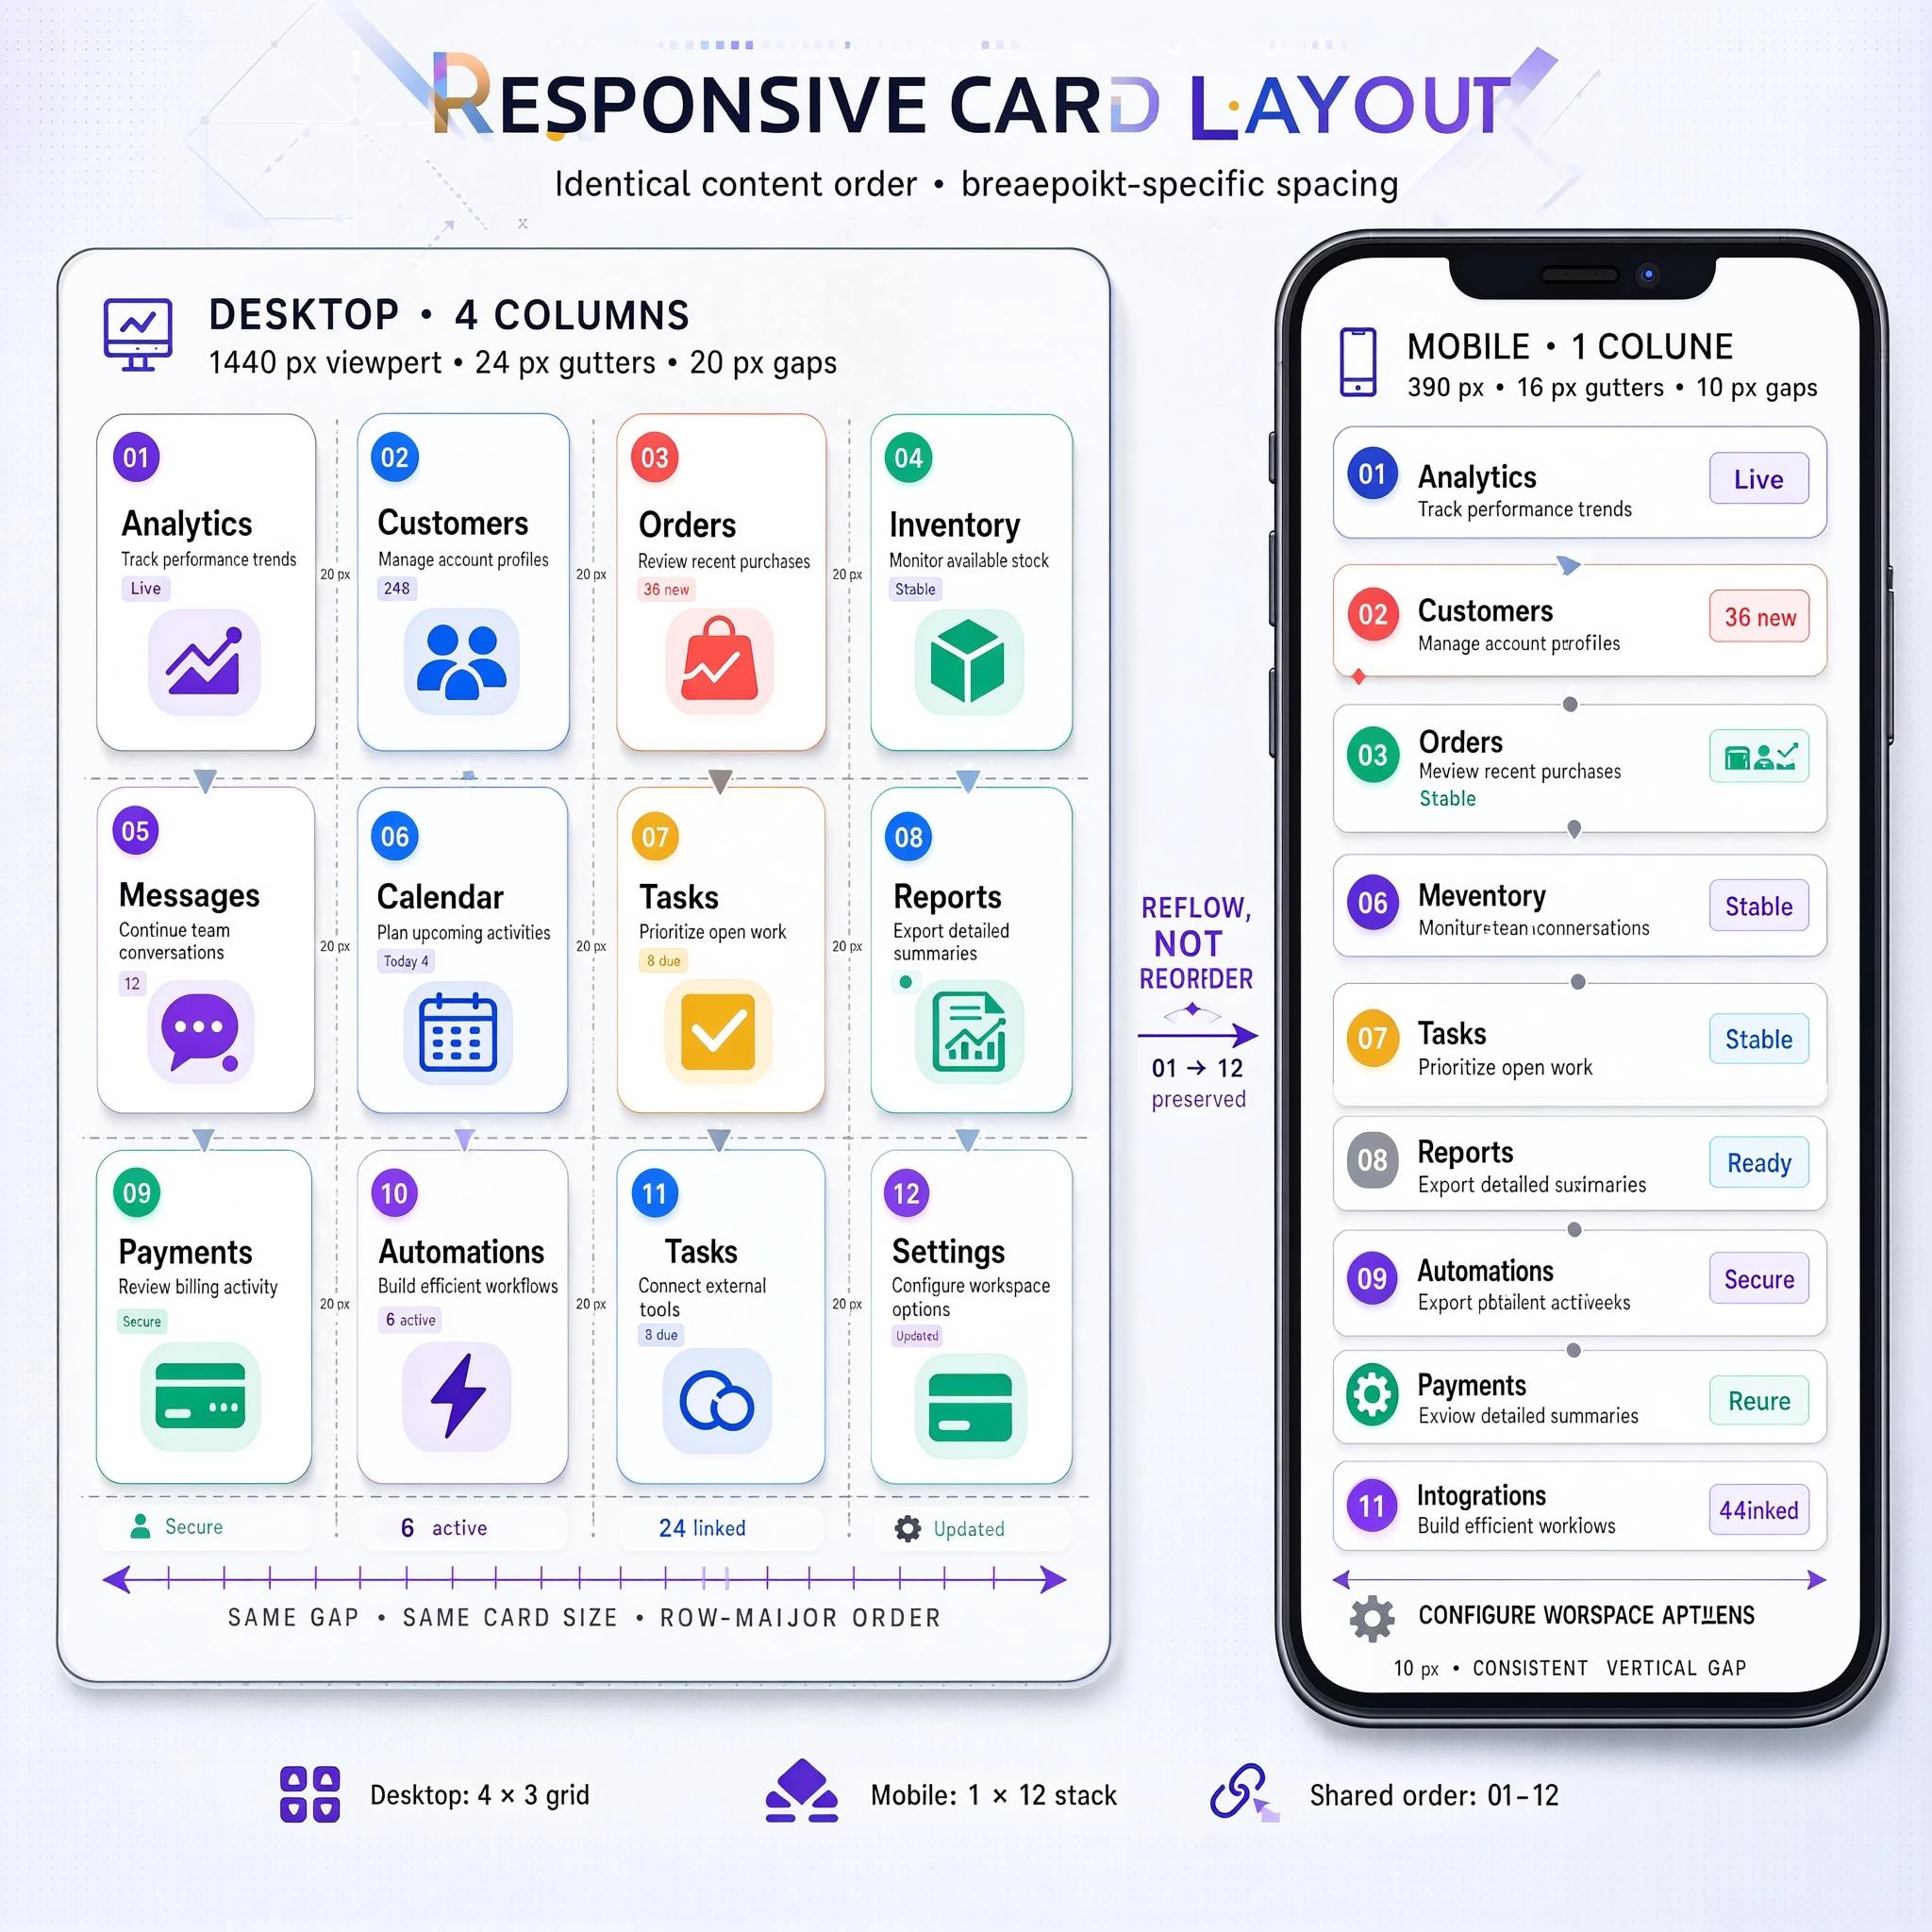
Адаптивная раскладка карточек, один из официальных примеров text-to-image.
Прозрачный фон как полноценный тип выхода
Помимо обычных изображений, Ming-Image 0.1 Design может выдавать RGBA-изображение с настоящим альфа-каналом, поэтому сгенерированный элемент постера, вырезанный продукт или UI-ассет сразу готов к композитингу и не требует отдельного прохода матирования. Карточка модели содержит набор рекомендованных триггерных фраз и требует добавить ровно одну из них в начало промпта. Тот же подход Qwen-Image 2.1 использует для режима прозрачности.
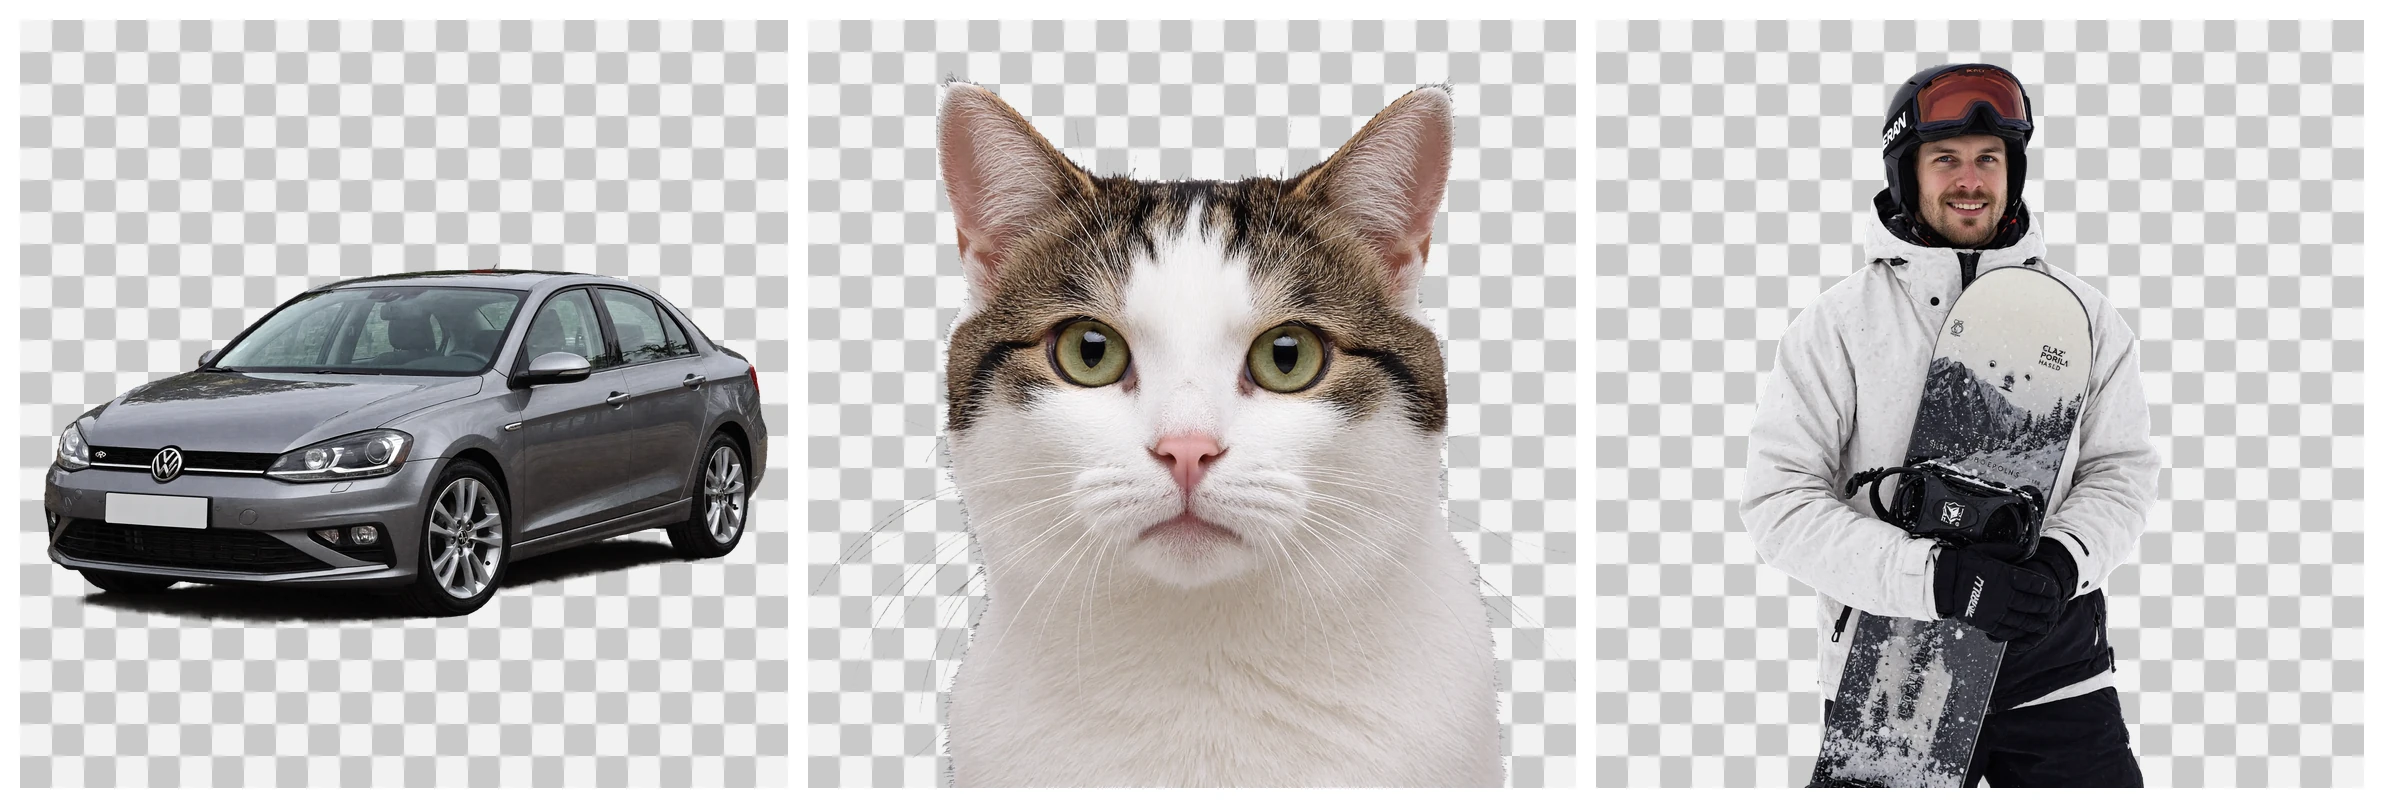
Выходы с прозрачным фоном. Шахматный узор показывает альфа-канал и не является частью сгенерированного изображения.
Родственный Layer: из дизайна в редактируемые слои
В серии есть второй checkpoint на 6B, Ming-Image 0.1 Design Layer, который решает обратную задачу: он берёт плоское изображение дизайна и разбирает его на отдельные редактируемые прозрачные слои. Именно этот шаг превращает сгенерированный макет в то, с чем можно реально работать в дизайн-инструменте, и inclusionAI дополняет его двумя опубликованными рабочими процессами агентов: навыком Ling UI Design, который использует сгенерированные референсы вместе с разбором на слои для создания и визуальной проверки UI-кода, и навыком image-to-editable-PPT, который воссоздаёт сгенерированную страницу как нативные элементы PowerPoint.
Checkpoint Layer использует другие настройки выборки по умолчанию, чем модель дизайна: 12 шагов при CFG 2.0, с рабочими разрешениями 512 и 1024.
Место в рейтинге UI/UX
Вместе с релизом inclusionAI опубликовала модель в рейтинге Artificial Analysis UI/UX Design, что является самым ясным сигналом о том, с кем конкурирует модель.
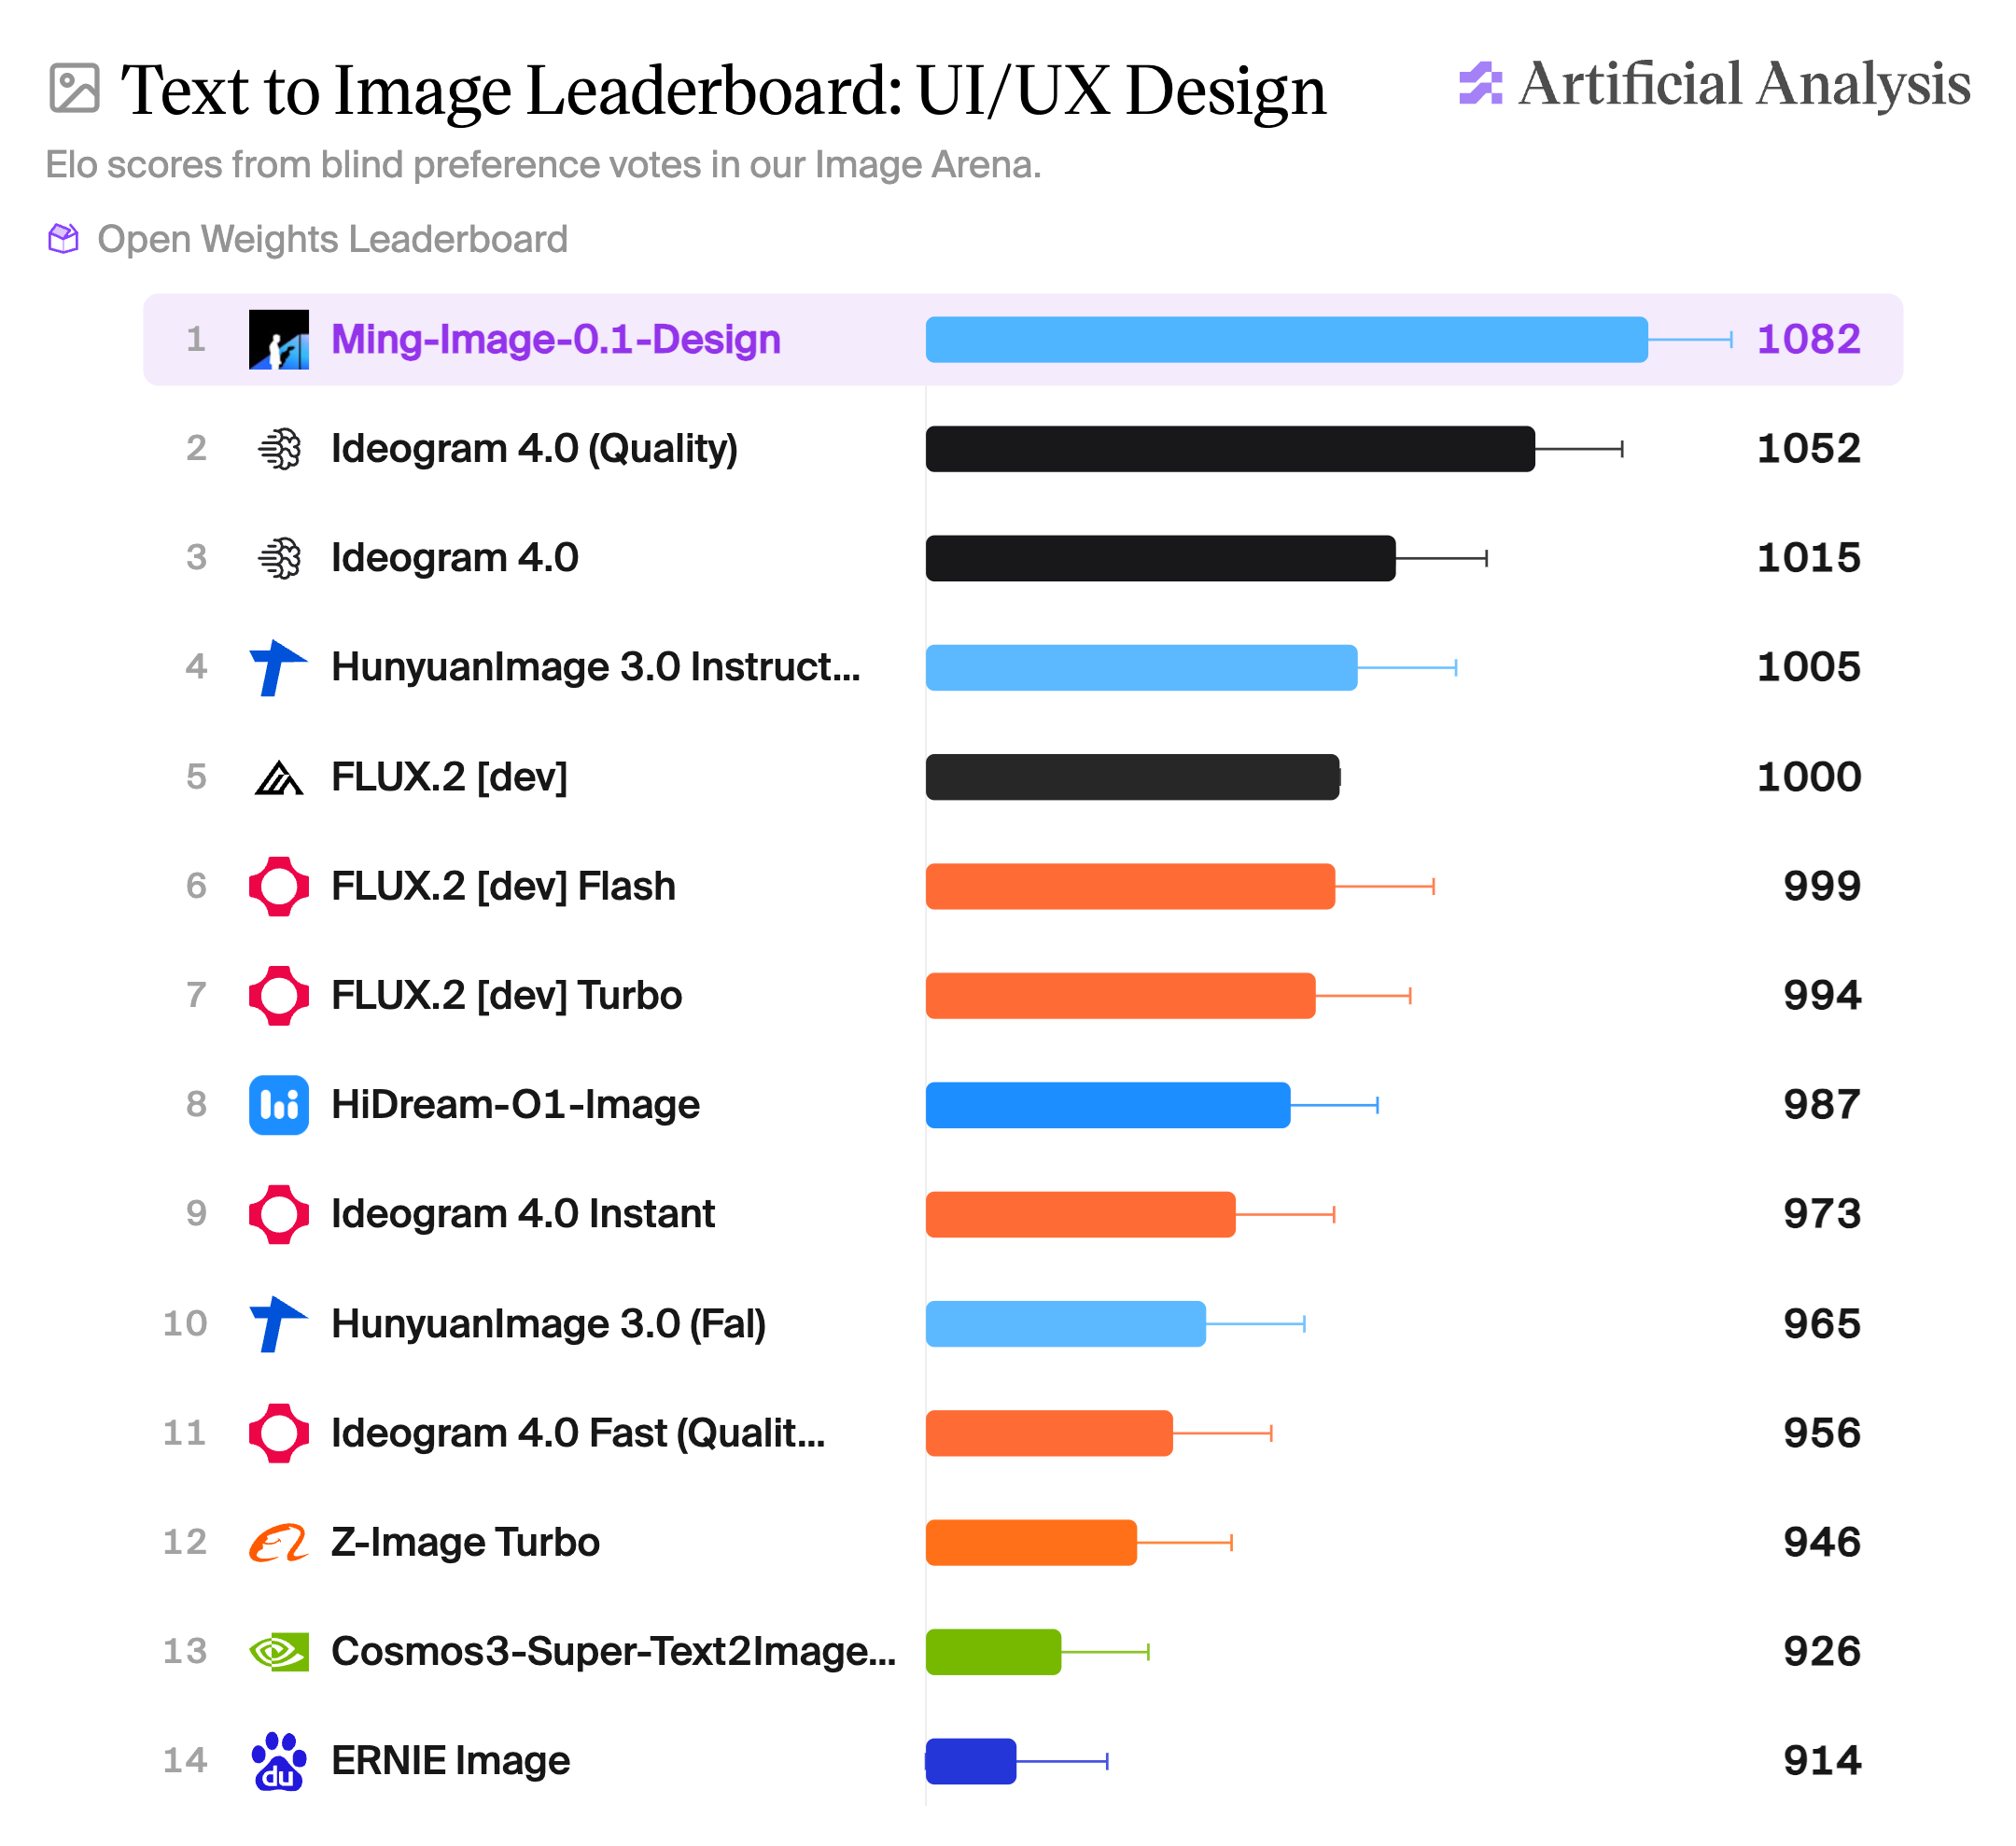
Позиция Ming-Image 0.1 Design в рейтинге UI/UX Design, из официального репозитория.
Доступность в ComfyUI
Поддержка Ming-Image в ядре ComfyUI была объединена 24 сентября 2026 года в PR ComfyUI #16482, поэтому оба checkpoint теперь загружаются в неизменённой установке:
- Перепакованные веса опубликованы в
Comfy-Org/Ming-Image: сборки BF16 иint8_convrotдля transformer версий Design и Layer, текстовый энкодер Ling-Mini-2.0 (а также сборкаw4a8и варианты для Layer) и VAE, разложенные по обычным папкамdiffusion_models/text_encoders/vae. Более ранняя перепаковка KijaiKijai/Ming-Image-ComfyUIпокрывает то же самое. - Реализация в ядре добавляет ноду
Text Encode Ming Image Edit(TextEncodeMingImageEdit), которая принимает clip, до 8 референсных изображений и необязательный VAE. Без VAE референсы попадают в текстовый энкодер только через его визуальную башню; с ним они кодируются и добавляются к latent-последовательности как чистые референсные кадры. ComfyUI различает Design и Layer по метаданным перепаковки, поэтому Layer загружается тем же путём. - Официального шаблона рабочего процесса пока нет, поэтому граф по-прежнему приходится собирать вручную вокруг загрузчиков checkpoint.
Раннее тестирование в канале Banodoco #ming-image показывает, что семплеры здесь важны больше обычного: Kijai отмечает, что выход LCM чистый, но слишком сглаженный, и что случайные сбои текста всё ещё часто встречаются при INT8, тогда как RuneX сообщает, что модель откликается на промпты в стиле bounding-box и благодаря малому размеру редактирует быстро.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.