Qwen-Image 2.1: 7B генерация и редактирование в ComfyUI
Qwen-Image 2.1 это открытая 7B модель изображений от Alibaba с нативной RGBA-прозрачностью, редактированием по 10 референсам и поддержкой ComfyUI с первого дня.
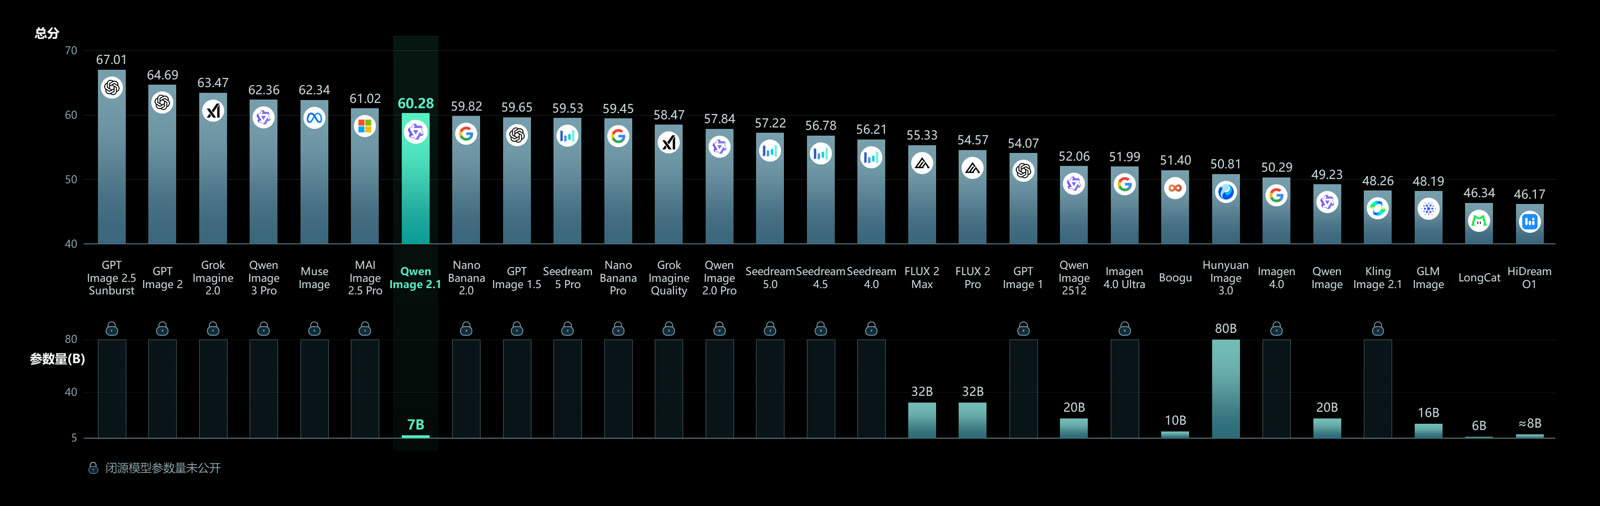
Примеры из официальной карточки модели Qwen-Image 2.1.
Что нового в Qwen-Image 2.1
Предыдущая генерация Qwen-Image использовала 20B основу MMDiT с текстовым энкодером Qwen2.5-VL-7B. Qwen-Image 2.1 заменяет визуальную генерацию на 7B компонент из 32 слоёв однонаправленного DiT, и вот четыре главных изменения:
- Компактность и эффективность. Внимание со смешанной гранулярностью и переиспользование префиксного KV-кэша сохраняют высокое качество при значительно меньших вычислительных затратах, чем у линейки 20B.
- Нативная прозрачность, единая генерация и редактирование. Одна модель создаёт обычные или прозрачные (RGBA) изображения по тексту, редактирует прозрачные слои и извлекает объекты из фотографий.
- Универсальное редактирование. До 10 референсных изображений на запрос, локальные правки, задаваемые кругами, нарисованными пометками или отдельной маской, и сохранение внешности людей и товаров.
- Реалистичные текстуры и утончённая эстетика. Улучшенная типографика, портретное освещение и мелкие детали.
Нативные размеры вывода шире, чем квадрат класса 1024, который использовали прежние рабочие процессы: 2048x2048 при 1:1, 2400x1792 при 4:3, 2528x1696 при 3:2 и 2752x1536 при 16:9, а также соответствующие портретные пропорции.
Прозрачные изображения с настоящим альфа-каналом
Главная особенность: альфа-канал сохраняется в самом файле. Вместо генерации на однотонном фоне с последующим вырезанием объекта отдельной моделью матирования Qwen-Image 2.1 записывает прозрачность сама, поэтому стикер, рендер товара или UI-ассет получаются готовыми к композитингу. Карточка модели рекомендует явный формат промпта, чтобы это включить:
This is an RGBA image with transparency. <your subject description>.
The image has alpha channel and the background is transparent.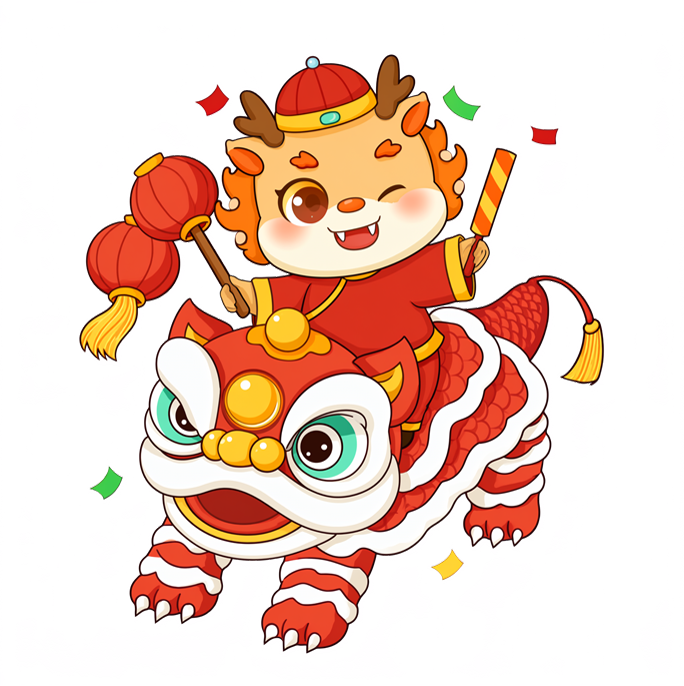
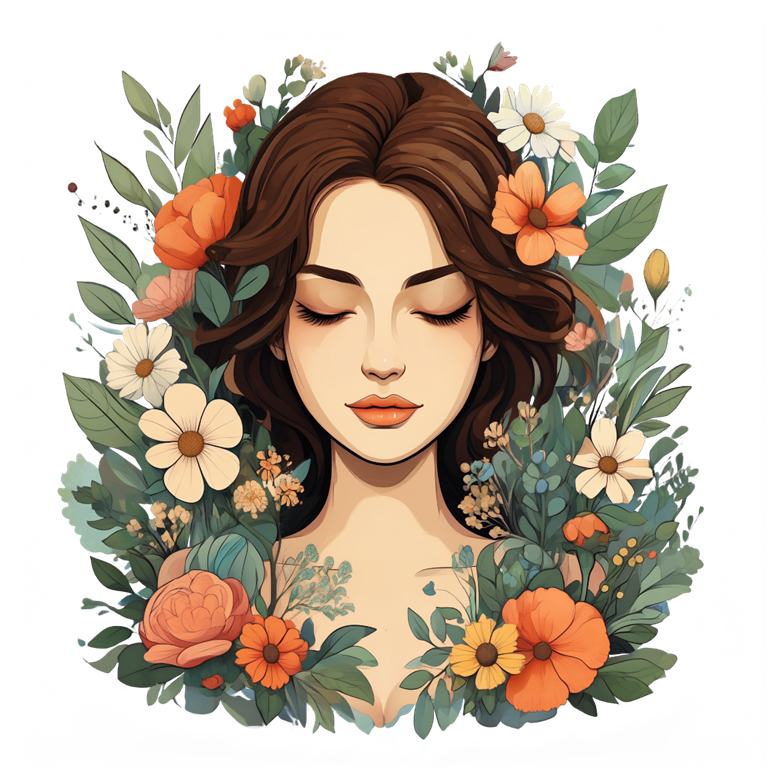
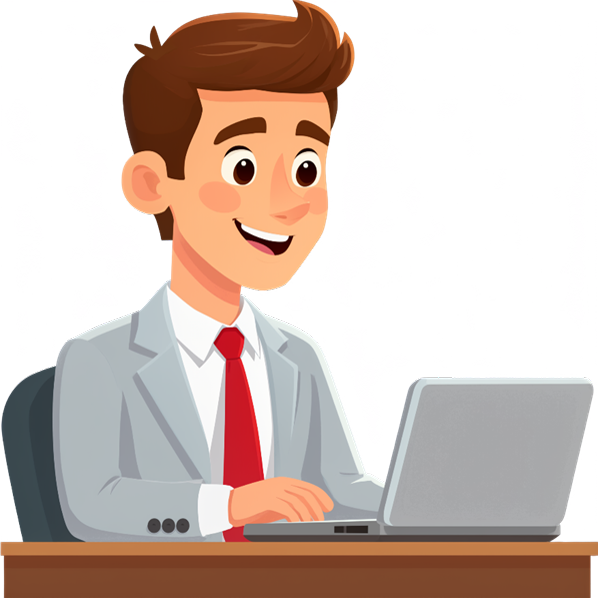
Нативная генерация прозрачных изображений прямо из официальной витрины. Файлы содержат альфа-канал, а не нарисованную шахматку.
Редактирование по десяти референсным изображениям
Именно в редактировании имеет значение количество референсов. Qwen-Image 2.1 принимает до десяти изображений за один проход, что позволяет создавать групповые композиции, сцены с несколькими товарами и листы персонажей без склейки отдельных генераций. Локальные правки можно задавать кругом, нарисованной пометкой или узлом маски.
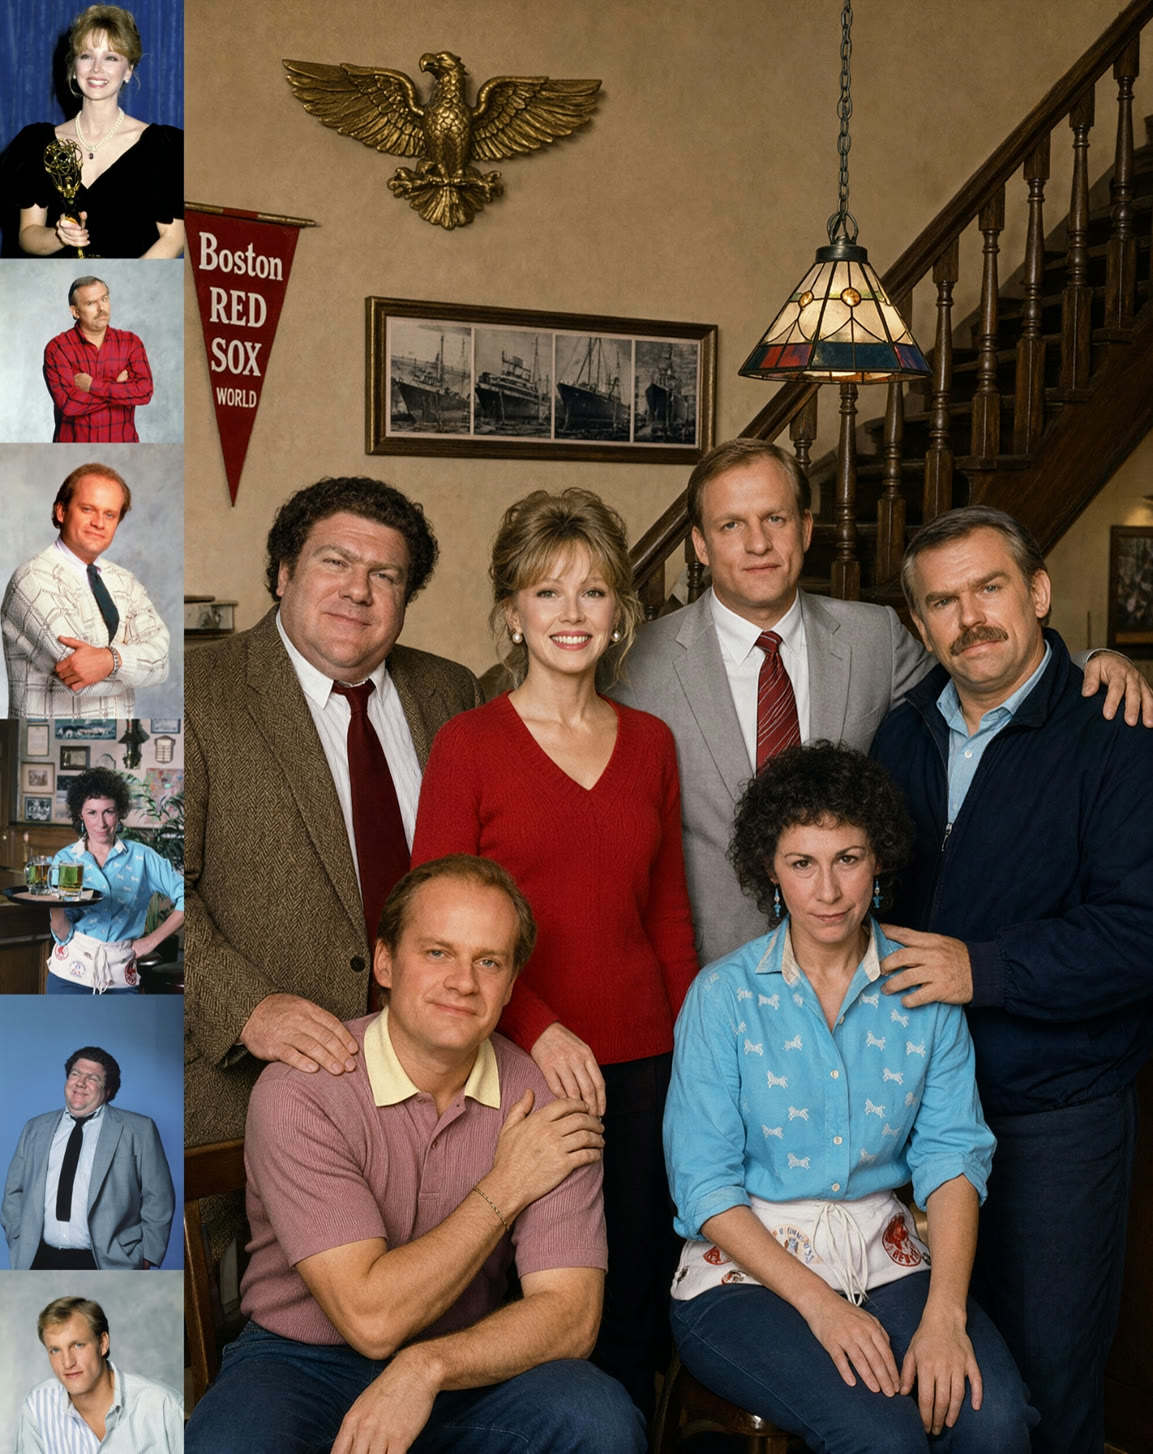
Один групповой снимок, сгенерированный по шести портретным референсам.
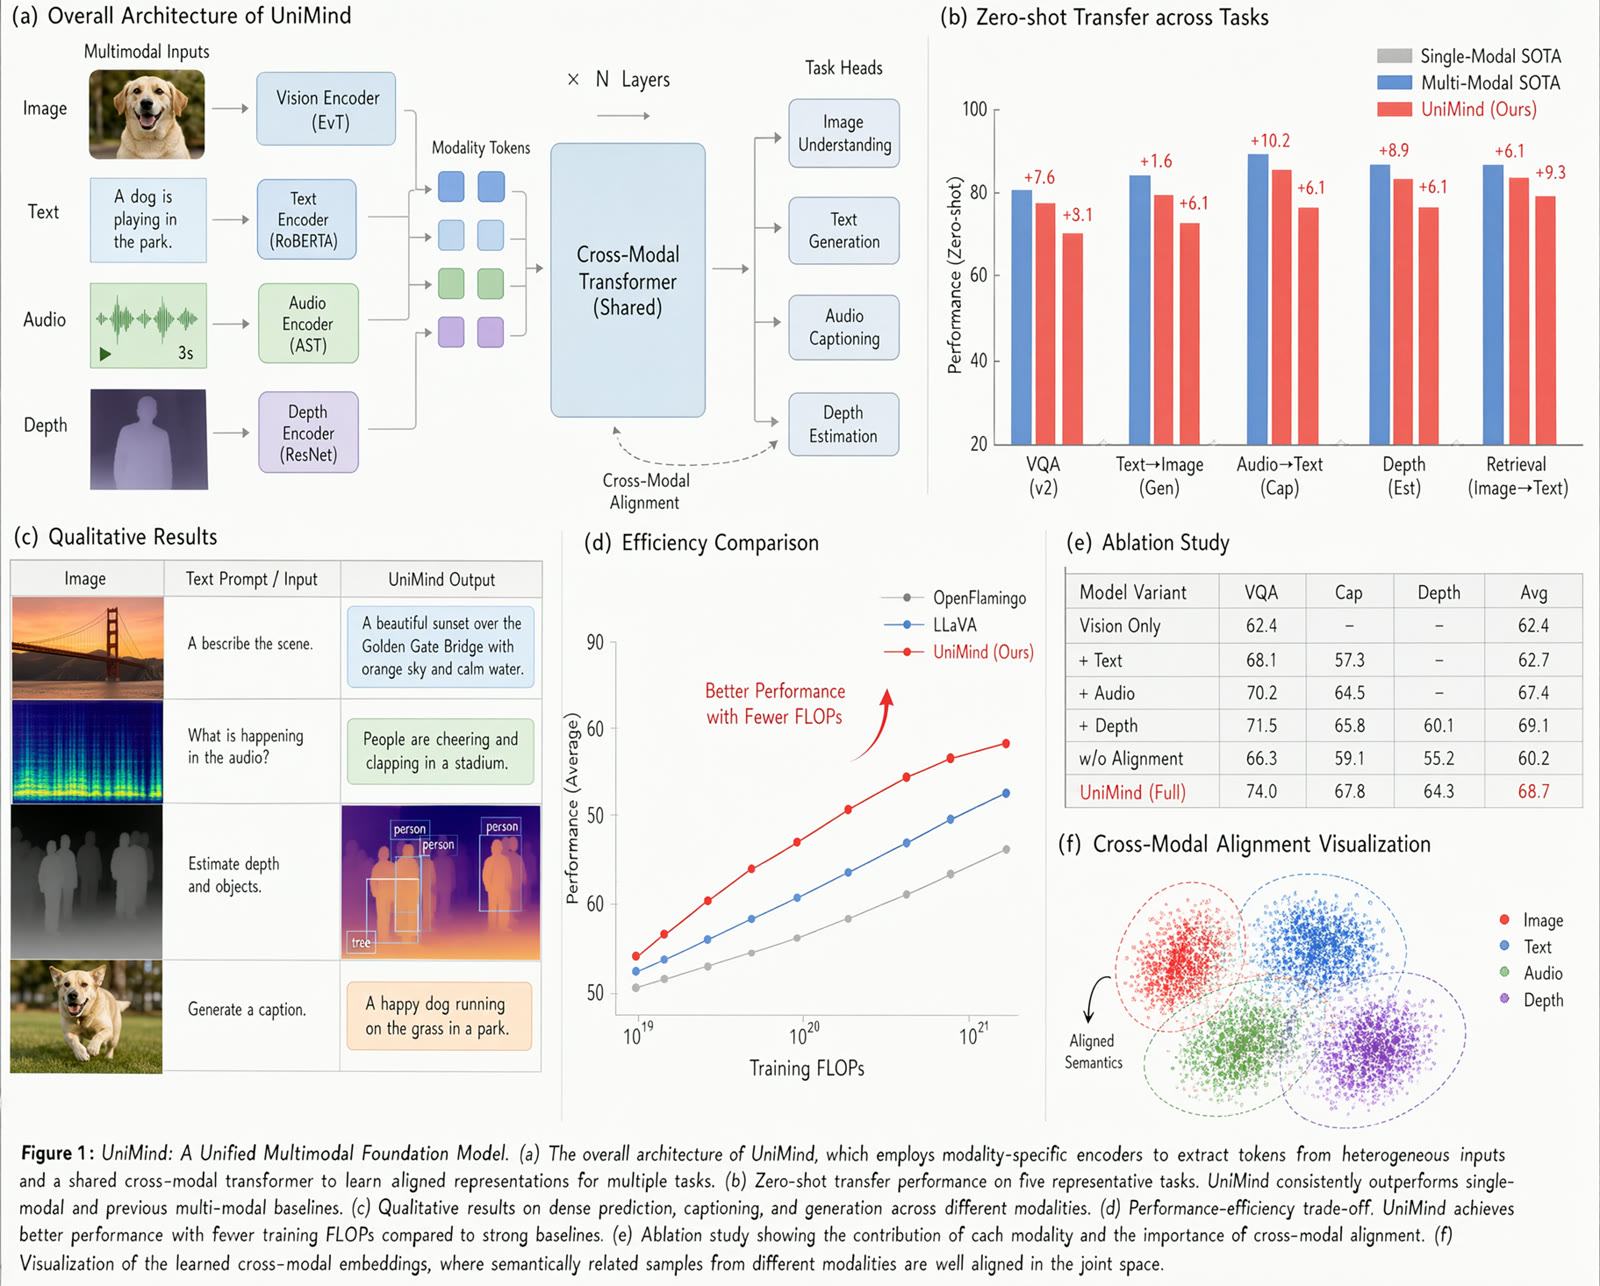
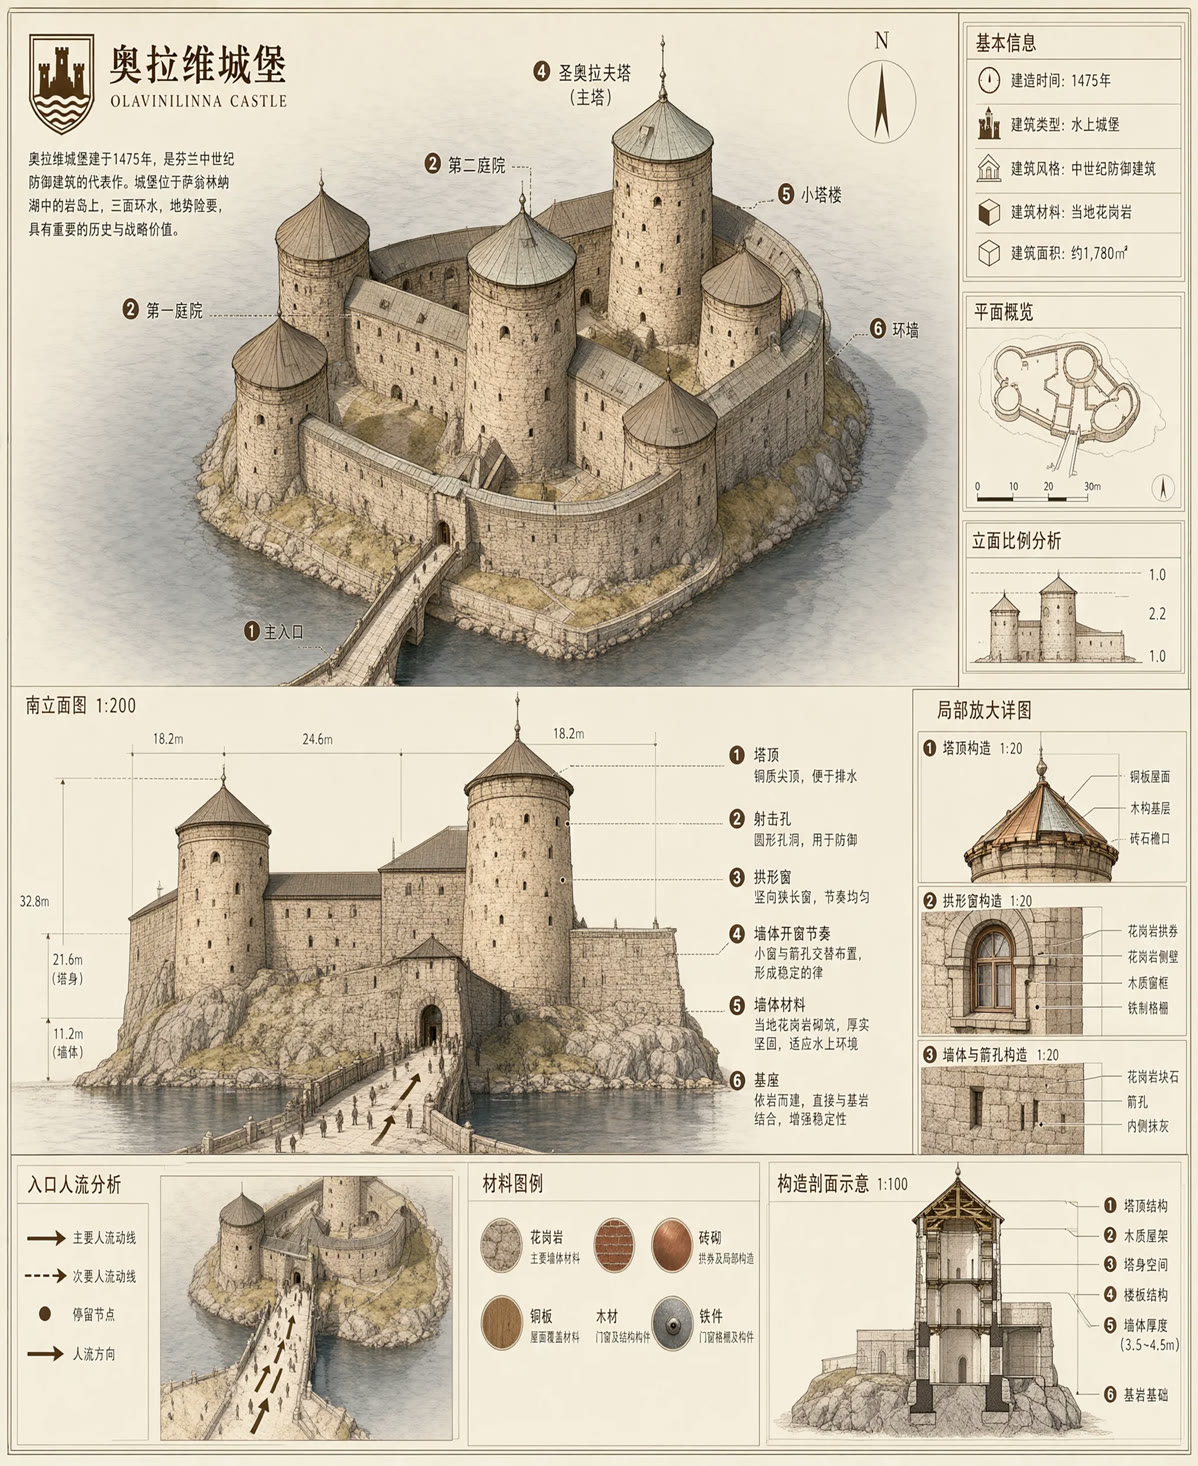
Примеры типографики и компоновки из карточки модели.
Поддержка ComfyUI в день запуска
Поддержка Qwen-Image 2.1 была добавлена в ComfyUI в Comfy-Org/ComfyUI #16400 (CORE-423, автор Kijai), и три официальных шаблона ниже требуют ComfyUI 0.37.0 или новее. Последующие коммиты добавили компиляцию блоков трансформера и улучшили размещение KV-кэша для этой модели.
Переупакованные однофайловые веса находятся в Comfy-Org/Qwen-Image-2.1, а шаблоны входят во встроенную галерею рабочих процессов, поэтому их можно открыть и из браузера шаблонов, а не только перетаскиванием JSON.
| Шаблон | Что он делает |
|---|---|
| Текст в изображение | Одно изображение 1024x1024 за 25 шагов выборки, нативный вывод 2K, поддержка типографики и альфа-канала |
| Редактирование изображения | Два референсных изображения через единый чекпоинт генерации и редактирования, полезно для правок с сохранением персонажа и вырезания товаров |
| Удалить фон | Одно входное изображение на входе, один прозрачный результат на выходе, благодаря нативному выводу RGBA модели |
Файлы модели
Переупаковка Comfy-Org разложена по обычным папкам:
📂 ComfyUI/
└── 📂 models/
    ├── 📂 diffusion_models/
    │   ├── qwen_image_2.1_bf16.safetensors
    │   └── qwen_image_2.1_int8_convrot.safetensors
    ├── 📂 text_encoders/
    │   ├── qwen3vl_8b_bf16.safetensors
    │   ├── qwen3vl_8b_int8_convrot.safetensors
    │   └── qwen3vl_8b_w4a8.safetensors
    └── 📂 vae/
        └── qwen_image_2.1_vae_bf16.safetensors
Помимо них, в переупаковке есть текстовые энкодеры prompt enhancer: qwen3.5_9b_qwen_image_2.1_pe_t2i и qwen3.5_9b_qwen_image_2.1_pe_i2i в форме INT8 convrot. Это LLM, которые Qwen дообучила, чтобы разворачивать короткий запрос в формат шаблона промпта, предпочитаемый моделью изображений. Они опциональны: любая достаточно сильная LLM может заполнить тот же шаблон промпта, а сама модель изображений работает и без неё.
Что сообщают первые пользователи
Модель доступна пользователям с самого дня запуска, и снова и снова всплывают одни и те же практические замечания:
- Нативное разрешение важно. Значительное превышение обучающего разрешения класса 2048 дестабилизирует экспозицию, а слишком большие входные референсы резко замедляют генерацию. Уменьшить референс до загрузки дешевле, чем позволить сэмплеру пережёвывать его.
- CFG ниже 1 непригоден. Guidance около 1 ведёт себя как в прежней линейке Qwen-Image, а к небольшому CFG с негативным промптом, ориентированным на качество, прибегают, когда текст на изображении должен быть чётче.
- Перенос стиля по-прежнему нестабилен. Текстовые инструкции надёжно меняют стиль, тогда как стиль, заданный через референсные изображения, менее предсказуем, что перекликается с опытом пользователей на более ранних моделях Qwen-Image Editing.
Доступность
Веса доступны на Hugging Face и ModelScope, анонс опубликован в блоге Qwen. Помимо ComfyUI, интеграции в день запуска включают Diffusers через QwenImage21Pipeline, vLLM-Omni, SGLang и LightX2V.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.